
ArtCraft 深度评测:开源AI图像视频创作工作台,以“可控性前置”重塑创作流程
导读摘要:
ArtCraft 是一款开源的 AI 图像与视频创作工作台,其核心设计理念是将“可控性前置”,即在生成最终画面之前,通过三维空间布局、角色摆姿和场景搭建等手段,彻底解决传统 AI 绘画工具“出图不可控、角色场景不一致”的行业痛点。它允许创作者将虚拟演员固定于真实环境照片中,无论镜头如何调度,人物位置始终保持一致;同时支持在 3D 空间内拼贴素材、使用 3D 人偶精确控制姿势与机位。此外,ArtCr...
1. ArtCraft是什么
ArtCraft 是一款开源的 AI 图像与视频创作工作台,其核心设计理念是将“可控性前置”,即在生成最终画面之前,通过三维空间布局、角色摆姿和场景搭建等手段,彻底解决传统 AI 绘画工具“出图不可控、角色场景不一致”的行业痛点。它允许创作者将虚拟演员固定于真实环境照片中,无论镜头如何调度,人物位置始终保持一致;同时支持在 3D 空间内拼贴素材、使用 3D 人偶精确控制姿势与机位。此外,ArtCraft 保留了 prompt 快速出图、指令改图、画布编辑和图生视频等轻量级功能,兼顾了效率与精度。
技术定位与领域: ArtCraft 属于计算机视觉与计算机图形学交叉领域的 AI 创作工具,具体应用于影视预可视化、动画分镜、电商视觉和游戏概念设计等专业场景。其在技术栈上融合了 2D/3D 合成、姿态估计、图像分割与生成式 AI 模型调度,定位为连接传统 DCC(数字内容创作)工具与纯 prompt 生成式 AI 之间的桥梁。
研发背景: ArtCraft 由开源社区驱动,核心代码托管于 GitHub 的 storytold 组织下。其研发动机源于当前 Midjourney、Stable Diffusion 等主流工具在专业创作流程中的局限性——随机性高、角色一致性差、缺乏空间感。团队旨在通过构建一个“IDE 式”的创作环境,将艺术家的空间想象力和导演思维引入 AI 生成流程。
核心价值: 该工具解决了 AI 生成内容在工业化生产中的可用性问题。通过“先搭场景、后出图”的逆向工作流,ArtCraft 将不可控的“抽卡”式生成转变为可预期的“工程化”产出,显著降低了多图叙事、系列海报和分镜脚本制作中的返工成本,提升了团队协作的效率。
技术特点: 其核心技术优势在于三维空间合成引擎与角色身份迁移机制。前者能自动处理透视、遮挡与光影关系,使多图层素材在深度空间中自然融合;后者则通过 3D 人偶作为中间参照,将精确的姿势与站位迁移至 AI 生成的角色上,实现了姿态控制与身份保持的分离,这是目前多数纯 2D 编辑工具无法做到的。
2. 主要功能
场景定位(多机位一致性): 这是 ArtCraft 最具差异化的功能。用户将虚拟演员“锚定”在真实环境照片的特定坐标后,系统会记录该位置的空间信息。在后续生成中,无论用户如何调整虚拟摄像机角度,人物与环境的相对位置、透视比例和遮挡关系都会保持物理正确,彻底解决了传统 AI 工具中“角色在画面中飘移”的问题,适用于影视 Previs 和广告多机位拍摄。
三维合成: 该功能将背景、前景和道具放置在一个具有深度信息的立体空间中。系统根据 Z 轴深度自动计算遮挡关系(如前景物体挡住后景角色)和光影衰减,模拟真实的物理相机效果。相比 Photoshop 的平面图层,三维合成提供了更接近实拍的沉浸感和空间真实感。
二维合成与画布编辑: 保留了传统平面设计的灵活性。内置图层拼贴、一键抠图(背景移除)和画笔工具,支持用户对生成结果进行精细的像素级修饰。该功能作为三维合成的补充,用于快速处理细节瑕疵或进行拼贴风格的创意表达。
图片转三维模型: 用户上传一张普通照片,ArtCraft 能将其转换为可旋转、可缩放的三维网格物体。这意味着创作者可以将 2D 素材(如一张桌子、一个道具)转化为可重复利用的 3D 资产,放入三维场景中参与透视和光照计算,极大丰富了素材库的维度和复用性。
角色摆姿与身份迁移: 创作者可在内置的 3D 人偶上旋转关节、调整脊柱弯曲度和手指细节,摆出目标姿势。随后通过“身份迁移”功能,将这个人偶的骨骼姿态数据映射到 AI 生成的角色上。该功能将“姿势控制”与“角色外观”解耦,让动画师无需依赖复杂的 ControlNet 参数,即可直观地锁定动作。
场景搭建与资产库: 提供预设的三维资产包(如室内家具、户外植被、建筑模块),用户像搭积木一样拖拽资产来规划机位、角色走位和景深层次。这降低了三维创作的技术门槛,使得不熟悉 Maya 或 Blender 的分镜师也能快速搭建用于验证构图的白盒场景。
混合素材创作: 支持将图片剪贴、三维网格和场景模型混排在同一个画布中统一编排。例如,可以将一张实拍照片作为背景,一个三维道具作为前景,再加上一个 AI 生成的 2D 角色,三者在一个视图下进行统一的透视和光照调整,实现跨维度的混合现实创作。
模型生态集成: 内置 62 个模型目录,并已接入 Grok、Midjourney、Sora 等外部 API 服务。用户无需频繁切换软件,即可在工作台内根据不同的生成需求(如写实、插画、视频动效)调用不同的底层模型,实现“一处编排、多模型输出”的聚合工作流。
3. 如何使用
环境要求与安装: 访问 GitHub Releases 页面下载 Windows 或 macOS 的稳定版安装包。Linux 用户需从源码编译,需配置 Rust 和 Node.js 环境。安装包体积较大,建议确保系统盘有充足空间,且显卡驱动需支持 OpenGL 4.5 以上以渲染三维视口。
启动与账号登录: 安装完成后首次启动,需按照客户端提示完成账号注册与登录。此账号用于同步本地工作区配置及验证开源许可证,但核心生成功能依赖用户自备的模型 API Key。
配置模型服务: 在“设置”选项中,填入所需的模型 API Key(如 OpenAI、Stability AI 或 Grok)。若需使用 Midjourney 或 Sora,需在集成插件中绑定对应账号的 Token。配置完成后,可在模型下拉菜单中测试连通性。
选择工作流模式: 主界面提供“快速出图”和“高级创作”双入口。前者适合灵感探索,输入 Prompt 即可快速生成;后者进入可视化工作台,用于需要精确控制场景、姿势和构图的专业创作。
搭建三维场景: 在高级创作模式中,点击“导入”加载环境照片或 3D 资产。使用左侧工具栏的“移动/旋转/缩放”工具,将角色和道具放置于场景中的目标位置。通过调整相机视角,确认前景与背景的遮挡关系是否符合预期。
角色摆姿与生成: 选中 3D 人偶,拖拽骨骼控制点完成姿势设定。确认构图后,点击“生成”按钮。ArtCraft 会将当前视口的相机参数、物体坐标和骨骼数据编译为控制条件,连同 Prompt 一并发送至所选 AI 模型,最终返回符合空间约束的图像或视频。
迭代精修与导出: 若生成结果存在局部瑕疵,可返回画布使用遮罩工具锁定区域,输入指令进行局部重绘(Inpainting)。确认最终效果后,点击“导出”选择 PNG、JPEG 或 MP4 格式,分辨率最高可支持 4K(视底层模型能力而定)。
4. 优缺点分析
| 优点 |
|---|
| 可控性前置设计: 通过三维空间布局和 3D 人偶摆姿,在生成前锁定构图、透视和角色动作,从源头解决了 AI 出图随机性大的核心痛点,显著降低专业创作的返工率。 |
| 多机位一致性保障: 虚拟演员固定在真实环境中,系统自动计算不同机位下的透视与遮挡,为影视预可视化和系列海报拍摄提供了可靠的跨图一致性,这是纯图像生成模型难以实现的能力。 |
| 三维合成真实性: 自动处理深度、光影和遮挡关系,使得多素材合成的画面比平面图层工具更具物理真实感,尤其适合需要复杂场景调度的专业视觉项目。 |
| 开源与二次开发潜力: 采用 MIT/Apache-2.0 双协议开源,开发者可自由修改源码、扩展插件或集成内部模型,这对于有定制化需求的工作室具有极大的吸引力。 |
| 双模式覆盖全流程: 快速出图模式满足前期灵感探索的效率需求,高级创作模式满足后期定稿的精度需求,一套软件覆盖了从概念到成品的完整工作链路。 |
5. 同类工具对比
| 维度 | ArtCraft | Midjourney | ComfyUI |
|---|---|---|---|
| 产品形态 | 开源桌面工作台,IDE 式三维创作环境 | 闭源在线服务,Prompt 驱动生成 | 开源节点式工作流引擎,本地部署 |
| 核心思路 | 先搭三维场景再生成,可控性前置 | 文字描述 + 风格参数,抽卡式生成 | 模块化节点连线,深度控制生成过程 |
| 可控精度 | 高,支持 3D 摆位、骨骼姿势、机位和遮挡精确控制 | 低,构图依赖 Prompt 和参考图,随机性大 | 较高,通过 ControlNet 和遮罩实现局部控制,但无 3D 空间概念 |
| 一致性能力 | 强,角色可在同一环境多机位固定,跨图一致性有保障 | 弱,跨图保持角色和场景一致较困难,需反复抽卡 | 中等,可通过种子和参考图保持风格一致,但无空间锚定 |
| 使用成本 | 开源免费,模型 API 费用自付,可本地编译 | 订阅制付费(约 10 美元/月起),无免费额度 | 开源免费,需自备 GPU 硬件和模型权重 |
| 模型选择 | 62 个模型目录,支持 Grok、Midjourney、Sora 等外部集成 | 仅自家模型系列,闭源不可扩展 | 支持任意 Hugging Face 模型,社区资源丰富 |
| 视频能力 | 内置图生视频,可接入多种视频生成模型 | 有视频生成功能,但模型选择有限 | 通过 AnimateDiff 等节点实现视频生成,配置复杂 |
| 二次开发 | 可,MIT/Apache-2.0 双协议开源,扩展性强 | 不可,封闭生态 | 可,完全开源,节点可自定义 |
| 适合人群 | 影视预可视化、动画分镜、专业创作团队 | 灵感探索、社交媒体出图、个人玩家 | 技术型创作者、追求极致控制的研究者 |
选型建议: 对于需要精确控制镜头调度和角色走位的影视 Previs 或动画分镜团队,ArtCraft 提供了比 ComfyUI 更直观的三维空间操作界面,且比纯 Blender 工作流更聚焦于 AI 生成,是平衡效率与控制精度的折中选择。若团队已有成熟的 Blender 管线且擅长 Python 脚本,则基于 Blender 的 AI 插件方案可能更具深度集成优势。
对于追求快速产出社交媒体内容的个人创作者: Midjourney 的低门槛和高质量出图仍是首选,尽管其可控性较弱,但配合“垫图”和风格参考功能,已能满足大多数非专业场景需求。而 ComfyUI 更适合那些愿意投入时间学习节点逻辑、追求生成过程完全透明和可复现的技术型用户。
6. 编辑总结
ArtCraft 的出现在于精准切中了 AI 生成内容从“玩具”走向“生产力工具”过程中的关键瓶颈——可控性。其“可控性前置”的设计哲学,本质上是对生成式 AI 工作流的一次重构:不再试图在生成后通过修图来弥补随机性,而是在生成前通过三维空间约束来消除不确定性。这种思路将导演思维和空间想象力重新归还给创作者,使得 AI 不再是难以驾驭的“黑箱”,而是可指挥的“虚拟摄制组”。
从技术实现来看,ArtCraft 将 3D 人偶摆姿、骨骼数据迁移与多模态生成模型相结合,实现了姿势控制与外观生成的解耦。这种混合现实的工作方式,既保留了 AI 在纹理和光影生成上的优势,又利用了传统三维图形学的精确性,是当前技术条件下兼顾效率与精度的务实方案。其 62 个模型目录的聚合生态,也反映出工具正从单一模型依赖向多模型编排演进的行业趋势。
当然,ArtCraft 仍处于早期阶段,三维资产库的丰富度、社区教程的完善度以及本地 GPU 算力的要求,都是其大规模普及的潜在障碍。但对于影视预可视化、动画分镜、电商系列海报等追求“确定性”的专业场景而言,ArtCraft 提供的价值是显著的。它代表了 AI 创作工具向专业化、工业化方向演进的一个重要分支,值得所有关注 AI 内容生产流程革新的从业者深入探索。
7. 应用场景
影视预可视化(Previs): 导演和摄影指导在实拍前,使用 ArtCraft 导入场地照片或 3D 场景模型,放置虚拟替身演员并规划走位。通过多机位切换预览镜头衔接,可在零成本条件下验证分镜的可行性、景别搭配和场面调度逻辑,减少实拍时的沟通成本与试错次数。
动画与分镜制作: 动画师在 3D 人偶上摆出关键帧姿势,通过身份迁移功能将姿态赋予 AI 生成的角色,快速产出动作连贯的分镜图。相比传统手绘分镜,该方法能更直观地展示角色与场景的比例关系,且修改姿势只需拖动骨骼点即可完成,大幅提升分镜迭代速度。
电商与广告视觉: 品牌方需要为同一产品制作多张不同角度的系列海报。使用 ArtCraft 将产品“钉”在统一的 3D 场景中,通过旋转虚拟相机即可获得不同机位的产品展示图,保证光影、背景和透视完全一致,确保系列广告视觉风格的统一性和品牌辨识度。
游戏概念设计: 概念设计师利用 ArtCraft 的 3D 资产库快速搭建世界观场景的“白盒”,在此基础上混合 2D 数字绘画素材和 3D 网格模型,探索不同的美术方向。这种工作流允许设计师在透视准确的前提下自由尝试构图变化,为最终概念图的绘制提供坚实的空间基础。
短视频与社交媒体内容生产: 内容创作者上传一张静态照片,通过“图生视频”功能一键生成具有运镜效果的短视频片段。结合三维场景中的相机路径预设,可批量产出带有推拉摇移效果的创意视频,适用于需要高频更新内容的社交媒体运营场景。
8. 常见问题FAQ
Q:ArtCraft 是完全免费使用的吗?
A:软件本身基于 MIT/Apache-2.0 双协议开源,代码和客户端完全免费。但生成功能依赖第三方 AI 模型的 API 调用,用户需要自行承担 Grok、Midjourney 或 Sora 等服务的 API 费用。若使用本地部署的开源模型(如 Stable Diffusion),则仅需承担硬件电费。
Q:我的电脑配置不高,能流畅运行 ArtCraft 吗?
A:ArtCraft 的三维视口渲染需要独立显卡支持,建议至少配备 4GB 显存的 GPU(如 NVIDIA GTX 1650 以上)。若仅使用“快速出图”模式且调用云端 API,则对本地算力要求较低;但“高级创作”模式下的实时视口交互对显卡性能敏感,低配设备可能出现卡顿。
Q:如何解决生成的角色与 3D 人偶姿势不一致的问题?
A:首先确保 3D 人偶的骨骼比例与目标角色差异不要过大,极端夸张的姿势可能导致迁移失真。其次,检查生成时是否勾选了“姿势锁定”选项,并适当提高 ControlNet 或姿态引导的权重参数。若仍不一致,可尝试将人偶姿势导出为 PNG 深度图,作为参考图一并提交给模型。
Q:ArtCraft 支持离线使用吗?
A:支持部分离线功能。用户可导入本地 3D 模型和图片素材进行场景搭建,且二维编辑工具无需联网。但 AI 图像生成和图生视频功能必须联网调用模型 API。若需完全离线生成,可在模型设置中配置本地运行的 Stable Diffusion WebUI 地址。
Q:我可以在商业项目中免费使用 ArtCraft 生成的内容吗?
A:可以。ArtCraft 的开源许可证允许商业使用,且不限制生成内容的版权归属。但需注意,您使用的第三方模型(如 Midjourney、Sora)可能有各自的商业使用条款,请务必查阅并遵守底层模型服务商的服务协议。
Q:如何为 ArtCraft 添加自定义的 3D 模型资产?
A:目前支持导入 OBJ、FBX 和 glTF 格式的三维模型文件。在“资产库”面板中点击“导入”按钮,选择本地文件即可。建议将模型导出为 glTF 格式以获得最佳的材质兼容性。复杂模型导入后可能需要手动调整缩放比例和坐标轴朝向。
9. 项目地址
- 产品官网: https://getartcraft.com/
- GitHub 仓库: https://github.com/storytold/artcraft
相关 AI 模型文章
PixelUMM深度评测:NVIDIA与滑铁卢大学联合打造的无编码器统一多模态模型
PixelUMM是NVIDIA与滑铁卢大学联合推出的无编码器统一多模态模型,其核心创新在于彻底移除传统多模态系统中的VAE和视觉编码器,构建了一个纯粹的Decoder-only Transformer架构,直接在原始像素空间读写图像与视频。该模型将图像按16×16 patch、视频按4帧tubelet切分,理解和生成任务共享同一解码器与自注意力机制,实现了端到端的像素级信息处理,代码已全面开源。
Nano Banana 2.1:Google DeepMind 图像生成与对话式编辑模型深度评测
Nano Banana 2.1(模型 ID:gemini-nano-banana-2.1)是 Google DeepMind 于 2026 年 10 月 6 日正式发布的第二代图像生成与对话式编辑模型,隶属于 Gemini 3 系列,底层架构基于 Gemini 3.6 Flash。该模型深度融合了原生多模态推理、1M token 长上下文与知识 grounding 能力,支持 1K/2K/4K 分...
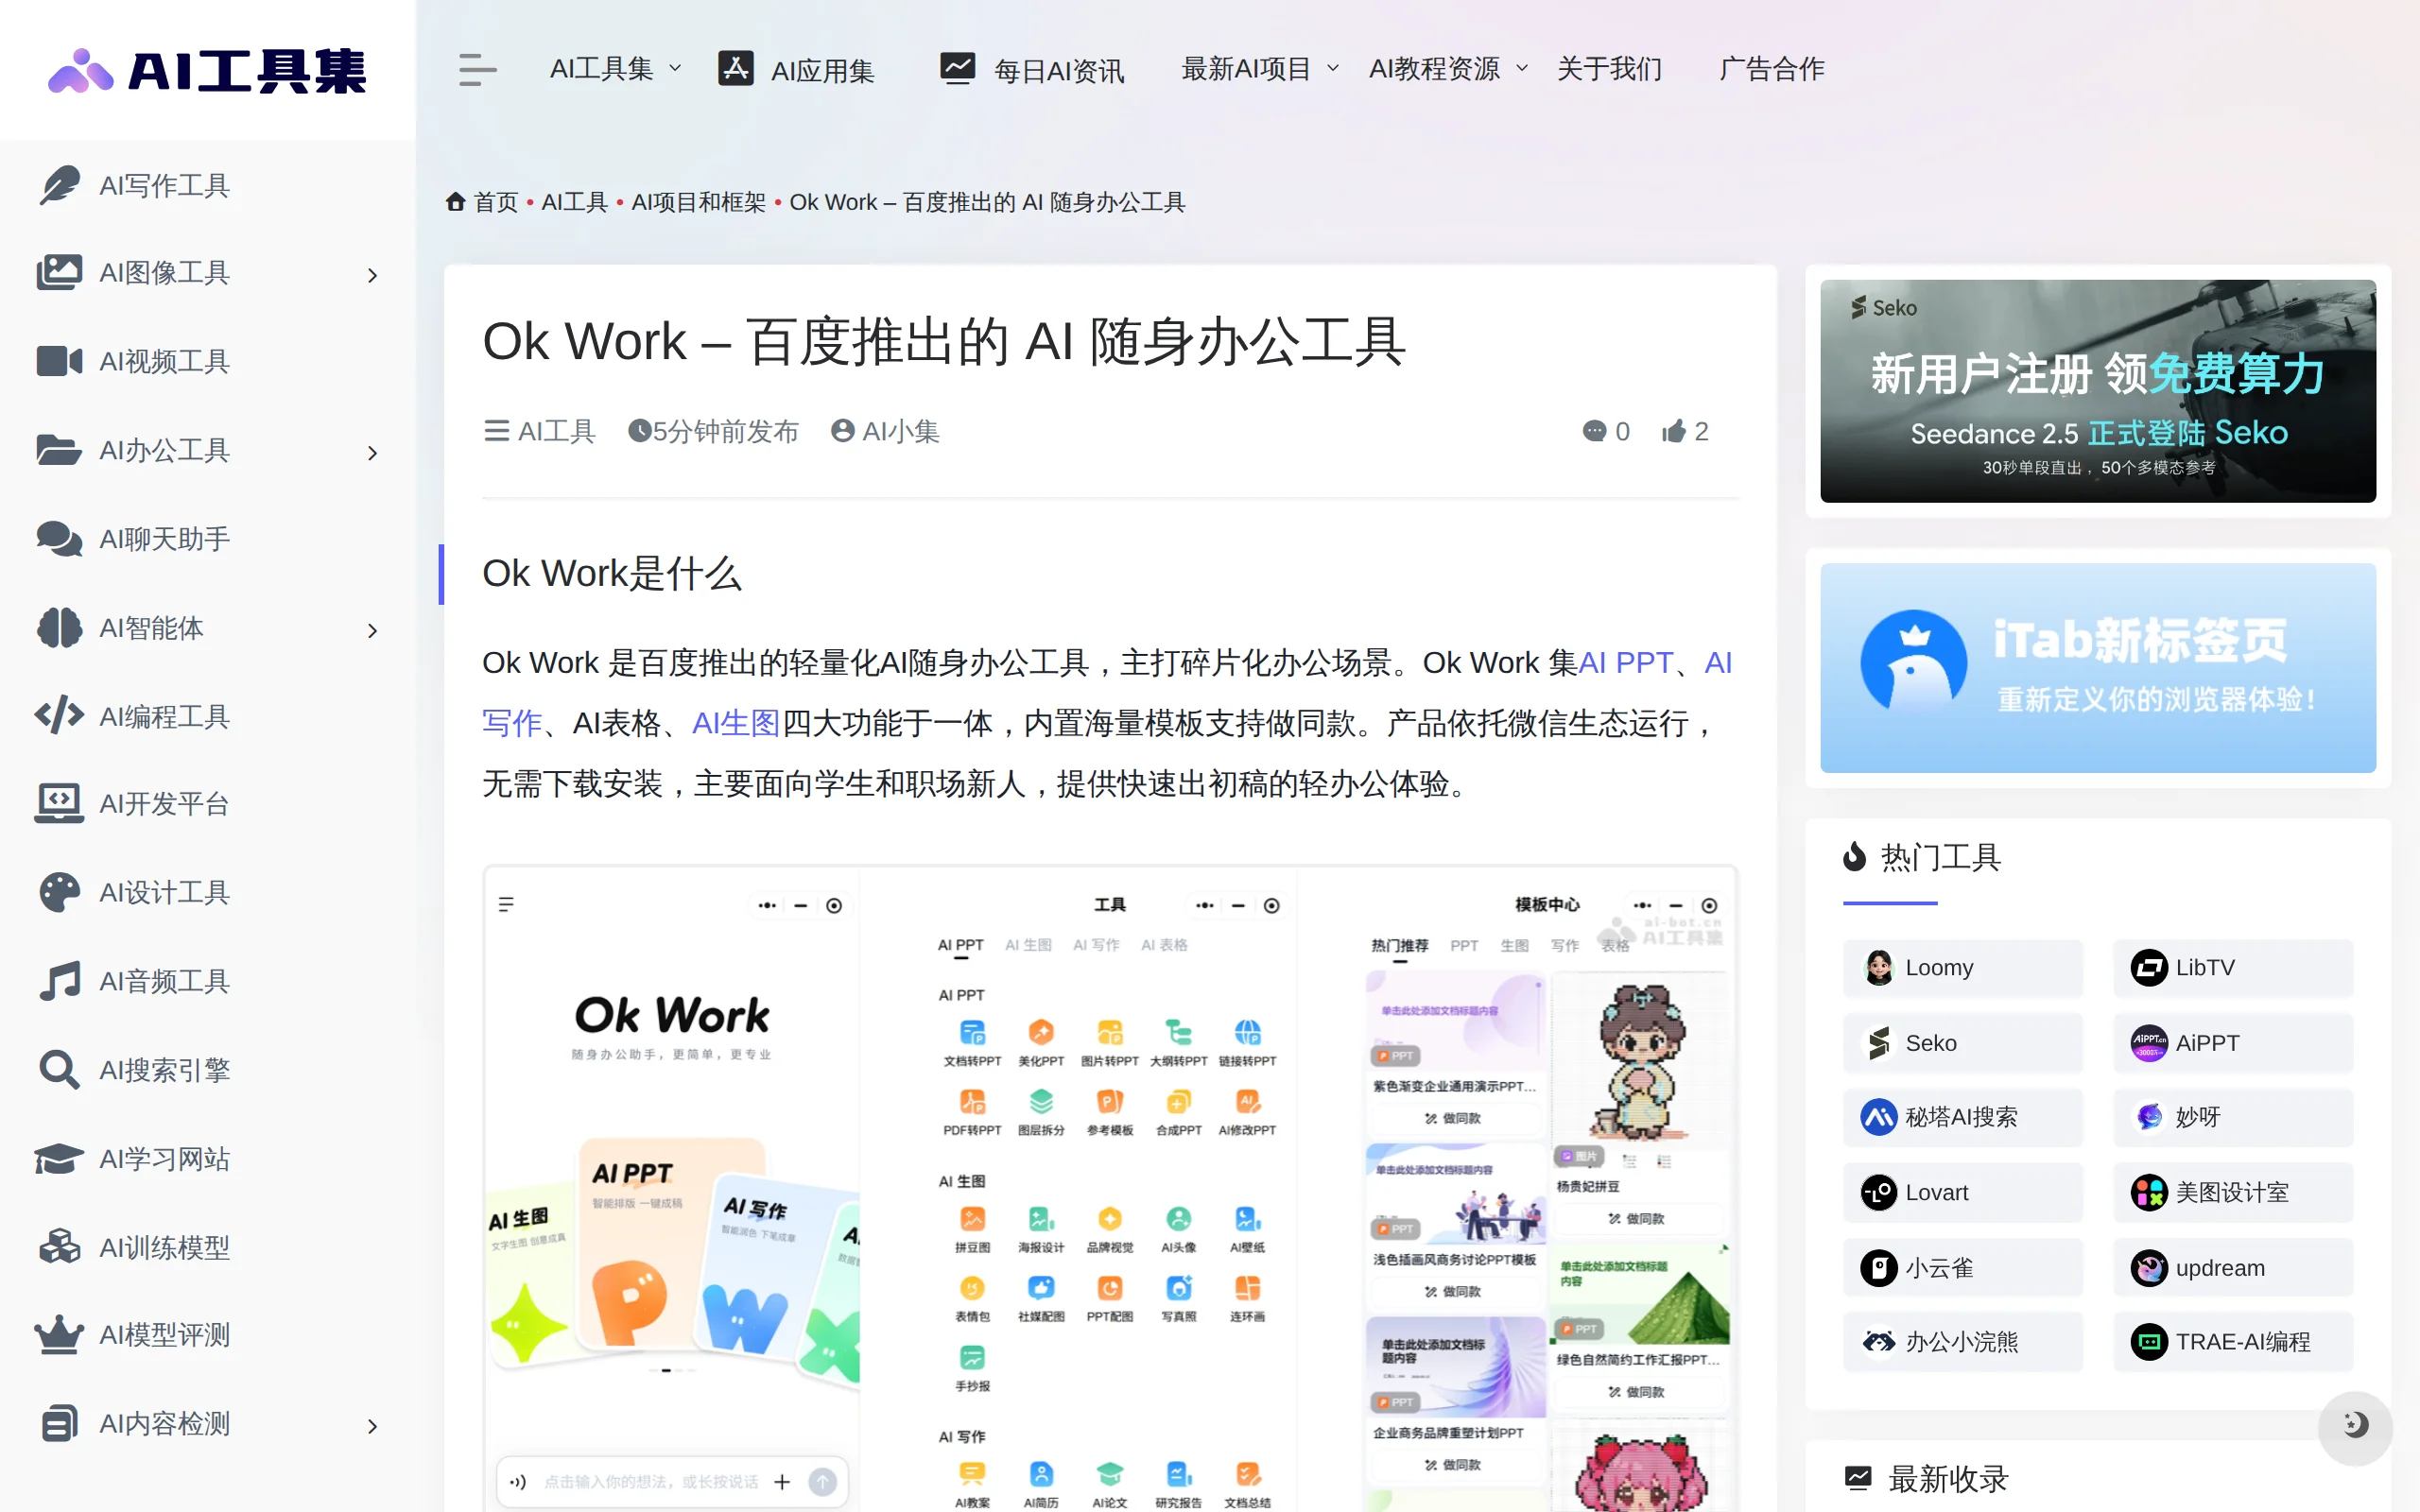
Ok Work – 百度推出的 AI 随身办公工具
Ok Work是百度推出的轻量化AI随身办公工具,以微信小程序形态运行,面向学生与职场新人,聚焦碎片化办公场景。产品将AI PPT、AI写作、AI表格、AI生图四大核心能力整合于同一对话界面,内置海量模板并支持"做同款"快速套用,无需下载安装即可完成从内容生成、文档转换到视觉设计的完整轻办公流程。依托文心大模型的底层能力,Ok Work将复杂的AI能力拆解为颗粒度精细的具体小工具,以极低的上手门槛...
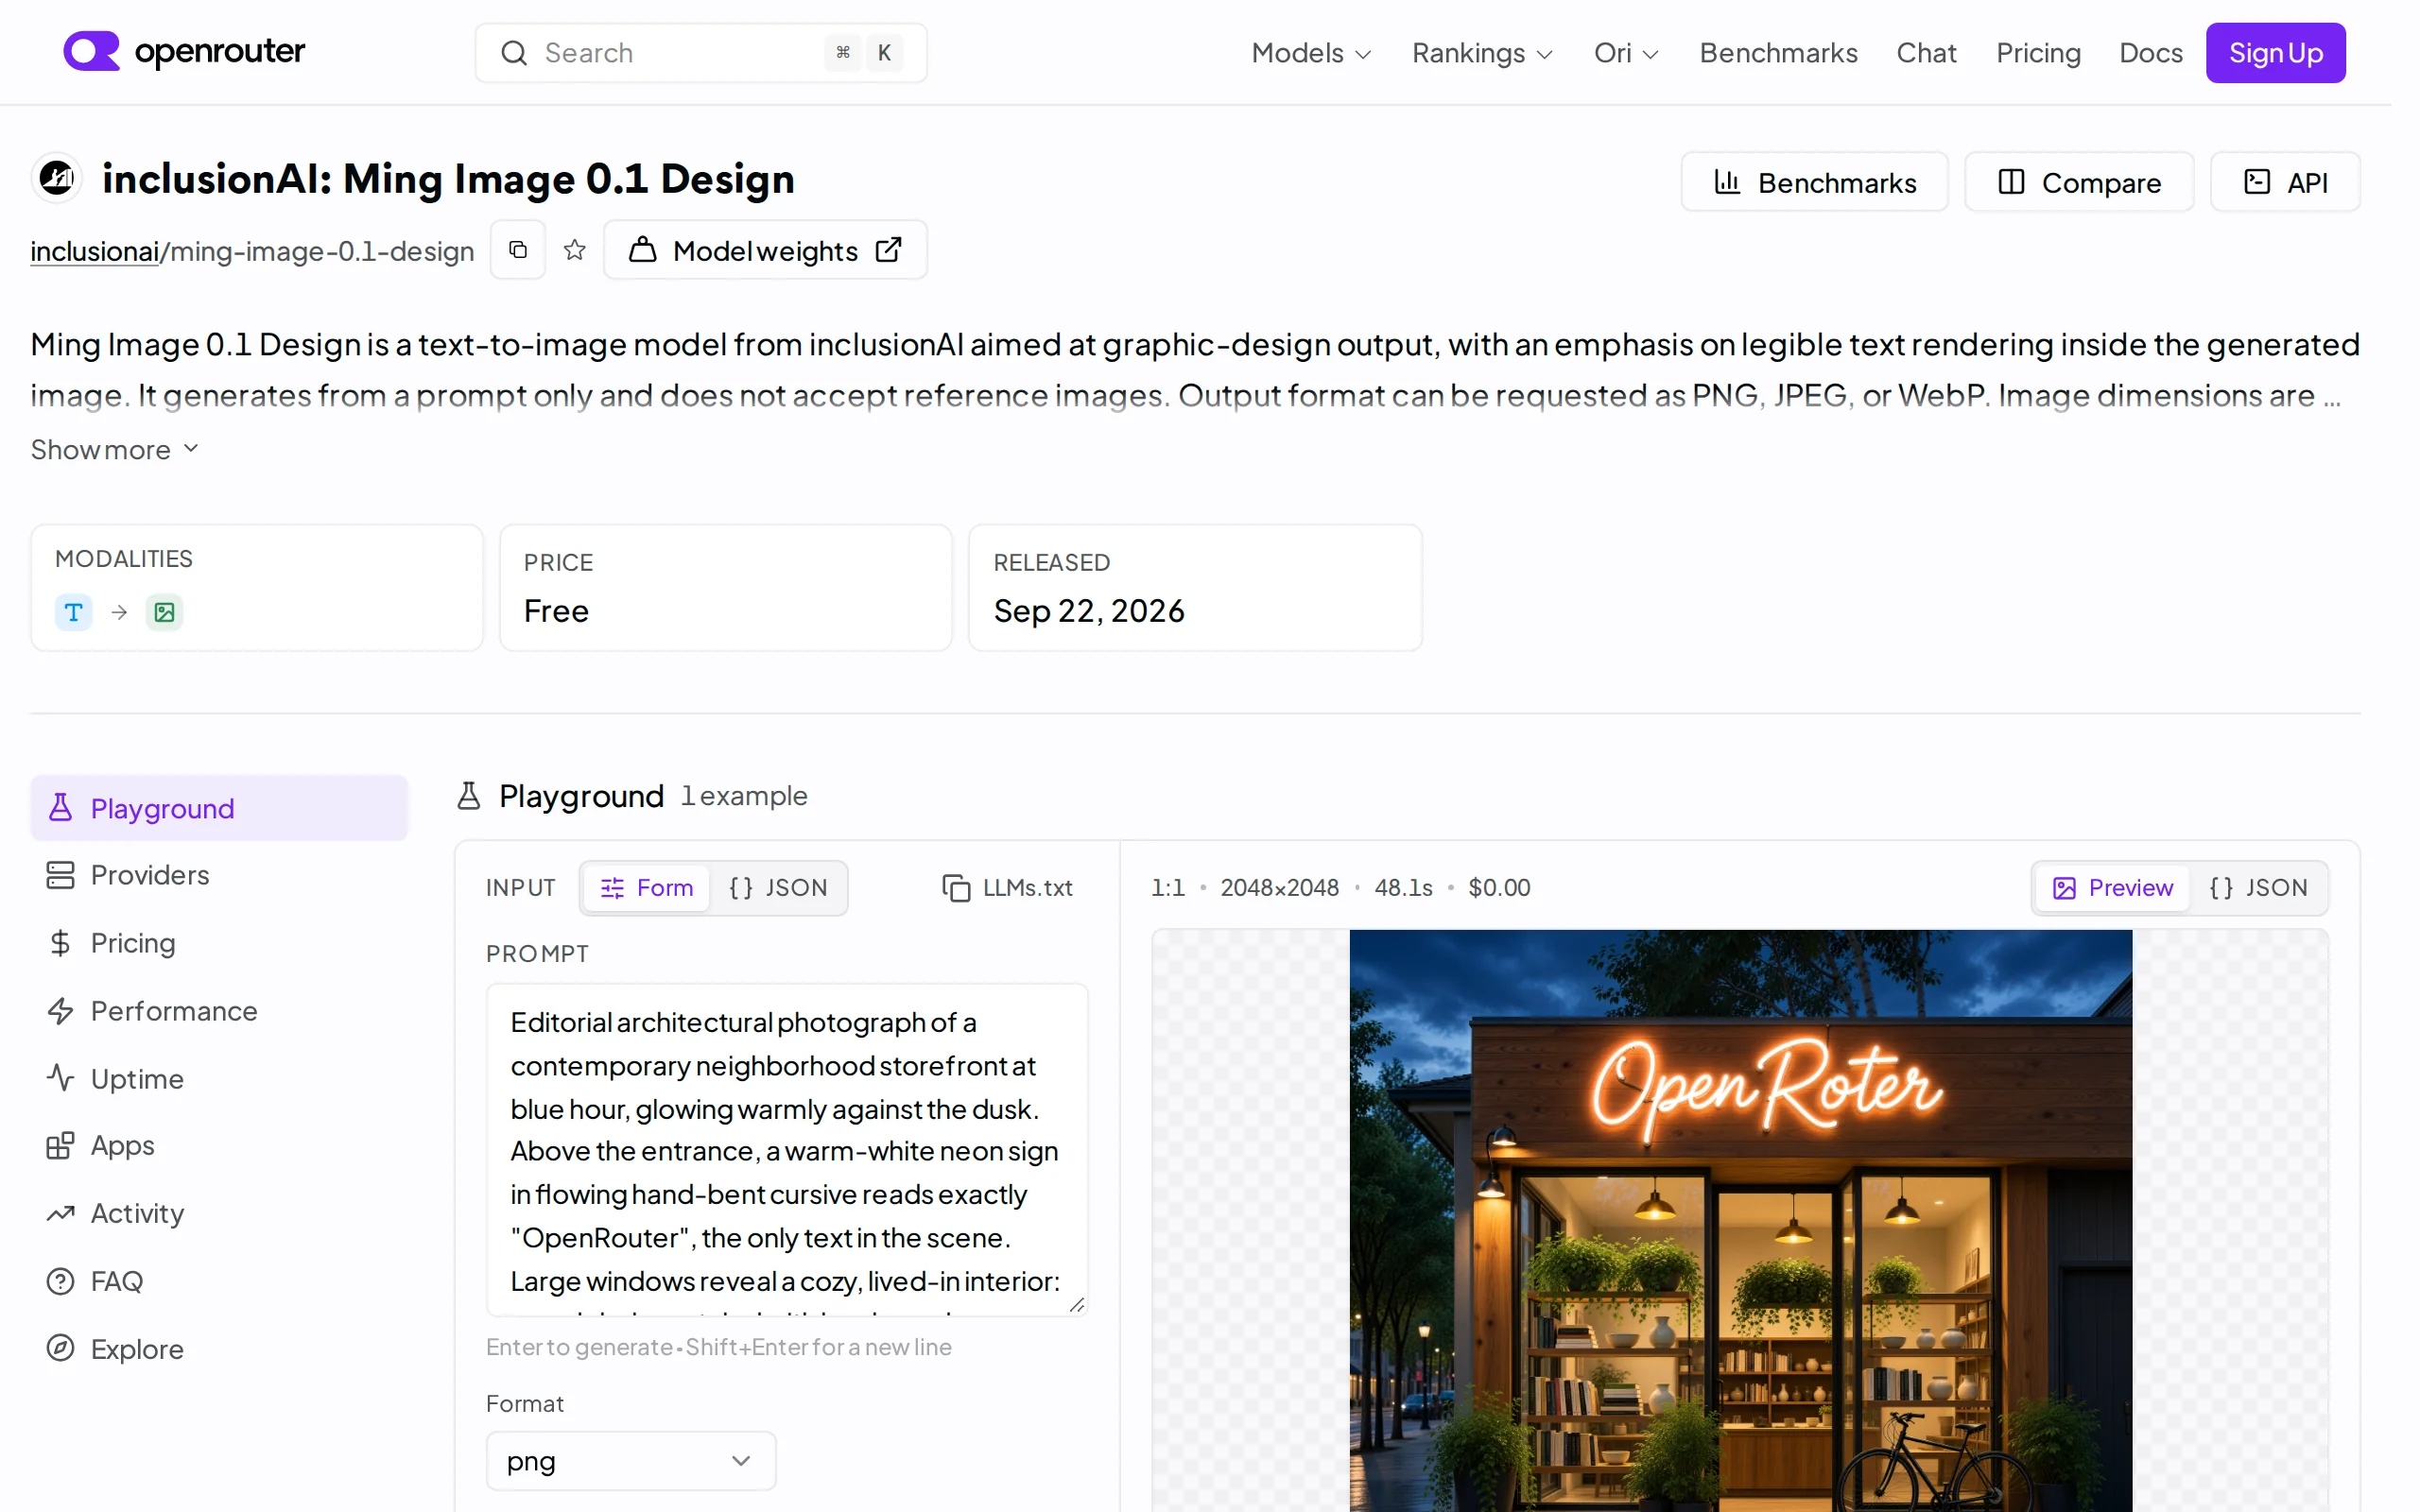
Ming-Image-0.1-Design:蚂蚁开源6B图像生成模型,端到端重构设计工作流
Ming-Image-0.1-Design是蚂蚁集团InclusionAI开源的一款6B参数图像生成模型,专注设计场景,支持8K长结构化提示词,能端到端生成UI、信息图、海报等完整视觉设计。配合同步开源的Design-Layer模型,该工具可将设计图拆解为2—9个可独立编辑的透明图层,实现"生成—分层—编辑—交付"全流程。Ming-Image-0.1-Design登顶Artificial Anal...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。