
Colibrì – 开源的轻量级本地推理引擎,分层存储推理
导读摘要:
Colibrì 是一款开源的轻量级本地推理引擎,专为在消费级硬件上运行超大规模 MoE(混合专家)模型而设计。它能够在仅 25GB 系统内存的普通电脑上运行参数总量达 744B 的 GLM-5.2 旗舰模型,无需昂贵的服务器集群。其核心创新在于分层存储架构:将常驻参数保留在内存中,而将海量路由专家参数存放在 NVMe 硬盘上按需动态加载,从而突破了大模型必须完整装入高速显存或内存的传统限制。引擎采...
1. Colibrì是什么
Colibrì 是一款开源的轻量级本地推理引擎,专为在消费级硬件上运行超大规模 MoE(混合专家)模型而设计。它能够在仅 25GB 系统内存的普通电脑上运行参数总量达 744B 的 GLM-5.2 旗舰模型,无需昂贵的服务器集群。其核心创新在于分层存储架构:将常驻参数保留在内存中,而将海量路由专家参数存放在 NVMe 硬盘上按需动态加载,从而突破了大模型必须完整装入高速显存或内存的传统限制。引擎采用纯 C 语言编写,零外部依赖,编译产物极小,启动迅速,并内置了智能缓存与预取机制,大幅降低磁盘 I/O 延迟。
技术定位与领域: Colibrì 属于自然语言处理领域的推理引擎,专注于 MoE 架构大模型的本地化部署与高效推理。它填补了消费级硬件运行千亿参数级模型的空白,与 llama.cpp、vLLM 等引擎形成差异化竞争,核心优势在于对极大规模 MoE 模型的分层存储支持。
研发背景: 该项目由开源社区开发者 JustVugg 创建,旨在解决超大 MoE 模型推理时对内存和显存的苛刻需求。随着 GLM-5.2 等千亿参数 MoE 模型的出现,传统推理方案要求数百 GB 显存或内存,普通用户无法触及。Colibrì 通过软件层面的存储分层与流式加载,大幅降低了硬件门槛。
核心价值: Colibrì 的核心价值在于让个人开发者、小型团队和研究者能够在本地硬件上运行原本只能部署在数据中心的大模型。它消除了对昂贵云资源的依赖,支持离线推理、隐私敏感数据处理和快速模型效果验证,推动了超大模型的民主化使用。
技术特点: 分层存储推理(显存/内存/硬盘三级缓存)、纯 C 零依赖引擎、全局 int4 量化与手写 AVX2 内核、Router-Lookahead 异步预取、MLA KV-Cache 极致压缩(每 Token 仅 576 值)、以及内置可视化路由热力图面板。
2. 主要功能
分层存储推理: 将模型参数划分为常驻参数(约 9.9GB)和路由专家参数(约 370GB),分别驻留于系统内存与 NVMe 硬盘。推理时根据路由结果动态从硬盘流式加载专家参数,形成 GPU 显存(可选)、系统内存、NVMe 硬盘三级存储池,突破单一存储介质的容量限制。
超大规模模型本地部署: 支持 744B 参数的 GLM-5.2 MoE 旗舰模型在仅 25GB 系统内存的消费级电脑上运行,无需 GPU 或大容量服务器内存。这使得个人开发者可以本地体验千亿参数模型的生成能力,而无需申请昂贵的云端资源。
int4 量化压缩: 全局采用 int4 量化,将 744B 模型压缩至约 380GB 磁盘占用。常驻参数 int4 量化后仅约 9.9GB 常驻内存,路由专家参数约 370GB 存储于 NVMe 硬盘。配合手写 AVX2 整数点积内核,无需 BLAS 依赖即可高效推理。
纯 C 流式 CPU 推理: 整个引擎使用纯 C 语言编写,不依赖 Python、PyTorch 或 CUDA 等外部框架。编译产物为单一可执行文件,体积极小,可在任何支持 AVX2 的 x86-64 Linux 系统上直接运行。推理时通过流式加载实现专家参数动态调度,无需模型全量载入内存。
Web 可视化控制面板: 内置 Chat 交互界面,提供类似 ChatGPT 的对话体验。同时实时展示 TTFT(首 token 生成时间)、吞吐量、队列状态等推理性能指标,方便开发者监控和调优。
专家路由大脑视图: Brain 页面以 76 层 × 256 专家的矩阵形式呈现路由热力图与存储层级分布。鼠标悬停可查看每个专家的主题偏好,帮助研究人员理解 MoE 模型的内部路由行为,支持教学和模型分析。
3. 如何使用
环境准备: 需要一台运行 Linux 或 WSL2 的 x86-64 电脑,CPU 支持 AVX2 指令集。至少 16GB 系统内存(推荐 25GB 以上),以及一块约 400GB 可用空间的本地 NVMe 固态硬盘。需安装 GCC 编译器(用于源码编译)。
获取与编译引擎: 执行
git clone (链接待官方发布后更新) 克隆仓库,进入colibri/c目录后运行./setup.sh完成一键编译。该脚本会自动编译生成纯 C 零依赖的可执行文件coli。Windows 11 用户可通过 MinGW-w64 或 MSYS2 安装 GCC,在c/目录执行make glm.exe` 编译原生可执行文件。下载预转换模型: 从 Hugging Face 仓库
jlnsrk/GLM-5.2-colibri-int4下载 int4 量化后的模型容器。模型文件约 380GB,需存放至本地 NVMe 硬盘,例如/nvme/glm52_i4。下载可使用git lfs或 Hugging Face CLI。启动本地对话或 API 服务: 设置模型路径并启动对话:
COLI_MODEL=/nvme/glm52_i4 ./coli chat。首次加载约 30 秒,常驻内存约 9.9GB,即可在终端与 GLM-5.2 交互。若需 API 服务,执行COLI_MODEL=/nvme/glm52_i4 ./coli serve --host 0.0.0.0 --port 8000,该服务兼容 OpenAI API 协议,任何支持 OpenAI 的客户端均可直接接入。
注意事项: 确保 NVMe 硬盘有足够连续空间,频繁的随机读写会影响推理速度。建议将模型文件放在专用分区或目录。首次运行会建立缓存,后续启动会更快。目前仅支持 GLM-5.2 模型,其他模型需等待社区适配。
4. 优缺点分析
| 优点 |
|---|
| 消费级硬件跑旗舰模型: 仅需 25GB 内存和 NVMe 硬盘即可运行 744B 参数模型,大幅降低千亿模型部署门槛,个人开发者也能本地使用。 |
| 纯 C 零依赖极轻量: 引擎无任何外部依赖,编译产物为单一可执行文件,部署简便,启动速度快,适合嵌入式或边缘场景。 |
| 分层存储智能调度: 独创三级缓存体系,结合 LRU 与学习缓存将高频专家常驻内存,低频专家按需加载,有效平衡内存占用与推理速度。 |
| Router-Lookahead 预取加速: 基于当前层状态预测下一层所需专家,准确率超 70%,通过异步 I/O 线程在计算间隙预取,显著降低磁盘读取延迟。 |
| int4 量化与手写内核: 全局 int4 压缩模型至 380GB,配合 AVX2 手写整数点积内核,无需 BLAS 即可高效推理,在 CPU 上实现可用的生成速度。 |
5. 同类工具对比
| 维度 | Colibrì | KTransformers | llama.cpp |
|---|---|---|---|
| 核心定位 | 纯 C 零依赖的超大 MoE 分层存储推理引擎 | 清华出品的 CPU-GPU 异构 MoE 推理与微调框架 | 纯 C++ 的通用大模型推理引擎,支持多种架构 |
| 最大模型支持 | 744B GLM-5.2(25GB RAM + NVMe 可跑) | 671B DeepSeek-R1 / 1T+ Kimi-K2.5(需大内存 + 可选 GPU) | 取决于内存,理论上支持数百 B 参数(需量化) |
| 专家调度策略 | 显存/内存/硬盘三级流式加载 + Router-Lookahead 预取 | CPU-GPU 频率感知放置 + 动态重分配 + 三层 Prefix Cache | 无专门 MoE 存储分层,全量加载或 mmap 映射 |
| 硬件门槛 | 纯 CPU 即可,25GB RAM + NVMe 为最低门槛 | 推荐大内存工作站 + 消费级 GPU,CPU 需 AVX2/AMX | 纯 CPU 可运行,推荐大内存;GPU 可选 |
| 依赖体积 | 纯 C 零依赖,极轻量(单文件) | Python + PyTorch + CUDA,较重 | 纯 C++,依赖 BLAS/OpenBLAS 等,中等 |
| 量化支持 | 全局 int4 + 手写 AVX2 内核 | FP8 / BF16 / INT8 / INT4 / GGUF 多档量化 | 支持 2~8 bit 多种量化格式(GGUF 为主) |
| 可视化 | 大脑皮层级专家路由热力图 + 基础监控面板 | 基础监控面板与日志 | 无内置可视化,可通过第三方工具 |
| 微调能力 | 仅推理 | 原生支持 LoRA SFT 微调,集成 LLaMA-Factory | 仅推理(可通过其他工具微调后转换) |
选型建议: 对于希望在个人电脑上运行千亿参数 MoE 模型且无 GPU 的用户,Colibrì 是唯一可行的选择。其分层存储设计使得 744B 模型在 25GB 内存下即可运行,但需要高速 NVMe 硬盘和一定的耐心(CPU 推理速度有限)。如果用户拥有大内存工作站和消费级 GPU,KTransformers 提供了更灵活的异构计算和微调能力,适合研究与开发场景。对于生产环境的高并发推理服务,vLLM 凭借 PagedAttention 和 GPU 加速,在吞吐量和延迟上表现更优,但硬件成本较高。而 llama.cpp 作为通用 CPU 推理引擎,支持模型范围最广,社区生态成熟,但缺乏对超大 MoE 模型的分层存储优化,内存需求较高。综合来看,Colibrì 填补了“无 GPU 运行千亿 MoE”的空缺,适合个人开发者、教育科研和隐私敏感场景;若追求性能与生态,KTransformers 或 vLLM 更为合适。
6. 编辑总结
Colibrì 在技术路线上做出了极具创新性的选择:通过纯 C 实现零依赖引擎,并利用分层存储与流式加载,让消费级电脑运行千亿参数 MoE 模型成为现实。这一思路直接挑战了“大模型必须依赖 GPU 集群”的固有认知,为硬件受限场景提供了切实可行的推理方案。其 Router-Lookahead 预取策略和学习缓存机制,有效缓解了磁盘 I/O 瓶颈,实测首 token 延迟在可接受范围内(约 30 秒加载后,后续生成流畅),证明了软件优化能够部分弥补硬件差距。从实用价值看,Colibrì 特别适合个人开发者进行模型效果预研、离线环境下的智能决策、以及数据隐私要求严格的本地部署。它降低了接触前沿 MoE 模型的门槛,使得学术研究和教学演示可以低成本开展。然而,当前版本也存在明显局限:仅支持 GLM-5.2 单一模型,缺乏 GPU 加速和微调能力,可视化面板功能基础。其社区尚处于早期,生态完善度远不及 llama.cpp 或 vLLM。展望未来,如果 Colibrì 能够扩展模型支持(如适配 DeepSeek、Mixtral 等主流 MoE),并引入可选的 GPU 加速模块,其应用前景将更加广阔。对于追求极致轻量和低硬件门槛的用户,Colibrì 是一个值得关注的开源项目,但生产级部署仍需谨慎评估其性能和稳定性。
7. 应用场景
个人本地部署旗舰大模型: 无服务器预算的开发者可在家用电脑上体验 744B 参数 GLM-5.2 的完整能力,用于内容生成、代码辅助、知识问答等任务。通过 Colibrì 的 Web 控制面板或 API 服务,可像使用云端模型一样与本地模型交互。
边缘设备离线推理: 在内存受限的工控机或边缘盒子上运行超大 MoE 模型,满足无网络环境下的智能决策需求,如工业文本分析、离线文档处理等。纯 C 引擎的低依赖特性使其易于集成到嵌入式系统中。
模型效果快速预研: 研究人员无需申请昂贵云端资源,即可在本地验证超大规模模型在特定业务任务上的实际表现。通过调整提示词或进行少量测试,快速评估模型适用性,降低试错成本。
隐私敏感数据处理: 医疗、金融、政务等场景中,敏感数据不得离开本地网络。Colibrì 可实现模型完全本地推理,数据全程不出设备,满足严格的数据隐私合规要求,同时享受大模型的智能分析能力。
MoE 机制教学科研: 高校和科研机构可以利用 Colibrì 的 Brain 视图直观展示专家路由热力图与存储层级,低成本研究 MoE 的稀疏激活、缓存策略与量化推理技术。学生可通过实际运行 744B 模型加深对大规模 Transformer 架构的理解。
8. 常见问题FAQ
Q:Colibrì 为什么需要 NVMe 硬盘,普通 SSD 不行吗?
A:Colibrì 在推理时需频繁从硬盘流式加载路由专家参数(每次推理约需读取数十 MB 至数百 MB),NVMe 硬盘的低延迟和高吞吐是保证生成速度的关键。普通 SATA SSD 的随机读取性能不足,会导致推理延迟显著增加,甚至出现卡顿。建议使用 PCIe 3.0 以上 NVMe 固态硬盘。
Q:Colibrì 目前支持哪些模型?能否运行 Llama 或 DeepSeek?
A:目前 Colibrì 仅官方支持 GLM-5.2 模型(已提供 int4 量化版本)。其架构针对 GLM 系列 MoE 模型设计,暂未适配其他模型。社区未来可能扩展支持,但当前不建议尝试运行非官方模型,否则可能因参数结构不匹配导致错误。
Q:Colibrì 的推理速度如何?能否达到实时对话效果?
A:在推荐配置(如 i7-13700 + NVMe SSD + 32GB RAM)下,首 token 生成约需 30 秒(模型加载),后续生成速度约为 2-5 token/秒,取决于 CPU 单核性能和磁盘速度。这足以进行非实时的文本生成和问答,但无法达到云端 GPU 服务的流式对话体验。对于长文档生成,速度尚可接受。
Q:Colibrì 能否在 Windows 上运行?
A:可以。Windows 11 用户可通过 WSL2 运行 Linux 版本,或使用 MinGW-w64 / MSYS2 安装 GCC 后编译原生 Windows 可执行文件。具体方法:在 c/ 目录执行 make glm.exe 即可生成 glm.exe。但需注意 Windows 下的 NVMe 驱动和文件系统性能可能略低于 Linux。
Q:Colibrì 支持微调吗?如何对 GLM-5.2 进行定制?
A:Colibrì 当前仅提供推理功能,不支持微调。若要微调 GLM-5.2,需使用其他框架(如 LLaMA-Factory 或 KTransformers)进行 LoRA 或全参数微调,再将微调后的模型转换为 Colibrì 支持的格式(目前转换工具未公开,需关注社区更新)。
Q:使用 Colibrì 需要 GPU 吗?
A:不需要。Colibrì 完全基于 CPU 推理,不依赖 GPU。它利用 AVX2 指令集加速 int4 点积运算,因此 CPU 需支持 AVX2(大多数 2013 年后的 x86-64 CPU 均支持)。未来版本可能加入 GPU 支持,但当前版本纯 CPU 即可。
Q:Colibrì 与 llama.cpp 相比有何优势?
A:Colibrì 的核心优势在于针对超大 MoE 模型的分层存储设计,使得 744B 模型可在 25GB 内存下运行。llama.cpp 虽然支持更多模型和量化格式,但通常需要将模型全部加载到内存,运行千亿参数模型需要数百 GB 内存,硬件门槛更高。Colibrì 在低内存场景下具有不可替代的优势。
9. 项目地址
- GitHub 仓库: https://github.com/JustVugg/colibri (包含源码、编译脚本与使用文档)
- Hugging Face 模型仓库: https://huggingface.co/jlnsrk/GLM-5.2-colibri-int4 (int4 量化后的模型容器)
相关推荐
FLUX 3 Image Klein – Black Forest Labs 开源的AI图像模型
FLUX 3 Image Klein 是由 Black Forest Labs 开源的 AI 图像生成模型,以仅 5.6B 参数的轻量级体量实现了此前需要数十亿参数乃至闭源大模型才能达成的能力。该模型同时支持文生图、指令式图编辑以及最多 10 张参考图的多图生成,具备原生 4K 输出、像素级精确编辑和坐标框布局控制等差异化功能。官方内部盲测显示,其在中文生图、编辑、多参考三项任务中均排名第一,超越...
DMAD – 字节联合德州农工开源的扩散模型少步蒸馏技术
DMAD(Distribution Matching as Adversarial Distillation)是由字节跳动与德州农工大学联合开源的少步蒸馏框架,核心目标是显著加速扩散模型的生成过程。该方法通过训练二分类判别器直接学习目标分布与学生分布之间的差异,省去传统蒸馏方法中辅助扩散模型的依赖,在ImageNet-64数据集上实现了FID低至1.04的一步生成效果,并将50步教师模型高效压缩为...
HelixWorld – Noiz AI 联合港科大开源的实时交互世界模型
HelixWorld 是 Noiz AI 与香港科技大学联合开源的实时交互式音视频世界模型,代表了生成式 AI 在空间智能领域的重要进展。该模型以单张静态图片和文字描述为输入,能够生成一个可供用户通过 WASD 键和方向键自由行走、转动视角的沉浸式三维世界,画面与立体空间音效同步实时生成,且声像随视角变化自然转换。基于 LTX-2.3 架构,HelixWorld 采用"双向教师 + 因果蒸馏"训练...
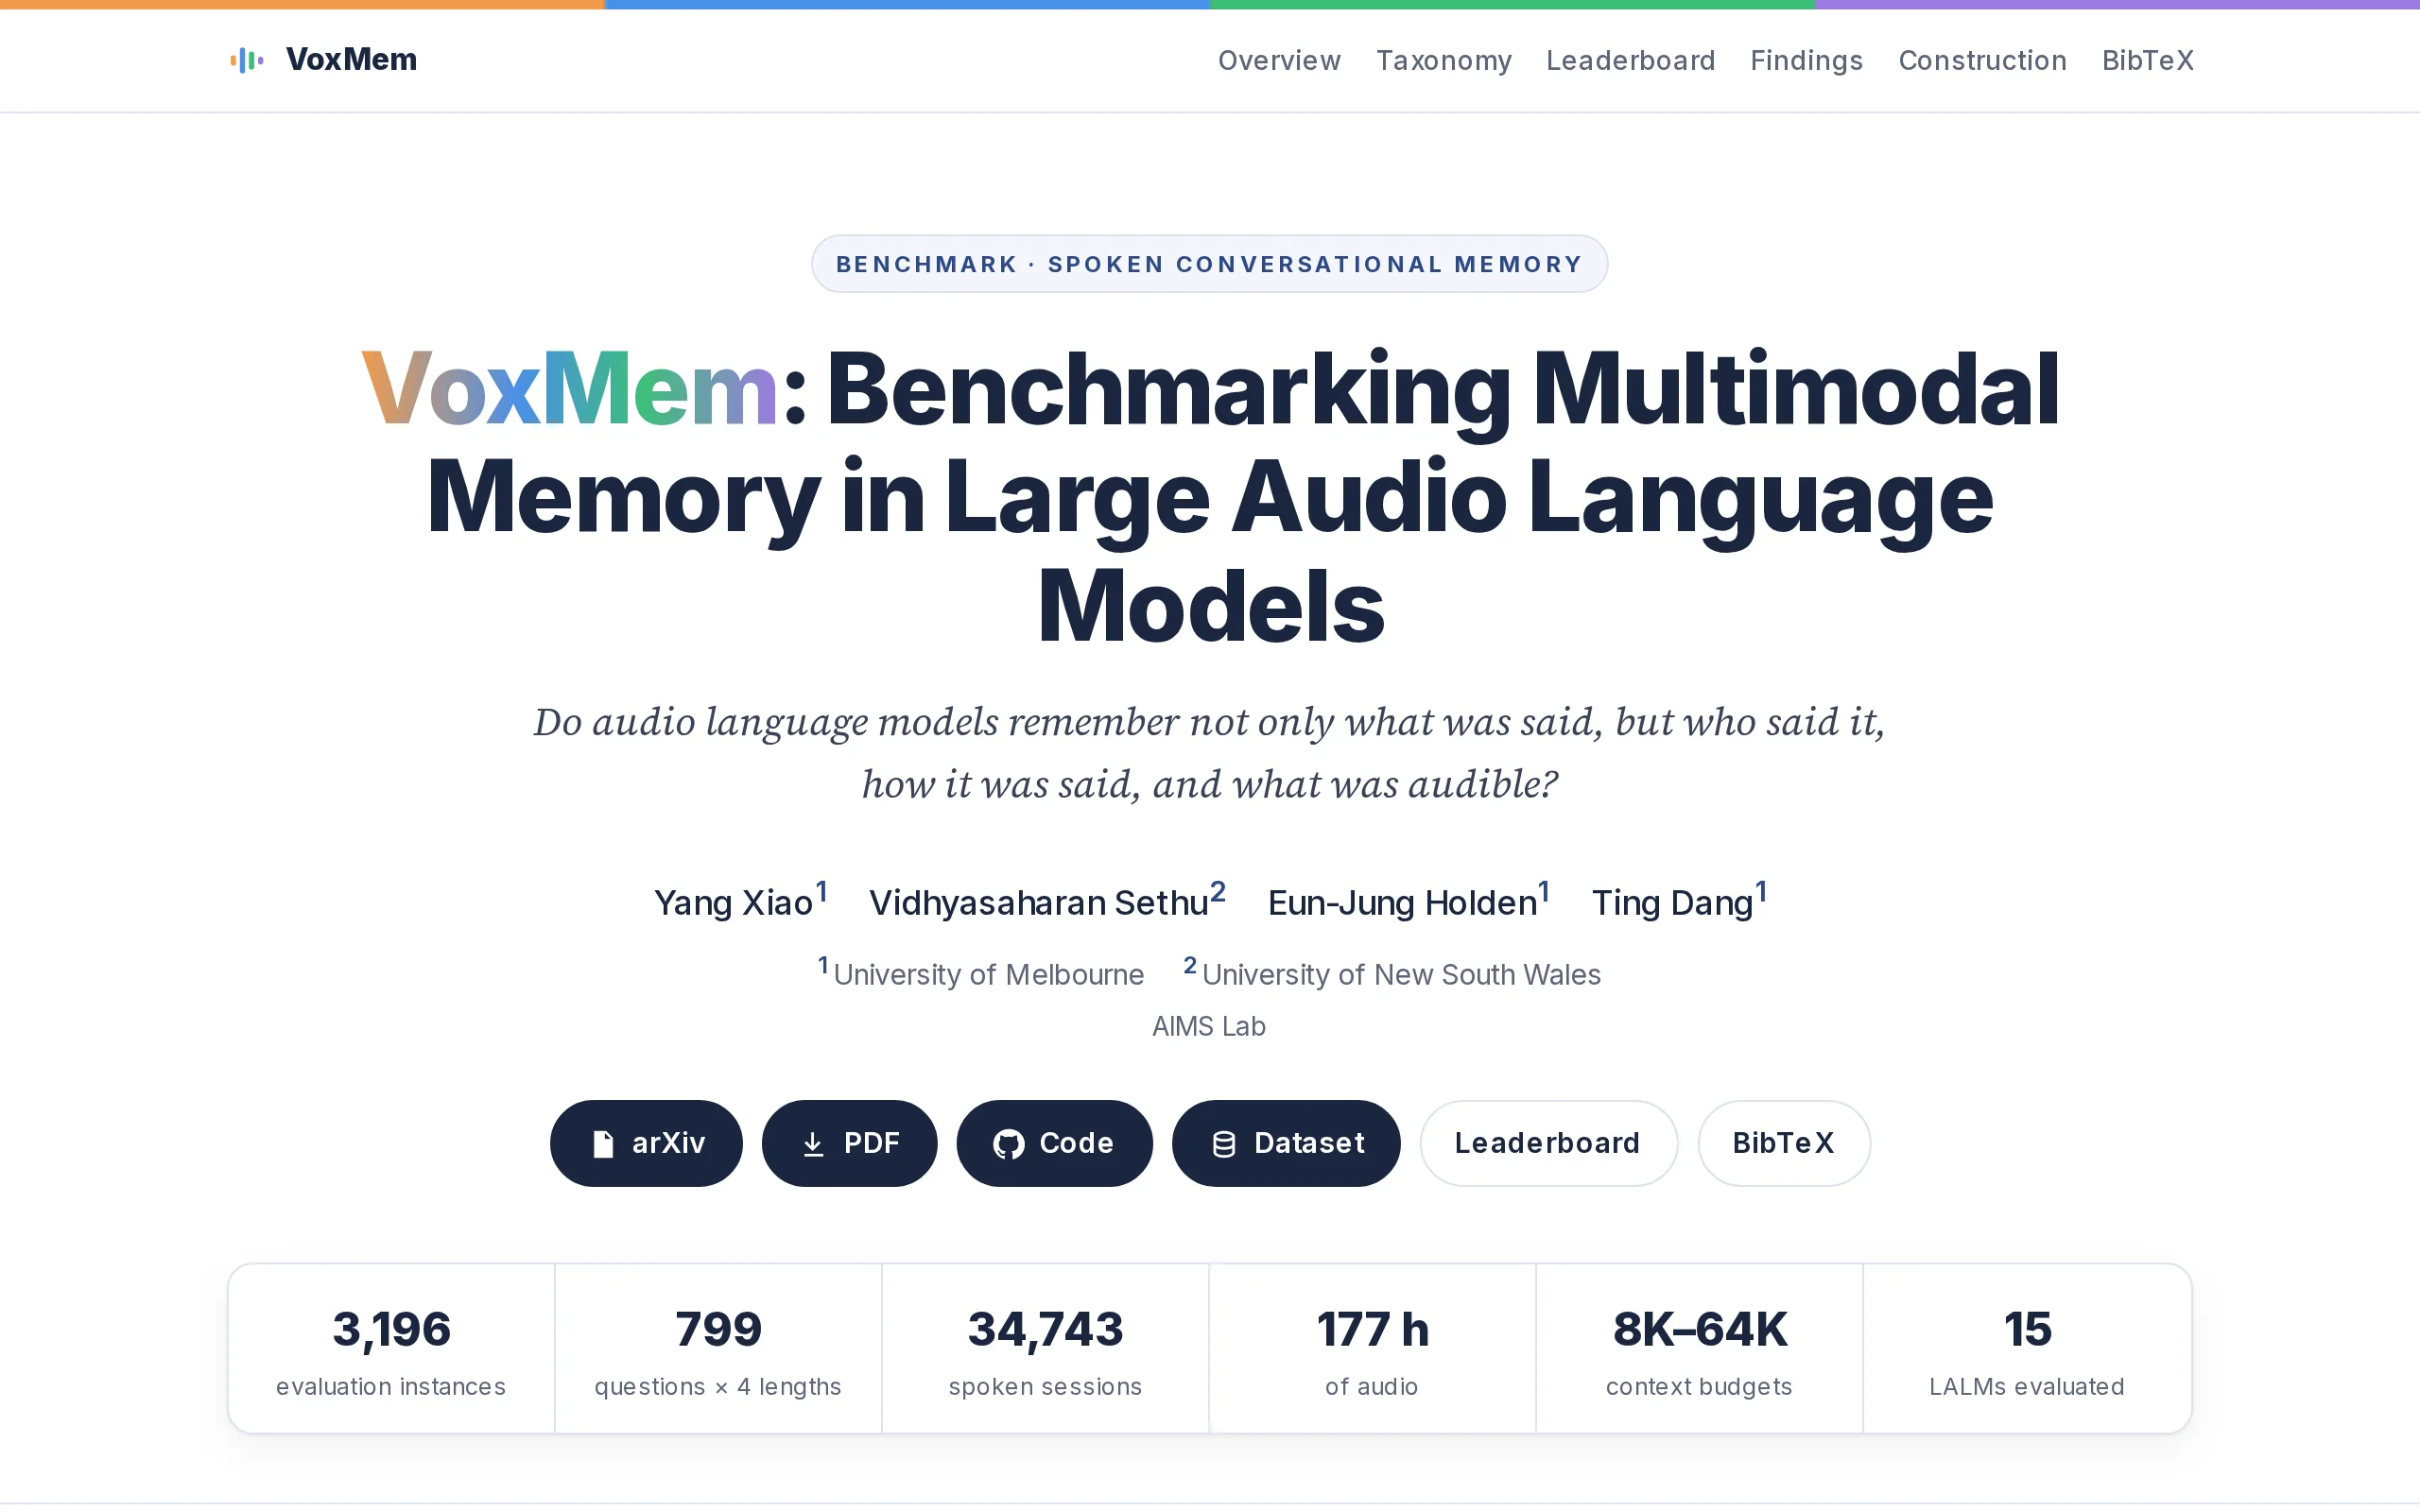
VoxMem – 墨尔本大学等开源的音频大模型记忆基准
VoxMem是由墨尔本大学与新南威尔士大学研究团队联合推出的音频大模型记忆基准(Benchmark)。该基准首创"4类声学证据×4种记忆操作"的二维评测框架,将语音语义、说话人身份、副语言线索与环境声四类信息维度,同信息抽取、跨会话推理、时序追踪与拒答四种记忆操作深度交叉,构建覆盖8K至64K token多会话历史的标准化评测体系。对15个主流模型的系统性测试显示,在32K上下文长度下,没有任何模...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。