
DuoMatching – 港中文联合字节开源的视频生成蒸馏框架
导读摘要:
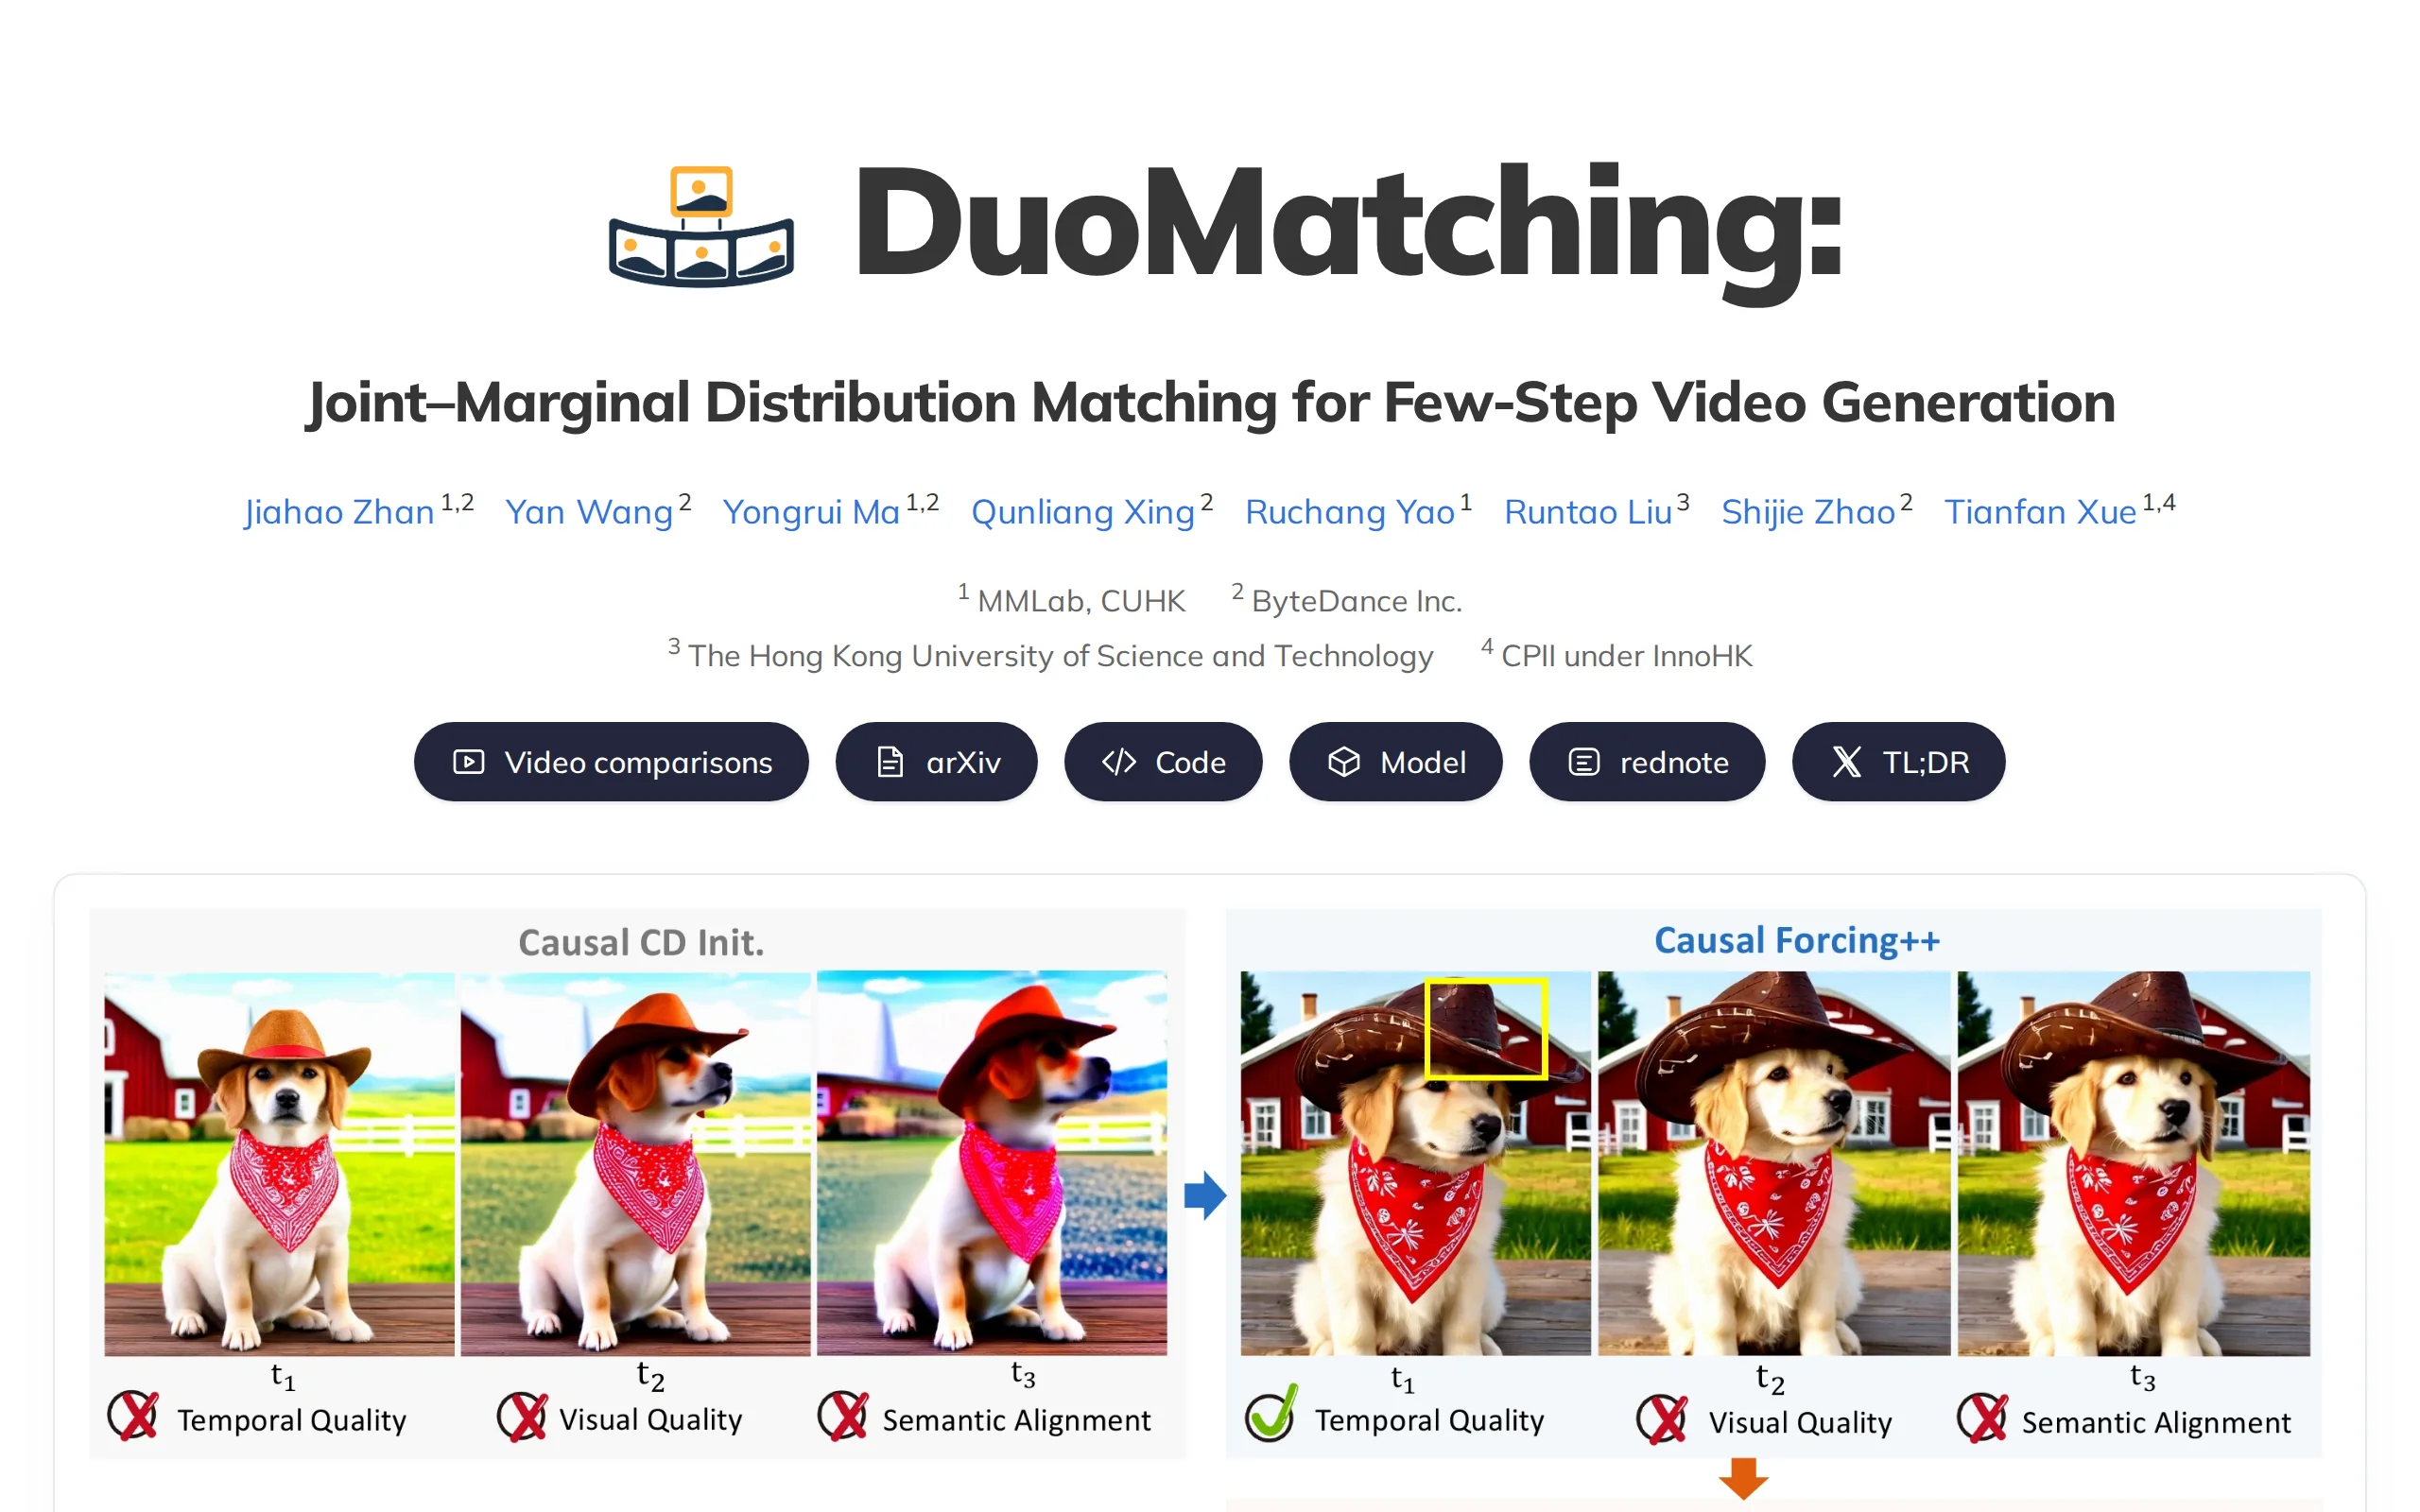
DuoMatching是由香港中文大学MMLab与字节跳动联合研发的少步视频生成蒸馏框架,其核心目标在于解决少步扩散模型在降低采样步数时面临的单帧画质退化与语义漂移问题。该框架通过解耦视频生成过程中的时序一致性与单帧质量优化两大任务,引入冻结的图像模型作为帧级监督信号,并借助LatentBridge模块实现视频与图像潜空间之间的高效映射,在保持视频跨帧运动连贯性的同时显著提升细节还原度与提示词遵循...
1. DuoMatching是什么
DuoMatching是由香港中文大学MMLab与字节跳动联合研发的少步视频生成蒸馏框架,其核心目标在于解决少步扩散模型在降低采样步数时面临的单帧画质退化与语义漂移问题。该框架通过解耦视频生成过程中的时序一致性与单帧质量优化两大任务,引入冻结的图像模型作为帧级监督信号,并借助LatentBridge模块实现视频与图像潜空间之间的高效映射,在保持视频跨帧运动连贯性的同时显著提升细节还原度与提示词遵循能力。该框架已完成开源,支持以2步或4步等低延迟配置生成高质量视频。
技术定位与领域: DuoMatching属于扩散模型蒸馏与视频生成交叉领域,重点探索在少步采样条件下同时保障时空一致性与单帧画质的技术路径。其核心创新在于将传统联合分布蒸馏与边际分布蒸馏相结合,形成双重分布匹配机制,使得视频老师模型与图像老师模型能够分别负责时序质量与帧级质量。
研发背景: 该框架由香港中文大学多媒体实验室(MMLab)与字节跳动联合推出。MMLab在视频理解与生成领域拥有深厚的技术积累,字节跳动则提供了工程化部署的实践经验。团队旨在克服现有少步蒸馏方法中画面细节丢失、语义偏差等已知局限。
核心价值: DuoMatching在训练阶段引入图像老师实现边际分布监督,同时保持视频老师的时序约束能力,且学生模型在部署阶段无需增加任何额外计算,即可在2步生成条件下获得VBench总分83.53的成绩,兼顾了生成速度、成本与输出质量。
技术特点: 提出1075万参数的LatentBridge模块桥接视频与图像潜空间,无需解码至RGB域即可完成监督信号传递;设计Latent Variation Sampling(LVS)策略,根据潜空间变化强度动态分配帧级监督预算,避免监督资源集中于静态画面。
2. 主要功能
双重分布匹配蒸馏: 在传统联合分布匹配(联合DMD)之外引入边际分布匹配(边际DMD)机制,视频老师负责整段视频的联合分布拟合以维持时序连贯性,图像老师对采样帧的边际分布进行约束以提升单帧画质。边际损失权重默认0.4,支持按任务需求调节。
LatentBridge潜空间映射: 针对视频VAE与图像VAE的latent结构不兼容问题,训练约1075万参数的转换模块,将视频latent切片直接映射至图像老师可理解的潜空间。该模块通过L1重建损失预训练,全程在潜空间完成运算,有效规避了解码至RGB再编码的高显存开销。
LVS帧级监督采样: Latent Variation Sampling根据相邻latent切片的变化强度对视频进行分段,再从各片段中遴选监督帧,每次默认采样4个切片。相比随机采样,该策略将有限的帧级监督预算聚焦于动态内容丰富的区域,避免了监督集中在静止画面的资源浪费。
少步低延迟生成: 支持2步、4步等低步数推理配置,学生模型在蒸馏后具备快速响应的能力,可胜任实时交互式应用对延迟的严格要求,同时维持了与高步数模型相近的视觉质量水平。
零额外推理开销: 图像老师模型仅参与训练阶段的监督工作,部署后的学生模型不包含任何图像模型的推理路径,因此生成延迟与计算成本与同等规模的少步模型完全一致,不因画质提升而增加服务端负担。
即插即用的模型升级路径: 框架设计将图像老师的选择与LatentBridge训练解耦,更换更强的图像监督模型时仅需重新训练对应的LatentBridge模块,无需改动学生模型的主干架构,为后续持续性能提升保留了灵活的扩展通道。
3. 应用场景
实时交互与直播生成: 面向数字人、虚拟主播与互动直播场景,利用少步低延迟特性快速生成动作与表情视频。2步推理配置可将等待时间压缩至实时反馈区间,在保持画面基本自然度的前提下支撑高频的交互响应需求。
广告与电商内容制作: 电商广告对产品材质、特定颜色和指定物体细节的呈现要求较高,DuoMatching通过图像老师强化语义对齐,可有效减少生成的广告画面与创意提示词不一致的情况,降低反复重试的素材制作成本。
短剧与动画预演: 剧本分镜与动态样片的初步验证阶段需要快速形成视觉草案,创作者可借助该框架以极低的成本批量生成角色动作与镜头设计的参考视频,在正式制作前验证镜头切换、运动节奏与视觉风格的可行性。
游戏与虚拟世界内容生成: 为游戏过场动画、角色技能展示或虚拟场景探索提供快速原型生成能力,交互式内容的开发过程中可以根据策划文案随时生成对应的动态素材,加速设计验证与沟通效率。
高并发视频生成服务: 面向C端用户提供视频生成功能的平台级服务,DuoMatching在训练阶段完成画质强化,使服务端在推理时无需增加额外计算即可获得高质量输出,适合需要统筹生成速度、服务成本与输出质量的规模化业务。
4. 如何使用
环境准备: 需要配备支持CUDA的NVIDIA显卡,显存建议不低于16GB(官方示例基于A100训练),操作系统支持Linux为主的主流平台,Python版本需为3.10。同时需确保CUDA驱动与PyTorch版本兼容。
项目安装: 克隆DuoMatching官方GitHub仓库,然后依次安装PyTorch、FlashAttention以及其他项目依赖项。此操作建议在独立的conda虚拟环境中完成,避免与现有环境产生依赖冲突。
模型权重下载: 获取Wan2.1-T2V-1.3B基础模型组件,以及DuoMatching官方发布的蒸馏权重。模型文件需按照仓库默认目录结构摆放,具体路径要求以官方仓库说明为准,缺失或错置可能导致加载失败。
提示词文件组织: 创建一个UTF-8编码的文本文件,每行书写一条提示词作为一条独立的生成请求。官方仓库提供了
prompts/demos.txt参考文件,可直接使用或按相同格式扩展自定义内容。执行推理: 运行
inference.py脚本,在命令行参数中指定推理配置、教师/学生权重路径、提示词文本路径以及输出目录。官方示例默认生成21帧视频,可通过参数调整输出帧数并设置随机种子以复现结果、保证多次生成的一致可控性。结果验证: 生成视频在输出目录中归档。建议对照提示词逐一检查语义对齐程度,并根据画面质量、运动幅度与一致性判断是否需要调整蒸馏权重、帧采样数量等超参数,以获得更优输出效果。
5. 优缺点分析
| 优点 |
|---|
| 单帧画质提升显著: 通过独立的帧级边际监督路径,有效缓解少步采样中毛发、纹理、材质等高频细节丢失问题,在VBench评测中获得83.53的综合成绩,画面精细度明显改善。 |
| 语义对齐准确度提升: 借助图像模型的语义先验,显著减少物体缺失、颜色错误与构图偏差等常见提示词遵循问题,生成结果与文本描述的一致性明显提高。 |
| 推理阶段零额外成本: 图像老师仅在训练期参与,部署阶段无需附加任何推理步骤或额外模型权重,服务成本与延迟完全等同于普通少步模型。 |
| 模块化设计支持持续迭代: 图像老师与LatentBridge松耦合,可随更强图像模型的发布灵活更换监督信号,无需修改学生主干,具备较好的可扩展性。 |
6. 同类工具对比
| 对比维度 | DuoMatching | Latent-Adversarial Diffusion Distillation (LADD) | SwiftBrush |
|---|---|---|---|
| 核心架构 | 联合DMD+边际DMD双重分布匹配,图像老师+视频老师协同监督 | 基于SDXL的潜空间对抗蒸馏,单阶段生成 | 文本到视频的一阶段蒸馏框架,无教师模型指导 |
| 性能指标 | VBench总分83.53(2步生成),时序与画质兼顾 | 在SDXL基座上单步生成质量优异,但主要面向图像 | 1-4步视频生成,与base模型性能一致性较好 |
| 功能特色 | LatentBridge潜空间桥接 + LVS动态采样策略,专为视频-图像跨域监督设计 | 无需文本编码器的对抗蒸馏,高效的单步生成 | 无需教师模型的自蒸馏方法,降低训练资源需求 |
| 部署方式 | 开源代码+预训练权重,本地部署推理,非商业限制待查 | 开源模型权重,基于扩散模型生态推理 | 开源推理代码,模型权重按需下载 |
| 易用性 | 依赖Wan2.1-T2V-1.3B底座,需按指定目录放置权重,有一定门槛 | 对SDXL生态用户较为友好,社区教程丰富 | 推理流程简洁,但训练复现成本较高 |
| 开源协议 | GitHub仓库开放,学术使用友好,商业授权需进一步确认 | 采用非商业使用许可,商用需另行授权 | 开源供研究使用,商用需联系团队 |
| 社区生态 | 项目刚发布,社区讨论与第三方扩展有限 | 基于Stable Diffusion生态,社区资源庞大 | 学术社区为主,工业应用案例较少 |
选型建议: 面向需要快速部署短视频生成服务并追求低延迟、低成本的应用方,DuoMatching在画质与速度之间取得的平衡具有实际价值,尤其适合以Wan2.1系列为底座的业务链路。若项目要求严格的商业使用授权或需要丰富的第三方工具链支持,LADD所依托的SDXL生态具备更强的成熟度。而侧重学术研究、希望在自蒸馏或数据高效路径上做进一步探索的团队,可参考SwiftBrush与SnapVideo的技术思路作为互补。
7. 编辑总结
DuoMatching在视频生成蒸馏领域提供了一种兼顾时序质量与单帧画质的创新范式。传统少步蒸馏方法往往在降低采样步数时面临细节丢失的瓶颈,而该框架通过引入独立的图像老师模型,将单帧视觉质量的优化任务从时序一致性约束中解耦出来,形成了清晰的功能分工。这一设计在技术逻辑上具有较好的普适性,不仅适用于当前的Wan2.1-T2V-1.3B底座,也为其他视频扩散模型的蒸馏训练提供了可借鉴的方法论。LatentBridge模块的高效潜空间映射以及LVS动态采样策略,则从工程层面回应了跨域监督与计算效率这两个实际问题,体现了研究团队对训练流程细节的深入把握。
从实用价值来看,DuoMatching最直接的受益场景是高并发、低延迟的视频生成服务,其“训练时增强、部署时零成本”的特性使其成为一个兼顾服务质量与运营成本的适配方案。对于内容创作平台、实时互动应用以及需要快速生成视觉素材的团队,这一框架均具备较高的落地可能性。当然,该框架对显存资源有一定的要求,且作为新开源项目,其社区生态和配套文档尚处于初期积累阶段,早期采用者需要具备一定的技术调试能力。
综合来看,DuoMatching在少步视频生成的质量优化方向上提供了具备学术创新性与工程实用性的解决方案。随着社区对LatentBridge与LVS策略的进一步验证和优化,这一框架有望成为视频生成蒸馏领域的重要参考实现,并在后续迭代中持续扩大其适用边界。
8. 常见问题FAQ
Q:DuoMatching的边际损失权重如何调节?
A:边际损失默认权重为0.4,增大该权重会增强图像老师对单帧画质与语义对齐的约束效果,但过高的权重可能削弱视频老师对时序一致性的主导作用。建议根据目标场景在0.2-0.6区间内进行梯度式调试,观察生成视频的运动流畅度与细节质量变化。
Q:LatentBridge需要单独训练吗?
A:首次使用需要完成预训练,该模块以L1重建损失学习将视频latent切片映射至图像VAE潜空间的任务。更换图像老师模型时,需要配套重新训练对应的LatentBridge,训练计算量相对可控,且预训练完成后仅参与训练期的前向计算。
Q:生成结果画面模糊或细节不足如何处理?
A:此情况通常与底座的Wan2.1-T2V-1.3B基础质量有关。可先确认提示词描述是否具体且包含足够的属性限定,再尝试增大LVS的采样切片数量或微调边际损失权重以强化帧级监督。若问题仍存在,需重新评估基础模型的适用性。
Q:模型能否在16GB显存的显卡上运行推理?
A:使用官方权重进行少步推理时,16GB显存的显卡可以完成基础生成任务,但具体取决于输出帧数与分辨率配置。官方示例默认生成21帧,若需生成更长或更高分辨率的视频,建议根据实际显存占用调整参数设置。
Q:推理开销是否包含图像老师模型的计算?
A:不包含。图像老师仅在蒸馏训练阶段提供监督信号,部署阶段的学生模型不包含图像模型的任何计算路径,因此推理延迟与计算成本与标准少步视频模型保持一致,这是该框架的核心设计优势之一。
9. 项目地址
- 项目官网:https://johnzhan2023.github.io/DuoMatching/
- GitHub仓库:https://github.com/JohnZhan2023/DuoMatching
- HuggingFace模型库:https://huggingface.co/JohnZhan/DuoMatching
- arXiv技术论文:https://arxiv.org/pdf/2610.03543
相关推荐
Genie 4 – Google DeepMind 推出的一代世界模型
Genie 4是Google DeepMind推出的新一代世界模型,能够实时生成可自由探索的虚拟世界。用户通过键盘操控角色移动,通过文字提示实时修改天气、添加人物或物体,并与虚拟角色进行交互对话。该模型首次支持原生音频与交互式对话能力,融合Gemini家族的多项技术——Gemini负责推理规划,Genie负责环境渲染,形成完整的智能体闭环。Genie 4可应用于机器人训练、影视预演、游戏原型验证及...
WorldSonus:港科大联合上海交大开源的实时流式视频配音框架深度评测
WorldSonus是由香港科技大学联合 Noiz AI、MetaX 及上海交通大学共同开源的流式视频配音框架,核心定位在于实现“视频流边生成、音频边输出”的实时交互式配音能力。该框架以 100ms 为一块进行增量生成,单块计算耗时仅 41.2ms,可持续输出 48kHz 立体声音频,显存占用恒定,支持无限时长跟流。有别于传统的离线双向配音模型,WorldSonus 采用因果 AR-Diffusi...
Voyager – 开源的桌面创作 Agent,覆盖完整制作流程
Voyager 是 Nullframe 推出的开源桌面创作 Agent,旨在通过自然语言交互将 AI 能力直接嵌入创作者现有的专业软件工作流中。与云端 AI 创作平台不同,Voyager 能够在本地直接调用 Photoshop、Premiere、After Effects、DaVinci Resolve、Blender 等专业软件,同时内置设计、视频和音频生成工具,覆盖从素材生成、剪辑、动效到配音...
GPT-6.1 Terra – OpenAI 推出的高效执行型大模型深度评测
GPT-6.1 Terra是OpenAI推出的高效执行型大模型,面向办公自动化与高频Agent任务场景,重点强化视觉理解、电脑操作、事实准确性与编程能力。该模型能够阅读技术图纸、处理发票、填写表格、编辑视频并操作桌面软件,标准API价格较上一代降低50%,任务执行速度与成本效益均实现显著优化。GPT-6.1 Terra已接入ChatGPT Work和Codex平台,定位为大规模处理日常工作的低成本...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。