
EvaOmni – 上海交大、复旦等开源的全模态大模型评测基准
导读摘要:
EvaOmni是由上海交通大学、复旦大学、腾讯优图实验室等机构联合开源的全模态大模型评测基准,旨在解决现有视频理解评测中"答对但说不出依据"的深层缺陷。该基准包含392段真实视频、1,027道人工标注问答,覆盖15种能力维度和3个推理层级,要求模型在给出答案的同时返回音频与视频证据的时间区间,并按照答案准确率、证据覆盖度和双模态定位三项指标进行综合评分。实测24个主流全模态模型中,表现最强的Gem...
1. EvaOmni是什么
EvaOmni是由上海交通大学、复旦大学、腾讯优图实验室等机构联合开源的全模态大模型评测基准,旨在解决现有视频理解评测中"答对但说不出依据"的深层缺陷。该基准包含392段真实视频、1,027道人工标注问答,覆盖15种能力维度和3个推理层级,要求模型在给出答案的同时返回音频与视频证据的时间区间,并按照答案准确率、证据覆盖度和双模态定位三项指标进行综合评分。实测24个主流全模态模型中,表现最强的Gemini3.7-Flash准确率达到79.4%,但双模态定位得分仅为35.1%,与人类专家的94.3%差距高达59.2个百分点,这一数据充分暴露了当前模型在证据溯源能力上的显著短板。
技术定位与领域: 属于多模态大模型评测与基准测试领域,聚焦于音频-视频联合理解能力的系统性评估。EvaOmni的独特定位在于将"证据定位"纳入评测核心,推动行业从单纯的答案正确率导向转向可解释、可溯源的推理能力验证。
研发背景: 由上海交通大学、复旦大学、腾讯优图实验室等多家顶尖学术与产业机构联合开发。研发动机源于现有视频问答基准(如Video-MME)仅考察答案正确性,无法区分模型是真正理解视听内容还是依赖单模态捷径作答,因此需要一套更严格的评测体系来揭示模型真实能力。
核心价值: 解决了视频理解评测中"猜对与有据可依无法区分"的关键问题。通过要求模型输出双模态证据时间区间,并采用证据覆盖与瓶颈定位双指标量化证据质量,EvaOmni能够精准定位模型在检索、理解和长程多跳推理等不同深度上的具体短板,为模型迭代提供可操作的改进方向。
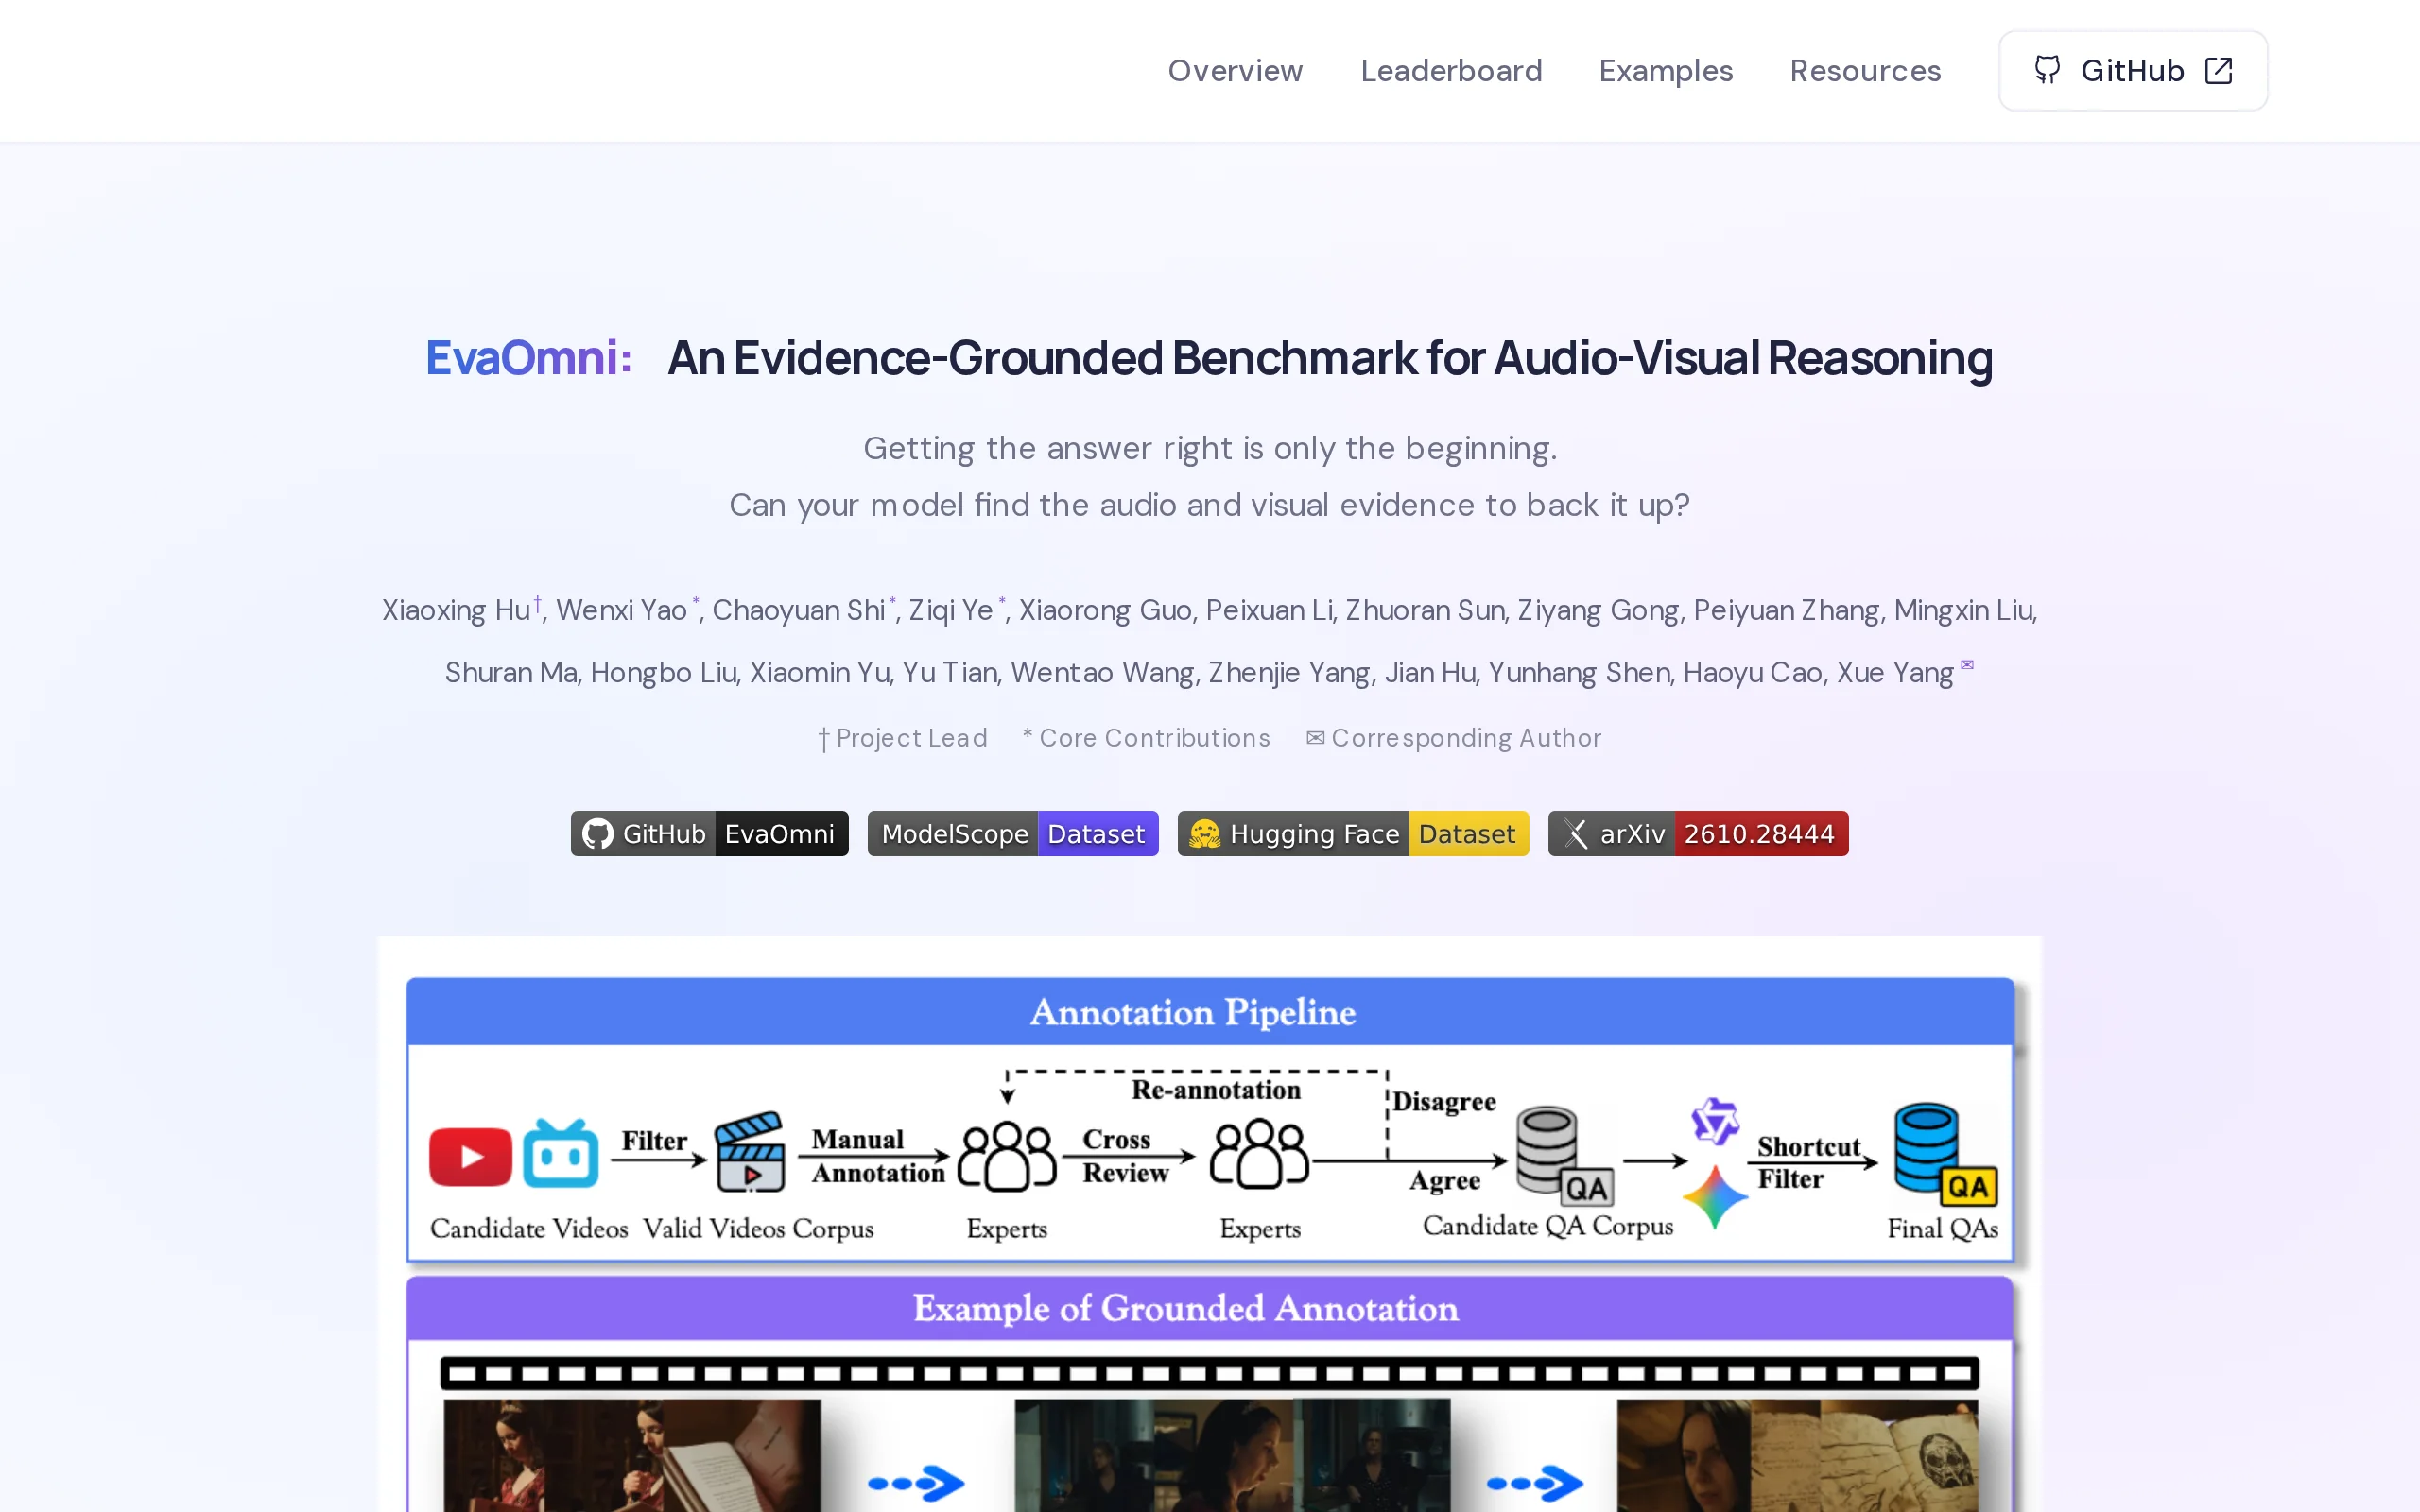
技术特点: 构建了四阶段数据生产流水线(视频筛选、人工标注、交叉审核、捷径过滤),通过文本、音频、视觉三种单模态输入筛查剔除可被捷径答对的题目;同时设计了覆盖-定位双指标评分体系,以较弱模态定分,杜绝用强模态弥补弱模态的投机行为。
2. 主要功能
答案评测(Acc.): 判断模型在视听选择题上的回答是否正确,输出整体准确率指标。该指标作为基础评分项,为后续证据质量评估提供前提条件,确保只有答案正确的样本才进入证据定位的深度分析。
证据标注与返回: 每道题均由人工标注支持答案的音频与视频时间区间,模型需随答案一同返回双模态证据区间。这一设计将模型的输出从单一的选项扩展为"选项+音频时间戳集合+视频时间戳集合"的三元组结构,使评测程序能够分别核对答案正确性与证据定位质量。
证据覆盖评分(C.G.): 统计人工标注的证据段被模型预测区间命中的比例,衡量模型是否找齐了所有支持线索。该指标侧重于"找没找到"的召回能力,允许宽泛预测获得一定分数,但不区分边界的精确程度。
双模态瓶颈定位(B.G.): 分别对音频和视频计算时序交并比(IoU),并取两种模态中较弱的一方作为最终得分。这一设计强制要求模型在两种模态上同时实现准确定位,从机制上杜绝了用强模态掩盖弱模态的能力缺陷,确保评测结果的真实性和公平性。
三级能力分层: 数据集按推理与证据复杂度组织为三个层级:Level 1检索与定位考查时间、事件、实体在音视频间的对齐能力;Level 2基础理解要求融合互补的视听线索理解事件、情绪与意图;Level 3复杂推理要求整合分散在不同时间点的多条证据完成多跳判断。层级越高,单题证据数量和覆盖时长显著增加。
捷径过滤机制: 通过文本、音频、视觉三种单模态输入分别让模型作答,凡能被单一模态或文字常识答对的题目一律返修重标。这一机制从数据层面系统性地阻断了"绕过视听联合推理"的捷径,保证评测题目必须依赖真正的跨模态理解才能解答。
模型横向评测与排行榜: 提供24个全模态模型的统一基准与排行榜,涵盖开放权重模型与专有模型。研究人员可通过标准化协议接入自有模型,与现有榜单结果进行直接对比,支持模型选型与技术迭代决策。
3. 应用场景
全模态模型研发评测: 模型团队在迭代Omni大模型时,可利用Acc./C.G./B.G.三项指标精准定位"答案提升但证据定位没跟上"的能力断层。例如,当模型准确率提升但B.G.得分停滞时,说明模型在时间感知和跨模态对齐方面存在结构性缺陷,可针对性地调整训练数据和模型架构。
企业级AI选型验收: 金融、政务、医疗等需要模型"给出可核对依据"的行业场景,采购方可通过B.G.瓶颈定位分筛选真正具备双模态可靠性的模型。相比仅看准确率,证据定位指标能有效识别那些"看似聪明实则缺乏依据"的模型,降低业务落地风险。
视频内容审核与溯源: 内容审核类应用要求模型明确指出违规内容"在哪个画面、哪段声音"中出现。EvaOmni的时间区间输出格式与定位指标可直接作为审核系统的验收标准,帮助构建可追溯、可复核的自动化审核流程。
教育/影视内容的问答产品: 带视频的学习助手和影视解说类产品需要引用原片片段作答。开发者可使用EvaOmni评估模型能否准确定位到相关镜头与台词,确保产品在回答用户问题时能提供可验证的视频依据,提升用户体验和内容可信度。
学术研究与榜单建设: 研究者可基于开源的392段带证据标注视频开展视听推理、时间定位、多跳推理等方向的深入研究,或将其纳入多基准联合评测体系。该基准为学术社区提供了高质量的标注数据资源,支持可复现的实验对比。
4. 如何使用
安装ModelScope客户端: 执行
pip install -U modelscope命令安装或升级ModelScope SDK。该SDK是下载数据集和模型权重的基础工具,建议使用Python 3.8及以上版本环境。下载数据集: 使用
dataset_snapshot_download函数,指定数据集ID为VisionXLab/EvaOmni-Dataset,将全部数据拉取到本地目录。数据集包含392段视频、1,027道问答及对应的音频/视频证据区间标注文件。准备模型输入: 按评测协议对视频进行预处理,包括统一分辨率、帧率等参数,并配套提取音频内容。确保输入格式与待评模型的接口规范一致,避免因格式问题影响推理结果。
接入待评模型: 按照GitHub仓库的接入说明,将你的全模态模型接入评测框架。使用统一的提示词模板,让模型输出"选项+音频时间戳+视频时间戳"的三元组结构,确保输出格式可被评测程序正确解析。
运行评测: 调用评测框架在全部1,027道问答上执行批量推理。评测程序会自动核对答案正确性、计算证据区间与人工标注的重合度,并输出各项指标得分。建议在GPU环境下运行,以缩短推理时间。
查看结果与分析: 读取Acc.、C.G.、B.G.三项核心指标及三级能力分层成绩,与排行榜中的现有模型结果进行对比。通过分析不同推理层级的表现差异,定位模型在检索、基础理解和复杂推理等环节的具体短板,为后续优化提供数据支撑。
5. 优缺点分析
| 优点 |
|---|
| 证据定位纳入评分: 要求模型返回音频与视频证据时间区间,有效区分"猜对"与"有据可依",推动评测从答案导向转向可解释性导向,填补了现有基准在证据溯源维度的空白。 |
| 双指标量化证据质量: 证据覆盖分C.G.衡量找没找齐线索,瓶颈定位分B.G.按时序IoU取较弱模态定分,杜绝用强模态掩盖弱模态,评测机制设计严谨且具有创新性。 |
| 三级能力分层精细: 从检索定位、基础理解到复杂多跳推理逐级递进,能够将模型短板定位到具体推理深度,为训练改进提供明确的优先级指导,实用价值较高。 |
| 捷径过滤机制严格: 通过文本、音频、视觉三种单模态输入系统性筛查题目,剔除绕过视听联合推理即可答对的样本,评测公平性在同类基准中处于较高水平。 |
| 揭示真实能力鸿沟: 实测显示最强模型答案准确率与人类仅差17个百分点,双模态定位却差59.2个百分点,有力揭示了当前模型在证据溯源方面的系统性短板,具有较高的行业警示价值。 |
6. 同类工具对比
| 对比维度 | EvaOmni | Video-MME |
|---|---|---|
| 规模 | 392段视频、1,027道问答 | 900段视频、2,700道问答,总时长约254小时 |
| 核心定位 | 答案正确性+视听证据定位双评 | 视频综合理解广谱评测(时长/领域/模态覆盖) |
| 评测指标 | Acc.+证据覆盖C.G.+双模态瓶颈定位B.G.三项 | 仅选择题准确率,可按是否带字幕/音频做消融对比 |
| 证据标注 | 每题标注音频+视频时间区间,模型需返回区间 | 无证据区间标注,只标注答案与字幕 |
| 模态要求 | 强制音频+视频双模态定位,缺一不可 | 音频、字幕为可选辅助输入,可开关 |
| 防捷径设计 | 四阶段流水线+文本/音频/视觉单模态筛查返修 | 要求题目与视频内容绑定、专家反复观看标注,但无系统化单模态筛查 |
| 任务分层 | 3级推理层级(检索定位/基础理解/复杂多跳) | 12种任务类型,按时长分短/中/长三档 |
| 适用场景 | 检验"答得对且说得出依据",适合Agent与可解释选型 | 检验广谱视频理解水平,适合通用能力横向对比 |
选型建议: 如果评测目标是验证模型在真实场景中的可解释性和证据溯源能力,EvaOmni是当前最具针对性的选择。其双模态定位指标能有效识别"答对但说不出依据"的模型,尤其适合金融、政务、内容审核等对可追溯性有刚性需求的场景。对于需要全面评估模型在多种视频理解任务上泛化能力的团队,Video-MME凭借更大的规模和更广的任务覆盖仍是通用能力横向对比的可靠基准。
在模型研发迭代场景中,建议将EvaOmni与Video-MME联合使用:用Video-MME快速筛查模型的整体能力基线,再用EvaOmni深度剖析证据定位短板。这种组合策略既能保证评测的覆盖面,又能获得可操作的改进方向,尤其适用于全模态大模型的迭代优化周期。
7. 编辑总结
EvaOmni的发布标志着视频理解评测从"答案正确率"单一维度向"答案+证据"双维度的范式转变,这一创新具有重要的行业价值。从技术创新性来看,其双指标评分体系(C.G.+B.G.)和三级能力分层设计在同类基准中具有显著的差异化优势,特别是以较弱模态定分的机制设计,从评测机制层面杜绝了模型投机行为,推动了评测公平性的提升。实测数据揭示的能力鸿沟——最强模型与人类专家在双模态定位上相差59.2个百分点——为全模态模型的发展指明了关键瓶颈所在。
从实用价值角度,EvaOmni为企业AI选型提供了更具辨识力的评估工具。在金融、政务、内容审核等需要可追溯依据的场景中,仅依赖准确率选型存在较大风险,而EvaOmni的证据定位指标能够有效筛选出真正具备双模态理解能力的模型。该基准适用于全模态模型研发团队、AI采购决策者、内容审核系统开发者以及从事视听推理研究的学术人员,尤其适合那些关注模型可解释性和落地可靠性的用户群体。
展望未来,EvaOmni的开放数据集和标准化评测协议为行业建立统一的证据定位评测标准奠定了基础。随着更多机构采用该基准进行模型迭代和选型验证,有望推动全模态模型在证据溯源能力上的持续进步。数据规模的扩展和中文场景的覆盖将是其后续发展的重点方向,也是其在更广泛行业场景中发挥价值的关键。
8. 常见问题FAQ
Q:EvaOmni与Video-MME的核心区别是什么?
A:EvaOmni在答案准确率之外,额外要求模型返回音频和视频证据的时间区间,并通过证据覆盖(C.G.)和双模态瓶颈定位(B.G.)两项指标量化证据质量。而Video-MME仅考察选择题答案正确率,不涉及证据定位。EvaOmni更侧重检验模型的证据溯源和可解释性能力。
Q:为什么B.G.指标要取音频和视频IoU中较弱的一方?
A:这是为了防止模型用强模态弥补弱模态的投机行为。如果取平均值或最大值,模型可以只准确定位视频而忽略音频,仍能获得较高得分。取较弱模态定分,强制要求模型在两种模态上同时实现准确定位,确保评测结果真实反映模型的双模态联合理解能力。
Q:模型输出的时间戳格式有什么要求?
A:模型需要输出"选项+音频时间戳集合+视频时间戳集合"的三元组结构。时间戳以区间形式表示,评测程序按时序交并比(IoU)计算与人工标注区间的重合程度。具体格式规范可参考GitHub仓库的接入文档。
Q:捷径过滤机制是如何工作的?
A:每道题会分别以仅文本、仅音频、仅视觉三种单模态输入让模型作答。如果模型在任一单模态条件下能答对题目,说明该题可被捷径解决,不依赖真正的视听联合推理,这类题目会被返修重标或剔除,确保最终评测题目必须依赖跨模态理解才能解答。
Q:如何将自有模型接入EvaOmni评测框架?
A:首先从GitHub仓库获取评测框架代码,然后按照文档说明将模型封装为统一接口,确保输出格式为选项+双模态时间戳的三元组。评测框架会批量处理1,027道问答,自动计算Acc.、C.G.、B.G.三项指标及三级能力分层成绩。
Q:EvaOmni的数据集是否可以免费用于商业用途?
A:数据集通过HuggingFace和ModelScope公开发布,遵循开源协议。具体许可条款请参考各发布平台上的许可证说明。学术研究和商业应用通常均可使用,但建议在正式商用前确认具体的授权条款。
9. 项目地址
相关推荐
MiniMax H3-Image – MiniMax 开源的图像生成模型
MiniMax H3-Image 是 MiniMax 官方开源的图像生成模型,其底层基于 MiniMax 自研的 H3 多模态基础模型构建,完整支持文生图、图像参考与图像编辑三大核心任务。凭借模型架构层面的预训练积累与后训练阶段的强化学习优化,H3-Image 能够在约 10 秒内生成 4096×4096 分辨率、约 1600 万像素的 4K 级图像,生成结果在细节丰富度和真实感方面表现突出。模型...

Muse Ember 评测:Meta 重新定义轻量级模型的效率边界
Muse Ember 是 Meta 于 2026 年中推出的最小参数规模 AI 模型,专为智能体(Agent)高频重复性任务设计。据官方基准测试数据,该模型以约 1/3 于 Claude Haiku 5.5 的单任务成本达到与之持平的综合跑分,并在智能体工作流(AutomationBench-AA)中以 37.8 分大幅领先,位居 Artificial Analysis 效率前沿。其核心配置包括 ...
Sophon-Realtime v1 深度评测:开源全双工语音对话模型的技术突破与工程实践
Sophon-Realtime v1 是由 AI降临派(Adventists AI)开源的全双工语音对话模型,基于 32B 参数规模设计,实现了边听边判断话轮、随时可被打断、理解语气与副语言信息、并以带感情的声音进行回应的完整对话能力。该模型在语音评测基准 VoiceBench 上取得 82.8 分,位列开源全双工模型第一,与 GPT-4o-mini-Audio 持平。项目提供 Tag(表现力强)...
Apollo World – 百度 Apollo 推出的全模态世界模型,赋能自动驾驶闭环仿真与数据飞轮
Apollo World是百度Apollo推出的面向物理AI的智能体驱动全模态世界模型。与传统仿真工具不同,该系统基于真实数据构建虚拟城市,其中车辆、行人及非机动车均为具备自主决策能力的AI智能体,而非遵循固定脚本的静态道具。模型能够实时生成相机画面与激光雷达点云等多模态观测数据,与无人驾驶车辆形成感知、决策、行动的闭环交互。Apollo World支持从任意起点到终点的完整出行任务,已直接投入萝...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。