
FireRedAudio – FireRedTeam 推出的通用音频语言模型

导读摘要:
FireRedAudio 是 FireRedTeam 推出的通用音频语言模型,代码、权重和论文都已公开。它用一个共享的 9B 自回归 LLM 做推理主干。理解与生成走解耦的连续表征:Audio Encoder 负责理解,RedAE 与 flow-matching DiT 负责生成。
1. FireRedAudio是什么
FireRedAudio是由FireRedTeam开发的通用音频语言模型,代码、权重和论文均已公开。该模型基于一个9B参数的自回归大语言模型(LLM),实现音频理解与生成的统一架构。通过解耦的连续表征路径,FireRedAudio使用Audio Encoder进行音频理解,RedAE与flow-matching DiT负责音频生成。尽管音色还原度不及最强的专用TTS系统,FireRedAudio仍为需要整合多种音频任务的团队提供了高效解决方案。
技术定位与领域: 属于音频处理和自然语言处理领域,旨在统一音频理解与生成任务,支持多种音频处理需求。
研发背景: 由FireRedTeam开发,该团队在音频处理和大语言模型领域有深厚的技术积累,致力于推动音频AI技术的发展。
核心价值: 通过共享推理主干,FireRedAudio简化了多任务模型的部署与管理,降低了资源消耗和开发复杂度。
技术特点: 不依赖专用speaker embedding,直接使用参考语音的RedAE表征作为合成条件,实现高效音频生成。
2. 主要功能
- 多任务统一架构: FireRedAudio通过共享9B参数的自回归LLM,实现音频理解与生成的统一,简化多任务处理流程。
- 高效音频理解: 使用Audio Encoder对输入音频进行编码,提取关键特征,支持语音识别、音频分类等任务。
- 高质量音频生成: 通过RedAE与flow-matching DiT,FireRedAudio能够生成高质量的音频,适用于语音合成、音乐生成等场景。
- 解耦表征路径: 理解与生成任务使用不同的表征路径,确保各自任务的优化与独立性。
- 不依赖专用speaker embedding: 通过参考语音的RedAE表征进行合成,减少模型依赖,提高灵活性。
- 支持多种音频任务: 适用于语音识别、语音合成、音频分类、音乐生成等多种音频处理任务。
- 开源与透明: 提供完整的代码、权重和论文,支持学术研究与商业应用,促进技术发展。
- 跨平台兼容性: 支持多种主流硬件平台,包括华为昇腾、沐曦、燧原等国产芯片(待官方公布)。
3. 如何使用
- 环境要求: 支持华为昇腾、沐曦、燧原等国产芯片,操作系统建议为Linux或Windows(待官方公布)。
- 安装步骤: 下载GitHub仓库中的代码,并按照仓库提供的环境配置说明进行安装。
- 模型部署: 从Hugging Face模型页下载对应权重,并使用提供的命令或脚本进行模型部署。
- 运行服务: 启动推理服务,通过API接口调用模型进行音频理解或生成任务。
- 注意事项: 在使用前,务必仔细阅读官方文档中的环境配置说明,确保所有依赖项正确安装。对于复杂的音频任务,建议进行充分的测试与调优。
4. 优缺点分析
| 优点 |
|---|
| 多任务统一架构: 通过共享9B参数的自回归LLM,实现音频理解与生成的统一,简化多任务处理流程。 |
| 高效音频理解: 使用Audio Encoder对输入音频进行编码,提取关键特征,支持多种音频理解任务。 |
| 高质量音频生成: 通过RedAE与flow-matching DiT,能够生成高质量的音频,适用于多种生成任务。 |
| 解耦表征路径: 理解与生成任务使用不同的表征路径,确保各自任务的优化与独立性。 |
5. 同类工具对比
| 工具 | 核心架构 | 性能指标 | 功能特色 | 部署方式 | 易用性 | 开源协议 |
|---|---|---|---|---|---|---|
| FireRedAudio | 9B参数自回归LLM | 待官方公布 | 多任务统一架构,不依赖专用speaker embedding | 本地/云端 | 代码、权重和论文公开 | 待官方公布 |
| Tacotron 2 | 专用TTS架构 | 行业公认高 | 专注于高质量语音合成,音色还原度高 | 本地/云端 | 代码公开,但权重需自训练 | Apache 2.0 |
| WaveNet | 专用音频生成架构 | 行业公认高 | 生成高质量音频,支持多种音频风格 | 本地/云端 | 代码公开,但权重需自训练 | Apache 2.0 |
| ESPnet | 通用音频处理框架 | 行业公认高 | 支持多种音频任务,包括ASR和TTS | 本地/云端 | 代码和权重公开 | MIT |
选型建议:
- 如果项目需要高效整合多种音频任务,FireRedAudio是一个值得考虑的选择,其多任务统一架构能够简化开发流程。
- 对于需要高质量音色还原的配音生产场景,Tacotron 2和WaveNet依然是更优的选择,它们在音色相似度方面表现更出色。
- ESPnet虽然功能全面,但需要更多的配置与调优,适合有较强技术背景的团队使用。
6. 编辑总结
FireRedAudio在多任务音频处理领域展现了显著的技术创新,通过共享9B参数的自回归LLM,实现了音频理解与生成任务的统一。这种架构不仅简化了多任务处理流程,还减少了资源消耗和开发复杂度。然而,FireRedAudio在音色还原度方面仍有提升空间,官方论文指出其说话人相似度低于最强的专用TTS系统。尽管如此,对于需要整合多种音频任务的团队,FireRedAudio依然具有较高的实用价值。此外,FireRedAudio的开源性质和透明的代码、权重及论文发布,为学术研究和商业应用提供了便利,促进了音频AI技术的发展。未来,随着更多细节的公布和社区的贡献,FireRedAudio有望在更多应用场景中发挥更大的作用。
7. 应用场景
- 语音识别: 通过Audio Encoder提取音频特征,FireRedAudio能够高效地进行语音识别任务,适用于语音助手、会议记录等场景。
- 语音合成: 使用RedAE与flow-matching DiT,FireRedAudio能够生成高质量的语音,适用于虚拟主播、有声读物等应用。
- 音频分类: FireRedAudio的音频理解能力支持对不同类型的音频进行分类,适用于音乐推荐、噪声识别等场景。
- 音乐生成: 通过音频生成模块,FireRedAudio可以生成不同风格的音乐,适用于音乐创作、背景音乐生成等应用。
8. 常见问题FAQ
Q:如何下载FireRedAudio的代码和权重?
A:您可以从GitHub仓库下载代码,从Hugging Face模型页下载权重。使用前请仔细阅读仓库中的环境配置说明。
Q:FireRedAudio支持哪些硬件平台?
A:FireRedAudio支持华为昇腾、沐曦、燧原等国产芯片,具体硬件需求待官方公布。
Q:FireRedAudio的性能如何?
A:FireRedAudio的具体性能指标如基座型号、MMAU、MMSU、FLEURS-102等评测分数尚未公布,建议关注官方更新。
Q:FireRedAudio的开源协议是什么?
A:FireRedAudio的开源协议和许可证信息尚未披露,使用时需关注官方更新。
Q:FireRedAudio是否适合商业应用?
A:FireRedAudio的开源性质和透明的代码、权重及论文发布,为商业应用提供了便利。建议在具体应用场景中进行充分测试与调优。
9. 项目地址
- GitHub 仓库:https://github.com/FireRedTeam/FireRedAudio
- Hugging Face 模型页:https://huggingface.co/FireRedTeam/FireRedAudio
- arXiv 论文:https://arxiv.org/pdf/2608.24168
相关推荐
Ming-3.0:蚂蚁百灵开源全链路语音模型家族深度评测
Ming-3.0是蚂蚁集团百灵大模型团队开源的全链路语音系列模型,围绕语音合成(TTS)、音频理解与对话(Audio)、语音识别(ASR)三类核心任务推出五款模型。该系列以"合成+理解+识别"一体化能力覆盖语音应用全流程,其中TTS系列支持独创的"导演模式"精细控制情绪、节奏与重音,Audio系列可端到端理解长录音并结构化输出,ASR系列支持热词注入与方言识别。模型已落地支付宝、阿福APP等蚂蚁内...
GPT-Live-1.1 – OpenAI 推出的 ChatGPT 一代语音模型
GPT-Live-1.1是OpenAI于2025年推出的ChatGPT新一代语音模型,接替上一代GPT-Live-1成为语音交互的「前台引擎」,同时以轻量版GPT-Live-1.1 Quip替代原mini版本。该模型延续了经典的全双工交互架构,模型无需等待用户说完即可持续采集语音流,实时判断停顿、打断与语速变化,动态决定回应时机,支持用户随时插话或改变提问方向,使对话节奏接近真人交流。在复杂任务处...
MiDashengLM-Spatial – 小米开源的空间音频理解大模型
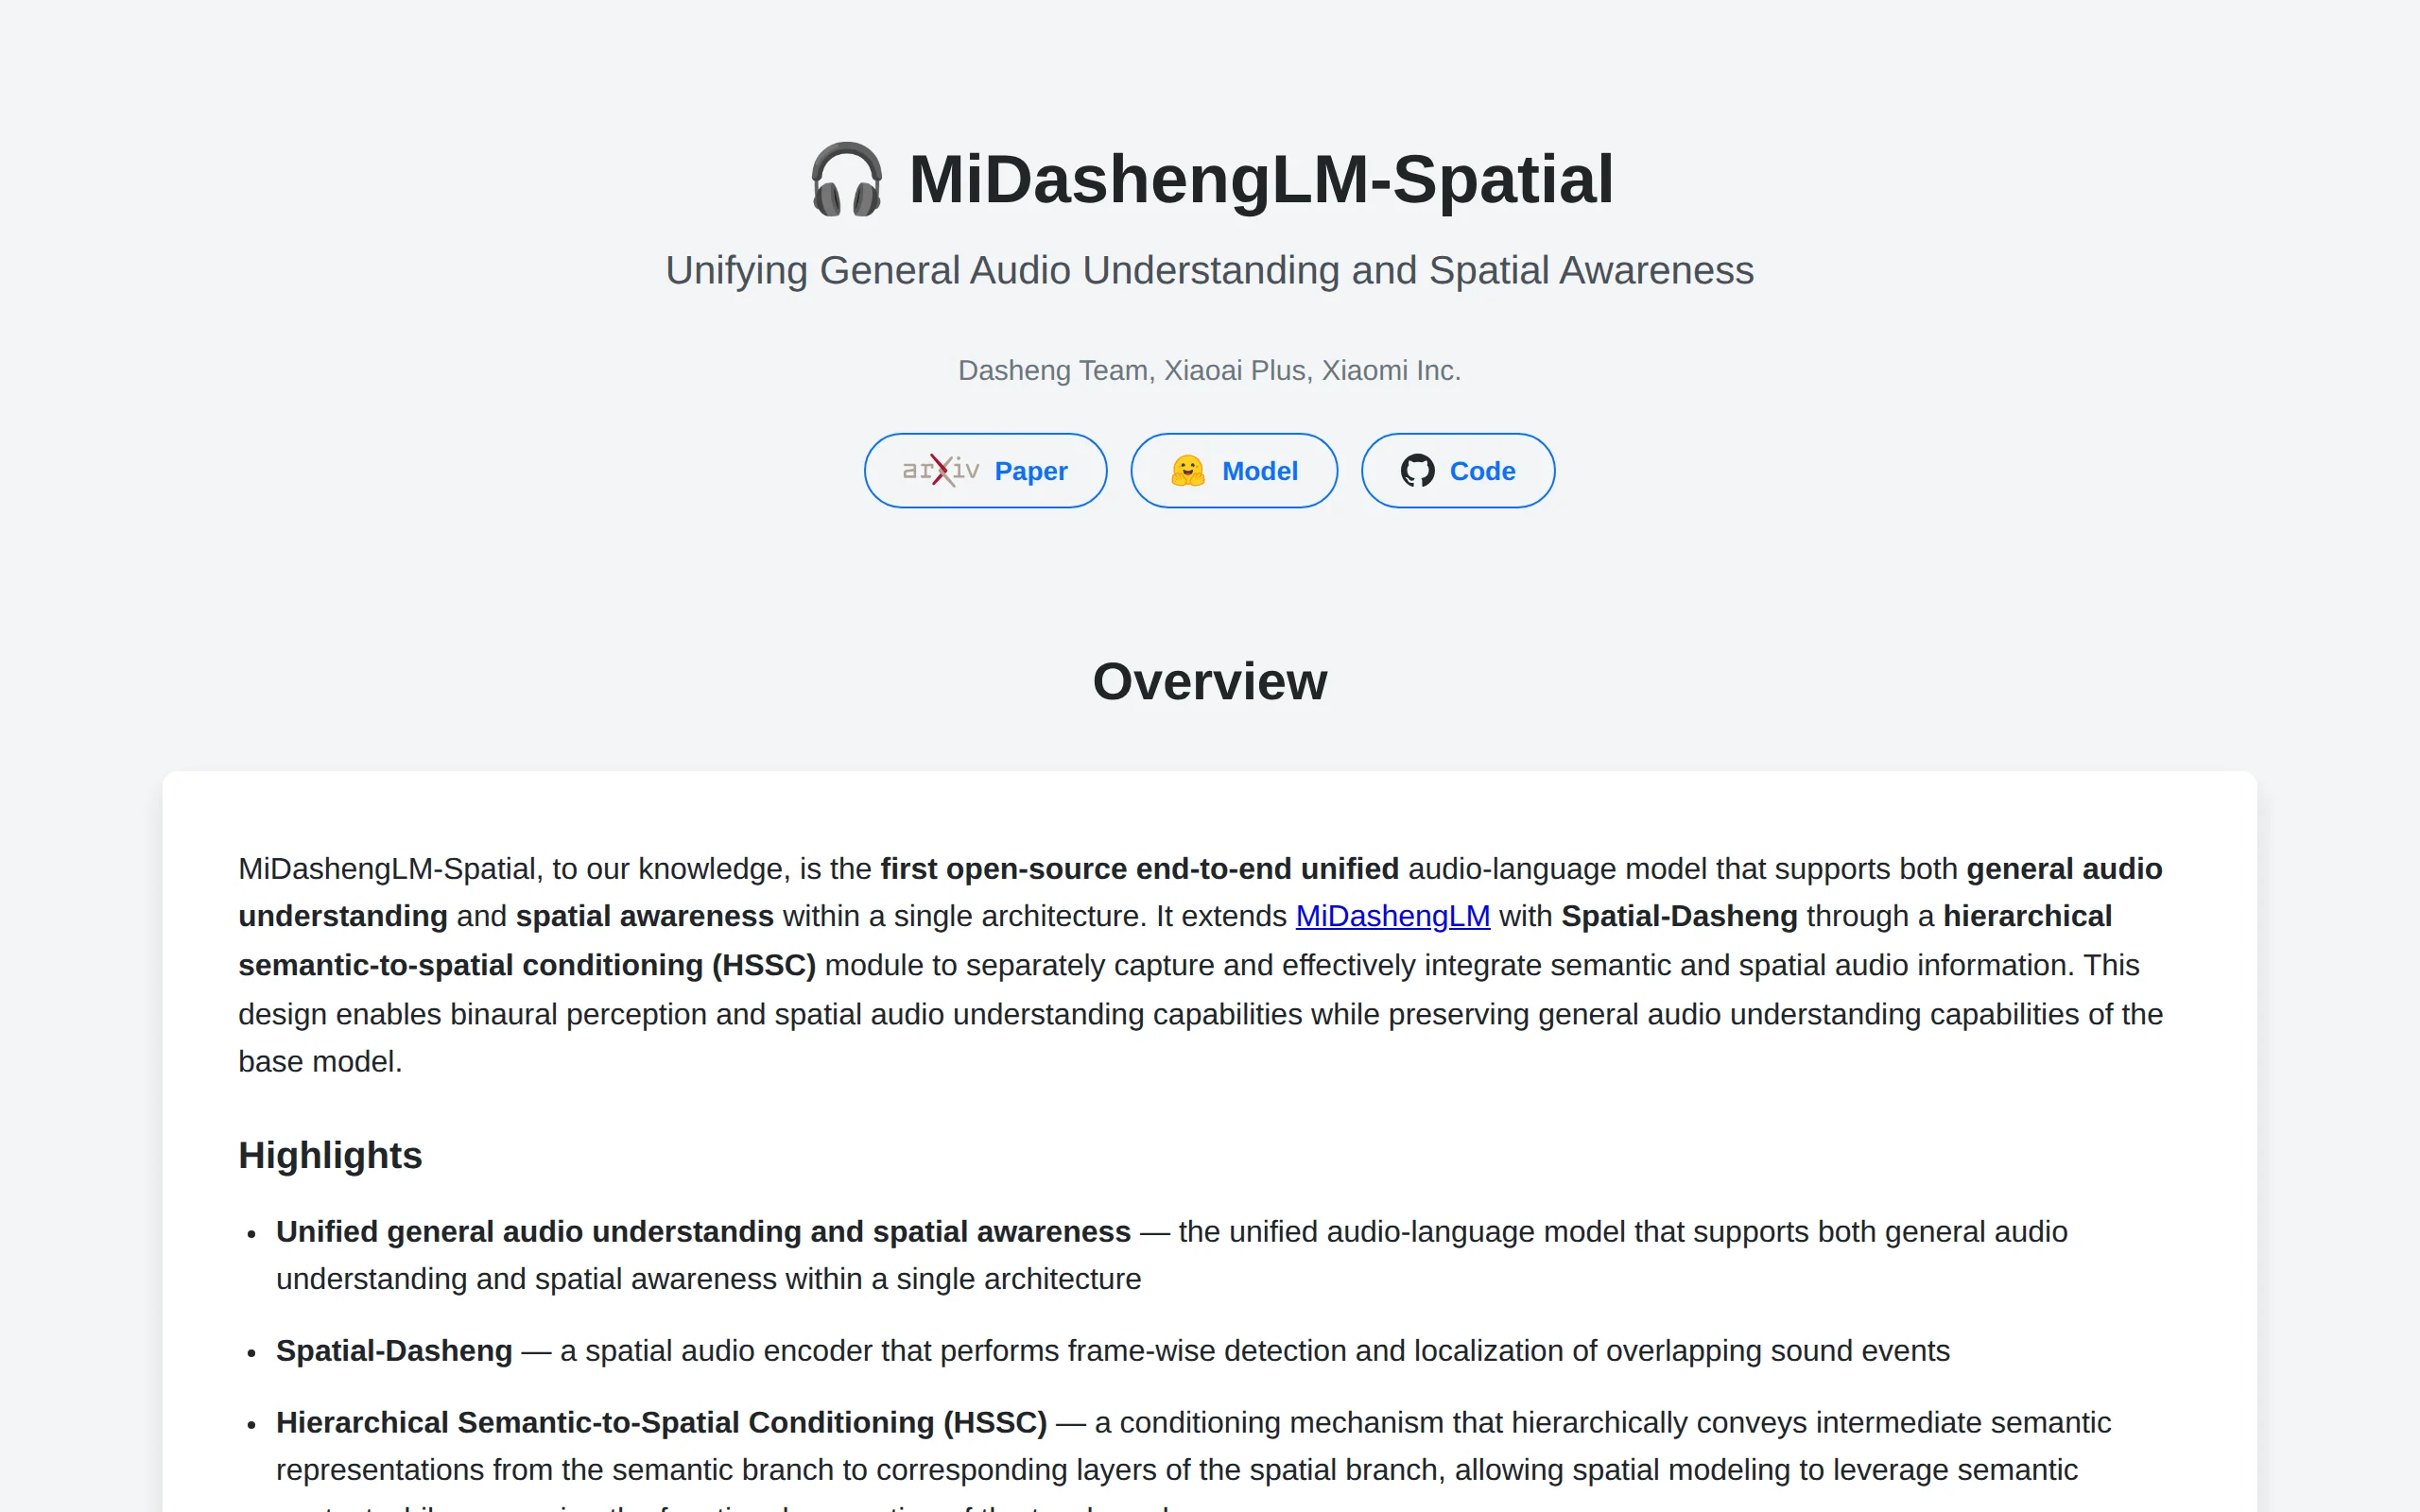
MiDashengLM-Spatial是小米Dasheng团队开源的空间音频理解大模型,业界首个在单一架构内统一通用音频理解与空间感知的端到端模型。该模型以MiDashengLM-7B为基座,通过新增Spatial-Dasheng空间音频编码器和层级语义到空间条件模块(HSSC),实现了声源方位感知、运动轨迹追踪以及多声源时空关系推理等能力,并支持重叠声源逐帧定位。配套数据方面,模型使用100万个...
YoVoice – 开源本地音频创作工具,实现从语音合成到乐谱编曲的全链路覆盖
YoVoice 是一款面向 macOS 和 Windows 平台的开源本地音频创作工具,由开发者 leemysw 发布,致力于为用户提供从文字转语音、零样本声音克隆到 AI 音乐作曲和五线谱编曲的完整创作链路。该工具基于 C++ 推理引擎 audio.cpp 构建,无需配置 Python 环境,安装即用,所有推理计算均在本地 GPU/CPU 完成,不依赖任何云端 API,从根源上保障了用户音频数据...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。