
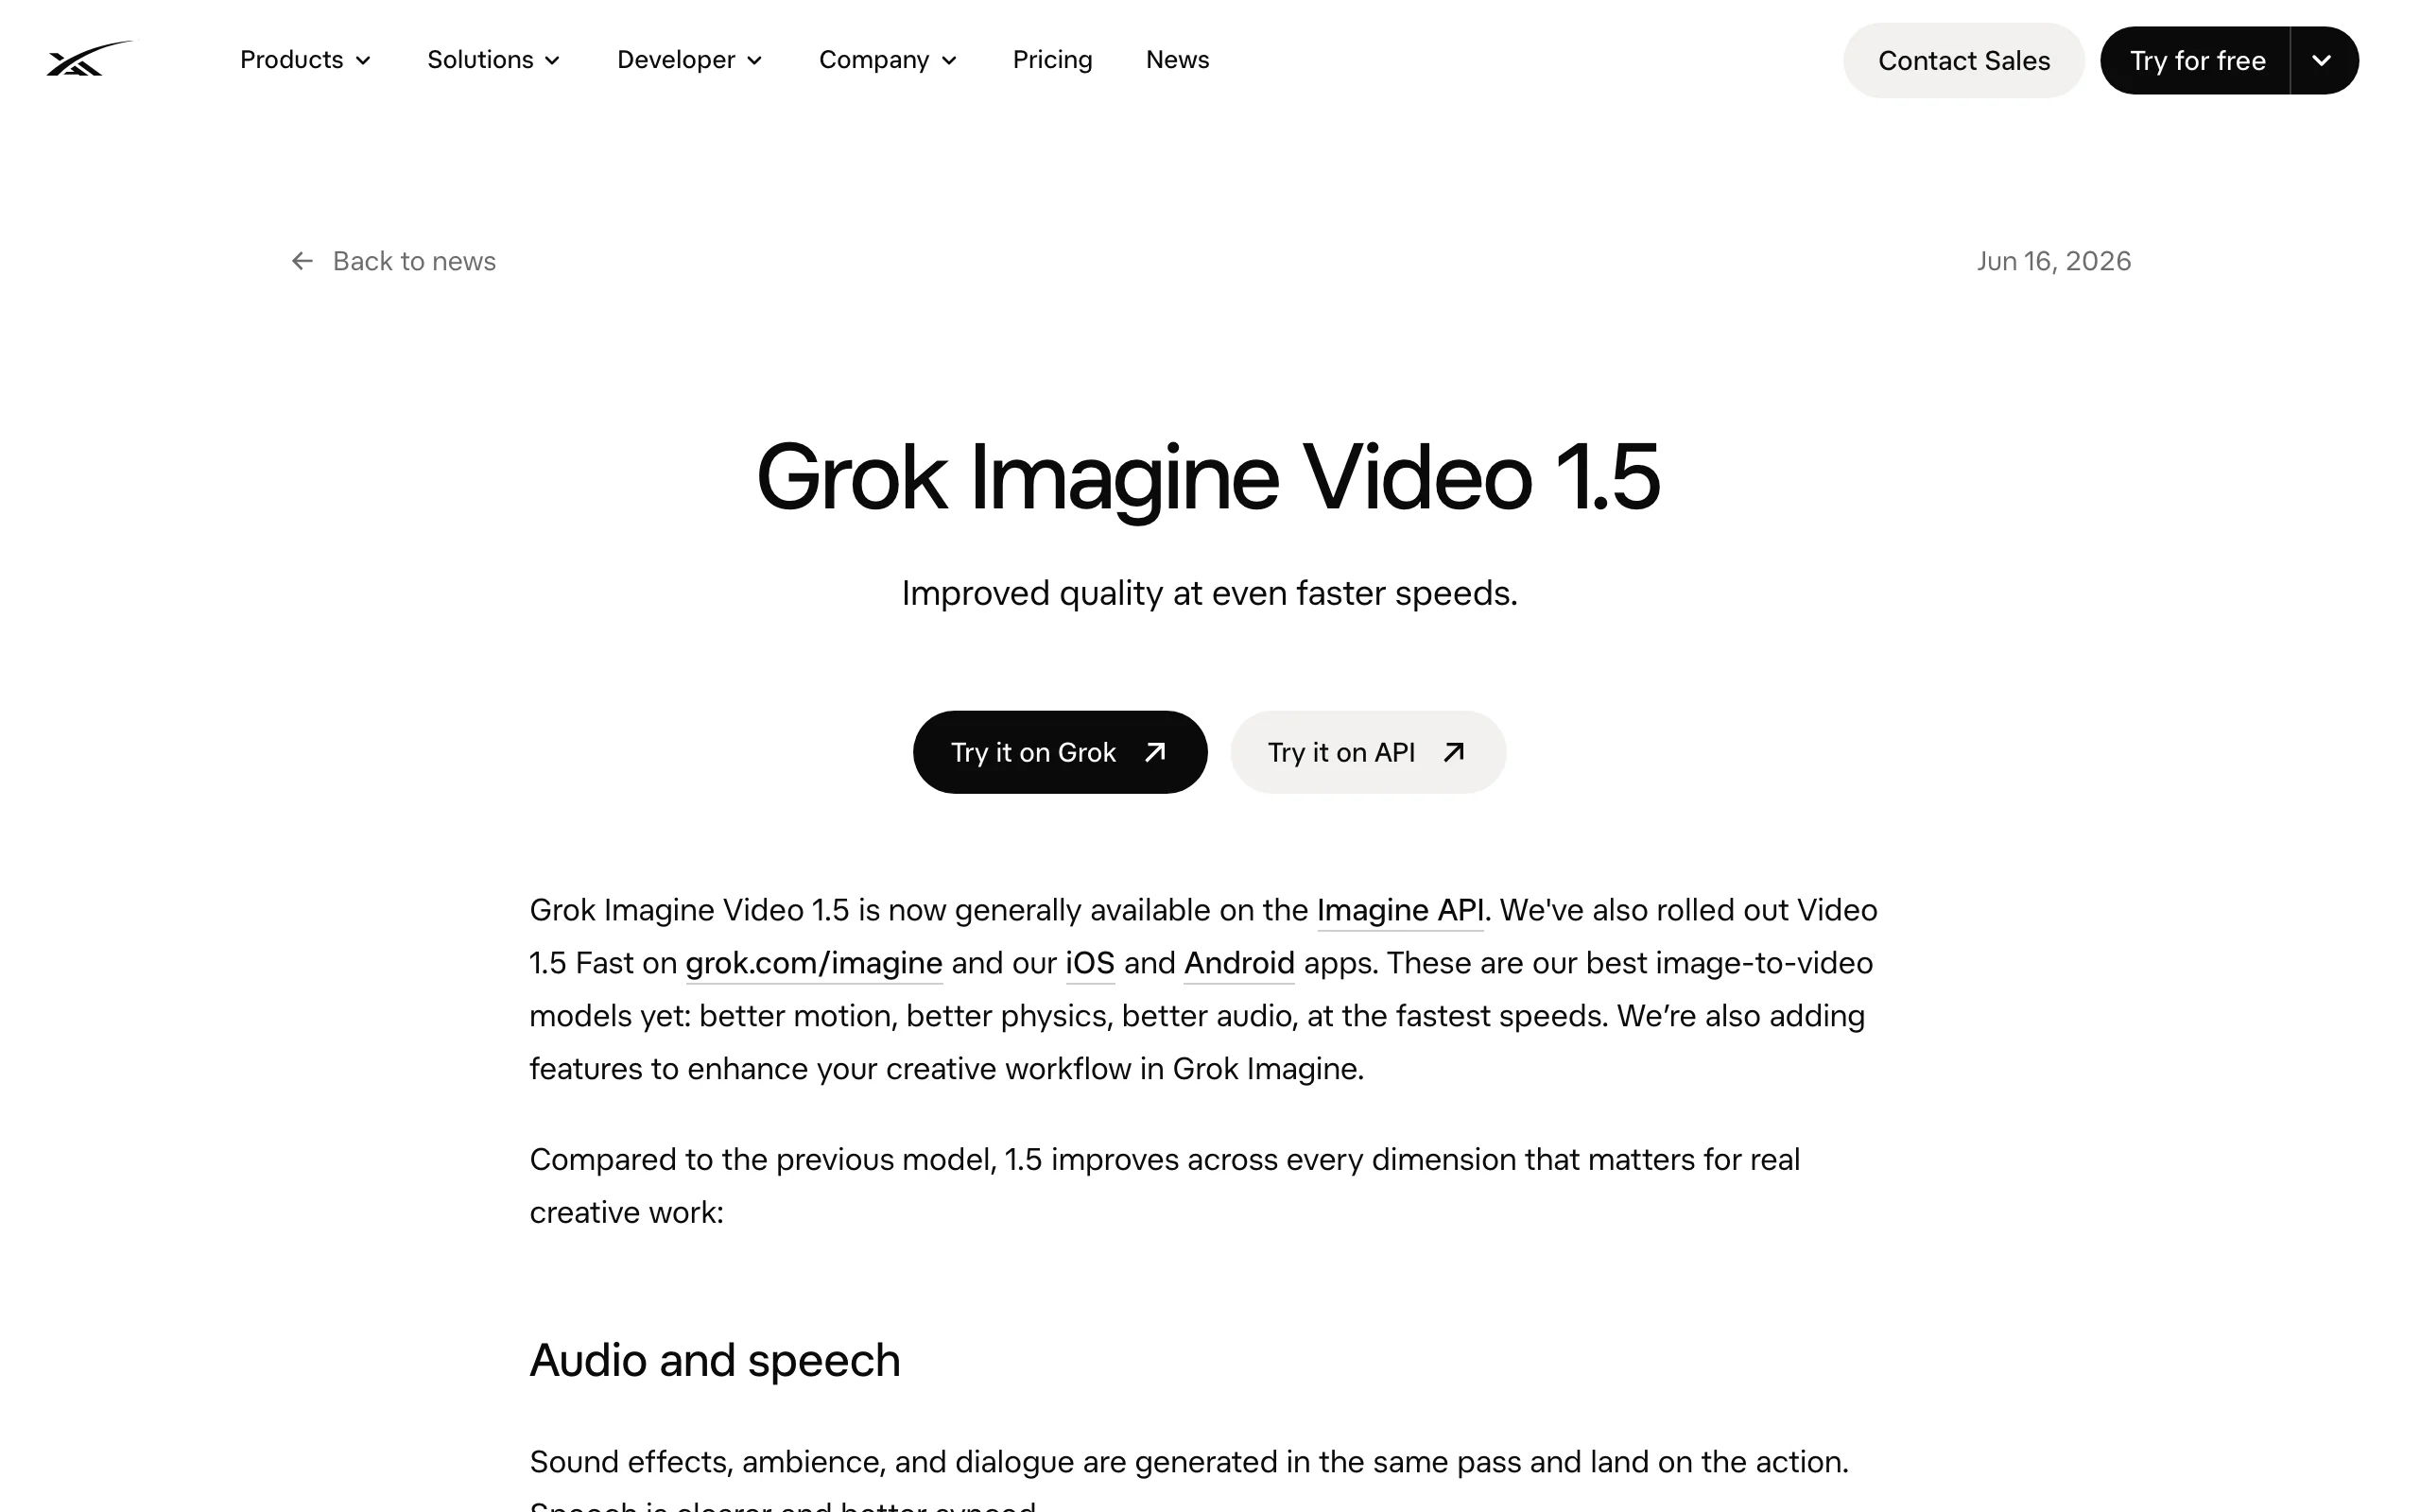
Grok Imagine Video 1.5 – xAI 推出的图生视频模型
导读摘要:
Grok Imagine Video 1.5 是由 xAI 推出的新一代图生视频模型,基于自研 Aurora 自回归引擎构建。该模型支持用户上传单张静态图片,通过自然语言提示一键生成带原生同步音频的短视频,最高支持 720p 分辨率。在 Fast 模式下,生成一段 6 秒 720p 视频仅需约 25 秒,显著提升了内容创作效率。模型在 Arena.ai 图生视频榜单中排名第一,Elo 评分约 13...
1. Grok Imagine Video 1.5 是什么
Grok Imagine Video 1.5 是由 xAI 推出的新一代图生视频模型,基于自研 Aurora 自回归引擎构建。该模型支持用户上传单张静态图片,通过自然语言提示一键生成带原生同步音频的短视频,最高支持 720p 分辨率。在 Fast 模式下,生成一段 6 秒 720p 视频仅需约 25 秒,显著提升了内容创作效率。模型在 Arena.ai 图生视频榜单中排名第一,Elo 评分约 1330,较前代提升 52 分,综合表现领先主流竞品。目前通过 xAI API 按秒计费对外开放,是当前业界在音视频同步生成、物理真实感模拟方面最具竞争力的解决方案之一。
技术定位与领域: Grok Imagine Video 1.5 属于多模态生成式 AI 领域,专注于图像到视频的转换任务,同时支持文本到视频生成。其独特定位在于将视频生成与原生音频合成整合为单一前向传播过程,实现了音画同步的高效生成,区别于传统需要后期配音的图生视频方案。
研发背景: 该模型由 xAI 研发团队基于 Aurora 自回归引擎架构开发。xAI 在自回归生成模型领域积累了深厚的技术底蕴,Aurora 引擎通过逐帧预测生成视频序列,保证了画面运动的时间连贯性。此次升级聚焦于生成速度、物理真实感和音画同步质量的全面提升。
核心价值: Grok Imagine Video 1.5 解决了传统图生视频方案中常见的运动连贯性差、物理模拟失真、音画不同步等核心痛点。通过原生音视频联合建模,在单一前向传播中同时生成视频帧与音频波形,大幅降低了后期制作成本。对于社交媒体内容创作者、广告团队和影视预可视化工作者而言,该模型提供了一条从静态创意到动态成品的高效路径。
技术特点: 模型采用自回归延展机制,支持从现有视频的最后一帧继续生成后续片段,可将多段短镜头串联为更长场景。同时,物理真实感增强算法优化了运动连贯性与重量感模拟,明显减少了人物肢体扭曲和物体漂浮假象,使衣摆自然晃动、下落物体加速轨迹等更接近真实物理世界。此外,模型支持 7 种宽高比和 480p/720p 两种分辨率,最长可生成 15 秒视频。
2. 主要功能
图生视频动画: 上传单张静态图片并输入自然语言提示,模型即可生成动态视频,精准保留原图细节、光影与构图。该功能适用于将产品照片、人物肖像或概念草图转化为动态内容,是电商广告和社交媒体营销的核心应用场景。
文生视频生成: 支持纯文本提示直接生成短视频,无需提供任何参考图像。适用于快速概念探索与创意草稿阶段,帮助创作者在项目早期快速验证想法,降低试错成本。
原生同步音频: 在单通道生成中同步输出视频与音频,包括环境音效、背景音乐及唇同步对话,无需后期配音。模型通过共享潜空间对齐口型、动作与音效的时间戳,实测咀嚼声、马蹄声均能与画面动作精准对齐,大幅提升内容真实感。
视频延展续写: 基于自回归机制,从现有视频的最后一帧继续生成后续片段,支持将多段短镜头串联为更长场景。此功能适用于长叙事内容的生产,如故事板动态预览或广告系列片,用户可逐步构建完整视频叙事。
多比例多分辨率输出: 支持 1:1、16:9、9:16 等 7 种宽高比,可选 480p 或 720p 分辨率,最长 15 秒。这种灵活性使得模型能够适配不同平台的发布需求,从横屏影视内容到竖屏社交短视频均可覆盖。
Fast 模式加速生成: 提供 Fast 版本大幅缩短生成时间,6 秒 720p 视频仅需约 25 秒,较前代 40 秒以上缩短近 40%。该模式适合高频创意草稿与社交内容快速迭代场景,显著提升内容生产流水线的效率。
3. 如何使用
获取 API 权限: 访问 xAI 开发者平台(x.ai)注册账号并获取 API Key。当前模型 ID 为
grok-imagine-video-1.5,用户需在开发者控制台激活该模型的访问权限。建议提前阅读 xAI API 文档了解速率限制和计费规则。构造请求参数: 通过 xAI API 发送 POST 请求,设置操作类型(
image_to_video或text_to_video)、输入模式(图片 URL 或 base64 编码,或纯文本提示)、分辨率(480p或720p)、时长(6-15 秒)及宽高比(1:1、16:9、9:16 等)。注意:不同分辨率会影响生成速度和计费成本。提交生成任务: 上传起始图片或输入文本提示,建议在提示词中详细描述镜头运动(如“缓慢前推镜头”)、动态节奏(如“轻快运动”)与音频需求(如“背景有鸟鸣声和轻柔音乐”)。模型以异步方式返回视频结果,可通过回调 URL 或轮询任务状态获取。
启用 Fast 模式: 在请求参数中设置
mode: "fast"以启用加速生成。Fast 模式下 6 秒 720p 视频生成时间约 25 秒,显著快于标准模式。注意:Fast 模式可能在极端复杂场景下牺牲少量细节,建议在创意迭代阶段优先使用。后期延展与筛选: 对生成的片段进行质量审核,利用视频延展功能从最后一帧继续生成后续内容。可通过多次延展操作将多段 6 秒短镜头串联为完整的叙事视频。建议在每次延展前检查画面连续性,避免因累积误差导致视觉断裂。
4. 优缺点分析
| 优点 |
|---|
| 图生视频榜单第一: 在 Arena.ai 图像转视频评测中登顶,Elo 评分约 1330,较前代提升 52 分,综合表现领先主流竞品,证明其在视频质量和用户偏好方面的优势。 |
| 生成速度大幅提升: Fast 模式下 6 秒 720p 视频仅需约 25 秒,较前代 40 秒以上缩短近 40%,适合高频创意草稿与社交内容快速迭代,显著提升内容生产流水线的效率。 |
| 音画同步精准自然: 原生生成同步音频,语音清晰度与口型同步效果大幅提升,实测咀嚼声、马蹄声均能与画面动作精准对齐,避免了传统后期配音中常见的音画不同步问题。 |
| 物理真实感强: 增强运动连贯性与重量感模拟,人物走路时衣摆自然晃动、下落物体轨迹真实,整体观感接近真实物理世界,显著减少了以往图生视频模型中常见的肢体扭曲和漂浮假象。 |
5. 同类工具对比
| 对比维度 | Grok Imagine Video 1.5 | Seedance 2.0 | Runway Gen-3 |
|---|---|---|---|
| 核心架构 | Aurora 自回归引擎,逐帧预测生成 | 扩散模型架构 | 扩散 Transformer 架构 |
| 最高分辨率 | 720p | 1080p | 1080p |
| 最长时长 | 15 秒 | 20 秒 | 18 秒 |
| 原生音频 | ✅ 音效+环境音+唇同步 | ✅ 对话强 | ❌ 需后期配音 |
| 图生视频排名 | Arena 第 1,Elo 约 1330 | — | Arena 约 1250 |
| 生成速度 | Fast 模式 6 秒约 25 秒 | 中等(约 60 秒/6 秒) | 较快(约 30 秒/6 秒) |
| 物理模拟 | 增强重量感与动量 | 强 | 中等 |
| 计费方式 | 按秒计费 | 积分/订阅 | 积分/订阅 |
| 开源协议 | 闭源商业 API | 闭源商业 API | 闭源商业 API |
选型建议: 对于追求高分辨率输出和更长视频时长的专业影视项目,Seedance 2.0 在分辨率和时长方面更具优势,但其生成速度较慢且原生音频能力略逊于 Grok Imagine Video 1.5。对于需要原生音画同步和快速迭代的社交媒体内容创作,Grok Imagine Video 1.5 凭借 Arena 排名第一的综合质量和 Fast 模式的极速生成,是当前最优选择。对于预算有限且对音画同步要求不高的个人创作者,Runway Gen-3 和 Pika 2.0 提供订阅制计费模式,更适合长期稳定使用。总体而言,Grok Imagine Video 1.5 在音画同步、生成速度和物理真实感方面建立了显著差异化优势,尤其适合对内容质量和生产效率都有高要求的专业用户。
6. 编辑点评
Grok Imagine Video 1.5 在技术创新性上展现了 xAI 在自回归视频生成领域的深厚积累。Aurora 自回归引擎的逐帧预测机制,结合原生音视频联合建模,在单一前向传播中同时生成视频与音频,这一技术路径显著区别于主流的扩散模型方案。从 Arena.ai 排名第一的 Elo 评分(约 1330,较前代提升 52 分)来看,模型在视频质量、运动连贯性和用户偏好方面确实取得了实质性突破。物理真实感增强算法的引入,有效解决了以往图生视频模型中常见的肢体扭曲和物体漂浮问题,使生成内容的观感更接近真实拍摄。
在实用价值方面,Fast 模式将 6 秒 720p 视频生成时间压缩至 25 秒,较前代缩短近 40%,这直接提升了内容创作流水线的效率。对于需要高频产出创意的社交媒体团队和广告公司而言,这一速度优势意味着可以在更短时间内完成多版本素材的 A/B 测试。原生音画同步功能则大幅降低了后期制作成本,实测中唇同步和音效对齐的精准度令人印象深刻。
该模型主要适用于对内容质量和生产效率都有较高要求的专业用户,包括社交媒体内容创作者、广告营销团队、影视预可视化工作者和产品展示团队。对于追求超高清画质(4K)或超长叙事(1 分钟以上)的专业影视项目,当前版本的分辨率和时长限制仍是短板。未来,随着 Aurora 引擎的持续迭代,我们有望看到更高分辨率、更长时长和更复杂场景支持能力的提升。
7. 应用场景
社交短视频快速迭代: 适合 TikTok、Instagram Reels 等平台的 6–15 秒创意短片、Meme 动画与趋势内容的高频生成。创作者可将静态 Meme 图片或概念草图输入模型,配合 Fast 模式在 25 秒内获得带原生音效的动态版本,大幅缩短从创意到发布的时间周期。
产品动态广告: 将电商产品静态图转化为带镜头运动与背景音效的短视频预告,用于商品详情页与广告投放。广告团队可基于同一产品图快速生成多版本动态素材,测试不同视觉风格与动效的转化效果,提升广告投放 ROI。
角色口播与解说内容: 上传人物肖像并输入台词,生成唇同步对话短片,适用于社交媒体口播、虚拟客服与知识类短视频。模型的原生音频生成能力确保口型与语音精准对齐,无需后期配音即可获得高质量的口播内容。
故事板动态预览: 将电影或广告分镜关键帧转化为动态镜头,帮助导演与制片人在正式拍摄前快速验证视觉节奏与运镜方案。通过视频延展功能,可将多段短镜头串联为完整的场景预览,降低前期制作中的沟通成本和试错风险。
概念变体与 A/B 测试: 广告团队可基于同一产品图快速生成多版本动态素材,用于测试不同视觉风格与动效的转化效果。结合 Fast 模式,团队可在短时间内完成数十个版本的迭代,为数据驱动的创意决策提供充足素材。
8. 常见问题 FAQ
Q:Grok Imagine Video 1.5 的生成速度有多快?
A:在 Fast 模式下,生成一段 6 秒 720p 视频仅需约 25 秒,较前代 40 秒以上缩短近 40%。标准模式的生成时间会略长,具体取决于输入图片的复杂度和设定的分辨率。
Q:模型支持哪些输入格式?
A:支持两种输入模式:图生视频(上传单张静态图片,支持 JPEG、PNG 格式)和文生视频(纯文本提示)。图生视频模式下,建议图片分辨率不低于 720p 以获得最佳输出效果。
Q:生成的视频包含音频吗?如何控制音频内容?
A:是的,模型原生生成同步音频,包括环境音效、背景音乐及唇同步对话。用户可以在提示词中描述所需的音频内容,如“背景有轻柔的钢琴音乐和鸟鸣声”,模型会根据描述自动生成匹配的音频。
Q:如何获取 API 访问权限?
A:访问 xAI 开发者平台(x.ai)注册账号并获取 API Key。当前模型 ID 为 grok-imagine-video-1.5,在开发者控制台激活该模型的访问权限后即可通过 API 调用。
Q:生成的视频最长可以是多少秒?
A:单次生成最长支持 15 秒。通过视频延展功能,可以从现有视频的最后一帧继续生成后续片段,理论上可以将多段短镜头串联为更长的视频。但建议每次延展前检查画面连续性,避免累积误差。
Q:模型支持哪些宽高比?
A:支持 1:1、16:9、9:16 等 7 种宽高比。用户可以根据目标平台选择合适比例,例如 9:16 适用于短视频平台,16:9 适用于 YouTube 等内容平台。
Q:Grok Imagine Video 1.5 在 Arena.ai 的排名如何?
A:模型在 Arena.ai 图像转视频评测中排名第一,Elo 评分约 1330,较前代提升 52 分。这一排名基于大规模用户偏好测试,综合反映了模型在视频质量和用户满意度方面的领先地位。
9. 项目地址
- 项目官网: https://x.ai/news/grok-imagine-video-1-5
- xAI 开发者平台: https://x.ai/api
相关推荐
星火X2.6:科大讯飞端云一体基座大模型的国产化突围与产业落地
星火X2.6(Spark-X2.6)是科大讯飞推出的端云一体基座大模型,基于全国产算力完成从训练到推理的完整闭环,是国产AI在安全性与性价比层面的关键布局。云端293-A30B版本支持百万token级超长上下文,输入价格仅为0.9元/百万tokens,显著低于DeepSeek-V4.1-Flash;端侧星火X2.6-4B已全面开源,在办公文档处理、工具协同等智能体任务上表现突出。系统依据任务难度与...
Ming-3.0:蚂蚁百灵开源全链路语音模型家族深度评测
Ming-3.0是蚂蚁集团百灵大模型团队开源的全链路语音系列模型,围绕语音合成(TTS)、音频理解与对话(Audio)、语音识别(ASR)三类核心任务推出五款模型。该系列以"合成+理解+识别"一体化能力覆盖语音应用全流程,其中TTS系列支持独创的"导演模式"精细控制情绪、节奏与重音,Audio系列可端到端理解长录音并结构化输出,ASR系列支持热词注入与方言识别。模型已落地支付宝、阿福APP等蚂蚁内...

FLUX 3 Max – fal 与 Black Forest Labs 推出的视频生成模型深度评测
FLUX 3 Max 是由 fal Research 与 Black Forest Labs 联合推出的后训练视频生成模型,基于 BFL 自研的 FLUX 3 多模态基础模型,支持文生视频、图生视频与关键帧插值三种工作流,可生成 5–20 秒、最高 1080p 分辨率且自带原生音频的视频内容。该模型主打极致推理速度与成本效率,10 秒成片约 12 秒完成生成,官方宣称在同画质条件下比 Seedan...
EdenLive – VAST 推出的实时生成式渲染器,重构世界模型渲染范式
EdenLive 是 VAST 推出的实时生成式渲染器,也是其世界模型项目 Project Eden 的阶段性成果。该工具以 Proxy 简化画面或参考视频为控制信号,结合目标首帧与文本提示词,持续实时生成写实或风格化画面,在单张 RTX 5090 上即可实现 720P、24FPS 以上的输出,端到端延迟仅百毫秒量级。其核心设计在于将世界状态维护与视觉渲染解耦,使视频模型不再承担隐式状态推断,从而...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。