
Hy-MT2-1.8B评测:腾讯混元端侧翻译大模型的极致量化实践
导读摘要:
Hy-MT2-1.8B是腾讯混元推出的端侧翻译大模型,以仅1.8B的参数量支持33个语种的双向互译,翻译质量在FLORES-200等基准上超越微软、豆包等商业API。模型通过2-bit(574MB)与1.25-bit(440MB)两档极致量化方案,可在手机、PC端本地流畅运行,并已落地哔哩哔哩直播弹幕实时翻译场景,实现了低成本、高隐私的端侧高质量翻译能力。
1. Hy-MT2-1.8B是什么
Hy-MT2-1.8B是腾讯混元推出的端侧翻译大模型,以仅1.8B的参数量支持33个语种的双向互译,翻译质量在FLORES-200等基准上超越微软、豆包等商业API。模型通过2-bit(574MB)与1.25-bit(440MB)两档极致量化方案,可在手机、PC端本地流畅运行,并已落地哔哩哔哩直播弹幕实时翻译场景,实现了低成本、高隐私的端侧高质量翻译能力。
技术定位与领域: Hy-MT2-1.8B属于自然语言处理领域的机器翻译方向,但与传统云端翻译服务不同,其核心定位是端侧(On-Device)翻译。该模型通过极低比特量化技术,将翻译能力完整部署至终端设备,在无网络环境下依然能够提供高质量的跨语种翻译服务,填补了移动端高性能离线翻译的空白。
研发背景: 该模型由腾讯混元团队研发,依托腾讯在社交、内容生态中的海量多语言场景需求。团队此前在混元大模型系列中积累了丰富的模型压缩与推理优化经验,此次推出的Hy-MT2-1.8B是其在端侧AI方向的重要技术成果,同时联合英特尔团队完成了x86平台的算子适配,体现了产学研协同的技术路线。
核心价值: 该模型解决了端侧设备算力与存储资源受限条件下,高质量翻译模型难以本地部署的核心矛盾。通过自研的Sherry稀疏量化方案,将模型体积压缩至440MB的同时保持翻译质量不显著下降,使普通手机和PC即可常驻运行翻译模型,彻底消除云端翻译带来的延迟、隐私和成本问题。
技术特点: 模型采用拉伸弹性量化(SEQ)与1.25-bit细粒度稀疏量化(Sherry)两项自研技术,前者将参数量化至四个离散值,后者通过"每4个参数保留3个±1、1个置0"的稀疏策略实现极低比特表达。配合专为CPU设计的STQ内核与英特尔VNNI指令集优化,在主流酷睿处理器上实现2.7至5倍的吞吐提升。
2. 主要功能
33语种双向互译: 覆盖中英日韩等主流国际语言,同时支持少数民族语言与方言,任意语种之间均可直接互译,无需中转语言,减少了二次翻译带来的信息损耗,满足全球化场景下的多语言沟通需求。
端侧本地推理: 模型通过2-bit与1.25-bit量化压缩至440~574MB,可在ARM架构手机与x86架构PC上本地运行,无需联网即可完成翻译任务。普通中端手机即可流畅运行,模型可常驻后台随时响应。
低延迟实时翻译: 针对直播弹幕等高实时性场景,单条翻译响应时间控制在500~800ms,能够跟上直播节奏。模型对网络流行语、梗文化等非规范文本具备较强的理解能力,已在实际场景中验证。
隐私安全保护: 翻译全过程在设备本地完成,文本数据无需上传云端,从物理层面杜绝了数据泄露风险。对于涉及商业机密、个人隐私的翻译需求,该特性具有重要价值。
跨平台架构适配: 同时支持ARM移动端与x86 PC端,英特尔团队针对低比特格式优化了向量化、权重重排与VNNI指令融合,使模型在酷睿处理器上的token吞吐分别提升约2.7倍(Q2_0C)和5倍(STQ),将极低bit方案从移动端扩展至PC与边缘设备。
开源开放生态: 模型权重与推理框架代码全面开源,开发者可自由下载、二次开发与商用部署。配合AngelSlim推理框架,降低了端侧翻译能力的集成门槛,便于社区生态的持续丰富。
3. 如何使用
环境要求: 需要一台配备主流CPU的电脑或手机,操作系统不限(支持Windows、Linux、Android、iOS等)。模型量化后最小仅440MB,普通存储空间即可满足;推理在CPU上完成,无需独立GPU。建议x86设备使用支持VNNI指令集的英特尔酷睿处理器以获得最佳性能。
下载模型权重: 访问Hugging Face仓库(huggingface.co/collections/AngelSlim/hy-low-bit-model),根据需求选择2-bit(574MB)或1.25-bit(440MB)量化版本。前者翻译质量略高,后者体积更小、推理速度更快,可根据设备性能和精度需求权衡选择。
获取推理框架: 从GitHub克隆AngelSlim仓库(github.com/tencent/AngelSlim),该仓库包含极低比特量化的推理内核与加载逻辑。克隆后按照README指引完成编译,框架支持CPU推理,无需额外安装CUDA等GPU依赖。
加载与推理: 使用AngelSlim框架加载已下载的模型权重,在本地CPU上执行翻译推理。x86设备可启用英特尔优化后的VNNI指令集内核获取最佳性能;ARM设备则使用针对移动端优化的STQ内核。开发者可参考仓库示例代码,快速集成至应用。
最佳实践建议: 对于直播弹幕等超低延迟场景,建议使用1.25-bit版本并启用批处理模式;对于文档翻译等质量优先场景,建议使用2-bit版本。部署前可在目标设备上运行基准测试,根据实际吞吐表现调整模型版本与线程配置。
4. 优缺点分析
| 优点 |
|---|
| 极致量化压缩: 通过SEQ与Sherry两项自研量化技术,将1.8B参数模型压缩至440~574MB,体积缩减超过75%,同时保持翻译质量几乎无损,技术方案具有较高创新性。 |
| 端侧隐私保护: 翻译全程在设备本地完成,无需上传云端,从根本上消除了数据泄露风险,对于处理敏感信息的企业用户和个人用户具有显著价值。 |
| 真实场景验证: 已接入哔哩哔哩直播弹幕实时翻译,单条响应500~800ms,经过大规模真实用户场景的检验,证明了模型的实用性与稳定性。 |
| 跨平台适配完善: 同时覆盖ARM移动端与x86 PC端,并经英特尔算子优化后吞吐提升2.7~5倍,在不同硬件平台上均有良好表现。 |
5. 同类工具对比
为评估Hy-MT2-1.8B的行业定位,选取Google Translate Gemma-4B、微软Translator API、豆包翻译三款代表性方案进行对比:
| 对比维度 | Hy-MT2-1.8B | Google Translate Gemma-4B | 微软Translator API |
|---|---|---|---|
| 参数规模 | 1.8B | 4B | 云端大模型(未公开) |
| 支持语种 | 33个语种互译+5种民族语言/方言 | 覆盖主流语言对 | 100+语种 |
| 端侧体积 | 440MB(1.25-bit)/574MB(2-bit) | ~2GB+(原生FP16,需自行量化) | 不适用(云端服务) |
| 核心量化技术 | Sherry 1.25-bit细粒度稀疏量化(ACL 2026 Oral)、SEQ 2-bit量化 | 无官方量化方案,需依赖第三方工具 | 不适用 |
| 翻译质量 | FLORES-200整体优于微软、豆包等商业API | 接近研究级水平,4B版为移动端效果妥协版 | 商业级质量,专业领域表现稳定 |
| 部署方式 | 端侧本地推理,无需联网 | 端侧部署,需自行处理量化与优化 | 云端API调用 |
| 推理框架 | AngelSlim自研框架,含x86 VNNI优化内核 | TensorFlow Lite、ExecuTorch等通用框架 | 不适用 |
| 隐私保护 | 数据不出端,本地完成 | 本地完成 | 数据上传云端 |
| 开源协议 | 权重+代码全开源 | Apache 2.0开源,可自由商用 | 商业闭源API |
| 商业落地 | 已接入哔哩哔哩直播弹幕实时翻译 | 主要用于研究/开发者实验 | 企业级翻译服务 |
选型建议: 对于隐私敏感型场景(如医疗记录、法律文件、商业机密翻译)以及需要离线运行的场景(如无网络环境下的跨国沟通、嵌入式设备翻译),Hy-MT2-1.8B的端侧架构和开源特性使其成为合适选择。特别是直播、游戏等需要低延迟实时翻译的场景,其500~800ms的响应速度和本地推理能力具有明显优势。
对于需要覆盖超多语种或专业领域翻译质量的用户,微软Translator API等云端服务仍是更稳妥的方案,但其代价是数据上云和按量计费。Google Translate Gemma-4B适合需要更大模型容量且设备性能充裕的开发者,但需自行解决量化压缩问题,部署成本较高。总体而言,Hy-MT2-1.8B在端侧翻译领域建立了体积、质量与速度的良好平衡。
6. 编辑总结
Hy-MT2-1.8B在端侧翻译模型领域展示了较为突出的技术创新性。其核心价值在于两项自研量化技术的组合应用:拉伸弹性量化(SEQ)将参数压缩至四个离散值,而Sherry稀疏量化进一步通过"细粒度稀疏"策略将平均比特数降至1.25-bit,使1.8B参数模型压缩至440MB仍保持可用翻译质量。这一技术路线在ACL 2026获得Oral录用,说明学术界对该方案创新性的认可。尤其值得关注的是,模型并未止步于技术论文,而是通过与英特尔合作完成x86算子适配,将极低比特推理从移动端扩展至PC与边缘设备,形成了完整的技术落地路径。
从实用价值来看,该模型已在哔哩哔哩直播弹幕场景中完成真实部署验证,500~800ms的响应速度满足高频实时翻译需求。其端侧推理架构带来的隐私保护特性,在数据安全日益受重视的当下具有实际意义。对于社交应用开发者、出海企业、游戏本地化团队以及隐私敏感型用户,Hy-MT2-1.8B提供了一个低成本、高可控的翻译解决方案。
适用人群方面,该模型主要面向三类用户:一是有端侧翻译集成的开发者,可通过开源权重与AngelSlim框架快速接入;二是注重数据隐私的企业用户,本地部署可规避数据出境合规风险;三是对实时性有严格要求的场景运营方,如直播平台、游戏厂商。模型的局限在于语种覆盖范围与云端服务仍有差距,且推理性能依赖终端硬件水平。
从发展潜力来看,Hy-MT2-1.8B所代表的端侧AI路线符合行业趋势。随着终端算力持续提升和量化技术不断演进,端侧模型在质量与速度上的表现将持续改善。该模型的量化方法论也可迁移至其他NLP任务,其技术价值有望超越翻译场景本身,为端侧AI的规模化落地提供参考范式。
7. 应用场景
直播弹幕实时翻译: 已落地哔哩哔哩直播场景,模型在本地实时翻译弹幕内容,单条响应500~800ms,能够跟上直播节奏。对网络流行语、梗文化等非规范表达具备较强理解能力,帮助跨语言观众实时参与互动,提升直播间的国际化氛围。
离线即时通讯: 集成于社交App后,可在无网络或弱网环境下实现跨国聊天实时互译。翻译在本地完成,对话内容不出设备,保障了通信隐私。对于差旅人士、留学生等经常处于网络不稳定环境的用户,该场景具有明确价值。
移动端网页与文档翻译: 作为浏览器插件或系统级翻译服务嵌入移动设备,本地完成外文网页、PDF文档的翻译处理。无需将文档上传至云端,适合处理敏感的商业合同、学术论文等私密内容,同时避免了云端翻译的排队等待时间。
游戏内实时本地化: 嵌入手游或PC游戏客户端后,可实时翻译外服游戏中的聊天消息、任务文本与UI界面。端侧运行不增加服务器负担,也不会因网络波动影响翻译可用性,为玩家提供无缝的跨服游戏体验。
跨境电商内容翻译: 在商家端本地批量翻译商品标题、详情页与客服话术,支持多语言店铺运营。翻译数据留在本地,避免商品信息经第三方平台流转,同时降低调用云端API的按量费用,适合高频次、大批量的翻译需求。
8. 常见问题FAQ
Q:1.8B参数的模型如何做到仅440MB体积?
A:模型采用了两级压缩策略。首先通过拉伸弹性量化(SEQ)将参数量化至{-1.5, -0.5, 0.5, 1.5}四个离散值,实现2-bit表达;随后使用Sherry稀疏量化,每4个参数中保留3个±1、1个置0,平均每个参数仅需1.25-bit。配合量化感知蒸馏(QAD)技术,在压缩体积的同时保持翻译质量几乎无损。
Q:2-bit(574MB)与1.25-bit(440MB)版本如何选择?
A:两个版本的核心差异在于体积与质量的权衡。2-bit版本保留更多信息,翻译质量略高,适合文档翻译等质量优先场景;1.25-bit版本体积更小、推理速度更快,适合直播弹幕等对延迟敏感的场景。建议在目标设备上分别测试两个版本的实际表现后决定。
Q:模型支持哪些语种?是否包含少数民族语言?
A:模型原生支持33个语种的双向互译,覆盖中英日韩等主流国际语言,同时包含5种民族语言/方言。任意语种之间均可直接互译,无需通过英语等中转语言,减少了二次翻译带来的信息损失。
Q:手机配置不高能否流畅运行?
A:模型量化后最小仅440MB,推理在CPU上完成,不依赖独立GPU。中端手机即可运行,但推理速度受设备算力影响。对于低端设备,建议使用1.25-bit版本并关闭后台其他高负载应用;高端设备则可获得接近实时的翻译体验。
Q:与云端翻译API相比,端侧翻译有哪些优势和不足?
A:优势在于数据不出端、隐私安全、零网络延迟、无按量计费成本;不足在于语种覆盖范围小于云端服务(如微软支持100+语种),且翻译质量受终端算力约束,复杂文本处理能力不及云端大模型。两者适用于不同场景,可互为补充。
Q:模型和代码是否完全开源?商用是否受限?
A:模型权重与AngelSlim推理框架代码均在GitHub和Hugging Face上开源,支持商用与二次开发。开发者需遵守仓库中的开源许可证条款,建议在商用前查阅具体协议内容以确认合规要求。
9. 项目地址
- GitHub仓库: https://github.com/Tencent-Hunyuan/Hy-MT2
- 推理框架AngelSlim: https://github.com/tencent/AngelSlim
- Hugging Face模型库: https://huggingface.co/collections/AngelSlim/hy-low-bit-model
相关推荐
FLUX 3 Image Klein – Black Forest Labs 开源的AI图像模型
FLUX 3 Image Klein 是由 Black Forest Labs 开源的 AI 图像生成模型,以仅 5.6B 参数的轻量级体量实现了此前需要数十亿参数乃至闭源大模型才能达成的能力。该模型同时支持文生图、指令式图编辑以及最多 10 张参考图的多图生成,具备原生 4K 输出、像素级精确编辑和坐标框布局控制等差异化功能。官方内部盲测显示,其在中文生图、编辑、多参考三项任务中均排名第一,超越...
DMAD – 字节联合德州农工开源的扩散模型少步蒸馏技术
DMAD(Distribution Matching as Adversarial Distillation)是由字节跳动与德州农工大学联合开源的少步蒸馏框架,核心目标是显著加速扩散模型的生成过程。该方法通过训练二分类判别器直接学习目标分布与学生分布之间的差异,省去传统蒸馏方法中辅助扩散模型的依赖,在ImageNet-64数据集上实现了FID低至1.04的一步生成效果,并将50步教师模型高效压缩为...
HelixWorld – Noiz AI 联合港科大开源的实时交互世界模型
HelixWorld 是 Noiz AI 与香港科技大学联合开源的实时交互式音视频世界模型,代表了生成式 AI 在空间智能领域的重要进展。该模型以单张静态图片和文字描述为输入,能够生成一个可供用户通过 WASD 键和方向键自由行走、转动视角的沉浸式三维世界,画面与立体空间音效同步实时生成,且声像随视角变化自然转换。基于 LTX-2.3 架构,HelixWorld 采用"双向教师 + 因果蒸馏"训练...
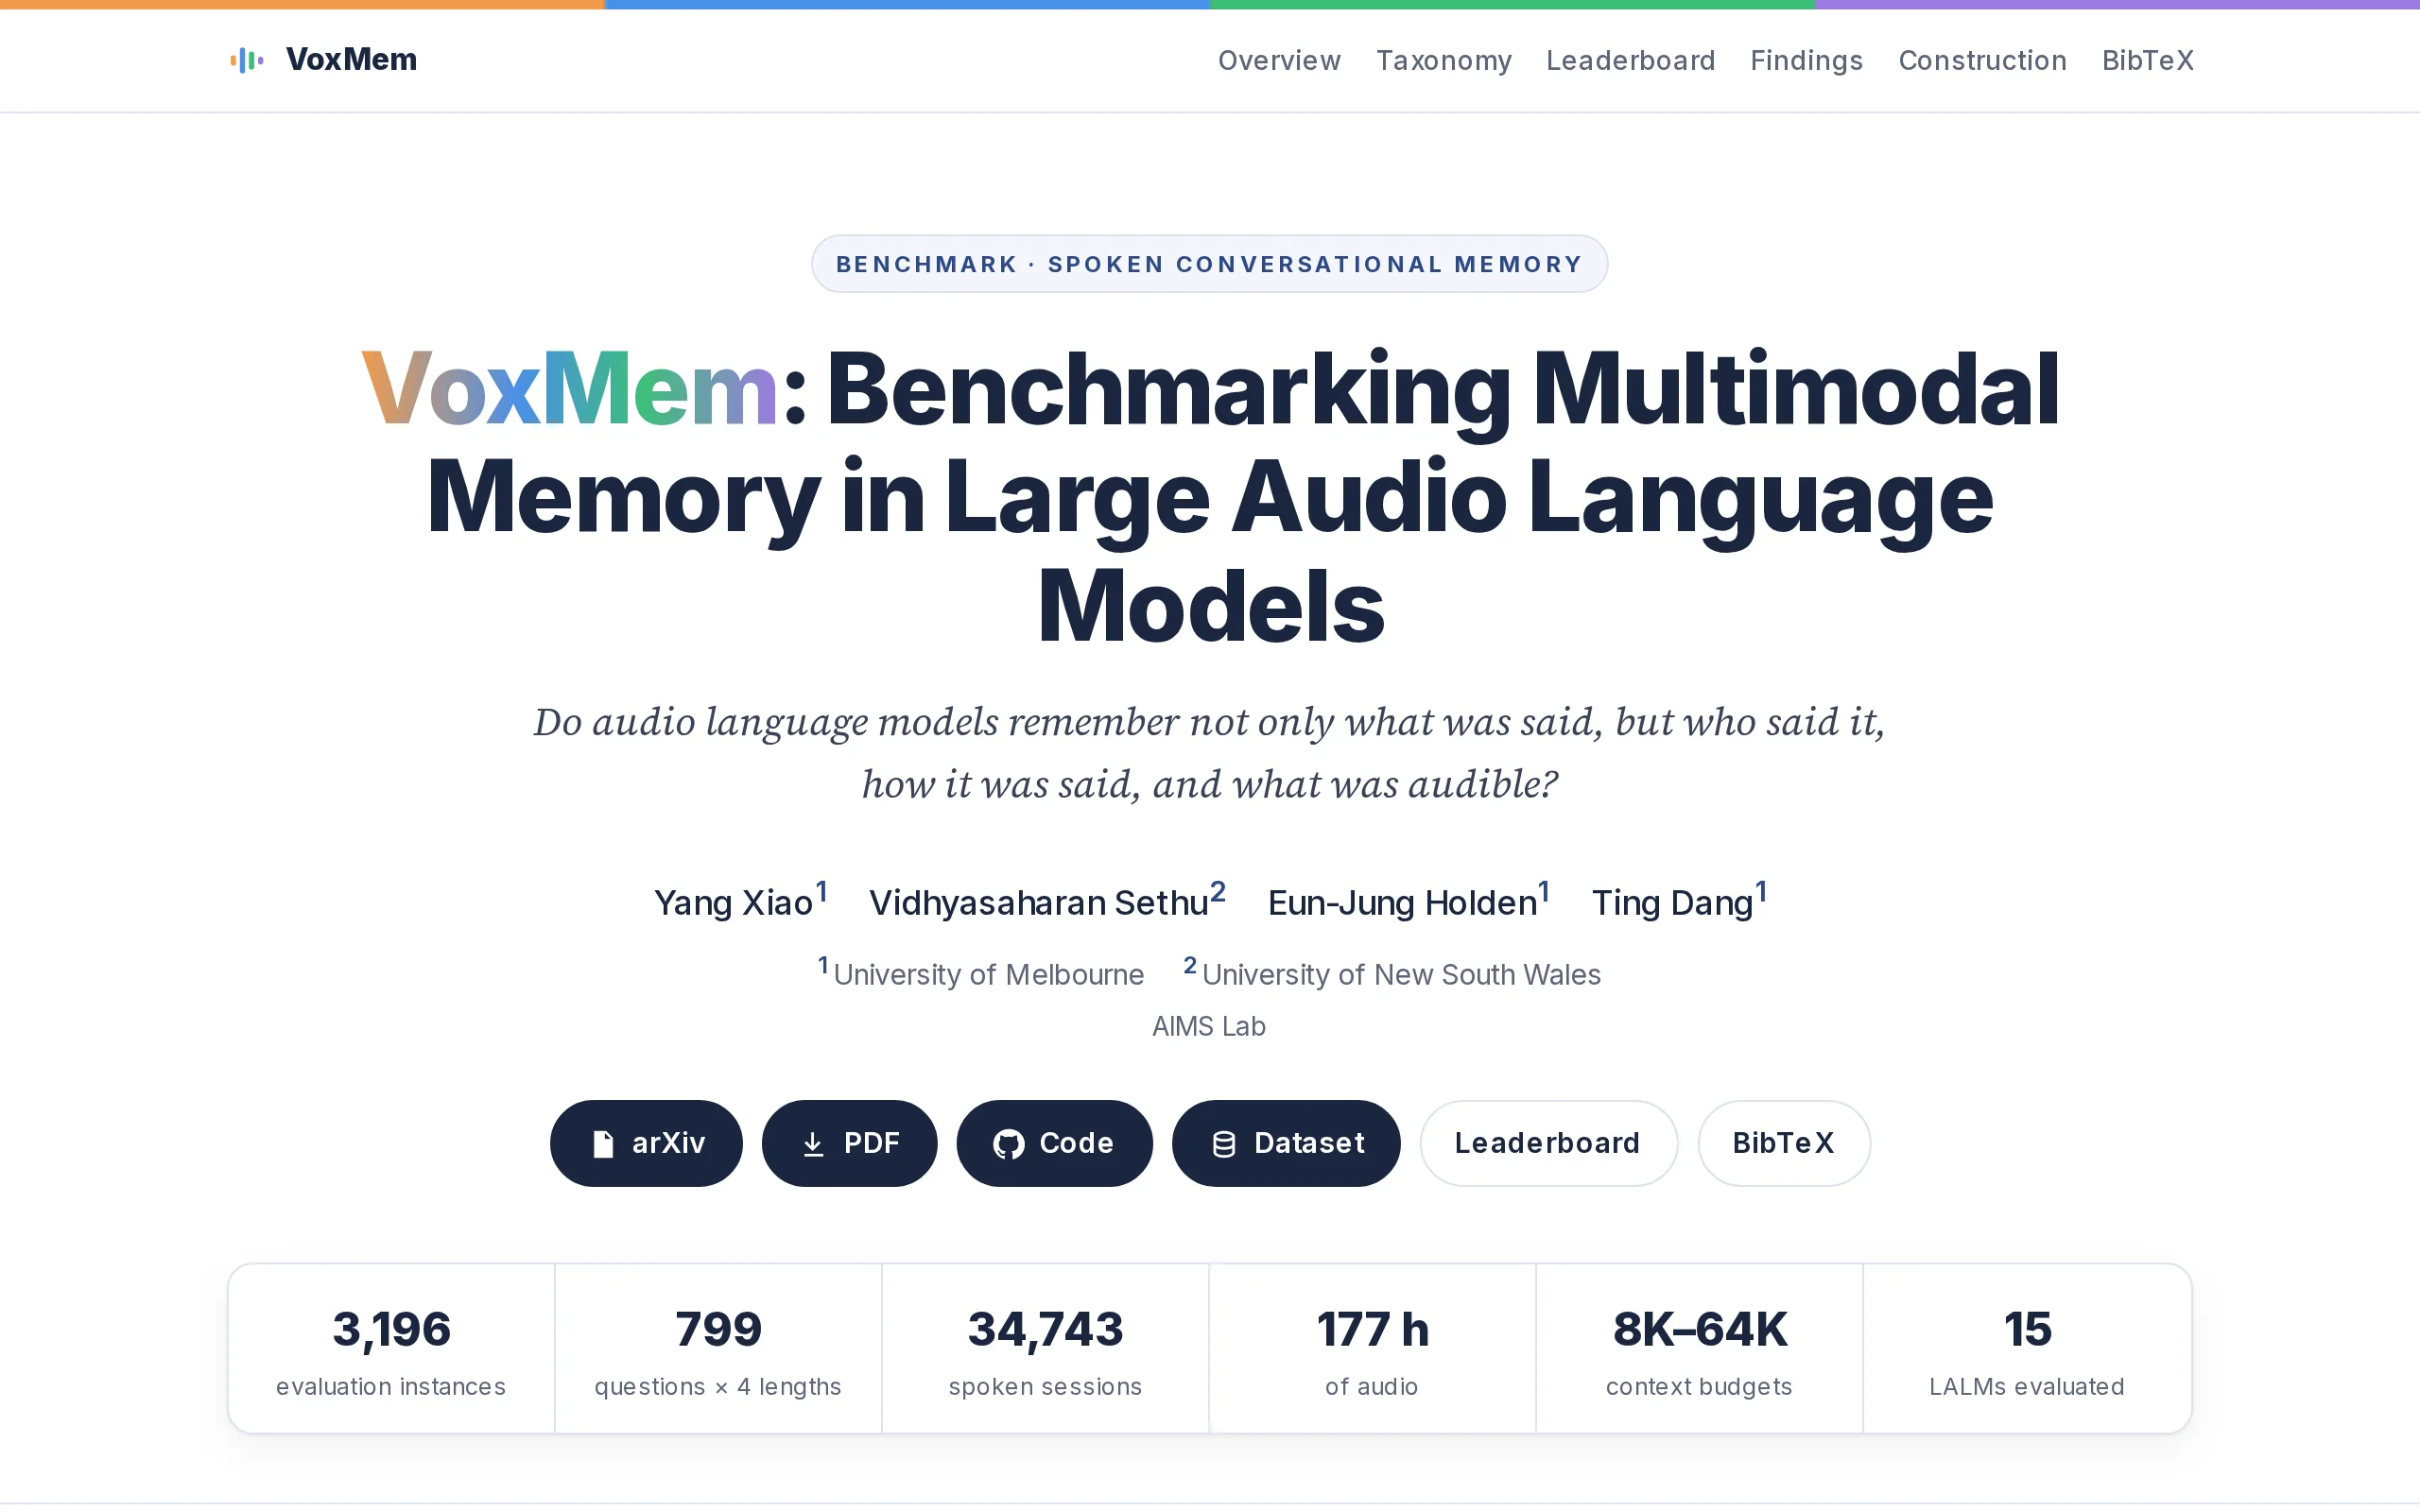
VoxMem – 墨尔本大学等开源的音频大模型记忆基准
VoxMem是由墨尔本大学与新南威尔士大学研究团队联合推出的音频大模型记忆基准(Benchmark)。该基准首创"4类声学证据×4种记忆操作"的二维评测框架,将语音语义、说话人身份、副语言线索与环境声四类信息维度,同信息抽取、跨会话推理、时序追踪与拒答四种记忆操作深度交叉,构建覆盖8K至64K token多会话历史的标准化评测体系。对15个主流模型的系统性测试显示,在32K上下文长度下,没有任何模...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。