
Khala – 中央音乐学院联合清华开源的 AI 音乐模型
导读摘要:
Khala 是由中央音乐学院与清华大学联合研发的开源 AI 音乐大模型,专注于高保真歌曲生成任务。该模型采用 64 层深度声学 Token 层级结构,将声音拆解为极细的离散单位,支持根据文本描述和歌词条件生成包含人声与伴奏的完整歌曲。在人声清晰度、乐器分离度与歌词节奏对齐方面,Khala 达到了开源模型的第一梯队水准,其生成音频在瞬态响应、泛音保留与乐器纹理细腻度上显著优于同类开源方案。项目已公开...
1. Khala是什么
Khala 是由中央音乐学院与清华大学联合研发的开源 AI 音乐大模型,专注于高保真歌曲生成任务。该模型采用 64 层深度声学 Token 层级结构,将声音拆解为极细的离散单位,支持根据文本描述和歌词条件生成包含人声与伴奏的完整歌曲。在人声清晰度、乐器分离度与歌词节奏对齐方面,Khala 达到了开源模型的第一梯队水准,其生成音频在瞬态响应、泛音保留与乐器纹理细腻度上显著优于同类开源方案。项目已公开完整代码、模型权重与部署说明,本地运行需 24GB 显存,目前更适合具备技术背景的用户作为开源底座使用。
技术定位与领域: Khala 属于自然语言处理与音频生成交叉领域,具体定位于高保真歌曲生成任务。与通用语音合成模型不同,Khala 专注于音乐级音频生成,强调人声与乐器的分离质量、歌词与旋律的时间对齐精度,以及整体音频纹理的保真度。该模型在开源社区中填补了高质量歌曲生成底座的空白,为音乐 AI 研究提供了可复现、可扩展的技术基准。
研发背景: 由中央音乐学院音乐人工智能系与清华大学计算机系联合研发。中央音乐学院提供音乐专业知识和数据标注规范,清华大学贡献深度学习与声学建模技术。两者的合作确保了模型在音乐理论正确性与工程实现可行性之间的平衡。研发动机源于现有开源音乐生成模型在人声清晰度、乐器分离度与歌词对齐方面的不足,以及商业模型闭源、不可定制的问题。
核心价值: Khala 解决了开源音乐生成模型中长期存在的三大痛点:人声与伴奏的分离质量低、歌词与旋律的时间对齐差、生成音频的纹理细节不足。通过 64 层深度声学 Token 结构和歌词-音频时间对齐机制,模型能够在本地部署环境下生成接近成品质量的歌曲,为音乐人、研究人员和开发者提供了一个可自由定制、无版权风险的开源底座。
技术特点: 核心创新在于 64 层深度声学 Token 层级结构,实现了对声音的显微镜级拆解,使乐器瞬态、泛音细节得以完整保留。歌词-音频时间对齐机制将歌词、节拍与人声起伏钉在同一时间轴上,有效减少吞字、倒字与节奏错位问题。模型采用声学 Token 语言模型架构,通过学习离散声学单位的序列关系生成连贯的音乐信号。
2. 主要功能
文本生成歌曲: 用户输入文本描述即可生成包含人声与伴奏的完整歌曲。模型能够理解文本中蕴含的情感、风格与节奏信息,并将其转化为对应的音乐特征,实现从文字到多轨音频的端到端生成。
歌词条件生成: 支持根据自定义歌词进行旋律与演唱生成,实现词曲同步。用户提供歌词文本后,模型自动匹配旋律走向、节奏型与人声起伏,确保歌词的音节时长与旋律音符一一对应,减少常见的歌词错位问题。
高保真音频输出: 生成音频在瞬态响应、泛音保留与乐器纹理细腻度上更接近成品质感。得益于 64 层深度声学 Token 结构,模型能够捕捉到传统方法容易丢失的高频细节与动态变化,输出音频的频谱密度和动态范围显著优于同类开源模型。
人声与伴奏分离生成: 通过声学 Token 层级建模,模型在生成过程中自然实现人声与乐器的分离,减少两者糊成一团的问题。与传统的后处理分离方法不同,Khala 在生成阶段就建立了人声与伴奏的独立表示,使得最终输出中两者在频谱上互不干扰。
时间对齐控制: 强化歌词与声音特征的时间对齐约束,通过将歌词、节拍与人声起伏钉在同一时间轴上,显著减少吞字、倒字与节奏错位问题。该机制在训练与生成两个阶段都起作用,确保生成的演唱在时间维度上精准匹配歌词音节。
本地私有化部署: 代码与模型权重完全公开,支持在本地 GPU 环境运行,无需依赖任何云端 API。这为企业、机构和个人开发者提供了完全的数据隐私保护,避免了使用商业平台时的版权与数据安全风险。
3. 如何使用
环境要求: 确保本地拥有至少 24GB 显存的 NVIDIA GPU,推荐使用 RTX 4090 或更高配置。操作系统建议为 Linux(Ubuntu 20.04 或更高版本),Windows 系统需通过 WSL2 运行。需要安装 Python 3.8 或更高版本,以及 CUDA 11.7 或更高版本的 GPU 驱动。
获取项目代码: 访问 Khala 的 GitHub 仓库(https://github.com/Khala-Music-AI/Khala),使用
git clone命令克隆项目到本地。同时需要从 Hugging Face 模型库(https://huggingface.co/liujiafeng/Khala-MusicGeneration-v1.0)下载预训练模型权重,并放置到指定目录。安装依赖: 进入项目目录,运行
pip install -r requirements.txt安装所有依赖。项目依赖包括 PyTorch、transformers、diffusers、librosa 等核心库,以及用于音频处理的 soundfile、pydub 等工具。建议在虚拟环境中进行安装,避免与系统其他 Python 环境冲突。加载模型并生成: 运行项目提供的推理脚本,通过命令行参数指定输入条件。例如,使用
--text "流行风格,欢快节奏,关于夏天的歌曲"进行文本生成,或使用--lyrics lyrics.txt传入歌词文件。模型会输出 WAV 格式的音频文件,默认保存在输出目录。关键配置说明: 推理脚本支持调整生成参数,包括采样步数(控制生成质量与速度的平衡)、温度参数(控制生成多样性)、以及音频采样率(默认 44100Hz)。建议首次使用时采用默认参数,后续根据实际效果微调。如果显存不足,可尝试降低采样步数或使用模型量化版本。
注意事项: 首次加载模型需要下载约 5GB 的权重文件,请确保网络连接稳定。生成过程中 GPU 显存占用较高,建议关闭其他占用显存的程序。生成的音频文件可直接用于原型验证,如需商业发布建议进行后期混音处理。
4. 优缺点分析
| 优点 |
|---|
| 人声清晰度领先: 得益于 64 层深度声学 Token 结构,Khala 生成的人声咬字稳定、AI 味轻,听感接近真人演唱,在开源模型中处于领先水平。 |
| 乐器分离度高: 各乐器瞬态与泛音细节清晰,不易糊成一团,生成的伴奏质量接近专业制作水准,适合作为音乐创作原型。 |
| 歌词节奏对齐精准: 通过时间轴对齐机制,显著减少吞字、倒字与节拍错位问题,生成的演唱在时间维度上精准匹配歌词音节。 |
| 开源免费无版权风险: 代码与模型权重完全公开,采用 Apache 2.0 许可证,支持商业和学术用途,企业可在本地私有化部署避免版权争议。 |
5. 同类工具对比
| 对比维度 | Khala | MRT2 (Google Magenta) | MusicGen (Meta) |
|---|---|---|---|
| 核心架构 | 64 层声学 Token 语言模型 | Codec LM + 帧级自回归 (SpectroStream) | EnCodec + 自回归 Transformer |
| 人声支持 | 是,支持歌词同步演唱 | 是,支持实时人声合成 | 是,支持文本引导人声生成 |
| 歌词对齐精度 | 强,时间轴对齐机制 | 中等 | 中等 |
| 硬件要求 | RTX 4090 (24GB 显存) | Apple Silicon (M1 及以上) | RTX 3090 (24GB 显存) |
| 输出音质 | 高保真,人声清晰 | 48kHz 立体声实时输出 | 32kHz 单声道 |
| 开源协议 | Apache 2.0 | Apache 2.0 | CC BY-NC 4.0 |
| 社区生态 | 较新,社区正在成长 | 成熟,插件丰富 | 活跃,有官方支持 |
选型建议: 对于需要高质量人声歌曲生成且具备技术能力的团队,Khala 是最佳选择,其歌词对齐精度和人声清晰度在开源模型中无可匹敌。对于需要实时交互和 MIDI 控制的音乐制作场景,MRT2 的实时流式生成能力更具优势,尤其适合 Apple Silicon 用户。对于预算有限、仅需要器乐生成的用户,Riffusion 的低硬件要求使其成为入门级选择。对于需要大规模部署和社区支持的场景,MusicGen 的成熟生态和官方支持更具吸引力。
6. 编辑点评
Khala 在开源音乐生成领域实现了重要突破,其 64 层深度声学 Token 结构是对现有声学建模范式的实质性改进。从技术角度看,该模型解决了长期困扰开源社区的三难问题:人声清晰度、乐器分离度与歌词对齐精度。传统方法往往只能在这三个维度中优化一到两个,而 Khala 通过细颗粒度的声学表示和强时间约束,实现了三者的协同提升。
从实用价值来看,Khala 为音乐人、研究人员和开发者提供了一个可自由定制的开源底座。音乐人可用其快速生成 Demo 验证创作想法,研究人员可基于其架构进行算法实验,开发者可将其嵌入自有工具实现商业应用。特别是对于版权敏感的企业场景,本地私有化部署能力避免了商业平台的版权风险。
适用人群定位清晰:技术背景的音乐 AI 研究者、具备 GPU 资源的独立开发者、需要高质量歌曲生成底座的学术团队。对于普通音乐爱好者,目前的使用门槛仍然较高,需要一定的技术能力。
未来发展潜力巨大:随着社区贡献的增加,模型的中文支持、生成速度优化和文档完善将成为重点改进方向。如果团队能推出轻量级版本降低硬件门槛,Khala 有望成为开源音乐生成领域的标杆项目。
7. 应用场景
音乐创作原型验证: 音乐人可使用 Khala 快速生成歌曲 Demo,验证旋律与歌词的搭配效果。输入文本描述或歌词后,模型在数分钟内输出完整歌曲,创作者可据此判断创作方向是否可行,大幅降低试错成本。
学术研究与算法实验: 音乐科技、音频 AI 领域的研究人员可将 Khala 作为基准模型,进行声学 Token 建模、歌词对齐算法、高保真生成等方向的实验。开源的代码和权重使得算法复现和性能对比变得便捷。
独立开发者集成: 开发者可基于 Khala 的开源代码进行二次开发,将其嵌入自有音乐创作工具、视频配乐平台或 AI 作曲软件。Apache 2.0 许可证允许商业使用,降低了法律风险。
版权敏感场景的私有化部署: 企业或机构可在本地 GPU 服务器上部署 Khala,用于内部音乐素材生成、广告配乐制作等场景,避免使用商业平台时的版权争议和数据泄露风险。
音乐教育与教学演示: 院校师生可使用 Khala 进行 AI 辅助作曲与声学建模原理的教学演示。通过调整输入参数观察输出变化,学生可直观理解声学 Token、时间对齐等技术概念。
8. 常见问题FAQ
Q:Khala 需要多大的显存?我的 RTX 3060 能运行吗?
A:Khala 推荐使用至少 24GB 显存的 GPU,如 RTX 4090 或 A5000。RTX 3060 的 12GB 显存无法加载完整模型,建议使用模型量化版本或考虑云端 GPU 服务。未来社区可能推出轻量级版本降低硬件要求。
Q:生成一首完整的歌曲需要多长时间?
A:在 RTX 4090 上,生成 30 秒的歌曲片段约需 2-3 分钟。完整歌曲(3-4 分钟)的生成时间在 15-20 分钟左右。生成速度受采样步数、音频长度和 GPU 性能影响,建议根据实际需求调整参数。
Q:Khala 支持中文歌词吗?效果如何?
A:模型主要针对英文歌曲场景优化,中文歌词的声调处理与节奏对齐表现有限。中文用户使用时可能出现声调不准确或节奏错位的问题。建议对中文歌词进行预处理,或等待社区推出中文优化版本。
Q:生成的音频可以直接商用吗?
A:Khala 采用 Apache 2.0 许可证,代码和模型权重可自由用于商业和学术用途。但请注意,生成的音频内容本身不涉及版权问题,但用户输入的歌词或文本描述可能涉及第三方版权,需自行确认。
Q:如何对模型进行微调或训练自定义数据集?
A:项目仓库提供了基础训练脚本,但文档较为简略。建议有经验的开发者参考 arXiv 论文中的技术细节,了解模型架构和训练流程。社区正在完善微调教程,预计未来会有更详细的指导。
Q:Khala 和 MusicGen 相比哪个更好?
A:两者各有侧重。Khala 在人声清晰度、歌词对齐精度和乐器分离度上更优,适合需要高质量人声歌曲的场景。MusicGen 社区更成熟、文档更完善,且支持更多生成模式。选择取决于具体需求和资源条件。
Q:模型在 Windows 系统上能运行吗?
A:官方推荐使用 Linux 系统。Windows 用户可通过 WSL2(Windows Subsystem for Linux)运行,但需要额外配置 GPU 驱动和 CUDA 环境。建议有经验的用户尝试,新手推荐使用 Linux 系统。
9. 项目地址
- GitHub 仓库:https://github.com/Khala-Music-AI/Khala
- Hugging Face 模型库:https://huggingface.co/liujiafeng/Khala-MusicGeneration-v1.0
- arXiv 技术论文:https://arxiv.org/pdf/2605.01790
相关推荐
GPT-Live-1.1 – OpenAI 推出的 ChatGPT 一代语音模型
GPT-Live-1.1是OpenAI于2025年推出的ChatGPT新一代语音模型,接替上一代GPT-Live-1成为语音交互的「前台引擎」,同时以轻量版GPT-Live-1.1 Quip替代原mini版本。该模型延续了经典的全双工交互架构,模型无需等待用户说完即可持续采集语音流,实时判断停顿、打断与语速变化,动态决定回应时机,支持用户随时插话或改变提问方向,使对话节奏接近真人交流。在复杂任务处...
MiDashengLM-Spatial – 小米开源的空间音频理解大模型
MiDashengLM-Spatial是小米Dasheng团队开源的空间音频理解大模型,业界首个在单一架构内统一通用音频理解与空间感知的端到端模型。该模型以MiDashengLM-7B为基座,通过新增Spatial-Dasheng空间音频编码器和层级语义到空间条件模块(HSSC),实现了声源方位感知、运动轨迹追踪以及多声源时空关系推理等能力,并支持重叠声源逐帧定位。配套数据方面,模型使用100万个...
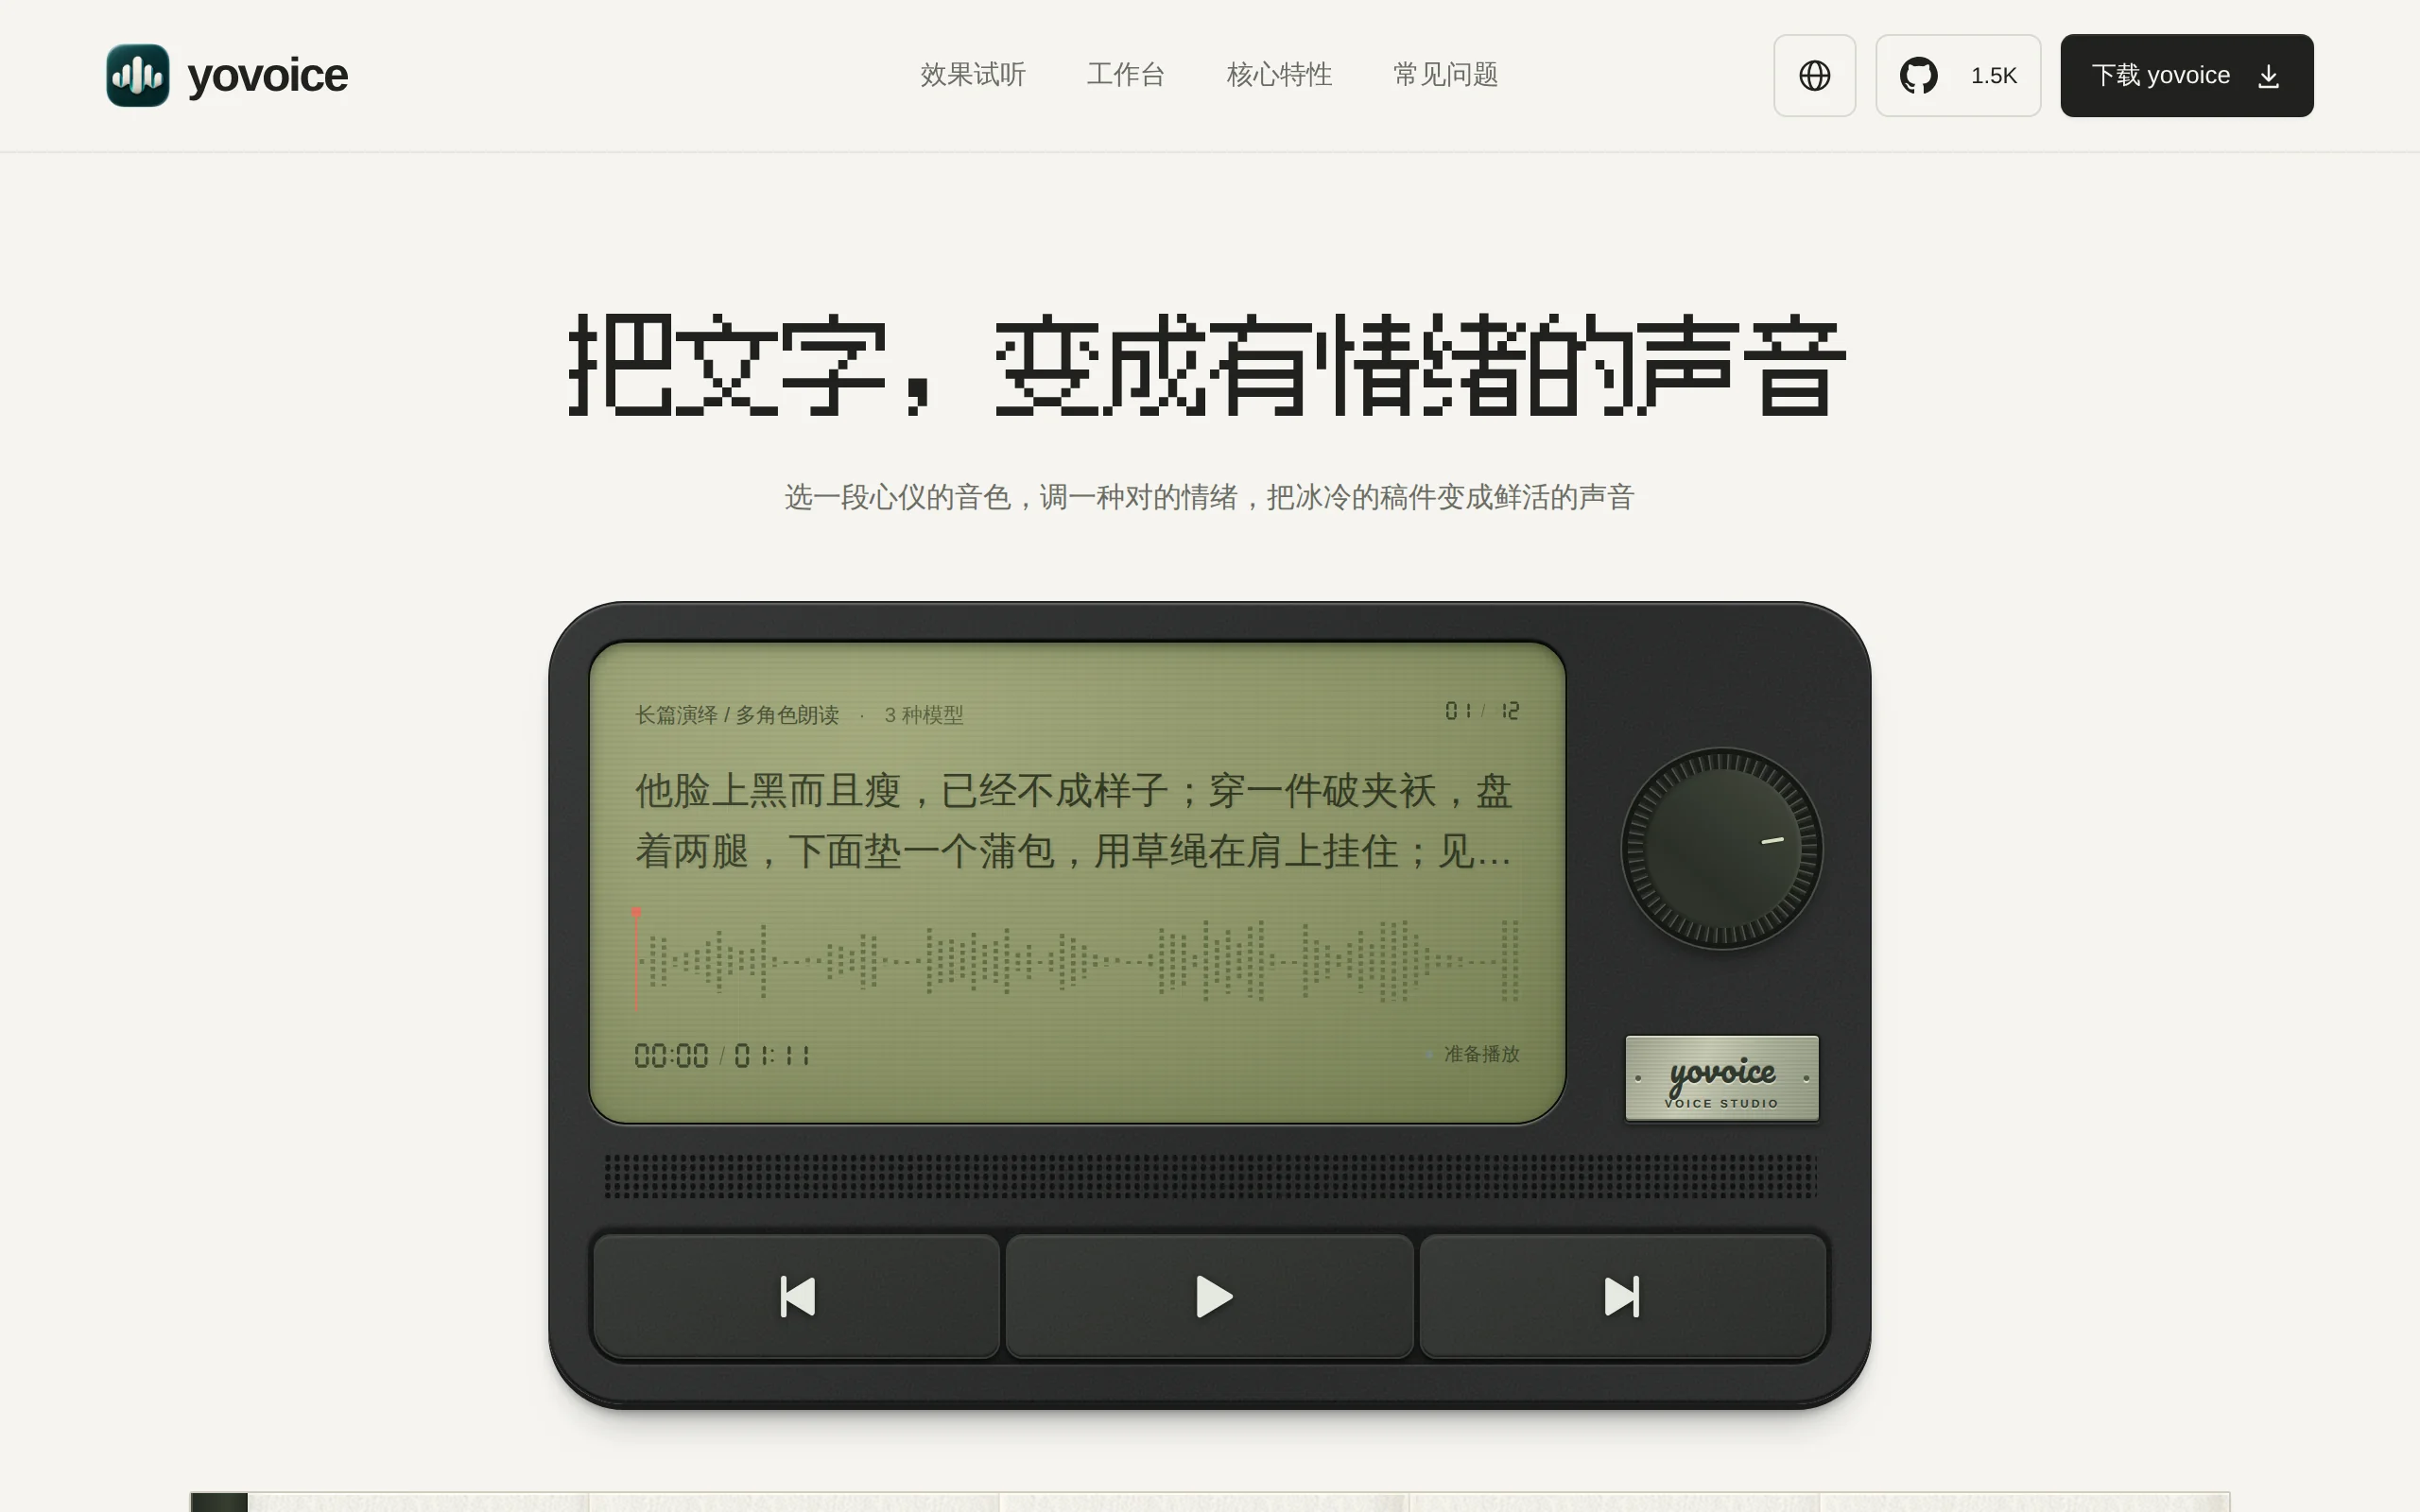
YoVoice – 开源本地音频创作工具,实现从语音合成到乐谱编曲的全链路覆盖
YoVoice 是一款面向 macOS 和 Windows 平台的开源本地音频创作工具,由开发者 leemysw 发布,致力于为用户提供从文字转语音、零样本声音克隆到 AI 音乐作曲和五线谱编曲的完整创作链路。该工具基于 C++ 推理引擎 audio.cpp 构建,无需配置 Python 环境,安装即用,所有推理计算均在本地 GPU/CPU 完成,不依赖任何云端 API,从根源上保障了用户音频数据...
HelixWorld – Noiz AI 联合港科大开源的实时交互世界模型
HelixWorld 是 Noiz AI 与香港科技大学联合开源的实时交互式音视频世界模型,代表了生成式 AI 在空间智能领域的重要进展。该模型以单张静态图片和文字描述为输入,能够生成一个可供用户通过 WASD 键和方向键自由行走、转动视角的沉浸式三维世界,画面与立体空间音效同步实时生成,且声像随视角变化自然转换。基于 LTX-2.3 架构,HelixWorld 采用"双向教师 + 因果蒸馏"训练...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。