
Lance – 字节跳动开源的轻量级原生统一多模态模型
导读摘要:
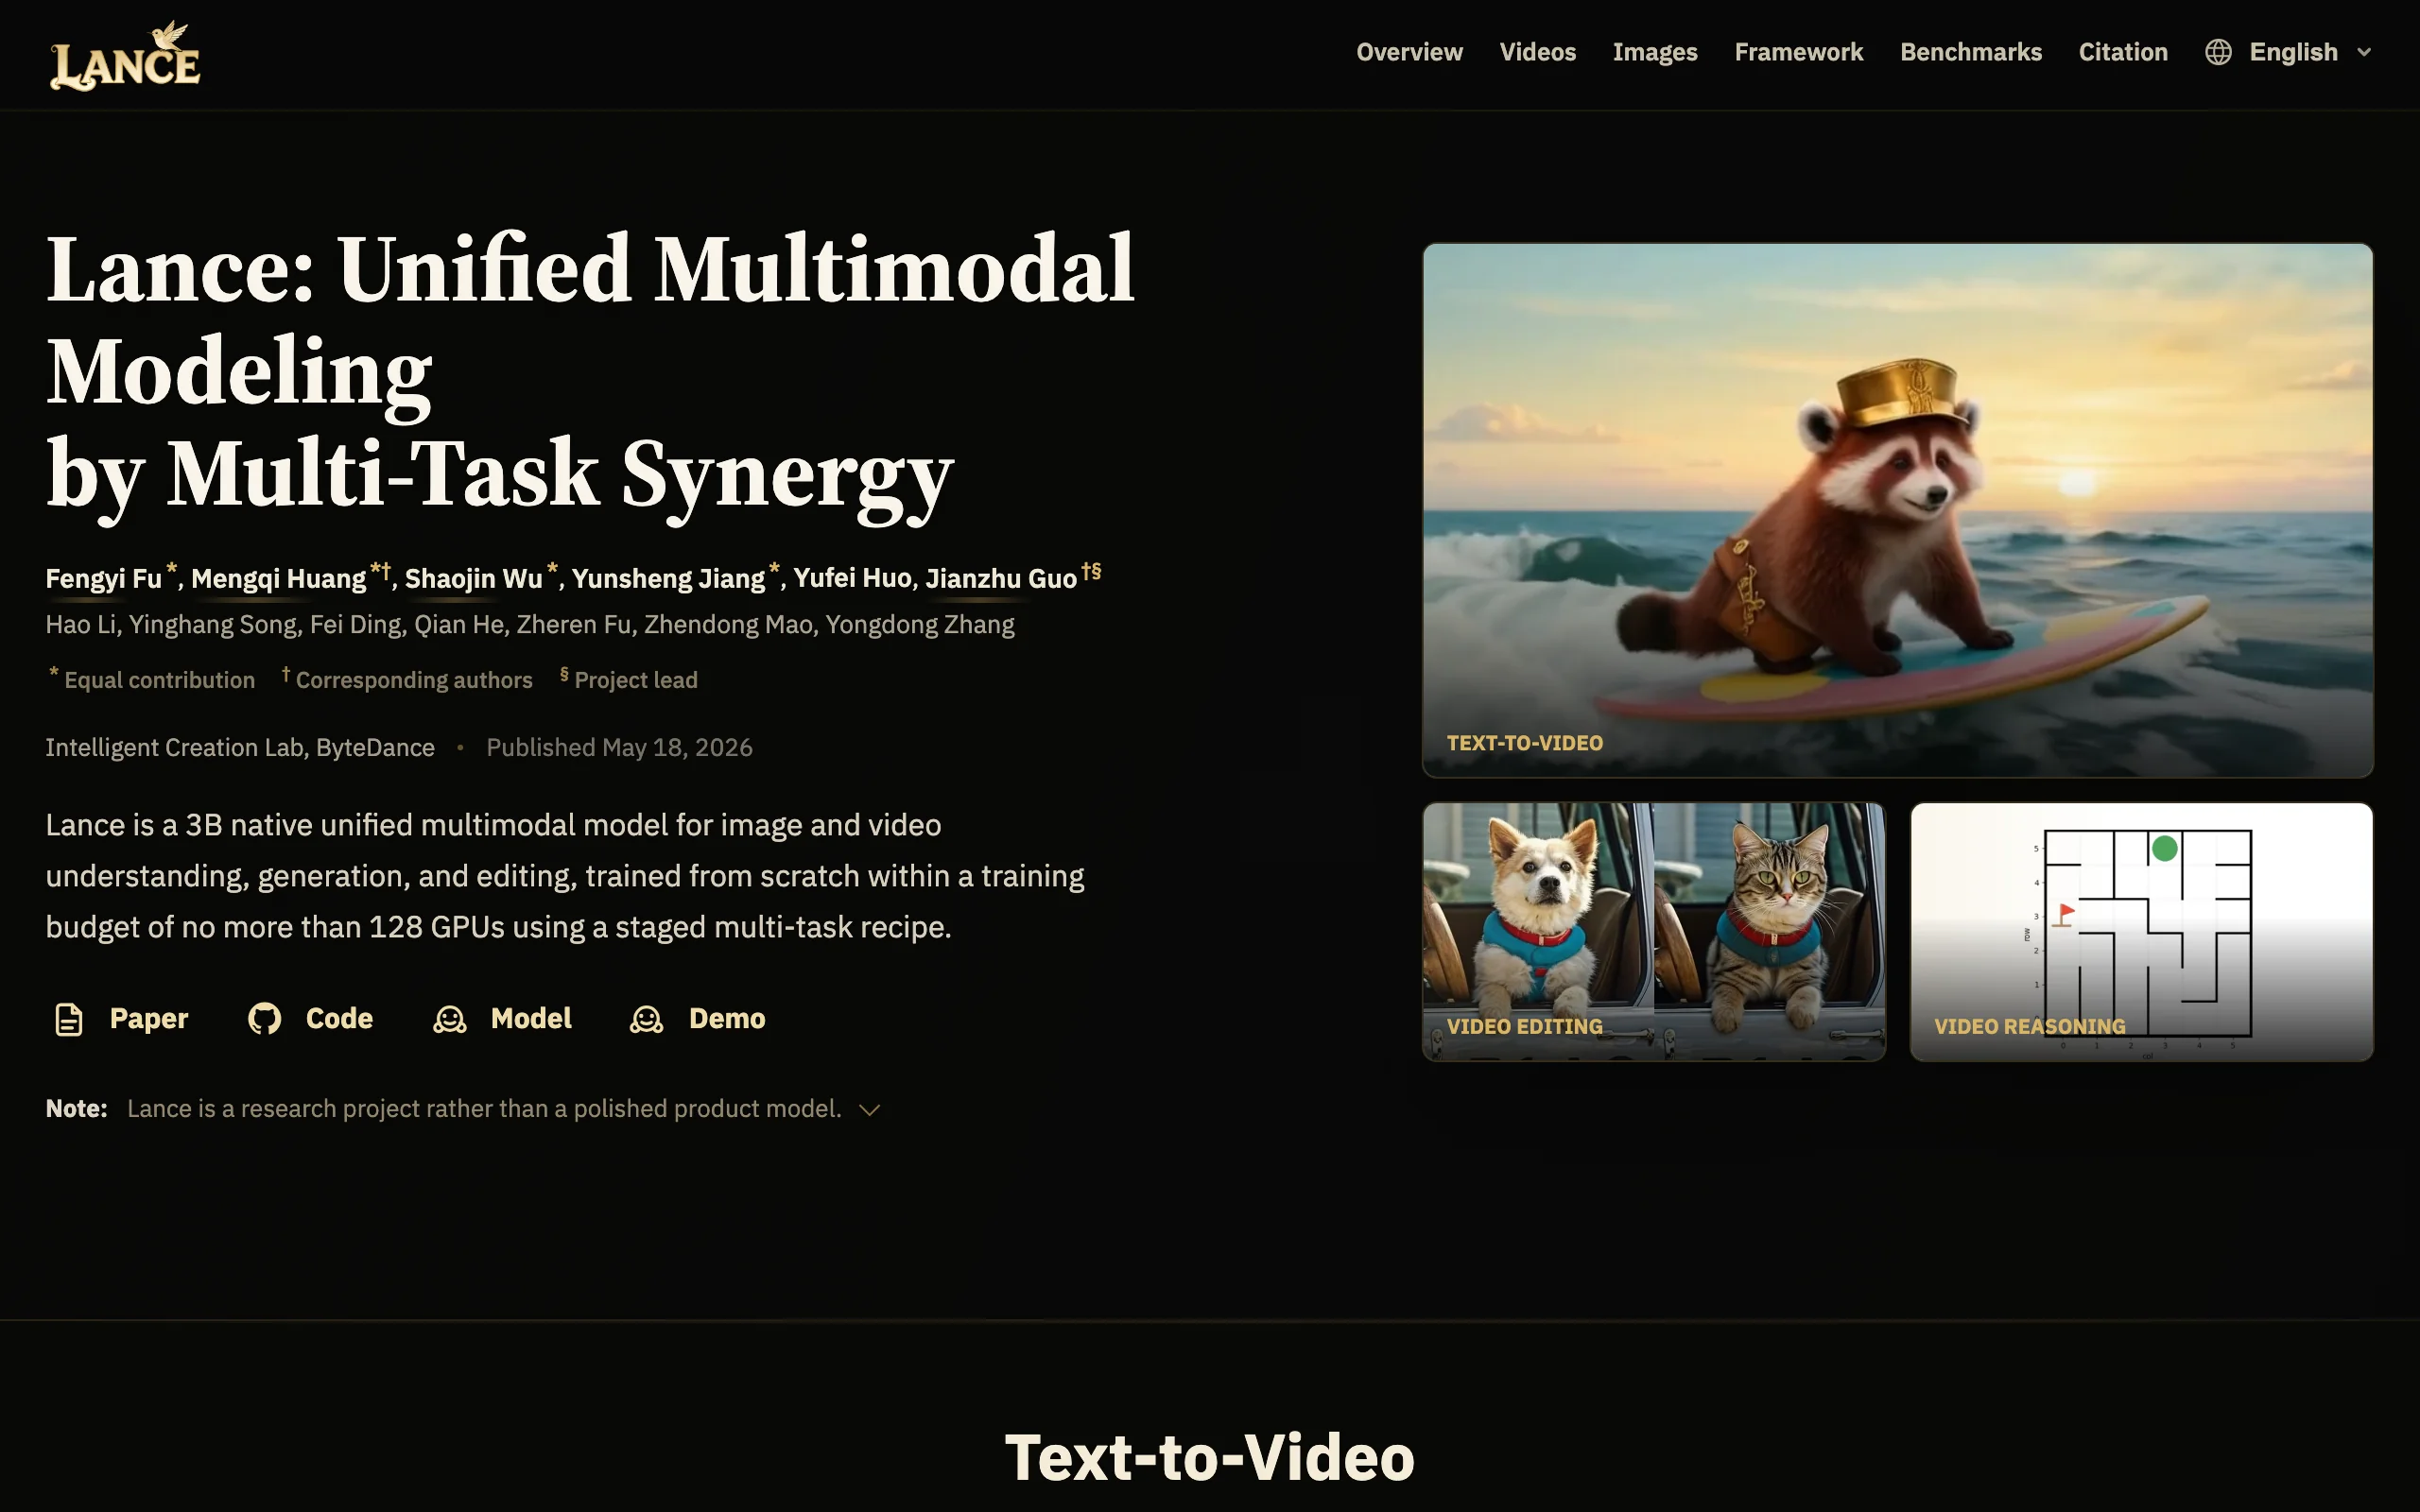
Lance是字节跳动智能创作团队开源的一款轻量级原生统一多模态模型,仅需3B激活参数即可在单一框架内同时支持图像与视频的理解、生成与编辑全链路任务。该模型采用分阶段多任务方案从零训练,整个训练周期仅消耗128张A100 GPU,显著降低了大规模多模态模型的研发门槛。在GenEval、VBench等多项权威基准测试中,Lance的表现优于或持平于参数量数倍于己的开源模型,并遵循Apache-2.0开...
1. Lance是什么
Lance是字节跳动智能创作团队开源的一款轻量级原生统一多模态模型,仅需3B激活参数即可在单一框架内同时支持图像与视频的理解、生成与编辑全链路任务。该模型采用分阶段多任务方案从零训练,整个训练周期仅消耗128张A100 GPU,显著降低了大规模多模态模型的研发门槛。在GenEval、VBench等多项权威基准测试中,Lance的表现优于或持平于参数量数倍于己的开源模型,并遵循Apache-2.0开源协议,允许自由商用与二次开发,为多模态AI技术的普及与应用提供了高效、灵活的解决方案。
技术定位与领域: Lance属于多模态大模型(MLLM)和视觉生成模型(VGM)的交叉领域,定位于实现“大一统”的视觉理解和生成。其独特之处在于,它不再将图像/视频的理解与生成视为两个分离的任务,而是通过统一的架构和训练范式,在一个模型内无缝完成从感知到创造的完整闭环。
研发背景: 该模型由字节跳动智能创作团队研发,该团队在图像、视频内容创作与AI技术结合方面有深厚的技术积累。研发动机源于当前多模态模型领域的“碎片化”现状——理解模型、生成模型、编辑模型各自独立,导致系统复杂、资源浪费、跨任务协同困难。Lance旨在打破这一壁垒,探索一条更高效、更统一的模型发展路径。
核心价值: Lance解决了多模态AI应用中的核心痛点:模型架构碎片化与任务切换成本高。其核心价值在于提供了一个“All-in-One”的解决方案,开发者无需在多个专用模型间进行繁琐的集成与调度,仅需一个模型即可应对图像/视频的理解、生成、编辑等多样化需求。这不仅大幅简化了技术栈,降低了部署和运维成本,也为开发更智能、更具交互性的应用(如智能创作助手、视频编辑Agent)提供了技术基础。
技术特点: Lance的技术核心在于其创新的双流混合专家(MoE)架构与统一交织序列表示。通过为理解与生成任务分配独立的专家路径,模型有效避免了异构任务间的相互干扰。同时,它通过广义三维因果注意力和模态感知位置编码,将文本、图像、视频等异构信息高效地组织在一个统一的序列中进行处理,实现了真正意义上的原生多模态融合。
2. 主要功能
全链路图像生成与编辑: 支持从文本到图像的生成,并能通过指令完成背景替换、物体增删、风格迁移、外观重塑等复杂的图像编辑任务。其统一架构使得编辑过程能够充分利用模型对图像语义的深层理解,实现更精准、更自然的修改效果,而非简单的像素级操作。
全链路视频生成与编辑: 能够根据文本描述生成连贯的视频,并支持单步及组合式的视频编辑,如变换背景、替换主体或修改动作。这得益于模型对视频时序信息的统一处理能力,能够在保持视频整体连贯性的前提下,精准地对特定元素进行修改,极大提升了视频内容创作的效率。
多轮一致性编辑: 对同一主体进行连续多轮的编辑操作,同时保持其身份、风格等核心属性的一致性。该功能解决了以往图像/视频编辑中“越改越不像”的痛点,通过统一的序列表示和注意力机制,模型能够在多轮交互中持续追踪和维持目标主体的特征,非常适合需要精细化调整的创作场景。
图像与视频理解: 具备对输入图像进行语义解析、内容识别与视觉问答的能力,并能对视频内容进行时序分析、动作识别与语义理解。作为统一模型,其理解能力与生成能力共享底层表征,这意味着它能“理解”自己“生成”的内容,为更高级的人机协作(如根据用户反馈自动修改生成结果)奠定了基础。
极致轻量化的部署: 仅3B的激活参数,使得Lance能够在消费级GPU(如NVIDIA RTX 4090)上进行推理。这打破了以往大型多模态模型对昂贵云端GPU的依赖,使得本地化、低延迟、保障数据隐私的AI应用成为可能,极大地扩展了其应用场景。
低成本的训练门槛: 整个模型从零训练仅需128张A100 GPU,远低于同级别模型的训练预算。这得益于其创新的分阶段多任务训练策略,该策略通过精心设计的数据配比和训练顺序,在有限算力下实现了多任务间的正向协同,为资源有限的研究团队和中小型企业复现和优化模型提供了现实可能。
3. 如何使用
环境准备与前置条件: 确保你的本地或云端环境具备Python 3.8及以上版本,并安装了PyTorch 2.0及以上版本。硬件方面,至少需要一张支持CUDA的NVIDIA GPU,推荐显存不低于16GB(如RTX 4080/4090)以获得流畅的推理体验。对于视频生成任务,建议使用24GB及以上显存的GPU。
克隆仓库与安装依赖: 打开终端,执行
git clone https://github.com/bytedance/Lance.git命令下载项目源码。进入项目目录cd Lance,然后运行pip install -r requirements.txt安装所有必需的Python库,包括transformers、diffusers等。建议使用虚拟环境(如conda)以避免依赖冲突。下载预训练模型权重: 从Hugging Face模型库(
bytedance-research/Lance)或GitHub Release页面下载Lance的预训练权重。你可以使用huggingface-cli工具进行下载:huggingface-cli download bytedance-research/Lance --local-dir ./checkpoints。请确保下载的权重文件路径与后续脚本中的配置一致。运行推理示例: 项目提供了
scripts/run_inference.py等示例脚本。你可以通过修改脚本中的参数来执行不同类型的任务。例如,运行图像生成任务:python scripts/run_inference.py --task text_to_image --prompt "一只穿着宇航服的柯基犬在月球上行走"。运行图像编辑任务:python scripts/run_inference.py --task image_editing --input_image ./examples/dog.png --prompt "将背景更换为雪山"。请根据脚本中的注释调整输入输出路径。
4. 优缺点分析
| 优点 |
|---|
| 极致轻量与高性能平衡: 仅3B激活参数,在GenEval、VBench等多项基准测试中性能超越或持平7B参数级别的模型,实现了参数量与性能的最佳平衡。 |
| 真正的全链路统一: 单一模型无缝覆盖图像与视频的理解、生成、编辑六大任务,无需在多个专用模型间切换,极大简化了应用系统架构。 |
| 极低的训练与复现成本: 整个模型仅用128张A100 GPU即可从零训练完成,降低了学术研究和中小企业复现与微调的门槛,促进了技术的民主化。 |
| 商业友好的开源协议: 采用Apache-2.0许可证,允许自由商用、修改和分发,消除了企业用户对知识产权风险的顾虑,有利于技术的广泛应用。 |
5. 同类工具对比
| 对比维度 | Lance (字节跳动) | TUNA (CMU) |
|---|---|---|
| 核心架构 | 双流MoE + 统一交织序列 + 广义三维因果注意力 | 统一自回归架构(Next-Token Prediction) |
| 激活参数量 | 3B | 7B |
| 任务覆盖 | 图像/视频理解、生成、编辑 | 图像/视频理解、生成 |
| GenEval 总分 | 0.90 | 0.90 |
| GEdit-Bench 均分 | 7.30 | 6.52 |
| VBench 总分 | 85.11 | 未列入 |
| 开源协议 | Apache-2.0 | 未明确 |
选型建议:
如果你是资源有限的开发者或研究者,目标是快速验证多模态统一模型的潜力: Lance是最佳选择。其3B的参数量和极低的训练成本使其在消费级GPU上即可运行,且性能优异。Apache-2.0协议也提供了最大的自由度。
如果你的应用场景对图像和视频的编辑能力有核心需求: Lance是当前开源领域的首选。从对比数据可以看出,Lance在GEdit-Bench上的得分远超TUNA,而Show-o2甚至未列入该榜单。其支持多轮一致性编辑的特性,在专业设计、广告营销等领域具有独特价值。
如果你更关注极致的图像生成质量,且对视频编辑需求不强烈: TUNA也是一个强有力的竞争者。它在GenEval上与Lance持平,且拥有更大的参数量(7B),理论上在复杂场景的生成上可能更具潜力。但需要注意其开源协议尚不明确,且缺乏编辑能力。
6. 编辑点评
Lance的出现,是多模态大模型领域一次极具前瞻性和实用价值的创新。它没有盲目追求“更大”的参数规模,而是通过精巧的架构设计,在“更小”的体量上实现了“更全”的功能和“更强”的性能,走出了一条与传统“大力出奇迹”截然不同的技术路径。
从技术创新性来看,Lance的双流混合专家(MoE)架构和统一交织序列表示是其最核心的贡献。MoE架构巧妙地解决了理解与生成这两个异构任务在统一模型中的“冲突”问题,而统一序列表示则为处理文本、图像、视频等多种模态信息提供了一种优雅且高效的方案。广义三维因果注意力和模态感知位置编码等细节设计,进一步夯实了其技术基础。这些创新并非简单的工程堆叠,而是对多模态本质的深刻洞察。
从实用价值分析,Lance的“全链路统一”特性将极大推动AI内容创作工具的进化。以往,一个智能创作应用可能需要集成图像生成、图像编辑、视频理解等多个模型,导致系统臃肿、延迟高、维护困难。Lance的出现,使得开发一个“全能型”AI创作助手成为可能,用户可以在同一个界面内完成从构思、生成到精修的完整流程,体验将得到质的飞跃。
适用人群定位: Lance非常适合AI应用开发者、内容创作者、设计师以及从事计算机视觉和自然语言处理交叉领域的研究人员。对于企业而言,其低成本和商业友好的协议,使其成为构建内部AI创作平台或SaaS服务的理想选择。
未来发展潜力: Lance的潜力在于其架构的可扩展性。未来,我们可以期待它支持更多模态(如音频、3D),提升视频生成的分辨率和时长,以及通过强化学习等技术进一步提升复杂指令的遵循能力。它将可能成为未来“AI原生”操作系统和创意工具的核心基础模型。
7. 应用场景
智能内容创作平台: 为设计师和视频创作者提供一站式工具。用户可以通过自然语言指令,在平台内完成从“构思草图”到“生成高清图”、“给图片换背景”、“生成一段展示视频”、“再对视频中的主体进行替换”等一系列操作,全程无需切换软件,极大提升创意落地效率。
短视频与社交媒体内容生产: 支持快速生成和编辑短视频内容。例如,用户输入“一只在巴黎铁塔下喝咖啡的猫”即可生成视频,随后可指令“将背景换成东京涩谷”,实现低成本、高效率的爆款视频素材创作,降低个人创作者和中小MCN机构的制作门槛。
广告营销素材批量生产: 电商和营销团队可利用Lance进行商品图、海报和宣传视频的批量生成与迭代。例如,为同一款产品生成不同背景(海边、家居、办公室)、不同风格(复古、极简、赛博朋克)的视觉素材,快速进行A/B测试,优化广告投放效果。
在线教育与培训内容制作: 教育工作者可以利用Lance自动生成教学所需的插图、动画和演示视频。例如,输入“演示地球绕太阳公转的动画”,模型即可生成一段视频,并可进一步编辑“将地球放大,并标注出轨道”,使抽象的知识点变得直观生动,丰富多媒体教学资源。
8. 常见问题FAQ
Q:Lance与Stable Diffusion这类扩散模型相比,核心区别是什么?
A:核心区别在于“统一性”。Stable Diffusion是一个纯粹的生成模型,专注于文生图和图生图。而Lance是一个统一模型,它在同一个框架内不仅能做生成,还能做理解(如视觉问答)和编辑(如指令式背景替换)。Lance的架构也不同于纯扩散模型,它融合了自回归和扩散的特性,通过统一序列表示来处理不同任务。
Q:我的显卡只有8GB显存,能否运行Lance?
A:对于图像理解和简单的图像生成/编辑任务,8GB显存勉强可以运行,但速度会较慢,且可能无法处理高分辨率输入。对于视频生成和理解任务,强烈建议使用16GB及以上显存的GPU。官方推荐使用RTX 4090(24GB)以获得流畅体验。
Q:如何对Lance进行微调以适应我的特定数据(如特定风格的产品图)?
A:项目仓库提供了微调脚本和文档(通常基于LoRA或全量微调)。你需要准备特定格式的数据集(包含图像/视频、文本指令和预期输出)。由于Lance训练成本低,微调对算力的要求也相对较低。建议从LoRA微调开始,它更节省显存和计算资源。
Q:Lance在视频生成上,最长能生成多少秒的视频?
A:目前官方示例和基准测试主要聚焦于数秒(如2-5秒)的短视频片段。在生成长视频时,可能会遇到一致性问题或质量下降。这主要是受限于GPU显存和训练数据的长度。社区正在探索通过时序超分或长视频生成策略来扩展其能力。
Q:Lance支持中文输入吗?
A:模型本身是基于英文数据训练的,对英文指令的理解和生成效果最佳。虽然理论上可以通过微调或使用中文CLIP模型来支持中文,但官方版本对中文的支持非常有限。如果你主要处理中文场景,需要进行针对性的中文数据微调。
Q:Lance的“多轮一致性编辑”是如何实现的?
A:这是通过其“统一交织序列表示”实现的。在编辑过程中,模型不只是看到当前修改后的图像,还会将原始图像、历史编辑指令和结果都编码到同一个序列中。通过序列中的注意力机制,模型能够持续追踪目标主体的身份、风格等核心特征,从而在后续编辑中保持一致。
9. 项目地址
- 项目官网: https://lance-project.github.io/
- GitHub仓库: https://github.com/bytedance/Lance
- HuggingFace模型库: https://huggingface.co/bytedance-research/Lance
- arXiv技术论文: https://arxiv.org/pdf/2605.18678
相关推荐
书生-A1.5 – 上海 AI Lab 开源的通专融合科学智能体
书生-A1.5(Sage-A1.5)是上海人工智能实验室推出的 35B 规模通专融合科学智能体,基于 Agents-A1 长程任务能力与书生·端砚科学发现平台构建,面向真实科研场景验证 RSI(Researcher-Scientist-Investigator)闭环。该模型能够自主拆解复杂科研任务、编排多个子智能体并行调研,并触发校验机制识别证据缺口、修正研究假设。书生-A1.5 已覆盖脑科学、电...
WorkForge – 腾讯联合复旦推出的智能体训练环境构建框架深度评测
WorkForge是腾讯混元与复旦大学联合推出的智能体训练环境构建框架,旨在解决当前智能体训练中高质量长程任务数据稀缺的核心瓶颈。该框架从专家工作流蓝图出发,通过获取智能体自动检索真实世界资源搭建工作区,基于工作区中的事实锚点生成任务指令与双重验证标准,让智能体在执行过程中产出可追溯的轨迹数据。目前WorkForge已建成16.7K个可验证环境,横跨40个专业领域,可将35B模型的GDPval得分...
星火X2.6:科大讯飞端云一体基座大模型的国产化突围与产业落地
星火X2.6(Spark-X2.6)是科大讯飞推出的端云一体基座大模型,基于全国产算力完成从训练到推理的完整闭环,是国产AI在安全性与性价比层面的关键布局。云端293-A30B版本支持百万token级超长上下文,输入价格仅为0.9元/百万tokens,显著低于DeepSeek-V4.1-Flash;端侧星火X2.6-4B已全面开源,在办公文档处理、工具协同等智能体任务上表现突出。系统依据任务难度与...
MemT 1.0 – 记忆张量开源的业内首个记忆原生基座模型
MemT 1.0是记忆张量(MemTensor)团队推出的业内首个记忆原生(Memory-Native)基座模型,已全面开源。该模型摒弃了传统大语言模型依赖外部检索或重复注入历史文本的方式,而是将历史信息编码为可持续更新的内部记忆状态,使模型能够在推理计算过程中直接读写记忆。MemT 1.0包含Flash(288B参数/17B激活)和Nano(36B参数/3B激活)两个版本,在11项记忆基准上位列...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。