
LingBot-Vision – 蚂蚁灵波科技开源的通用视觉基座模型

1. LingBot-Vision是什么
LingBot-Vision 是蚂蚁灵波科技(RobbyAnt Technology)开源的通用视觉基座模型,其核心创新在于业内首次将“边界结构”确立为预训练目标,实现了从传统语义分类到几何建模的空间感知范式突破。该模型仅需1.6亿张图像语料即可完成高效预训练,数据规模比DINOv3等主流模型小一个数量级,却具备亚像素级的边界定位与空间结构理解能力,并支持在视频中稳定连续追踪物体边界。为适应不同部署需求,LingBot-Vision一次性开源了ViT-G、ViT-L、ViT-B、ViT-S四个参数规模的版本,覆盖从云端高精度推理到边缘端轻量化部署的完整链路。
技术定位与领域: 属于计算机视觉领域的基础模型层,专注于空间感知与几何结构理解,区别于以语义分类为核心的通用视觉预训练模型(如CLIP、DINOv3),其定位是面向物理世界交互的视觉骨干网络。
研发背景: 由蚂蚁灵波科技(RobbyAnt Technology)研发,该公司专注于具身智能与三维视觉技术,此前已推出LingBot-Depth 2.0等空间感知模型。LingBot-Vision的研发动机源于现有视觉基础模型在边界识别、空间拓扑关系建模上的不足,旨在为机器人、自动驾驶、工业质检等需要精准空间感知的场景提供原生优化的视觉表征。
核心价值: 解决了传统视觉模型在物体边缘模糊、低对比度场景失效、视频时序不一致等痛点。通过几何建模范式,模型能区分真实物体边缘与纹理噪声,在透明物体、反光表面等传统深度相机失效的场景下仍能准确推断物体轮廓,显著提升了机器人在复杂物理环境中的感知可靠性。
技术特点: 以边界结构为预训练目标是其最核心的技术差异化能力;亚像素级边界定位机制使其在精度上超越通用模型;高效数据训练策略证明了在明确的物理结构约束下,视觉模型能用更少数据习得更强的空间感知能力;多规格开源策略降低了从研究到落地的门槛。
2. 主要功能
边界结构预训练: 业内首次将边界结构作为预训练核心目标,强制模型学习物体轮廓的几何连续性、边缘曲率变化及相邻表面的空间拓扑关系,使编码器天然具备对物体边界的高敏感度,从根本上突破了传统判别式自监督预训练的范式限制。
亚像素级边界定位: 通过精细的几何监督信号,模型能够区分真实物体边缘与纹理噪声,在透明物体、反光表面等低对比度场景下仍能准确推断物体轮廓,补全传统深度相机失效区域的三维结构,精度达到亚像素级别。
视频连续追踪: 模型具备在视频序列中稳定追踪物体边界的能力,能够保持时序一致性,不会因帧间变化或光照波动导致边界抖动或丢失,为视频内容分析、自动驾驶感知等动态场景提供可靠支持。
一模多用: 除作为LingBot-Depth 2.0的骨干网络支撑深度补全任务外,模型具备通用视觉表征与多任务迁移能力,可通过微调适配语义分割、实例分割、边缘检测等多种下游任务,实现单一预训练模型的多场景复用。
多规格开源: 提供ViT-G(巨型)、ViT-L(大型)、ViT-B(基础)、ViT-S(小型)四个参数规模的版本,覆盖从云端高精度推理到移动端/边缘端轻量化部署的不同需求,开发者可根据算力资源灵活选择。
高效数据训练: 预训练语料仅为1.6亿张图像,比DINOv3小一个数量级。通过结构化的几何先验知识引导训练,模型在更少数据下习得了更强的空间感知能力,证明了物理结构约束对数据效率的显著提升作用。
3. 如何使用
下载模型权重: 访问HuggingFace或ModelScope上的官方模型仓库(搜索“robbyant/lingbot-vision”),根据部署需求选择ViT-G、ViT-L、ViT-B或ViT-S版本,下载对应的权重文件(.pth或.safetensors格式)。
克隆代码仓库: 执行
git clone (链接待官方发布后更新) 克隆项目代码,阅读README.md了解整体架构,查看examples/目录下的推理示例脚本和docs/` 中的API接口文档。环境配置与依赖安装: 推荐使用Python 3.9+和PyTorch 2.0+,通过
pip install -r requirements.txt安装依赖(包括torchvision、opencv-python、pillow等)。如需GPU加速,确保CUDA版本与PyTorch兼容。加载模型进行前向推理: 使用如下核心代码将模型权重加载至视觉编码器模块:
model = LingBotVision.from_pretrained("robbyant/lingbot-vision-base"),随后传入预处理后的图像张量,调用model(image_tensor)获取边界特征图或空间结构表征。微调适配下游任务: 基于下游任务(如语义分割、深度估计)的数据集,冻结或部分解冻模型参数进行微调。建议使用较小的学习率(如1e-5)和AdamW优化器,训练时注意保持数据增强中的几何一致性。
视频场景集成: 对于视频连续追踪需求,需将模型与光流或目标跟踪模块结合,逐帧提取边界特征并通过时序滤波(如卡尔曼滤波)维持边界稳定性,避免帧间抖动。
4. 优缺点分析
| 优点 |
|---|
| 范式创新显著: 业内首创边界结构预训练目标,从语义分类转向几何建模,在空间感知任务上具备原生优势,突破传统自监督范式瓶颈。 |
| 数据效率极高: 仅需1.6亿张图像即可达到甚至超越10亿级数据训练的模型在空间感知上的表现,大幅降低了预训练的计算成本。 |
| 边界识别精度领先: 亚像素级边界定位能力在低对比度、透明物体等困难场景下表现稳定,填补了传统模型在边缘细节上的空白。 |
| 多规格开源策略灵活: ViT-G/L/B/S四个版本覆盖从高精度到轻量化的完整链路,适配云端服务器到边缘设备的多种部署场景。 |
5. 同类工具对比
| 对比维度 | LingBot-Vision | DINOv3 | CLIP |
|---|---|---|---|
| 预训练目标 | 边界结构几何建模(首创) | 自监督判别式预训练(对比学习+掩码) | 图文对比学习(多模态对齐) |
| 训练数据量 | 1.6亿张图像 | 约10亿级图像 | 4亿图文对 |
| 边界定位精度 | 亚像素级,边缘清晰稳定 | 通用特征提取,边界细节相对模糊 | 语义级定位,无原生边界能力 |
| 视频能力 | 支持连续追踪物体边界 | 主要面向静态图像表征 | 静态图文匹配,无视频能力 |
| 空间感知原生性 | 原生面向空间感知优化 | 通用视觉表征,非空间专用 | 语义理解为主,空间感知弱 |
| 开源协议 | 开源(具体协议待确认) | Apache 2.0 | MIT |
| 模型规模选择 | ViT-G/L/B/S四种 | ViT-G/L/B/S等多种 | ViT-B/L等多种 |
选型建议: 对于需要高精度空间感知和边界定位的机器人、自动驾驶场景,LingBot-Vision是最优选择,其几何建模范式在边缘识别上具有原生优势,且数据需求更低。如果任务偏重通用语义理解或图文跨模态检索,CLIP和DINOv3仍是更成熟、生态更完善的选择。对于需要交互式分割(如用户点击指定物体)的场景,SAM的灵活性和社区资源更丰富,但其缺乏预训练的空间感知能力,在自动化边界追踪任务上不如LingBot-Vision。
6. 编辑点评
LingBot-Vision的发布在视觉基础模型领域具有重要的范式创新意义。其核心贡献在于将“边界结构”从下游任务特征提升为预训练目标,这本质上是将物理世界的几何约束引入模型学习过程,而非仅仅依赖数据驱动的统计模式。从技术实现角度看,亚像素级边界定位能力和高效数据训练策略(1.6亿 vs 10亿级)证明了这一方向的可行性——在明确的物理结构约束下,模型确实能用更少数据习得更强的空间感知能力,这对降低预训练成本、推动模型落地具有实际价值。
从实用价值来看,LingBot-Vision直接服务于具身智能、深度补全、工业质检等需要精准空间感知的场景,这些领域正是当前视觉技术从“看懂”走向“交互”的关键瓶颈。模型提供的ViT-G/L/B/S多规格版本也体现了工程落地的考量,而非单纯的学术实验。不过,其社区生态尚处于起步阶段,与DINOv3、SAM等成熟模型的插件和扩展资源相比差距明显,开发者可能面临较高的集成成本。
适用人群方面,LingBot-Vision最适合从事机器人感知、自动驾驶环境理解、工业视觉检测的研究人员与工程师,尤其是那些被传统模型边界模糊问题困扰的团队。对于通用图像分类或图文检索任务,该模型并非最佳选择。未来发展潜力上,若团队能持续完善文档、丰富下游任务示例并推动社区贡献,LingBot-Vision有望成为空间感知领域的标杆模型。
7. 应用场景
具身智能视觉: 为机器人提供精准的空间结构与边界感知能力,在导航避障、物体抓取、环境建图等任务中,模型能实时识别物体轮廓与空间拓扑关系,辅助机器人做出更准确的物理交互决策。
深度补全增强: 作为LingBot-Depth 2.0的骨干网络,模型通过亚像素级边界定位能力,显著提升对透明玻璃、反光金属等低纹理物体的深度估计精度,补传统深度相机在这些场景下的失效区域。
工业质检: 在电子元器件、精密零部件的外观检测中,模型利用亚像素级边界识别能力,可稳定检测微小划痕、边缘毛刺、轮廓偏差等缺陷,比传统视觉算法更鲁棒,减少误检和漏检。
自动驾驶感知: 增强对道路边界、车道线、障碍物边缘的识别稳定性,尤其在雨天、夜间、逆光等低对比度场景下,模型能准确区分真实边界与阴影、水渍等干扰,提升环境理解的可靠性。
视频内容分析: 在安防监控、行为分析等场景中,模型可在视频序列中持续追踪目标物体的边界,即使目标发生形变或部分遮挡,仍能保持边界的一致性,支撑更精准的目标检测与行为识别。
8. 常见问题FAQ
Q:LingBot-Vision与DINOv3在预训练范式上有何本质区别?
A:DINOv3采用判别式自监督预训练,通过对比学习或掩码重建让模型区分不同图像实例,本质是语义层面的特征学习。LingBot-Vision则采用几何建模范式,将边界结构作为预训练目标,强制模型学习物体轮廓的几何连续性、边缘曲率等物理空间特征,本质是结构层面的表征学习。
Q:模型在低对比度场景(如透明玻璃)下的表现如何?
A:表现显著优于通用模型。通过精细的几何监督信号,LingBot-Vision能区分真实物体边缘与纹理噪声,在透明物体、反光表面等场景下,模型能基于几何连续性推断出传统深度相机无法捕捉的轮廓,补全失效区域的三维结构。
Q:如何选择ViT-G/L/B/S版本?
A:ViT-G(巨型)适合高精度云端推理,参数量最大,边界定位最精细;ViT-L(大型)平衡精度与速度,适合服务器端部署;ViT-B(基础)是通用推荐版本,适合大多数研究场景;ViT-S(小型)面向边缘设备或移动端,在保持核心能力的同时大幅降低计算开销。
Q:模型是否支持端到端视频边界追踪?
A:模型本身提供单帧边界特征提取能力,不直接包含时序建模模块。要实现视频连续追踪,需要集成光流或目标跟踪算法(如卡尔曼滤波、SORT等),对逐帧提取的边界特征进行时序对齐和滤波。
Q:微调时需要注意什么?
A:建议使用较小的学习率(1e-5左右)和AdamW优化器,避免破坏预训练学到的几何结构知识。数据增强时应保持几何一致性(避免随机裁剪导致边界变形),并建议冻结部分浅层特征提取层以保留边界敏感度。
Q:模型在图像分类任务上表现如何?
A:由于模型专为空间感知优化,在ImageNet等通用图像分类任务上的表现可能不如同等规模的CLIP或DINOv3。其强项在于边缘检测、深度估计、语义分割等需要空间理解的任务,而非语义分类。
9. 项目地址
相关推荐

FLUX 3 Max – fal 与 Black Forest Labs 推出的视频生成模型深度评测
FLUX 3 Max 是由 fal Research 与 Black Forest Labs 联合推出的后训练视频生成模型,基于 BFL 自研的 FLUX 3 多模态基础模型,支持文生视频、图生视频与关键帧插值三种工作流,可生成 5–20 秒、最高 1080p 分辨率且自带原生音频的视频内容。该模型主打极致推理速度与成本效率,10 秒成片约 12 秒完成生成,官方宣称在同画质条件下比 Seedan...
EdenLive – VAST 推出的实时生成式渲染器,重构世界模型渲染范式
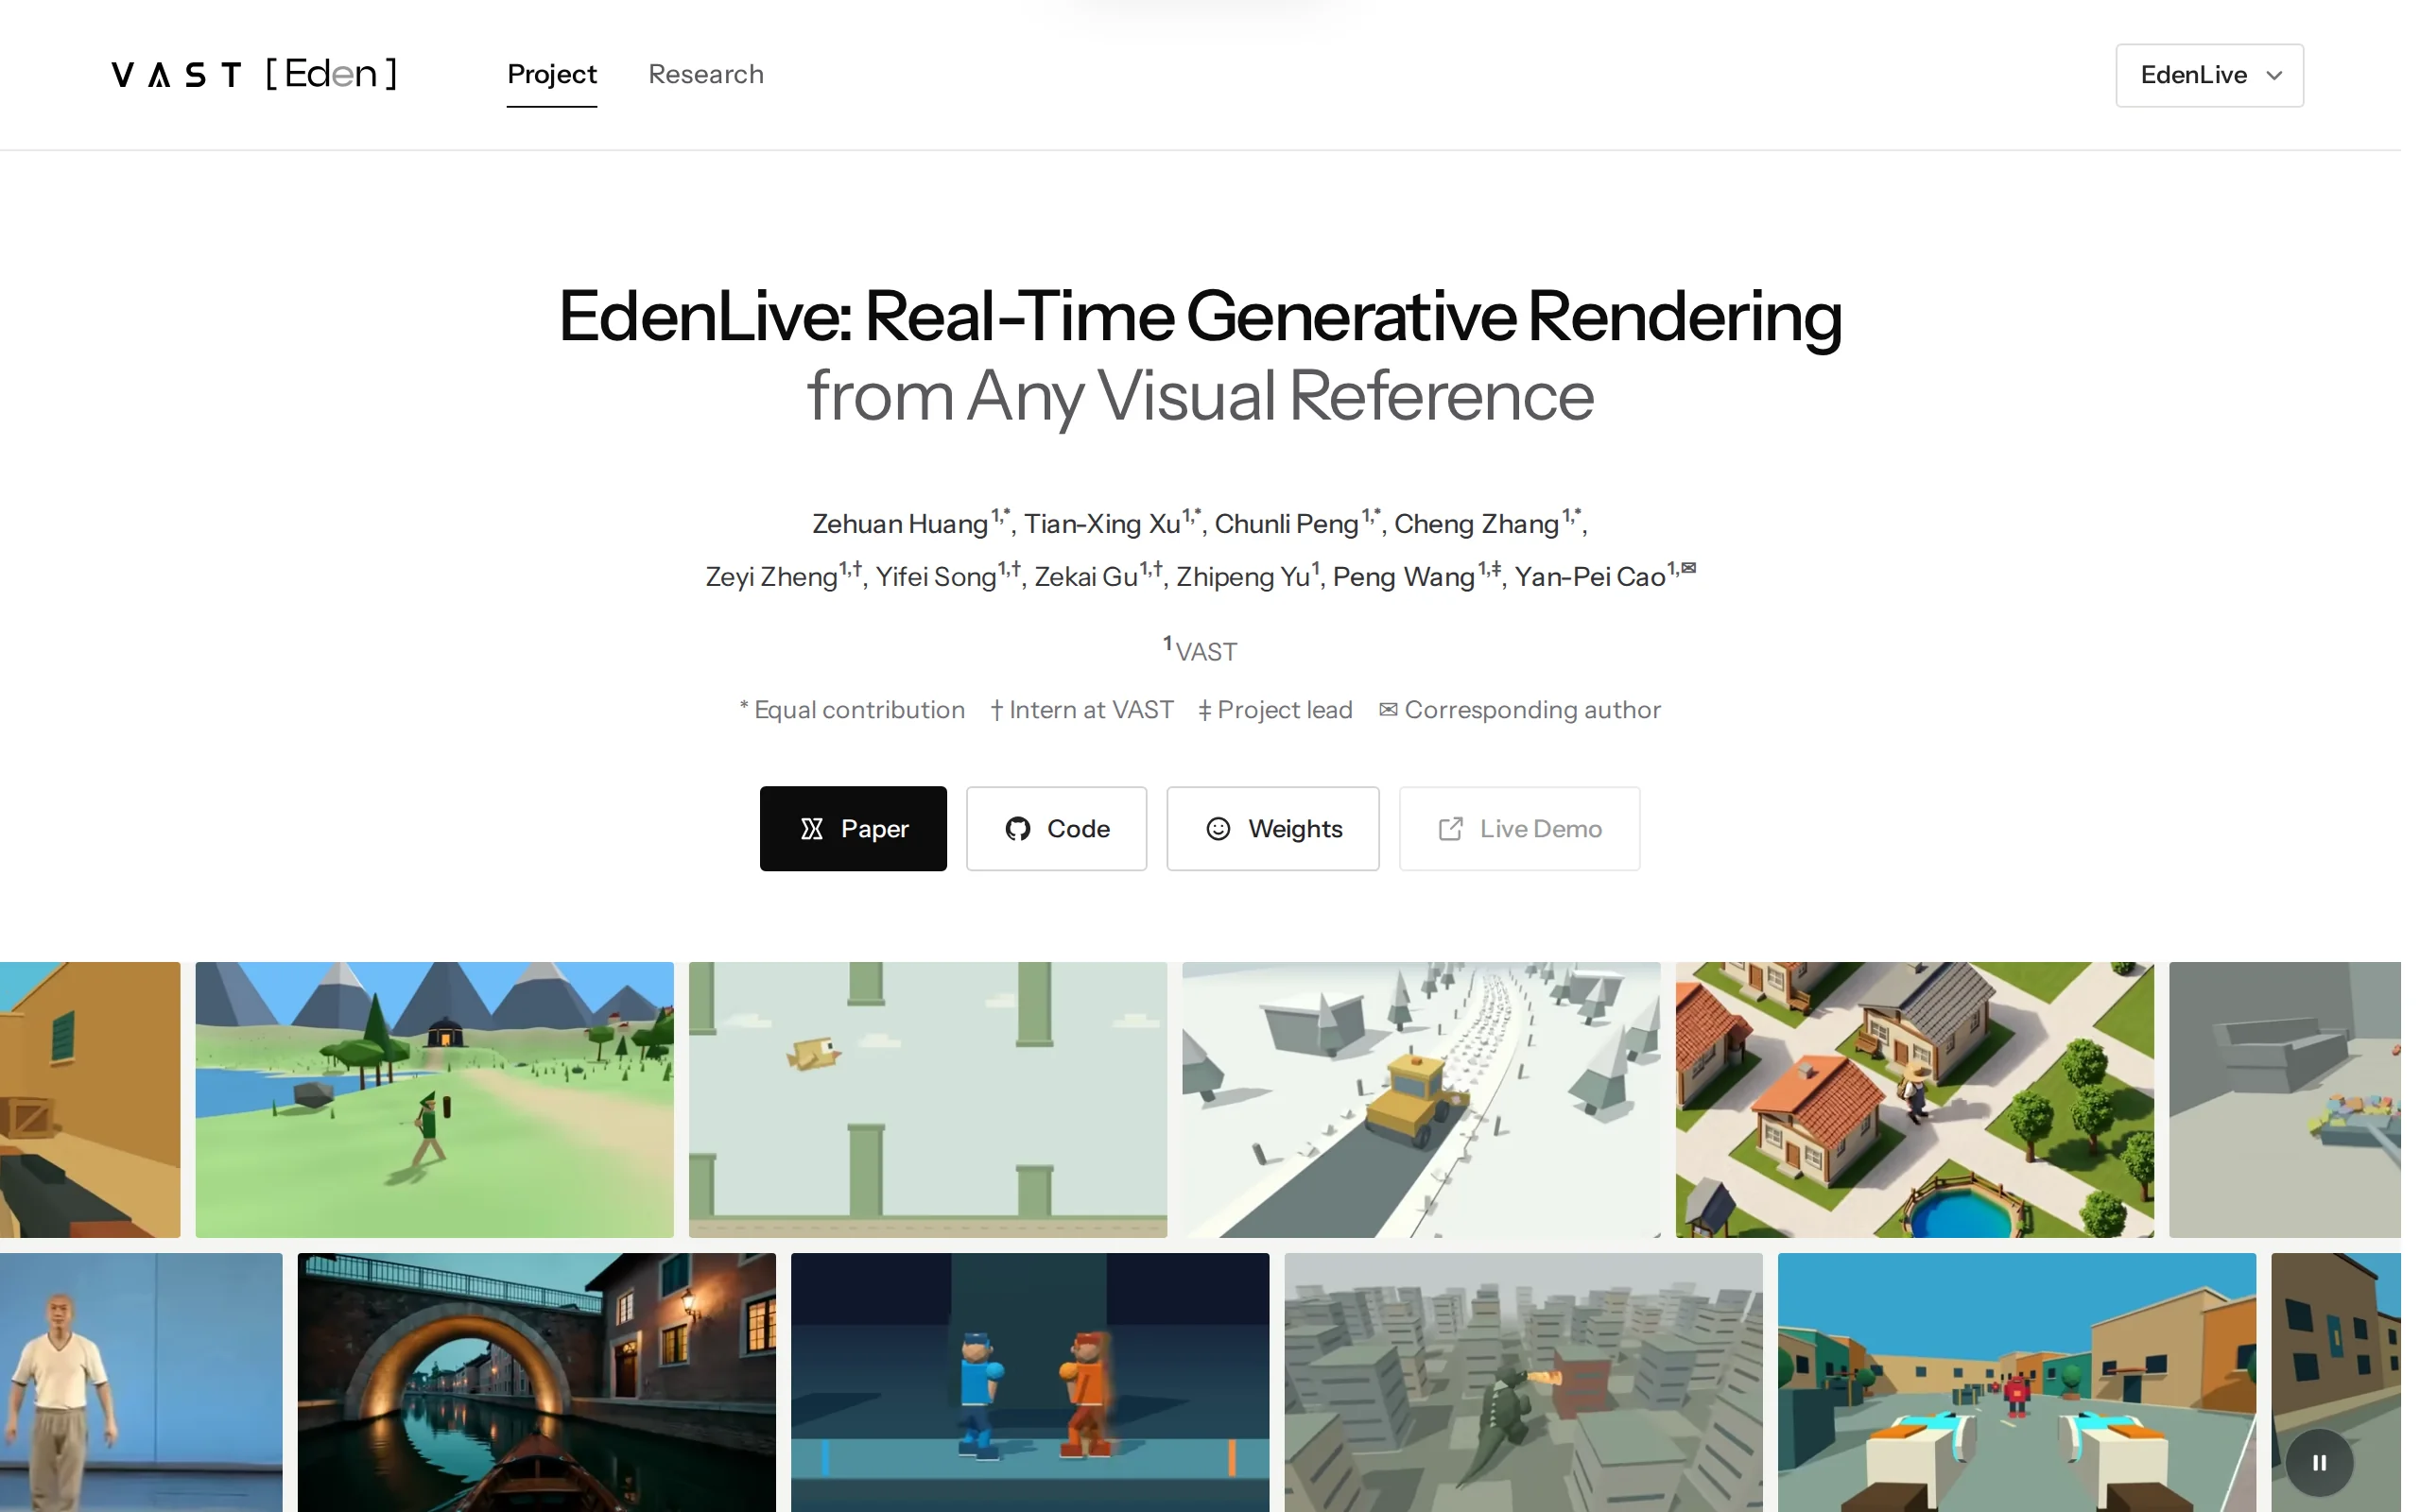
EdenLive 是 VAST 推出的实时生成式渲染器,也是其世界模型项目 Project Eden 的阶段性成果。该工具以 Proxy 简化画面或参考视频为控制信号,结合目标首帧与文本提示词,持续实时生成写实或风格化画面,在单张 RTX 5090 上即可实现 720P、24FPS 以上的输出,端到端延迟仅百毫秒量级。其核心设计在于将世界状态维护与视觉渲染解耦,使视频模型不再承担隐式状态推断,从而...

BlenderWorld – Qwen 开源的 3D 创作 Agent 评测基准
BlenderWorld 是 Qwen 团队联合浙江大学、香港中文大学、复旦大学及新加坡国立大学共同推出的 3D 创作 Agent 评测基准,包含 223 项真实制作任务,用于检验 AI 系统能否根据照片、视频或设计规格,在 Blender 环境中交付可编辑的 3D 工程文件。该基准通过多视角渲染与原生工程结构检查的双轨评审机制,以 2,651 条验收标准综合衡量需求完成度与视觉质量。实测 13 ...
Muse Spark Open – Meta 开源的多模态大模型深度评测
Muse Spark Open是Meta最新开源的多模态大模型,采用稀疏混合专家(MoE)架构,总参数规模达8160亿,单次推理仅激活420亿参数,支持100万Token的超长上下文窗口,能够原生处理文本、图像、视频和音频四种模态的输入。该模型主攻编程与Agent任务,基于MLX框架优化后可在两台M5 Ultra Mac Studio上本地完整运行,将大规模Agent工作流从云端带入桌面端。模型权...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。