
MAI-Voice-2 – 微软推出的一代文本转语音模型
导读摘要:
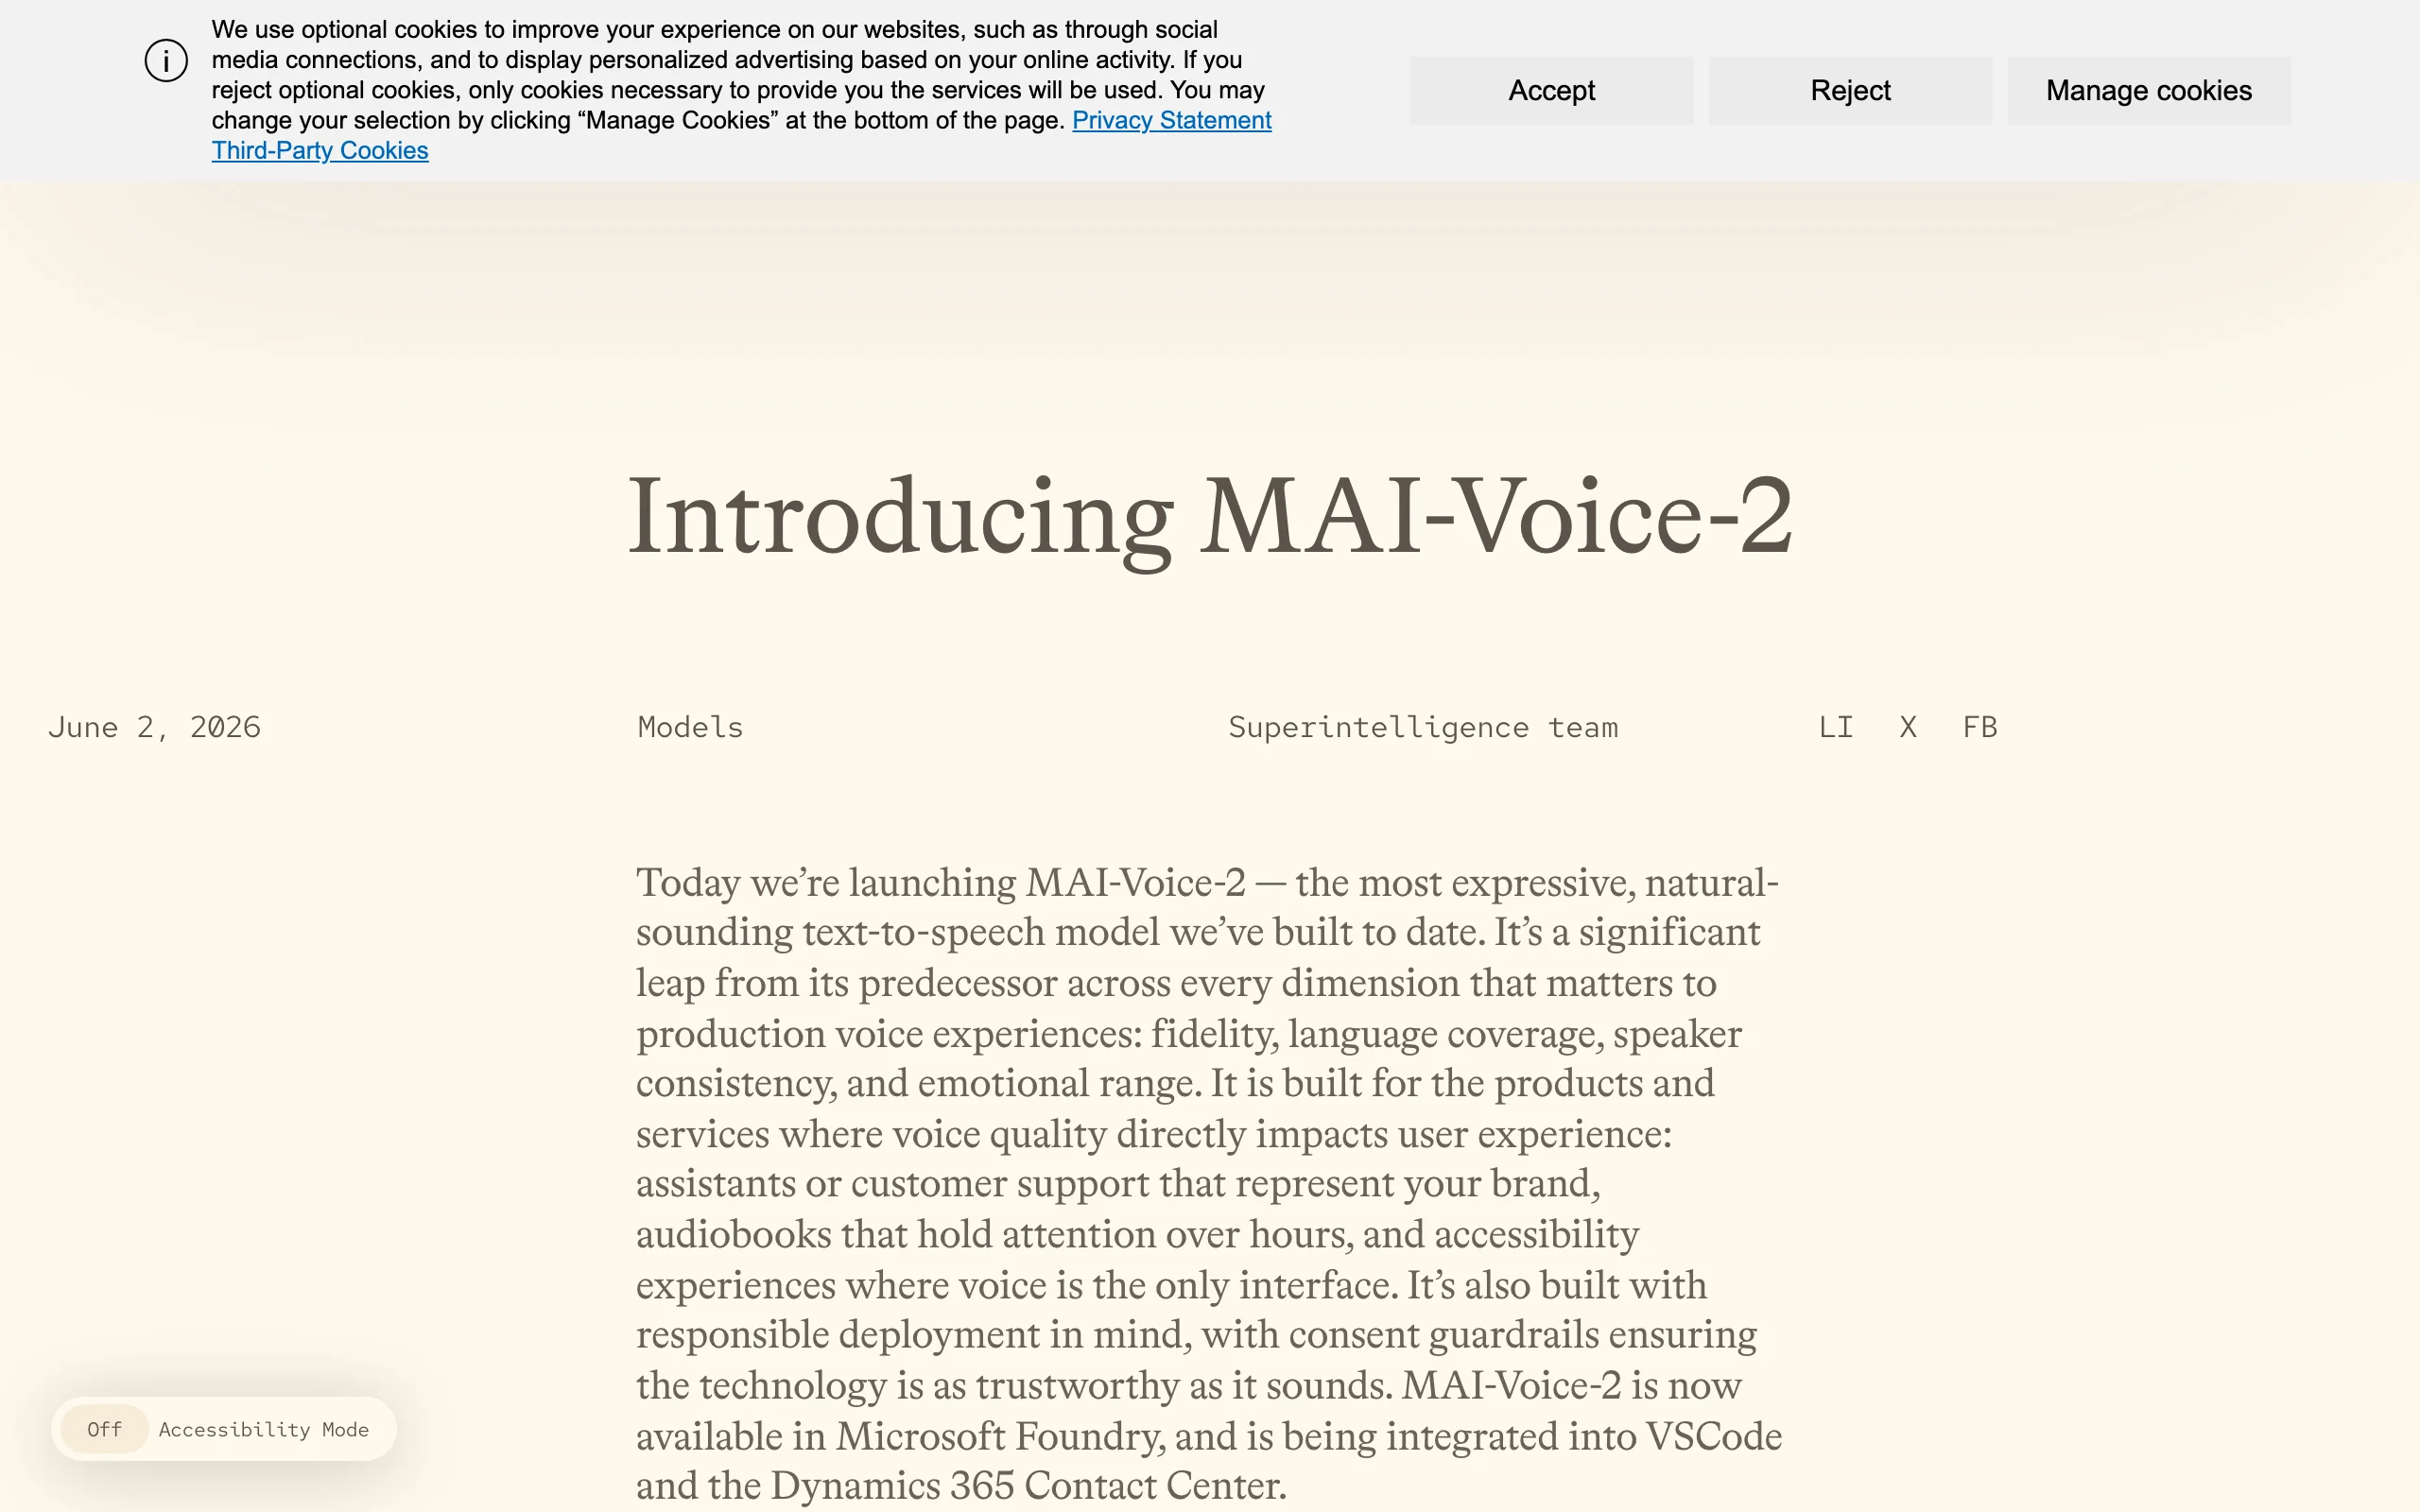
MAI-Voice-2 是微软于2026年6月推出的新一代文本转语音(TTS)模型,基于自研语音基础架构,在保真度、语言覆盖、说话人一致性和情感表达能力上实现了代际飞跃。该模型支持15+种语言,具备细粒度情感控制、零样本语音克隆和自然代码切换能力,在盲测中72%的听众偏好其音质超过前代,合成语音与真人录音的相似度达到难以区分的水平。作为微软AI语音体系的核心组件,MAI-Voice-2面向企业级应...
1. MAI-Voice-2是什么
MAI-Voice-2 是微软于2026年6月推出的新一代文本转语音(TTS)模型,基于自研语音基础架构,在保真度、语言覆盖、说话人一致性和情感表达能力上实现了代际飞跃。该模型支持15+种语言,具备细粒度情感控制、零样本语音克隆和自然代码切换能力,在盲测中72%的听众偏好其音质超过前代,合成语音与真人录音的相似度达到难以区分的水平。作为微软AI语音体系的核心组件,MAI-Voice-2面向企业级应用和内容创作场景,旨在提供高度自然、可控且安全的语音合成解决方案。
技术定位与领域: MAI-Voice-2属于自然语言处理中的语音合成(Text-to-Speech)领域,定位为多语言、高表现力的端到端神经网络TTS模型。它区别于传统拼接合成或参数合成,采用自研的语音基础模型架构,能够从文本中自动提取语义、情感和韵律特征,生成高度拟人的语音输出。
研发背景: 微软研究院和Azure AI团队在语音领域有深厚积累,此前推出的Azure Neural HD语音已在商业场景广泛应用。MAI-Voice-2是微软在语音合成上的重大升级,旨在解决前代模型在语言覆盖、情感控制精细度、长文本稳定性上的不足,并响应市场对零样本语音克隆和代码切换的需求。
核心价值: 该模型解决了多语言环境下语音合成的自然度不一致问题,通过统一建模使15+种语言均达到英语同等水平。零样本语音克隆大幅降低了定制声音的成本(仅需5-60秒音频),而系统级强制consent机制则从源头杜绝了语音滥用,兼顾了创新与合规。
技术特点: 端到端架构无需手动调参即可适配语调与情感;多语言统一建模针对不同音系学体系深度优化;零样本语音克隆基于Voice Prompting技术,保持音色与韵律一致性;细粒度SSML情感标签支持悲伤、耳语、兴奋等多种情绪精确控制。
2. 主要功能
多语言自然合成: 从英语单语言扩展至15+种语言,包括声调语言(如中文)、音高重音语言(如日语)、重音计时语言(如英语)和音节计时语言(如西班牙语)。模型针对各语言音系学特性进行深度优化,确保所有语言在自然度和表现力上达到同等水准,用户无需切换模型即可生成多语言语音。
细粒度情感控制: 通过SSML标签支持悲伤、耳语、兴奋、困惑、愤怒等多种情感精确调控。开发者可以在文本中嵌入情感标签,模型自动调整语调、语速和音色,实现从平稳叙述到情绪饱满的平滑过渡,适用于有声书、影视配音等对情感层次要求高的场景。
零样本语音克隆(Voice Prompting): 仅需5-60秒参考音频即可提取说话人身份特征,并迁移至任意目标语言。基于参考音频编码器提取speaker embedding,在合成过程中保持音色、语调和韵律的一致性。无需针对特定说话人微调或重新训练,大幅降低定制品牌声音的门槛。
说话人身份稳定性: 在数小时的长内容(如有声书、播客、讲座)中,模型能持续保持一致的说话人特征,避免音色漂移或语调突变。这是通过内部注意力机制和长上下文建模实现的,对需要连贯叙述的应用场景至关重要。
自然代码切换: 支持印地语-英语、西班牙语-英语等语言对在句子内自然混说,不丢失韵律和身份一致性。模型能够识别语言边界并自动调整发音,实现如同双语母语者般的流畅切换,特别适合多语言市场的内容本地化。
角色风格扮演: 支持特定角色风格,如励志教练、体育解说员、新闻播音员等。开发者可通过预设的角色提示或自定义参数,让语音适配特定场景的语调、节奏和情感色彩,无需手动调整大量参数。
3. 如何使用
环境要求与前置条件: 使用MAI-Voice-2需通过微软Azure Foundry平台,无需本地部署硬件。用户需拥有Azure订阅并开通MAI-Voice-2 API服务。建议使用Python 3.8+环境调用REST API,或通过Azure SDK进行集成。语音克隆功能需额外申请授权,生产环境仅允许经许可的声音。
核心使用流程: 首先在Azure Foundry中创建MAI-Voice-2资源,获取API密钥和端点。然后通过HTTP POST请求发送合成指令,请求体包含文本内容、说话人标识(预置声音或自定义声音ID)、语言代码及可选的情感标签。示例命令:
import requests
headers = {"Ocp-Apim-Subscription-Key": "YOUR_KEY"}
body = {
    "text": "今天天气真好,我们出去走走吧。",
    "voice": "zh-CN-XiaoxiaoNeural",  # 预置声音
    "style": "cheerful"  # 情感标签
}
response = requests.post("https://your-endpoint.cognitiveservices.azure.com/...", headers=headers, json=body)
关键配置说明: 情感控制使用SSML格式,如
<mstts:express-as style="sad">。语音克隆需先上传参考音频(5-60秒,16kHz单声道WAV或MP3),系统自动生成声音模型并分配ID,后续合成时引用该ID。代码切换功能通过语言标签自动识别,无需额外配置。注意事项与最佳实践: 语音克隆功能需申请授权,未授权声音无法在生产环境使用,建议提前提交申请。长文本建议分段处理(每段不超过10分钟),以避免API超时。情感标签需与文本内容匹配,否则可能产生不自然的语调。测试阶段可使用免费层(每月一定额度),生产环境建议选择标准层以获得更高并发和稳定性。
4. 优缺点分析
| 优点 |
|---|
| 音质领先: 盲测中72%用户偏好超过前代,合成语音与真人录音难以区分,在自然度和表现力上达到业界顶尖水平。 |
| 零样本语音克隆便捷: 仅需5-60秒音频即可克隆声音,无需微调或大量数据,大幅降低品牌声音定制门槛。 |
| 长文本稳定性优异: 在数小时的有声书、播客中保持一致的说话人特征和音质,无音色漂移,适合长篇内容生成。 |
| 安全合规机制完善: 系统级强制consent机制,未授权声音无法生产使用,从源头杜绝语音滥用,满足企业合规要求。 |
5. 同类工具对比
| 对比维度 | MAI-Voice-2 (微软) | Google Gemini 3.1 Flash TTS | ElevenLabs TTS |
|---|---|---|---|
| 核心架构 | 自研端到端语音基础模型,多语言统一建模 | 基于Gemini多模态模型的语音生成模块 | 专有深度学习架构,支持语音克隆和情感控制 |
| 语言支持 | 15+种语言,含代码切换(印地-英、西-英) | 70+种语言,覆盖最广 | 29种语言,支持多语言语音克隆 |
| 情感控制 | 细粒度SSML标签(悲伤、耳语、兴奋等) | 200+内联音频标签([sigh]、[laughing]等),支持自然语言提示 | 情感滑块(0-100)和预设风格,控制维度较粗 |
| 语音克隆 | ✅ 5-60秒零样本,全语言支持,需授权 | ❌ 不支持 | ✅ 支持,但需付费(Professional以上套餐),克隆质量高 |
| 多说话人 | ❌ 不支持原生多人对话 | ✅ 单次API调用原生支持2人对话 | ✅ 支持,但需手动拼接或使用项目功能 |
| 长文本稳定性 | 针对有声书、播客优化,数小时稳定 | 几分钟以上质量可能漂移,建议分块处理 | 长文本稳定性较好,但有音色漂移报告 |
| 安全与合规 | 系统级强制consent,未授权声音无法生产 | SynthID水印,依赖服务条款 | 提供声音验证和版权声明,但无强制机制 |
| 部署方式 | 云端API(Azure Foundry) | 云端API(Google Cloud) | 云端API + 部分本地SDK |
| 定价模式 | 按字符计费,有免费层 | 按字符计费,有免费层 | 按字符计费,无免费层 |
选型建议: 对于需要多语言覆盖(特别是小语种)且不要求语音克隆的场景,Google Gemini Flash TTS是首选,其70+语言和原生多说话人对话能力优势明显。如果核心需求是高品质语音克隆和品牌声音定制,MAI-Voice-2的零样本克隆和长文本稳定性更胜一筹,但需接受语言覆盖较少和授权流程。ElevenLabs在语音克隆质量和情感控制上表现优秀,但价格较高且免费额度有限。OpenAI TTS适合追求极致自然度的简单合成任务,但缺乏情感控制和克隆能力,功能较为单一。
6. 编辑点评
MAI-Voice-2代表了微软在语音合成领域的最新技术成果,其技术创新性主要体现在三个层面:一是自研端到端架构实现了从文本到语音的 holistic 理解,无需手动调参即可适配语调、情感和风格,这在业界同类产品中较为罕见;二是多语言统一建模针对不同音系学体系进行深度优化,使15+种语言均达到英语同等的自然度,解决了以往多语言TTS“英语好、其他差”的痛点;三是零样本语音克隆结合系统级强制consent机制,在降低使用门槛的同时构建了安全防线,为语音合成的商业化落地提供了可复用的范式。
实用价值方面,MAI-Voice-2在有声书、播客、客服中心、游戏配音等场景具有明显优势,特别是长文本稳定性和情感控制能力,能显著提升内容生产效率。其语音克隆功能让中小团队也能快速打造品牌专属声音,无需专业录音棚。
适用人群包括:需要多语言高品质语音合成的企业开发团队、内容创作者(播客、有声书作者)、游戏开发者、无障碍辅助工具开发者等。需要注意的是,语音克隆授权流程和云端依赖可能对部分用户构成障碍。
未来发展潜力巨大。随着微软持续投入语音基础模型,预计语言覆盖将扩展至40+种,并可能支持原生多说话人对话和离线部署。安全机制也可能成为行业标准。
7. 应用场景
智能助手与客服中心: 为Copilot、虚拟客服、智能设备提供品牌专属声音。通过语音克隆创建一致的企业语音形象,结合情感控制实现同理心回应,提升用户交互体验。例如,银行客服可使用平静、专业的语音,而娱乐助手则可采用活泼、鼓励的语气。
有声书与播客制作: 创作者无需专业录音棚,即可将文字内容转换为高质量有声书或播客。利用长文本稳定性特点,可一次性生成数小时内容,且说话人身份一致。情感标签可精确控制叙述中的情绪起伏,使故事更具感染力。
游戏与AR/VR配音: 为游戏角色、虚拟世界旁白提供多语言、多风格语音。通过角色风格扮演功能,可快速为不同角色(如NPC、解说员、反派)生成符合角色设定的声音,降低配音成本和时间。
无障碍辅助: 为视障用户提供文本朗读,为言语障碍者提供语音替代方案。MAI-Voice-2的高自然度语音能提升阅读体验,而语音克隆功能可让言语障碍者使用自己(或授权)的声音进行交流,更具个性化。
在线教育与培训: 为在线课程、模拟场景提供讲师和虚拟角色声音。支持多语言代码切换,适合双语教学场景;情感控制可让讲解更具吸引力,提升学习效果。
8. 常见问题FAQ
Q:MAI-Voice-2支持哪些语言?
A:目前支持15+种语言,包括英语、中文(普通话)、日语、韩语、西班牙语、法语、德语、意大利语、葡萄牙语、俄语、阿拉伯语、印地语等。微软计划后续扩展至更多语言,特别是小语种。
Q:语音克隆需要多少参考音频?质量要求如何?
A:仅需5-60秒的参考音频,建议使用16kHz单声道WAV或MP3格式,内容清晰无背景噪音。音频越长,克隆质量越稳定,但60秒已能获得优秀效果。无需专业录音棚,普通手机录音即可。
Q:语音克隆功能如何使用?是否需要额外授权?
A:需要在Azure Foundry中提交语音克隆授权申请,通过后系统会分配声音模型ID。生产环境仅允许经许可的声音,未经授权的声音无法用于商业用途。测试阶段可在有限额度内试用。
Q:MAI-Voice-2能否本地部署?
A:目前仅通过Azure Foundry云端API提供服务,不支持本地部署。对于数据隐私要求高的用户,微软提供了数据加密和合规认证,但无法完全离线使用。
Q:如何实现代码切换(如中英混说)?
A:在SSML或API请求中,直接混合不同语言的文本,模型会自动识别语言边界并切换发音。无需额外标签,但建议在文本中明确标注语言(如使用<lang xml:lang="en">标签)以获得最佳效果。
Q:长文本合成有无字符限制?
A:API单次请求建议不超过10分钟音频(约5000字符)。对于更长的内容(如整本有声书),建议分段合成并拼接,模型在每段内保持说话人一致性,拼接后音色稳定。
Q:情感标签有哪些?如何使用?
A:支持悲伤、耳语、兴奋、困惑、愤怒、平静、严肃、幽默等多种情感。使用SSML标签<mstts:express-as style="sad">包裹文本,或通过API请求中的“style”参数指定。情感需与文本内容匹配,否则可能产生不自然效果。
9. 项目地址
- 项目官网与介绍: https://microsoft.ai/news/mai-voice-2expressive-speech-in-10-languages/
- Azure Foundry 文档: https://learn.microsoft.com/en-us/azure/ai-services/speech-service/ (搜索“MAI-Voice-2”)
相关推荐
科大讯飞 SparkAudio 1.0 深度评测:全国产算力驱动的星火语音基座大模型
SparkAudio 1.0 是科大讯飞于 2026 年 10 月 22 日在全球 1024 开发者节上发布的星火语音基座大模型,基于全国产算力完成训练,围绕语音识别、同传翻译、实时交互三大核心方向实现能力跃升,并拓展了音频理解、情绪识别、实时说话人分离与环境声理解等进阶能力。该模型通过半监督音频编码器、动态分段端到端建模、双范式协同解码三项技术创新,实现了整体效果提升 20%、响应时延降低 15...
Eleven Realtime:ElevenLabs 一体化语音 Agent 模型的架构突破与工程实践
Eleven Realtime 是 ElevenLabs 推出的一体化语音 Agent 模型系列,包含 v1 Mini 与 v1 Max 两个版本,核心设计思想是将语音识别(ASR)、语言模型推理、工具调用与语音合成(TTS)整合进单一模型,替代传统方案中多组件串联的复杂架构。该系列支持 90 多种语言,并可调用 ElevenLabs 声音库中 17,000 余种音色,v1 Max 在保持 98....
Ming-3.0:蚂蚁百灵开源全链路语音模型家族深度评测
Ming-3.0是蚂蚁集团百灵大模型团队开源的全链路语音系列模型,围绕语音合成(TTS)、音频理解与对话(Audio)、语音识别(ASR)三类核心任务推出五款模型。该系列以"合成+理解+识别"一体化能力覆盖语音应用全流程,其中TTS系列支持独创的"导演模式"精细控制情绪、节奏与重音,Audio系列可端到端理解长录音并结构化输出,ASR系列支持热词注入与方言识别。模型已落地支付宝、阿福APP等蚂蚁内...
GPT-Live-1.1 – OpenAI 推出的 ChatGPT 一代语音模型
GPT-Live-1.1是OpenAI于2025年推出的ChatGPT新一代语音模型,接替上一代GPT-Live-1成为语音交互的「前台引擎」,同时以轻量版GPT-Live-1.1 Quip替代原mini版本。该模型延续了经典的全双工交互架构,模型无需等待用户说完即可持续采集语音流,实时判断停顿、打断与语速变化,动态决定回应时机,支持用户随时插话或改变提问方向,使对话节奏接近真人交流。在复杂任务处...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。