
Ming-Image-0.1-Design:蚂蚁开源6B图像生成模型,端到端重构设计工作流
导读摘要:
Ming-Image-0.1-Design是蚂蚁集团InclusionAI开源的一款6B参数图像生成模型,专注设计场景,支持8K长结构化提示词,能端到端生成UI、信息图、海报等完整视觉设计。配合同步开源的Design-Layer模型,该工具可将设计图拆解为2—9个可独立编辑的透明图层,实现"生成—分层—编辑—交付"全流程。Ming-Image-0.1-Design登顶Artificial Anal...
1. Ming-Image-0.1-Design是什么
Ming-Image-0.1-Design是蚂蚁集团InclusionAI开源的一款6B参数图像生成模型,专注设计场景,支持8K长结构化提示词,能端到端生成UI、信息图、海报等完整视觉设计。配合同步开源的Design-Layer模型,该工具可将设计图拆解为2—9个可独立编辑的透明图层,实现"生成—分层—编辑—交付"全流程。Ming-Image-0.1-Design登顶Artificial Analysis UI/UX开源榜第一,已接入灵光闪应用和画眉等真实业务。
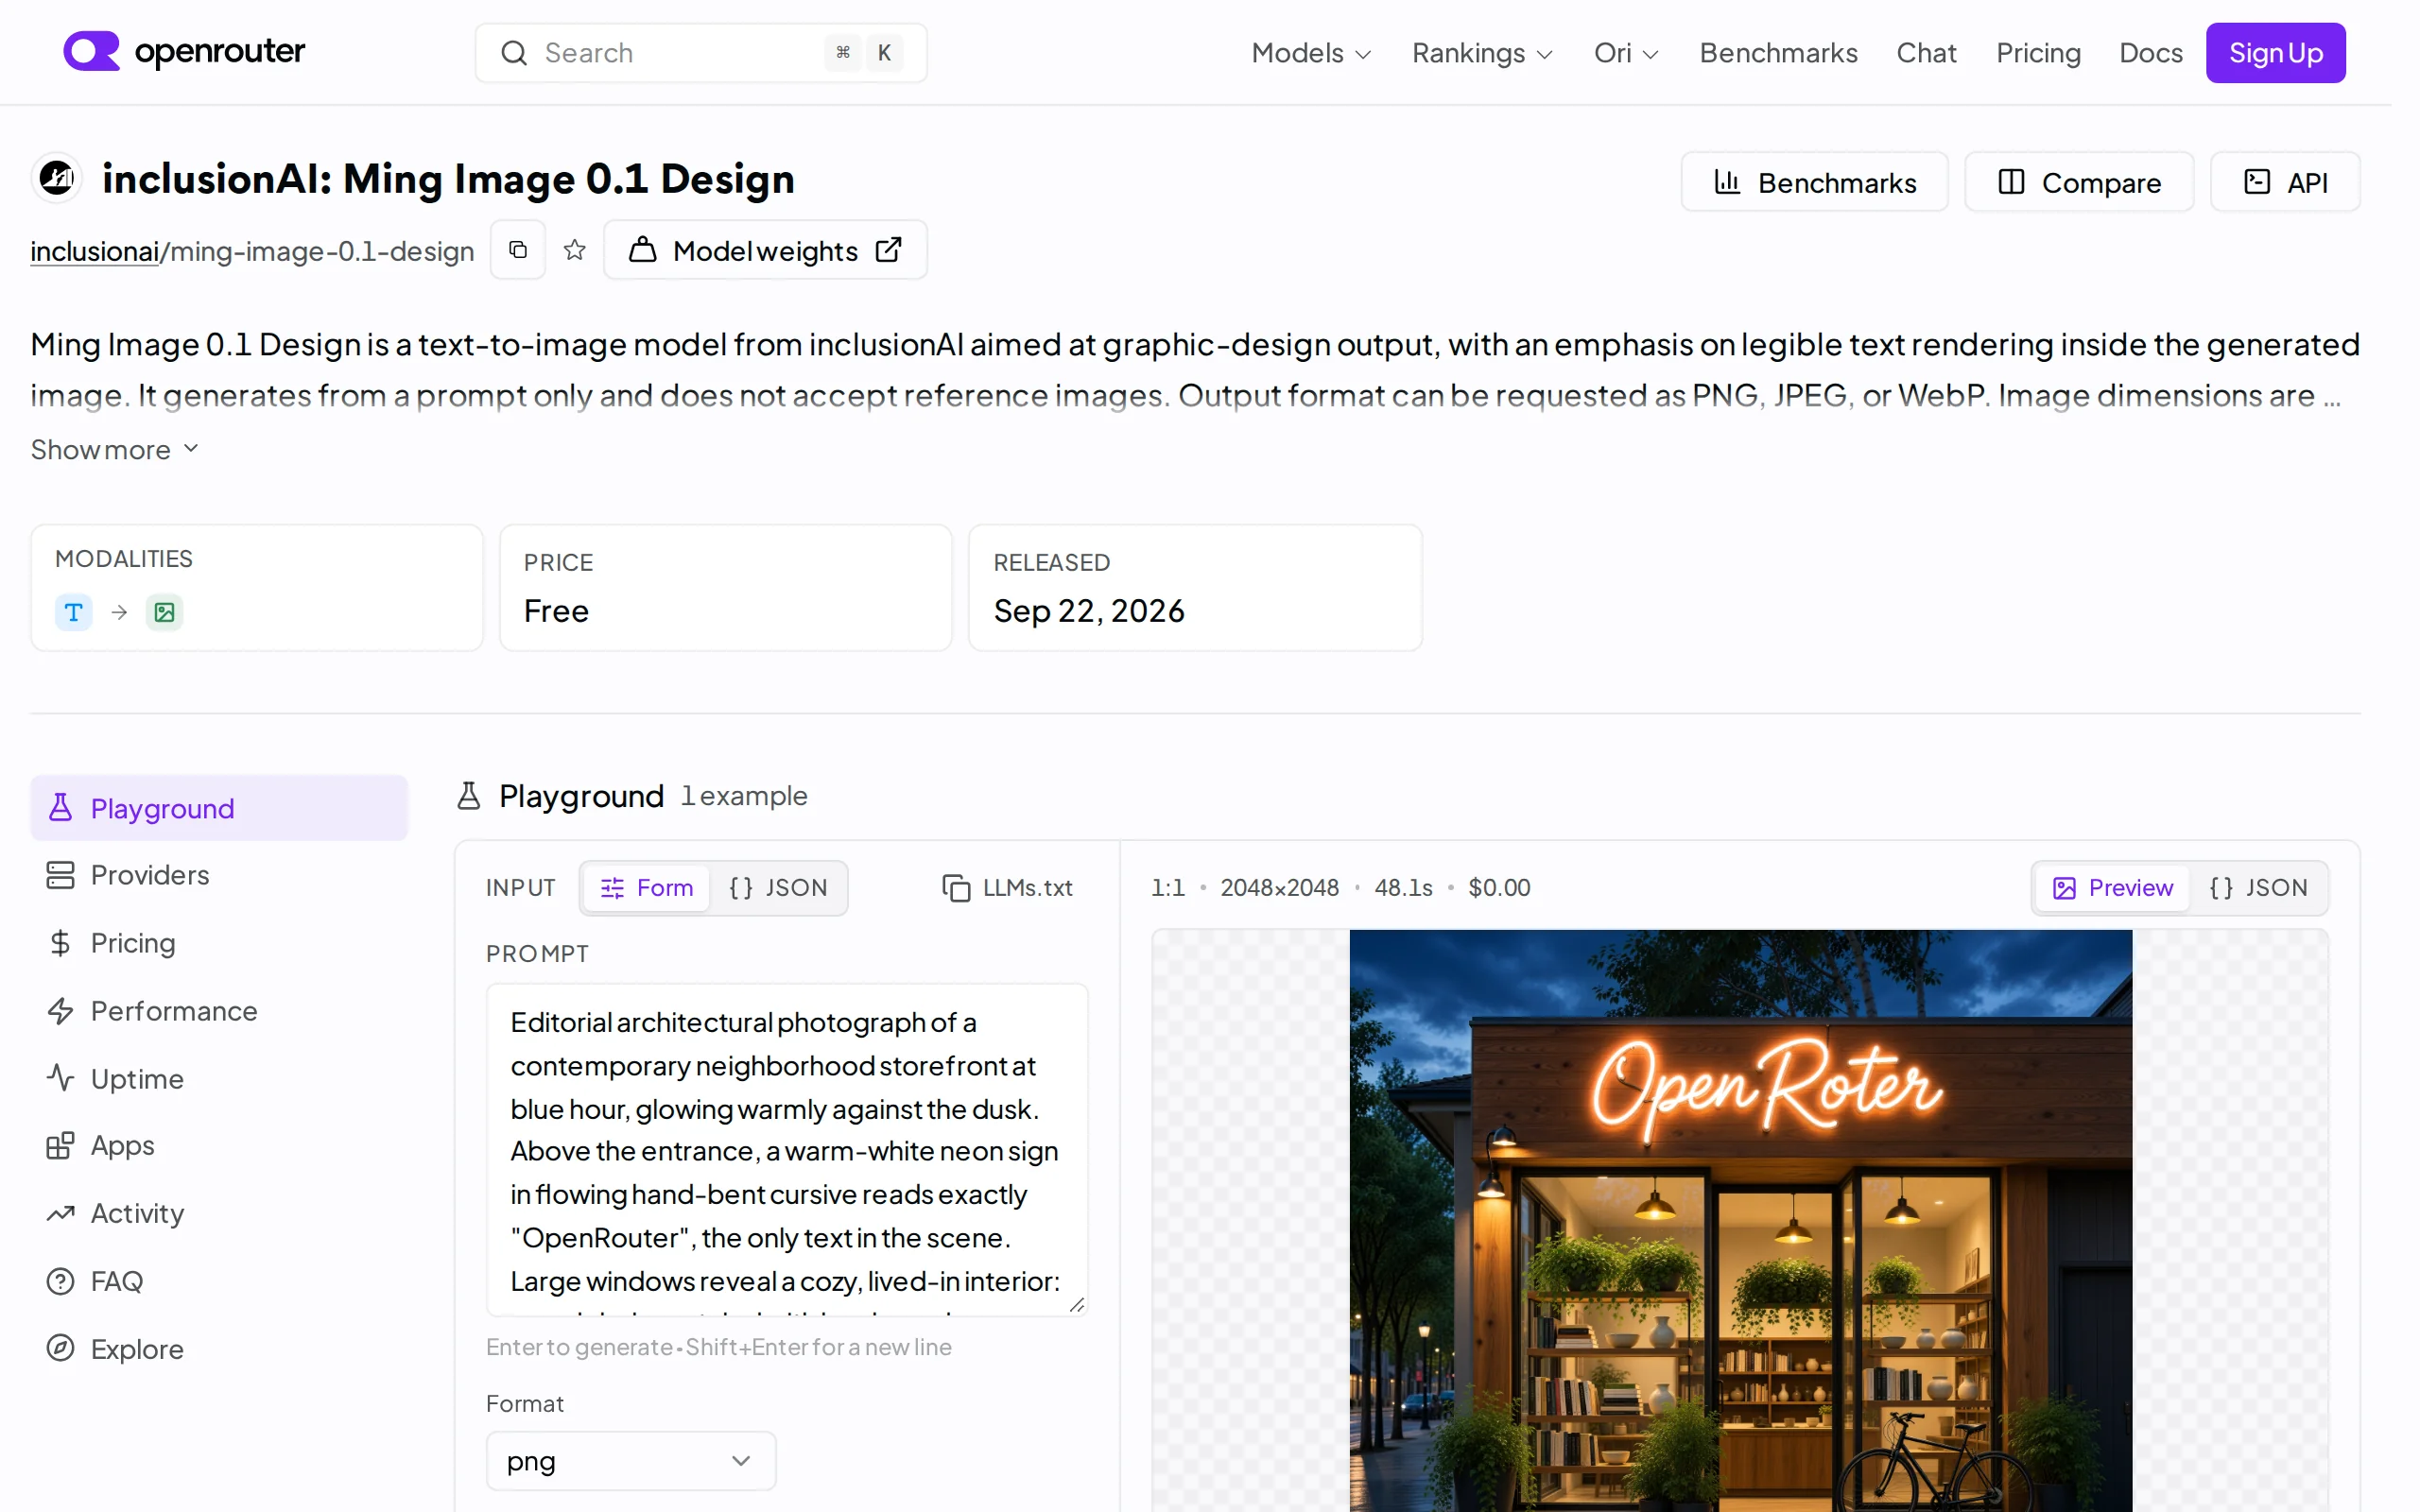
图片来源为官方文章
技术定位与领域: 属于生成式AI图像生成领域,聚焦设计自动化方向。该模型并非通用文生图工具,而是针对UI设计、信息图、海报等结构化视觉内容进行专项优化的专业模型,其核心差异化在于"可编辑性"——生成结果不再是扁平图片,而是可拆解、可修改、可交付的设计资产。
研发背景: 由蚂蚁集团InclusionAI团队开发,基于团队在图像生成、多模态理解和设计工具链方面的技术积累。研发动机源于传统AI生图"一次性产出、不可编辑"的痛点,以及设计行业中从概念到交付的漫长链路。团队希望通过开源模型+配套工具链,降低设计自动化的门槛。
核心价值: 解决了三个关键问题:其一,长提示词理解能力不足导致复杂设计需求无法完整表达;其二,生成结果不可编辑,难以进入专业设计流程;其三,从设计图到可运行前端页面或PPT的交付链路断裂。通过8K提示词、RGBA VAE和分层模型,将生成结果转化为可继续加工的设计素材。
技术特点: 自研原生RGBA VAE使生成空间直接覆盖透明背景素材,无需后处理抠图;Type Token图层角色约束和Alpha-Aware Layer Optimization保证分层质量;Composite-Layer Stack Consistency约束确保图层重组后高度还原原图。6B参数量在性能与部署成本间取得平衡。
2. 主要功能
文生设计: 支持8K长结构化提示词,模型将用户需求自动组织为文案、模块、布局和视觉风格四个维度的结构化输入,从文字需求端到端生成UI、Dashboard、信息图、海报等完整视觉设计。超长提示中的信息被完整理解和执行,支撑复杂页面中多模块、多元素的准确呈现。
文字与版式渲染: 针对标题、按钮、卡片和多区域信息的文字呈现进行专项优化,保证版式稳定、信息排布准确。这一能力在传统文生图模型中往往薄弱,而Ming-Image通过专项训练强化了文字生成质量,使设计图中的文字内容清晰可读、位置准确。
全局风格统一: 区别于"分别生成背景、插画和装饰再拼装"的做法,模型在一次生成过程中统筹全局布局、配色和素材风格,通过专项训练强化文字、版式和多元素组合能力,从根本上减少素材间的色系冲突和画风不一致,避免多次生成造成的风格割裂和模板感。
透明素材生成: 原生RGBA VAE使生成空间直接覆盖透明背景素材,人物、商品、图标和装饰可以带着Alpha通道输出。自研支持Alpha通道的变分自编码器,使透明素材无需后处理抠图即可直接进入设计工作流,显著提升素材生产效率。
设计分层(Layer): Design-Layer模型可将设计图拆成2—9个语义独立的RGBA图层,支持文字、主体、背景的单独修改、移动和替换。通过Type Token显式告诉每个图层自己承担的设计角色,引导模型按语义进行拆分,保证拆出的图层内容清晰、职责独立。在Crello-Test 12项指标中全部排名第一。
前端交付(Design Skill): Text-to-Page模式先出设计方案再写代码,用户输入需求约15秒即可先看到页面方案,确认后再交给Coding生成可运行页面;Visual Coding模式支持从设计稿截图还原可运行页面。打通了从设计到前端代码的自动化链路。
PPT交付(PPT Skill): 将图片中的文字、色块、布局还原为PowerPoint可编辑元素,图标插画直接提取复用。用户可以在PowerPoint中继续修改文案、配色和布局,实现从设计图到可编辑演示文档的快速转换。
3. 如何使用
选择接入方式: 可通过OpenRouter在线免费API(https://openrouter.ai/inclusionai/ming-image-0.1-design)快速体验,无需本地部署;也可从Hugging Face或ModelScope下载模型权重进行本地部署。本地部署建议使用具备16GB以上显存的GPU,模型参数量为6B。
编写提示词: 用自然语言描述设计需求,建议按"文案、模块、布局、视觉风格"四个维度的结构组织内容,以发挥8K长提示词能力。例如描述页面用途、需要包含的模块、整体布局偏好和视觉风格倾向,模型会自动将需求组织为结构化输入。
生成设计图: 调用Design模型,一次生成UI、信息图或海报等完整视觉设计。模型会在一次生成过程中统筹全局布局、配色和素材风格,约20秒返回完整结果(工程优化后),无需多次生成再手动拼接。
拆解图层: 将生成的设计图或已有的设计图输入Design-Layer模型,拆分为2—9个可独立编辑的透明图层。图层按设计角色组织,支持文字、主体、背景的单独修改、移动和替换。Alpha-Aware优化保证透明边缘干净、无残留。
前端交付: 在GitHub获取Design Skill(ling-cookbook),输入需求约15秒先出页面方案,确认后再交给Coding生成可运行页面。也可将设计稿或截图输入,经Layer拆解素材后自动生成可运行前端页面,并通过截图比对自动校验修正。
PPT交付: 使用PPT Skill(ling-cookbook),将设计图一键还原为可编辑的PowerPoint页面,文字、色块、布局均可继续修改,图标插画可直接提取复用。适合需要快速将视觉设计转化为演示文档的场景。
4. 优缺点分析
| 优点 |
|---|
| 小参数高性能: 6B参数在复杂UI任务中对战Nano Banana 2、FLUX.2等更大模型取得12/12、10/10全胜成绩,在Artificial Analysis UI/UX开源榜登顶,展现出色的参数效率。 |
| 端到端风格统一: 一次生成统筹全局布局、配色与素材风格,避免多次生成拼接造成的风格割裂和模板感,从根本上减少素材间的色系冲突和画风不一致问题。 |
| 设计可编辑性强: Layer模型将设计图拆成语义独立的RGBA图层,Crello-Test 12项指标全部第一,透明边缘干净无残留,重组后高度还原原图,让生成结果可继续修改。 |
| 速度快成本低: 比20B Qwen开源版快约4.3倍(单次推理183秒对比795秒),工程优化后约20秒出图,改字成本仅为GPT-image2的1/7,适合高频迭代的设计场景。 |
| 交付链路完整: 配合Design Skill和PPT Skill,可从文字或参考图直达前端页面和可编辑PPT,首次见效果从5分钟降至15秒,显著缩短设计交付周期。 |
5. 同类工具对比
| 对比维度 | Ming-Image-0.1-Design | Qwen-Image-Layered | Nano Banana 2 |
|---|---|---|---|
| 参数量 | 6B | 20B | 约12B |
| 核心架构 | 原生RGBA VAE + Type Token图层约束 + Composite-Layer重组一致性 | 分层生成架构,图层语义角色约束较弱 | 通用文生图架构,不支持原生分层 |
| 复杂UI任务表现 | 对战12/12、10/10全胜,登顶Artificial Analysis UI/UX开源榜 | 全面落后于Ming-Image | 被Ming-Image击败 |
| 分层能力 | 2—9个语义独立RGBA图层,按设计角色组织,Crello-Test 12项指标全部第一 | 图层解耦,语义角色约束较弱,复杂遮挡下边缘残留较多 | 不支持设计分层 |
| 单次推理时间 | 183秒(工程优化后约20秒) | 795秒 | 待官方公布 |
| 交付链路 | Design Skill(前端)+ PPT Skill,从文字直达可运行页面和可编辑PPT | 无配套交付工具 | 无配套交付工具 |
| 部署方式 | 开源权重,本地部署或OpenRouter在线API | 开源权重,本地部署 | 闭源API |
| 开源协议 | 开源(权重与Skills全部开源) | 开源 | 闭源 |
| 社区生态 | 新开源,社区生态建设中 | 依托Qwen生态,社区较活跃 | 依托Google生态 |
选型建议: 对于设计自动化场景,Ming-Image-0.1-Design在分层能力和交付链路上具有明显优势,尤其适合需要将AI生成结果继续编辑、交付为前端页面或PPT的团队。其6B参数在部署成本和推理速度上更具竞争力,是设计工具链集成的优先选择。Qwen-Image-Layered虽然参数更大,但分层质量和推理速度均落后,适合对参数规模有特定要求的场景。
对于通用图像生成需求,Nano Banana 2和FLUX.2在写实、艺术创作等领域可能表现更均衡,但缺乏设计分层和交付能力。若用户需要的是"一次性出图"而非"可编辑设计资产",这两款模型仍是可靠选择。若团队已有设计工具链且需要AI生成能力,Ming-Image-0.1-Design的开源权重和配套Skills提供了更完整的解决方案。
6. 编辑总结
Ming-Image-0.1-Design的技术创新性体现在三个层面:其一,原生RGBA VAE的设计使生成空间直接覆盖透明背景素材,跳过了传统"生成—抠图"的后处理环节,这是架构层面的实质改进而非工程优化;其二,Type Token图层角色约束和Composite-Layer Stack Consistency约束共同解决了AI生成内容不可编辑的行业痛点,使生成结果从"图片"升级为"设计资产";其三,6B参数在复杂UI任务中击败参数规模数倍于己的模型,验证了"小参数+专项优化"路线在垂直场景中的可行性。
从实用价值看,该模型最突出的贡献是打通了"文字需求—视觉设计—可编辑图层—前端代码/PPT"的完整交付链路。传统AI生图工具输出的是最终成品,而Ming-Image-0.1-Design输出的是可继续加工的半成品,这一定位更贴合设计行业的实际工作流程。改字成本仅为GPT-image2的1/7、首次见效果从5分钟降至15秒等数据,表明其在效率维度具有可量化的优势。
适用人群方面,该模型适合三类用户:一是AI应用开发者,可在Agent写代码前快速生成视觉预览;二是专业设计师,可将AI生成的海报、主视觉拆解为可编辑图层后精修;三是需要快速产出PPT或前端页面的产品经理和运营人员。对于追求极致写实效果的艺术家或摄影爱好者,该模型并非首选。
未来发展潜力上,随着设计分层能力和交付工具链的持续完善,AI生成内容有望更深度地嵌入专业设计工作流。开源策略降低了集成门槛,社区生态的成长将决定其能走多远。Ming-Image-0.1-Design代表了一种方向:AI图像生成的目标不是替代设计师,而是让设计流程中的重复劳动自动化,让设计师专注于创意决策。
7. 应用场景
AI应用生成预览: 在Agent写代码前先由Design生成应用视觉预览,让用户提前确认设计方向,实现"所见即所得"。产品经理可以用自然语言描述功能需求,模型生成UI预览图,确认后再进入开发阶段,避免开发完成后才发现设计不符合预期,显著降低沟通和返工成本。
专业设计图层编辑: 设计师将海报、电商主视觉一键拆为可编辑图层,约40秒可分别改字、移动主体、替换背景,并导出PSD。例如电商大促海报需要更换商品图和价格文案时,无需重新设计,直接在拆解后的图层上修改即可,大幅提升设计迭代效率。
前端页面还原(Visual Coding): 输入设计稿或截图,经Layer拆解素材后自动生成可运行前端页面,并通过截图比对自动校验修正。前端开发者可将设计图直接转换为页面代码,减少从设计稿到手写HTML/CSS的重复劳动,尤其适合活动页、落地页等标准化页面的快速产出。
PPT快速复刻: 将一张设计图还原为可编辑的PowerPoint页面,文案、配色、图片均可继续修改,图标插画直接提取复用。市场或运营人员看到一张优秀的海报或信息图,可以快速将其转化为可编辑的PPT模板,在保留视觉风格的同时替换为自己的内容。
8. 常见问题FAQ
Q:Ming-Image-0.1-Design与通用文生图模型(如Stable Diffusion、FLUX)有何本质区别?
A:通用文生图模型输出的是扁平图片,不可编辑;Ming-Image-0.1-Design输出的是"设计资产"——配合同步开源的Design-Layer模型,可将生成结果拆解为2—9个语义独立的RGBA透明图层,支持文字、主体、背景的单独修改。此外,该模型针对UI、信息图、海报等结构化设计场景进行了专项优化,在文字渲染、版式稳定性和全局风格统一上表现更好,而通用模型在写实、艺术创作等场景可能更擅长。
Q:8K长提示词能力在实际使用中如何体现?
A:传统文生图模型对超过数百字的提示词往往"选择性失明",长提示中的信息无法被完整执行。Ming-Image-0.1-Design将用户需求自动组织为文案、模块、布局和视觉风格四个维度的结构化输入,使最高8K长度的提示词中的信息被完整理解和执行。实际使用中建议按这四个维度组织提示词,例如描述页面用途、包含的模块、布局偏好和视觉风格,模型能更准确地呈现复杂页面中的多模块、多元素。
Q:Design-Layer模型的分层质量如何?能否用于专业设计工作流?
A:Design-Layer在Crello-Test 12项指标中全部排名第一,通过Type Token图层角色约束引导模型按语义拆分,Alpha-Aware Layer Optimization保证透明边缘干净无残留,Composite-Layer Stack Consistency约束确保图层重组后高度还原原图。实际使用中,设计师约40秒可将海报拆解为可编辑图层并导出PSD,满足专业设计工作流中对图层独立性和编辑自由度的要求。
Q:本地部署需要什么硬件配置?
A:模型参数量为6B,推荐使用具备16GB以上显存的GPU进行推理。工程优化后单次生成约20秒返回完整结果。对于硬件配置不足的用户,可通过OpenRouter在线免费API(https://openrouter.ai/inclusionai/ming-image-0.1-design)体验,无需本地部署。权重已开源,支持自由构建设计工具。
Q:如何将生成的设计图交付为前端页面或PPT?
A:可通过GitHub获取Design Skill和PPT Skill(ling-cookbook)。Design Skill支持Text-to-Page模式(输入需求约15秒先出页面方案,确认后生成可运行页面)和Visual Coding模式(从设计稿截图还原可运行页面);PPT Skill可将设计图中的文字、色块、布局还原为PowerPoint可编辑元素,图标插画直接提取复用。
Q:模型的开源协议是什么?是否可以商用?
A:Ming-Image-0.1-Design的权重与Skills全部开源,支持商业和学术用途。用户可从Hugging Face或ModelScope下载模型权重进行本地部署和二次开发,也可通过OpenRouter在线API快速集成。开源策略降低了部署和定制成本,适合团队构建自有设计工具链。
9. 项目地址
- 在线体验API(OpenRouter): https://openrouter.ai/inclusionai/ming-image-0.1-design
- Hugging Face模型库: https://huggingface.co/inclusionAI/Ming-Image-0.1-Design
- Hugging Face分层模型: https://huggingface.co/inclusionAI/Ming-Image-0.1-Design-Layer
相关 AI 模型文章

Longcat-2.5-preview深度评测:美团新一代多模态长程Agent大模型
LongCat-2.5-Preview是美团最新推出的新一代大模型,在延续LongCat-2.0的1.6T总参数、约48B激活参数和1M token原生上下文基础上,首次将多模态能力直接融入基座本体,面向终端、浏览器、桌面软件等场景执行长流程Agent任务。该模型已接入官方API,同时兼容OpenAI和Anthropic双接口协议,支持最大128K tokens输出,并可被Codex、OpenCl...
Ok Work – 百度推出的 AI 随身办公工具
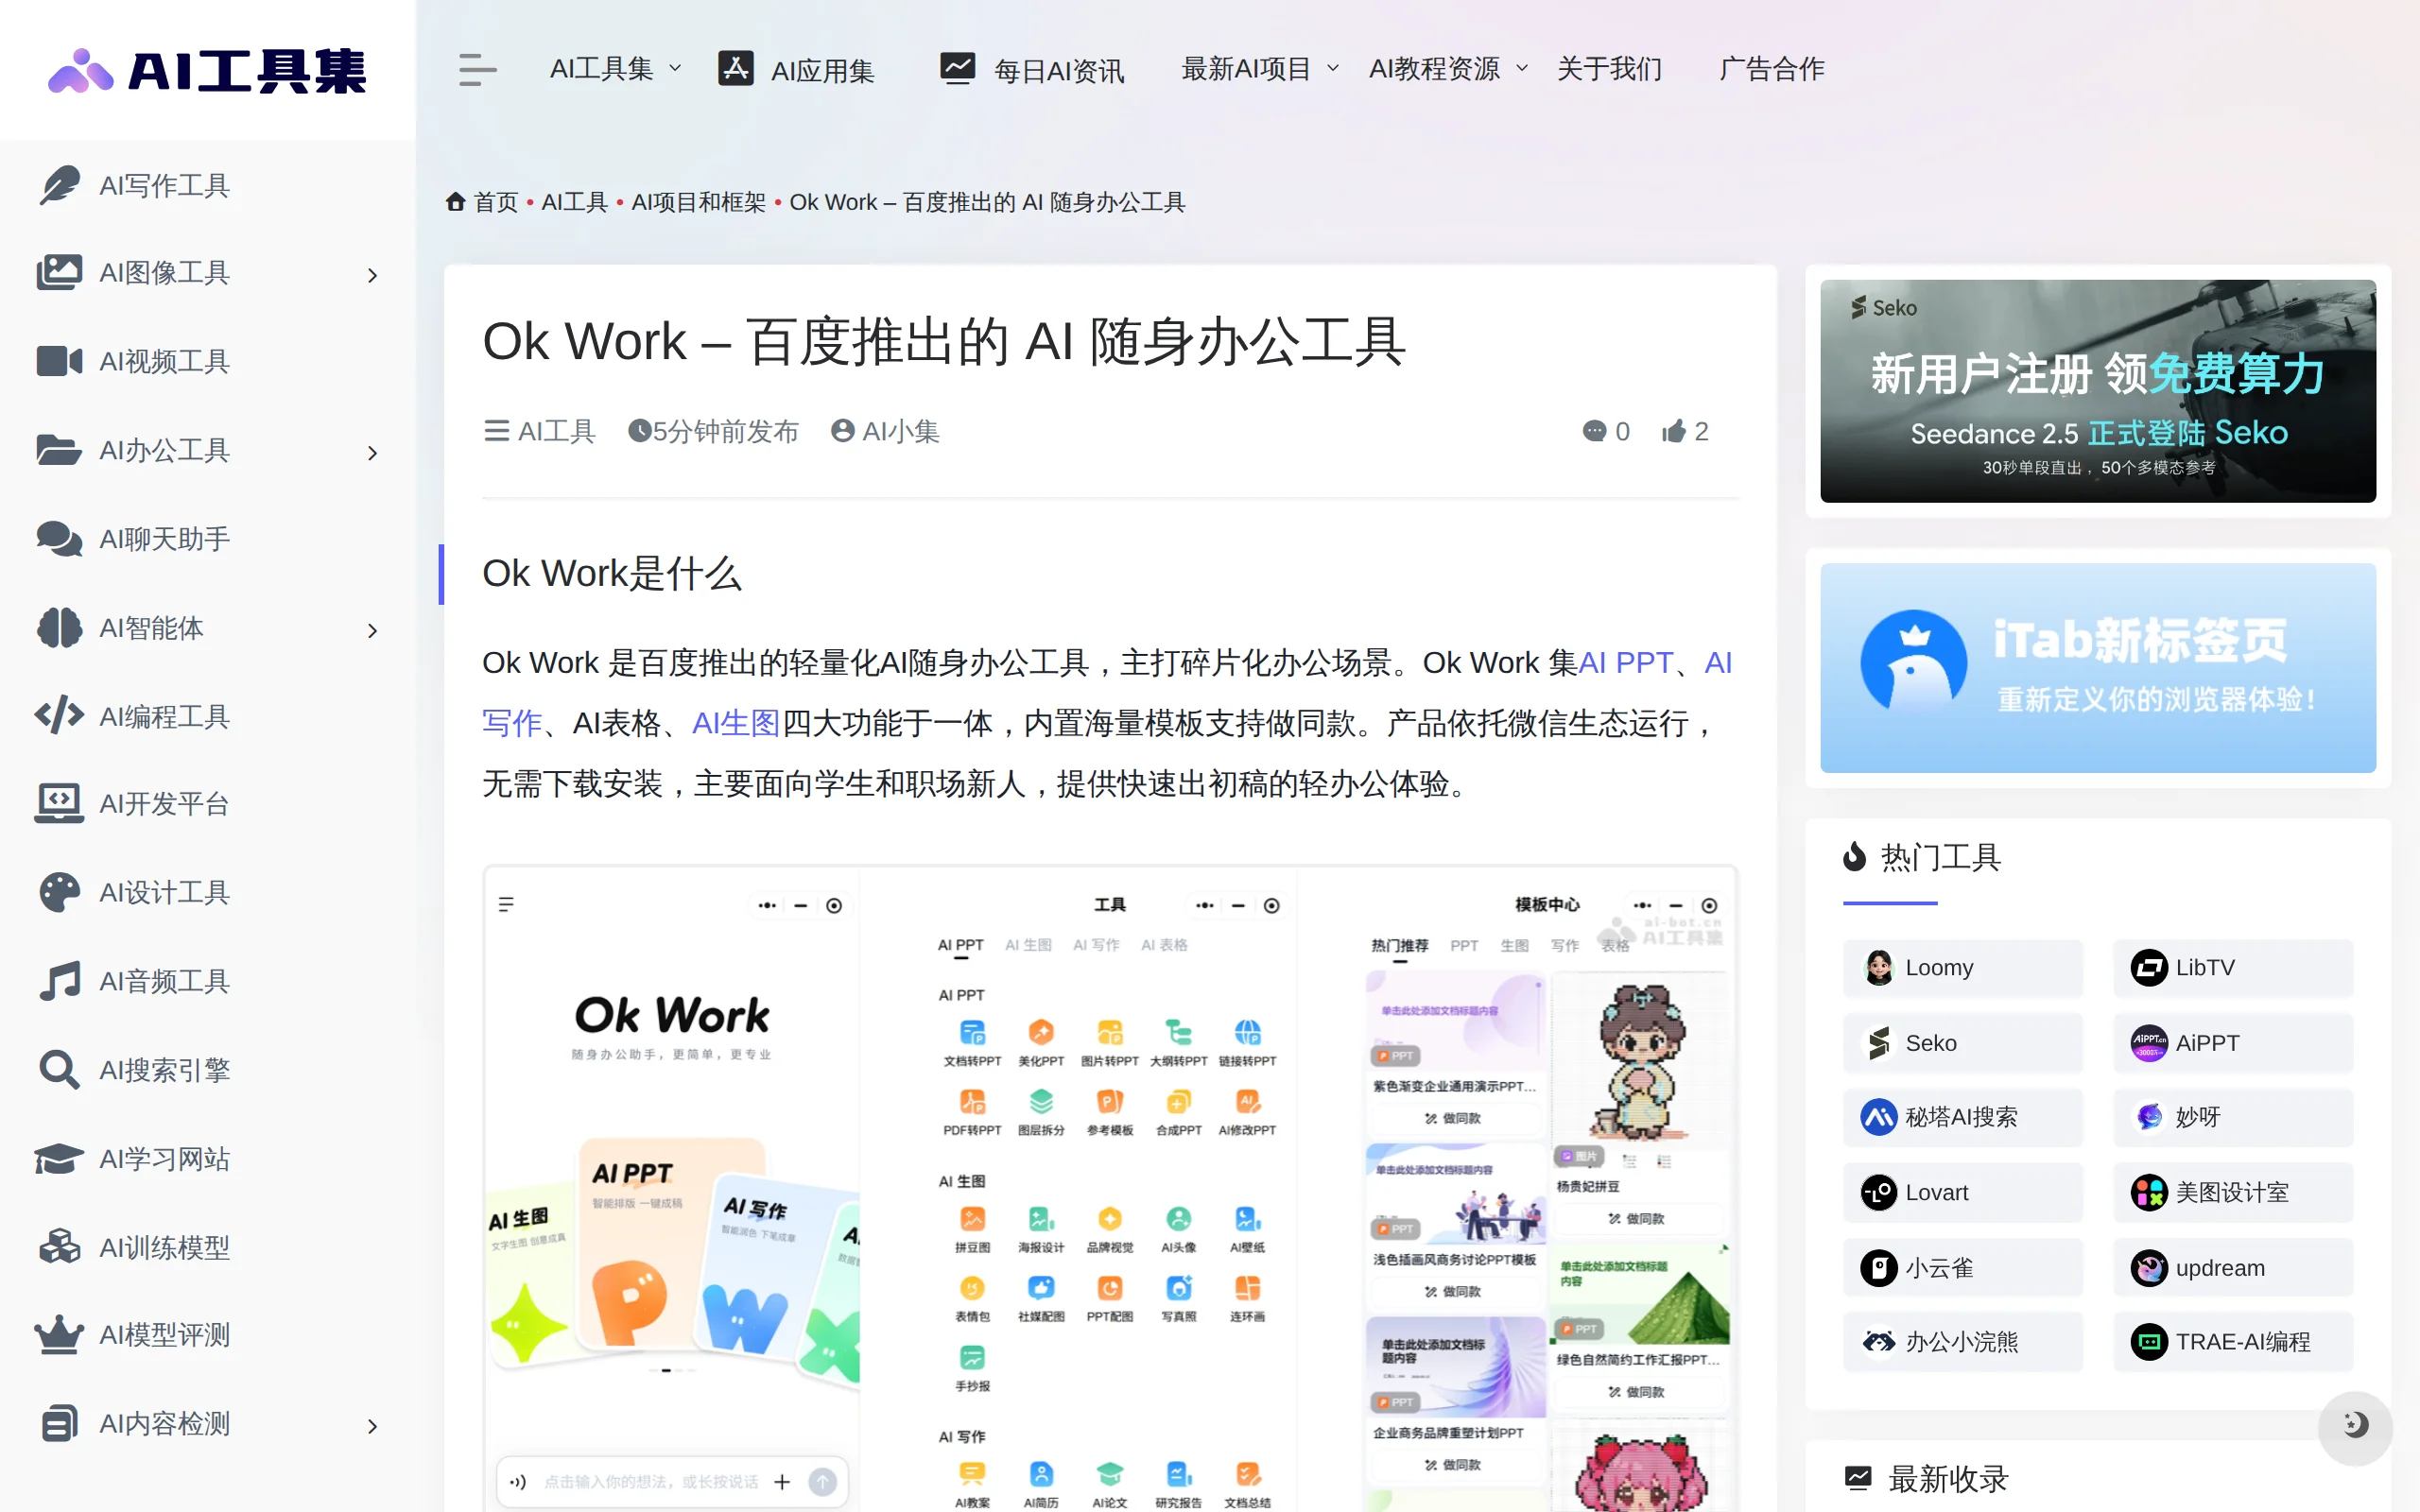
Ok Work是百度推出的轻量化AI随身办公工具,以微信小程序形态运行,面向学生与职场新人,聚焦碎片化办公场景。产品将AI PPT、AI写作、AI表格、AI生图四大核心能力整合于同一对话界面,内置海量模板并支持"做同款"快速套用,无需下载安装即可完成从内容生成、文档转换到视觉设计的完整轻办公流程。依托文心大模型的底层能力,Ok Work将复杂的AI能力拆解为颗粒度精细的具体小工具,以极低的上手门槛...
TeleOCR – 中国电信星辰实验室开源的文档解析模型深度评测
TeleOCR 是中国电信星辰实验室开源的文档解析模型,采用约 1.2B 参数的轻量级视觉语言架构,在单一框架内统一处理数字文档与相机拍摄文档,可将文字、版面、表格、公式和科学图表解析为 Markdown、JSON 等结构化结果。该模型在 OmniDocBench v1.6 榜单中登顶,同时获得 PureDocBench 榜首和 ICDAR-2026 科学图解析挑战赛冠军,支持本地 GPU 部署,...
Xiaomi MiMo-V2.6 – 小米开源的全模态模型系列
Xiaomi MiMo-V2.6是小米发布并开源的全模态模型系列,包含Pro和Flash两个原生全模态模型,以可验证复杂任务为核心的大规模Agentic强化学习为技术主线。该系列通过6天在线强化学习、约75万条交互轨迹的系统训练,显著提升了软件工程、代码生成、视觉理解与网络安全等多维度能力,并将能力边界扩展至3D游戏场景构建、Blender三维建模、机械臂具身控制、Computer Use自动化操...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。