
Mirage – strukto-ai 开源的 AI Agent 统一虚拟文件系统
导读摘要:
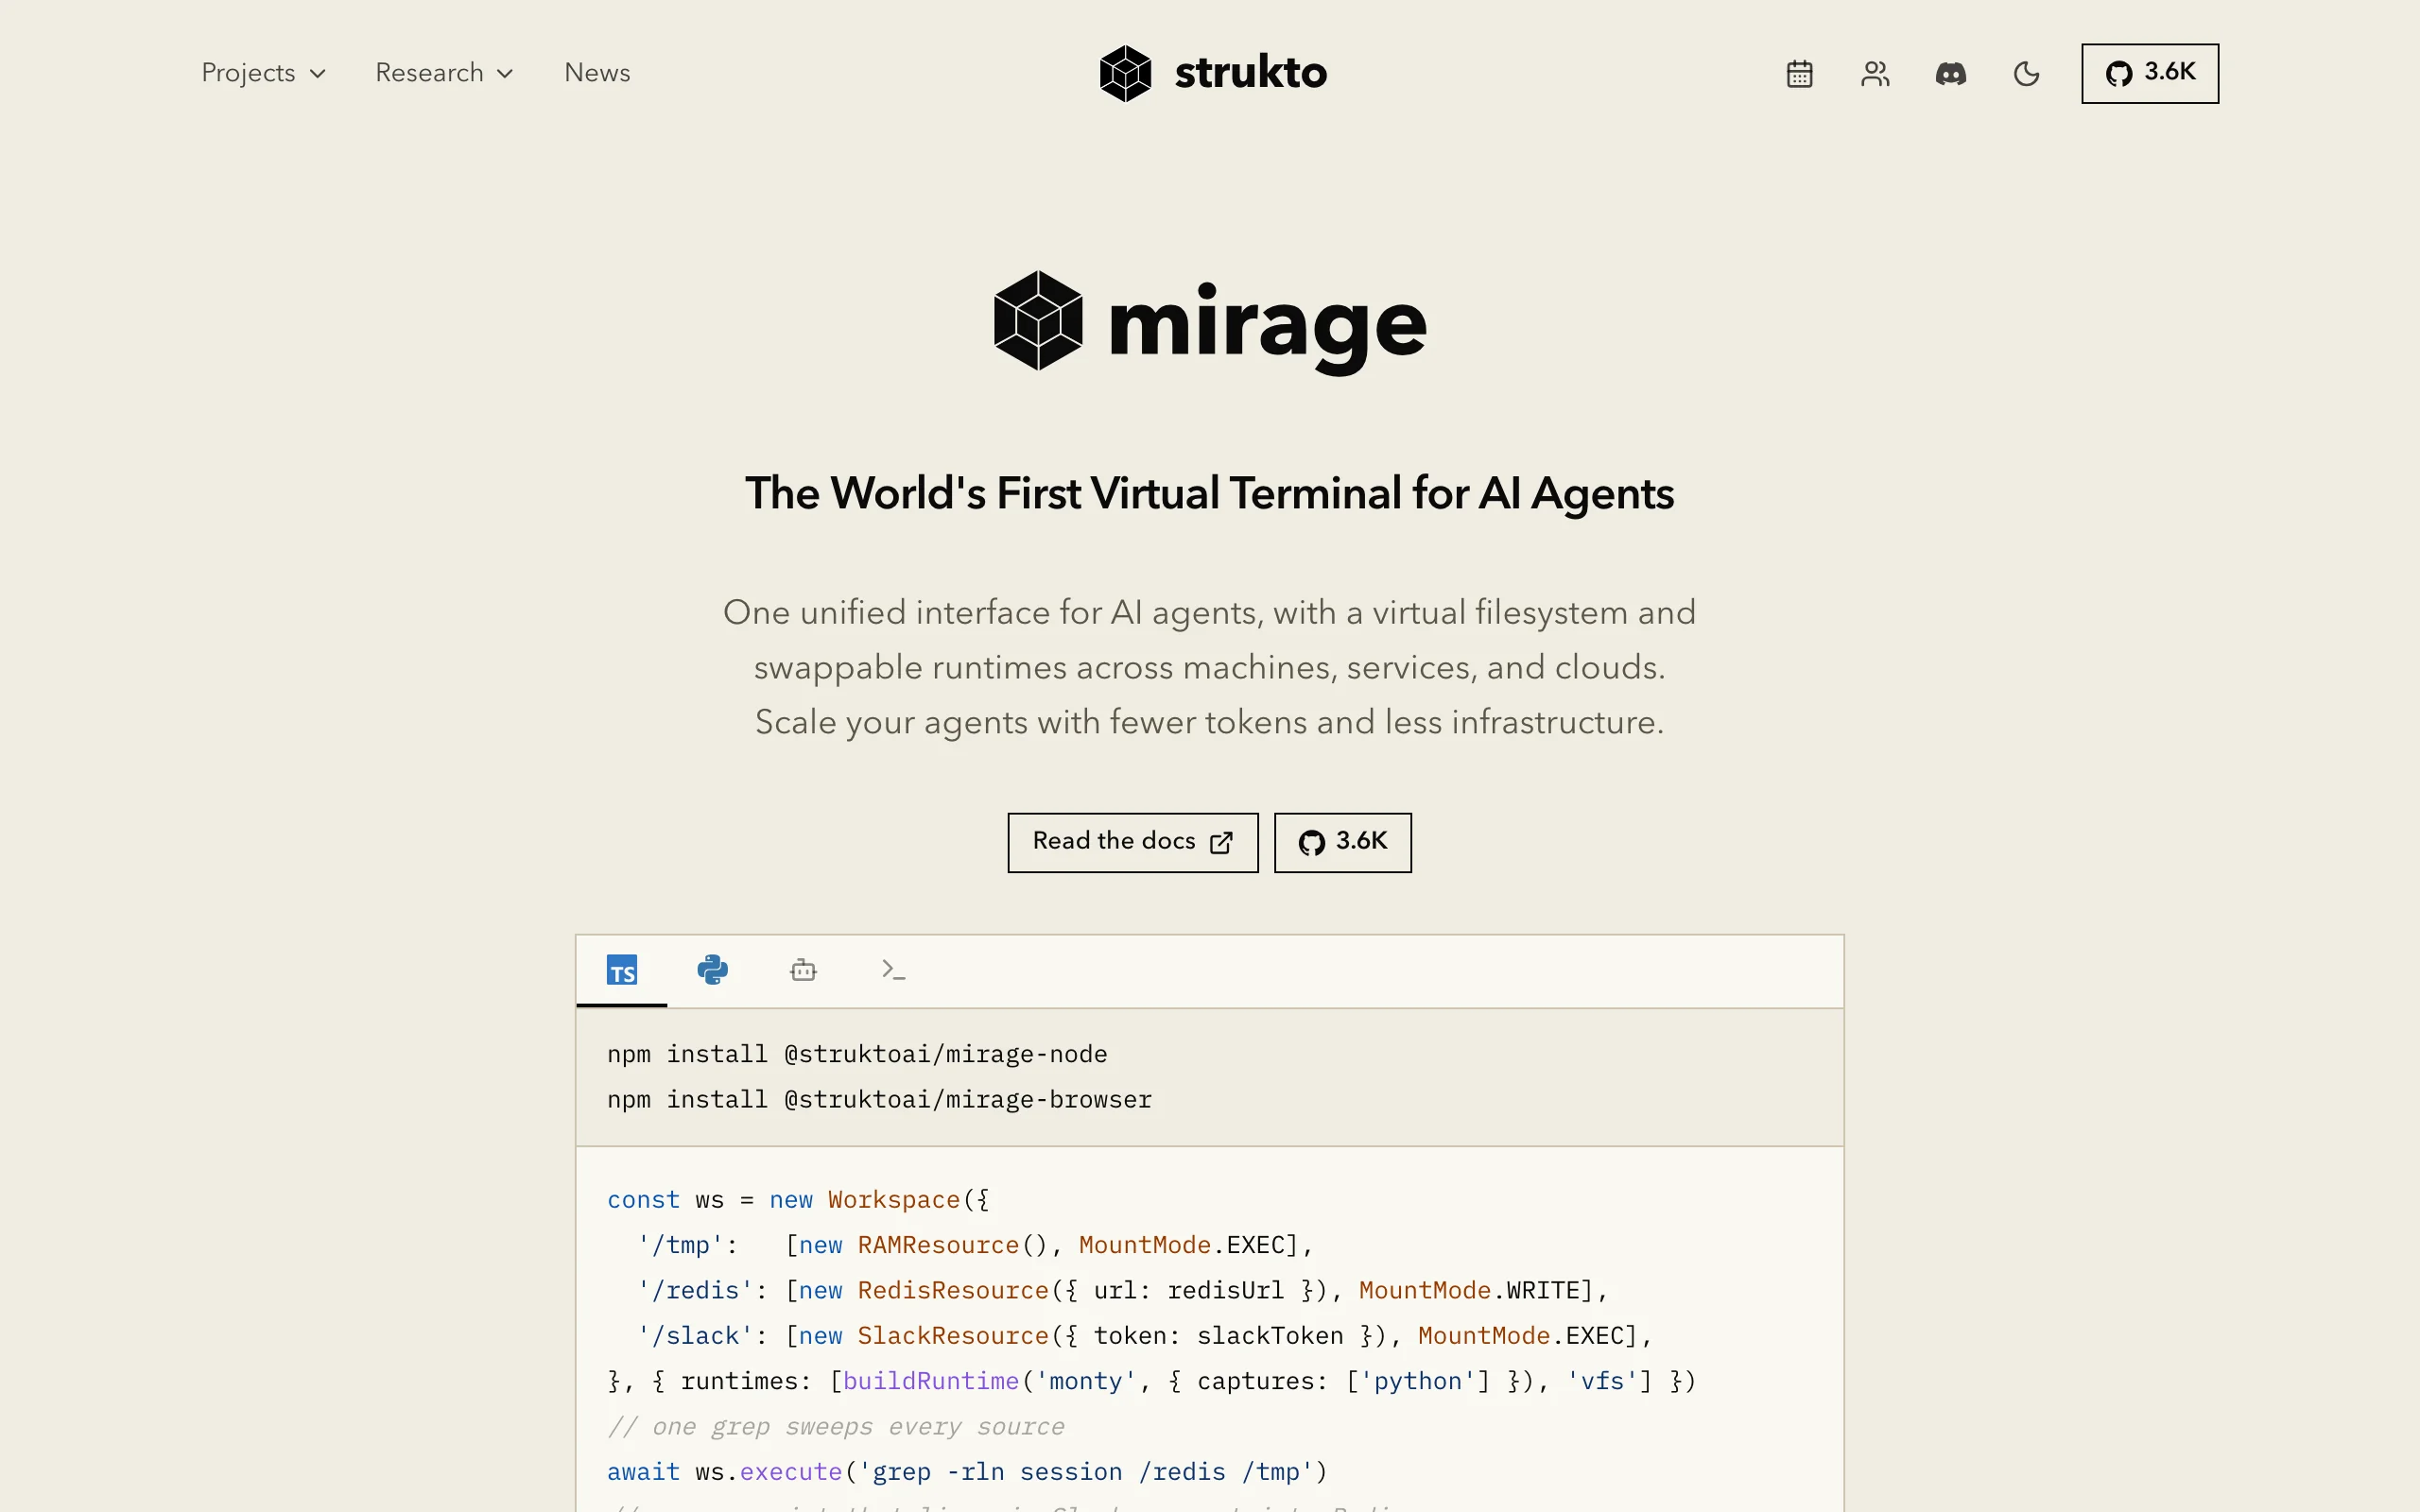
Mirage 是 strukto-ai 团队推出的一款面向 AI Agent 的统一虚拟文件系统,旨在通过将 S3、Slack、Gmail、GitHub、MongoDB 等异构数据源统一挂载为同一棵虚拟文件树,让 AI Agent 无需学习任何新 API,仅使用 Bash 命令(cat、grep、wc、管道等)即可跨服务读写、查询和复制数据。该工具的核心价值在于大幅降低 AI Agent 与外部系...
1. Mirage是什么
Mirage 是 strukto-ai 团队推出的一款面向 AI Agent 的统一虚拟文件系统,旨在通过将 S3、Slack、Gmail、GitHub、MongoDB 等异构数据源统一挂载为同一棵虚拟文件树,让 AI Agent 无需学习任何新 API,仅使用 Bash 命令(cat、grep、wc、管道等)即可跨服务读写、查询和复制数据。该工具的核心价值在于大幅降低 AI Agent 与外部系统集成的学习成本和技术复杂度,实现“一个文件系统,搞定所有后端”的愿景。
技术定位与领域: Mirage 属于 AI Agent 基础设施层工具,聚焦于解决 Agent 与外部数据源交互时的接口碎片化问题。其技术路径不同于传统的 API 封装或 MCP 协议,而是通过虚拟文件系统抽象层将异构后端统一映射为 POSIX 文件语义,属于系统软件与 AI 工程交叉领域。
研发背景: strukto-ai 团队在构建多 Agent 系统时发现,现有工具集成方案(如 Function Calling、MCP)要求 Agent 为每个后端学习新的 API 调用格式,导致开发效率低下且容易出错。团队基于“大语言模型对 Unix 文件操作语义的理解远超任何 SDK”这一洞察,开发了 Mirage 作为统一抽象层。
核心价值: Mirage 解决了 AI Agent 与外部系统集成时的“N 套 API”痛点,将学习成本从“掌握每个后端的 SDK”降低到“仅需 Bash 命令”。同时,其跨服务管道操作和环境快照功能,使得 Agent 能够在单回合内完成复杂的数据流转任务,并将执行环境完整迁移,显著提升开发效率和部署灵活性。
技术特点: Mirage 采用四层分层架构(应用层、Bash/VFS 层、Dispatcher/Cache 层、资源层),核心是 VFS 虚拟文件系统抽象层,它将 Slack 频道映射为目录、消息映射为 JSON 文件,MongoDB 集合映射为目录、文档映射为 JSON 文件。工具内置两层智能缓存(索引缓存和文件缓存),支持内存和 Redis 后端,并提供了 OpenAI Agents SDK、Vercel AI SDK、LangChain 等主流框架的适配器。
2. 主要功能
- 统一虚拟挂载: 将 S3/R2/GCS、Google 套件(Gmail/Drive/Docs)、Slack/Discord/Telegram、GitHub/Linear/Notion、MongoDB/Redis/PostgreSQL、SSH 远程服务器等全部映射为
/s3、/slack、/github等标准目录,Agent 无需关心底层是对象存储还是聊天频道。
| - 跨服务 Bash 操作: AI 可用 cat、grep、head、find、cp、mv、管道、重定向等 Unix 命令在任意挂载点上操作,跨服务管道如 `grep alert /s3/log.jsonl |
可移植工作空间: 支持快照、克隆与回滚,整个 Agent 执行环境可打包为 tar 文件迁移到另一台机器直接恢复,无需重新配置,解决多机部署与 Serverless 场景下的状态一致性问题。
两层智能缓存: 内置索引缓存(目录与元数据)和文件缓存(对象字节),重复读取零网络调用;支持内存(默认 512MB)或 Redis 后端,显著降低远程 API 调用频次,适配多进程与无服务器架构。
主流框架无缝接入: 提供 OpenAI Agents SDK、Vercel AI SDK、LangChain、Pydantic AI、CAMEL、OpenHands 等适配器,以沙盒或工具层形式嵌入现有技术栈,不强制更换 Agent 框架。
FUSE 适配器: 允许外部应用将 Mirage 虚拟文件树作为本地磁盘直接访问,支持通过操作系统原生文件操作接口读写远程数据,进一步降低集成门槛。
3. 如何使用
环境准备: 确保系统安装 Python ≥ 3.12 或 Node.js ≥ 20,操作系统为 macOS 或 Linux。建议使用 Python 3.12+ 版本以获得最佳性能,Node.js 20+ 版本提供完整的异步支持。
安装部署: Python 用户通过
uv add mirage-ai安装;TypeScript 用户通过@struktoai/mirage-node或@struktoai/mirage-browser安装;CLI 用户可通过一键脚本、npm、uvx 或 npx 安装。推荐使用uvx mirage快速启动 CLI 模式。创建与配置工作空间: 在代码中实例化 Workspace 对象,将虚拟路径(如
/s3、/slack)与对应资源驱动(如S3Resource、SlackResource)进行挂载映射。例如:ws = Workspace().mount("/s3", S3Resource(bucket="my-bucket"))。
| 执行 Bash 命令: 通过 ws.execute() 传入标准 Unix 指令(如 cat、grep、cp、管道),Mirage 自动将其翻译为底层各服务的实际 API 调用。例如:`result = ws.execute("cat /slack/general/2024-01-01.json |
快照与迁移: 调用
ws.snapshot("demo.tar")打包整个环境,通过mirage workspace load demo.tar在新机器直接恢复,无需重新配置。快照包含所有挂载配置和缓存数据。接入 Agent 框架: 通过
MirageSandboxClient嵌入 OpenAI Agents SDK,或通过mirageTools(ws)接入 Vercel AI SDK。LangChain、Pydantic AI、CAMEL、OpenHands 均提供官方适配器,只需几行代码即可完成集成。
注意事项: 首次使用需要为每个后端提供认证凭据(如 API Key、OAuth Token),建议通过环境变量或配置文件管理。缓存大小可根据实际场景调整,内存不足时可切换到 Redis 后端。
4. 优缺点分析
| 优点 |
|---|
| 零学习成本: AI 无需掌握任何新 API 或 MCP,直接复用训练数据最丰富的 Bash 与文件系统语义,大幅降低集成门槛。 |
| 跨服务管道原生支持: 不同后端之间的数据流转如同本地磁盘操作,Agent 单回合可完成更多实际工作,显著提升任务执行效率。 |
| 环境可移植: 快照与克隆能力让 Agent 运行环境版本化、可迁移,解决多机部署与 Serverless 场景下的状态一致性问题。 |
| 高性能缓存: 两层缓存机制显著降低远程 API 调用频次,Redis 后端更适配多进程与无服务器架构,提升系统吞吐量。 |
| 框架无关: 不强制更换 Agent 框架,以沙盒或工具层形式嵌入现有技术栈,降低迁移成本。 |
5. 同类工具对比
| 维度 | Mirage | MCP (Model Context Protocol) |
|---|---|---|
| 产品定位 | 面向 AI Agent 的统一虚拟文件系统 | AI 与外部系统通信的开放标准协议 |
| 核心思路 | 将所有后端映射为 POSIX 文件系统,AI 用 Bash 统一操作 | 通过 Server-Client 架构标准化工具发现与调用 |
| AI 交互方式 | 标准 Bash 命令、管道、重定向,零新词汇 | AI 通过协议描述发现能力,生成结构化 JSON 调用 |
| 学习成本 | 极低,复用 LLM 原生擅长的 Shell | 中,需理解 Schema、Capability 描述与协议规范 |
| 跨服务组合 | 原生管道 `\ | ` 与重定向,跨挂载点无缝流转 |
| 环境可移植性 | 快照、克隆、回滚,tar 包完整迁移 | 无原生环境打包,各 Server 配置分散管理 |
| 缓存机制 | 两层缓存(索引+文件),支持 Redis 共享 | 依赖各 MCP Server 自行实现 |
| 开源协议 | Apache 2.0 | Apache 2.0 |
选型建议: 对于追求极低学习成本和跨服务原生数据流转的场景,Mirage 是最优选择。其 Bash 加文件系统的抽象方式特别适合日志分析、数据迁移等需要频繁操作异构后端的任务。如果项目已经深度集成 MCP 生态,且对协议标准化有强需求,MCP 是更合适的选择。对于需要快速集成大量 SaaS 工具且对编排能力要求较高的企业级应用,Composio 的预构建连接器和托管环境更具优势。
6. 编辑点评
Mirage 的技术创新性在于其“文件系统即通用抽象”的设计哲学,这一思路巧妙地将大语言模型对 Unix 文件操作的内化能力转化为统一的接口抽象。相比 MCP 和 Composio 等方案,Mirage 不需要 Agent 学习任何新的调用范式,直接复用已有语言能力,这在理论上显著降低了集成成本和错误率。从实用价值来看,其跨服务管道操作和环境快照功能解决了 Agent 开发中的两个核心痛点:复杂数据流转和状态管理。特别是对于多源日志分析、自动化报告生成等场景,Mirage 能够将原本需要多步 API 调用的任务简化为单条 Bash 命令。
在适用人群方面,Mirage 特别适合以下开发者:已经熟悉 Unix 命令行的 AI 工程师、需要集成多个异构后端的 Agent 开发者、以及希望降低系统复杂度的技术团队。对于完全没有 Bash 经验的开发者,可能需要一定的学习曲线,但相比学习多个 SDK 仍然有优势。未来发展潜力方面,Mirage 的核心抽象理念具有很好的扩展性,随着社区贡献的驱动增多,其生态价值将逐步显现。不过,当前项目仍处于早期阶段,文档完善度和社区活跃度有待提升。
7. 应用场景
多源日志分析: Agent 同时挂载 S3 日志目录、Slack 告警频道与 GitHub Issue 仓库,通过
grep与wc跨服务统计故障频率并定位根因,将原本需要多次 API 调用的分析流程简化为单条 Bash 命令。自动化报告生成: 从 Google Sheets 提取数据、Gmail 获取附件、Notion 读取项目文档,统一汇总到本地虚拟目录后自动生成综合报告,Agent 无需关心数据来源的差异。
远程服务器运维: 通过 SSH 挂载多台远程主机,Agent 用标准 Bash 批量执行诊断命令、复制配置文件与变更系统状态,实现跨服务器的自动化运维操作。
数据迁移与同步: 在 S3、R2、GCS 等不同云存储之间,或从 MongoDB 到本地磁盘,通过
cp与管道指令完成异构后端的数据迁移,无需编写复杂的迁移脚本。Serverless Agent 服务: 结合 Redis 共享缓存为无服务器架构的多副本 AI 应用提供有状态、可恢复的虚拟文件层,确保实例重启后环境不丢失,提升服务可靠性。
8. 常见问题FAQ
Q:Mirage 与 MCP 有什么区别?
A:Mirage 将后端映射为 POSIX 文件系统,AI 用 Bash 命令操作;MCP 是标准协议,AI 通过 JSON 调用工具。Mirage 的学习成本更低,且支持原生跨服务管道操作。
Q:Mirage 支持哪些后端数据源?
A:目前支持 S3/R2/GCS、Google 套件(Gmail/Drive/Docs)、Slack/Discord/Telegram、GitHub/Linear/Notion、MongoDB/Redis/PostgreSQL、SSH 远程服务器等,社区正在扩展更多驱动。
Q:Mirage 的性能如何?
A:内置两层缓存机制,重复读取零网络调用;内存缓存默认 512MB,支持 Redis 后端共享缓存。实际性能取决于后端 API 响应速度,缓存命中场景下延迟极低。
Q:Mirage 是否支持自定义后端?
A:支持。开发者可以通过实现标准化的 VFS 接口(如 readdir、open、read、stat 等)创建自定义资源驱动,将任意服务映射为虚拟文件系统。
Q:Mirage 的环境快照包含什么?
A:快照包含所有挂载配置、缓存数据和工作空间状态,打包为 tar 文件后可在另一台机器完整恢复,无需重新配置认证凭据和挂载映射。
Q:Mirage 的缓存如何配置?
A:可通过环境变量或配置文件设置缓存大小和存储后端,默认使用 512MB 内存缓存,支持切换到 Redis 后端以实现多进程共享缓存。
Q:Mirage 是否支持 Windows?
A:目前官方支持 macOS 和 Linux,Windows 用户可以通过 WSL 2 运行。团队表示未来可能提供原生 Windows 支持。
9. 项目地址
- 项目官网: https://www.strukto.ai/mirage
- GitHub 仓库: https://github.com/strukto-ai/mirage
相关推荐
Kimi K3.1 Pro 深度评测:月之暗面旗舰模型的技术突破与生态布局
Kimi K3.1 Pro 是月之暗面推出的 K3.1 系列首个旗舰模型,定位为迄今最强的 3 万亿参数级开放权重模型,原生支持 100 万 token 上下文窗口。作为 K3 的后训练版本,该模型在代码开发、3D 创作、金融研究和长程 Agent 能力上实现显著跃升,Terminal-Bench 4.0 得分 65.7% 超越 GPT-6 Astra,金融基准 OfficeQA Pro v2 以...
书生-A1.5 – 上海 AI Lab 开源的通专融合科学智能体
书生-A1.5(Sage-A1.5)是上海人工智能实验室推出的 35B 规模通专融合科学智能体,基于 Agents-A1 长程任务能力与书生·端砚科学发现平台构建,面向真实科研场景验证 RSI(Researcher-Scientist-Investigator)闭环。该模型能够自主拆解复杂科研任务、编排多个子智能体并行调研,并触发校验机制识别证据缺口、修正研究假设。书生-A1.5 已覆盖脑科学、电...
WorkForge – 腾讯联合复旦推出的智能体训练环境构建框架深度评测
WorkForge是腾讯混元与复旦大学联合推出的智能体训练环境构建框架,旨在解决当前智能体训练中高质量长程任务数据稀缺的核心瓶颈。该框架从专家工作流蓝图出发,通过获取智能体自动检索真实世界资源搭建工作区,基于工作区中的事实锚点生成任务指令与双重验证标准,让智能体在执行过程中产出可追溯的轨迹数据。目前WorkForge已建成16.7K个可验证环境,横跨40个专业领域,可将35B模型的GDPval得分...
星火X2.6:科大讯飞端云一体基座大模型的国产化突围与产业落地
星火X2.6(Spark-X2.6)是科大讯飞推出的端云一体基座大模型,基于全国产算力完成从训练到推理的完整闭环,是国产AI在安全性与性价比层面的关键布局。云端293-A30B版本支持百万token级超长上下文,输入价格仅为0.9元/百万tokens,显著低于DeepSeek-V4.1-Flash;端侧星火X2.6-4B已全面开源,在办公文档处理、工具协同等智能体任务上表现突出。系统依据任务难度与...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。