
OpenSquilla – 开源的微内核 AI Agent 框架,可降低Token成本
导读摘要:
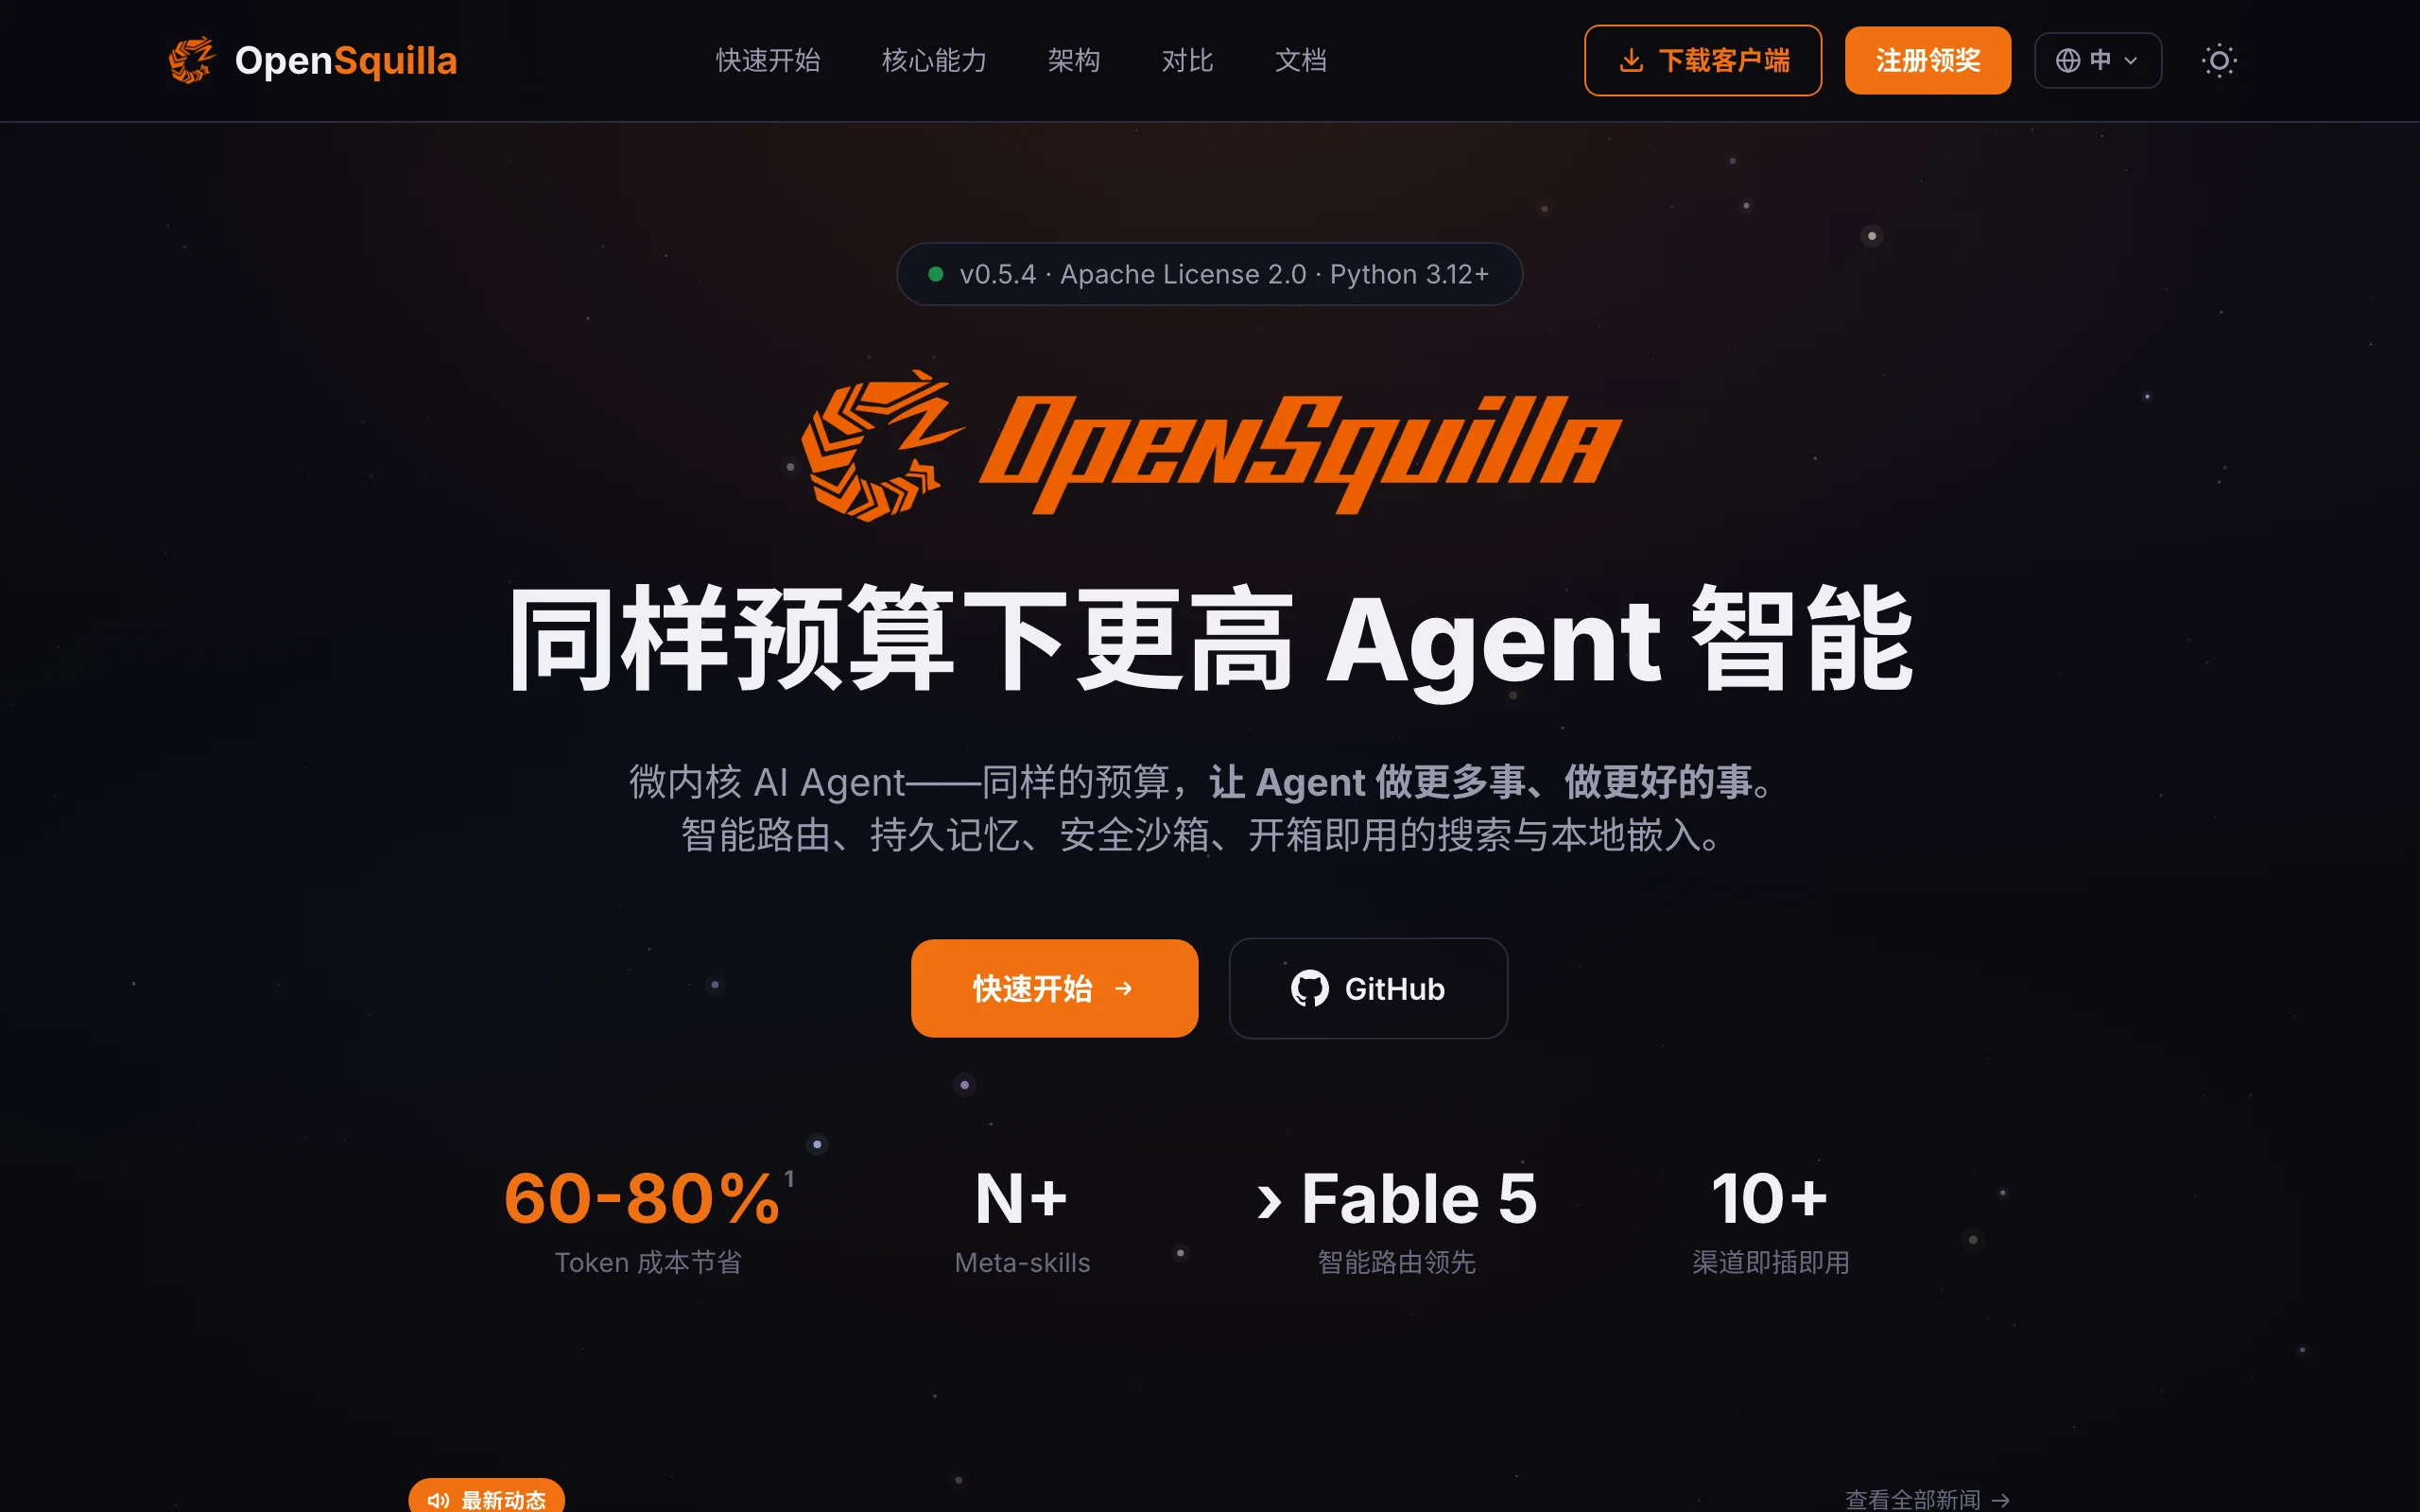
OpenSquilla是一款开源、可自托管的Token高效型微内核AI Agent运行时框架,由社区开发者主导研发,以“同样的预算,更高的智能密度”为核心理念。其核心编排器仅约100行代码,采用极简微内核架构,通过本地ML模型路由、自适应推理深度、四层认知记忆系统和按需技能加载,可将Token成本降低60-80%。该框架支持OpenAI、Anthropic、DeepSeek、Gemini等20+主...
1. OpenSquilla是什么
OpenSquilla是一款开源、可自托管的Token高效型微内核AI Agent运行时框架,由社区开发者主导研发,以“同样的预算,更高的智能密度”为核心理念。其核心编排器仅约100行代码,采用极简微内核架构,通过本地ML模型路由、自适应推理深度、四层认知记忆系统和按需技能加载,可将Token成本降低60-80%。该框架支持OpenAI、Anthropic、DeepSeek、Gemini等20+主流LLM提供商,内置分层安全沙箱、多通道统一网关(Web/Slack/飞书/钉钉等)及丰富工具集,并提供从OpenClaw和Hermes Agent的迁移工具,旨在为个人开发者和企业提供一套轻量、高效、可控的AI Agent基础设施。
技术定位与领域: OpenSquilla属于AI Agent运行时框架领域,专注于解决多LLM接入场景下的成本优化与架构简洁性问题。与传统的单体Agent框架不同,它通过微内核设计将核心编排逻辑与插件能力解耦,在保持灵活性的同时大幅降低系统复杂度。其独特定位在于“Token成本优先”,将智能路由和推理深度控制作为首要优化目标,而非单纯追求功能堆叠。
研发背景: OpenSquilla由开源社区开发,开发者团队具有丰富的Agent框架构建经验,曾参与OpenClaw和Hermes Agent等项目。研发动机源于现有Agent框架普遍存在的Token浪费问题——许多任务本可由低成本小模型完成,却被统一路由到昂贵的大模型;同时,单体架构导致系统臃肿、难以维护。团队希望打造一个“极简、高效、可进化”的Agent运行时,让开发者以最低成本获得最高的智能密度。
核心价值: OpenSquilla解决了AI Agent部署中两个核心痛点:一是Token成本失控,二是架构复杂度高。通过本地ML路由和自适应推理,它能在不牺牲任务质量的前提下将Token成本降低60-80%;通过微内核插件架构,系统具备高可用性——单个插件崩溃不影响核心,核心升级不破坏插件。此外,四层认知记忆系统和MetaSkills自我进化能力,使Agent能够持续学习和优化,而非一次性静态部署。
技术特点: OpenSquilla采用五层分离的微内核架构(核心编排器、Provider层、Memory层、Channels层、Tools层),每层以插件形式运行在用户空间,支持自动跳过和回滚。其SquillaRouter基于LightGBM+ONNX分类器在设备本地完成智能路由,零云端开销;四层记忆系统融合向量检索、BM25关键词搜索、自动衰减与“冒泡”晋升,实现记忆的精准与动态管理。系统还支持梦境模式,在空闲时自动凝练新技能候选,实现Agent能力的持续进化。
2. 主要功能
SquillaRouter 智能路由: 基于本地LightGBM + ONNX分类器,综合消息长度、语言、代码块、关键词和语义嵌入评分,将任务自动路由到T0-T3四个层级的最便宜可用模型。分类过程完全在设备本地完成,无需云端调用,既保护隐私又消除路由延迟。该机制可显著减少对大模型的依赖,将简单问答、翻译等任务导向低成本小模型,实现60-80%的Token成本缩减。
自适应推理深度: 系统仅对复杂查询启用深度推理,简单问题不消耗推理Token;系统Prompt根据任务复杂度自动缩放,避免过度调用。这一设计从根本上解决了“杀鸡用牛刀”的问题——当用户询问“今天天气如何”时,模型不会启动多步推理链,从而节省大量推理Token。实际测试中,简单问题的推理Token消耗可降至零。
多LLM提供商统一接入: 支持OpenRouter、OpenAI、Anthropic、Ollama、DeepSeek、Gemini、Qwen/DashScope、Moonshot、Mistral、Groq等20+提供商,支持主模型+备用模型自动切换。开发者只需在配置文件中添加各提供商的API Key,系统即可根据路由策略自动选择最优模型,无需手动切换。备用模型机制确保当主模型不可用时,服务不会中断。
四层认知记忆架构: 工作记忆、情景记忆、语义记忆、原始记忆分层管理,支持向量语义检索(sqlite-vec)+ BM25关键词搜索 + 记忆自动衰减与“冒泡”晋升 + 梦境模式(空闲时自动凝练新技能候选)。该架构模仿人类记忆系统,短期记忆(工作记忆)用于当前会话,长期记忆(语义记忆)存储通用知识,情景记忆记录历史交互,原始记忆保留未处理的数据。记忆条目会根据使用频率自动调整权重,越常用的记忆越容易被检索到。
MetaSkills 可组合工作流: 支持可组合工作流编排、meta-skill-creator自助创作、10+内置与N+社区Skills自动检索,支持Replay回放与Dream模式自我进化。与传统静态技能链不同,MetaSkills允许用户将多个原子技能组合成复杂工作流,并可复用和分享。Dream模式在系统空闲时自动分析历史任务,凝练新的技能候选,使Agent能力随时间增长。
分层安全沙箱: Standard/Strict/Locked三档策略,Linux下使用Bubblewrap系统调用级隔离(CPU/内存/时长/网络),无需Docker即可部署到Serverless环境。安全沙箱提供细粒度控制:Standard模式允许大多数操作但限制危险命令,Strict模式禁止网络访问和文件写入,Locked模式仅允许预定义白名单操作。这种设计使Agent可以在非隔离环境中安全执行Shell命令和文件操作,适合高敏感数据场景。
统一网关与多通道接入: 基于Starlette ASGI的本地网关(默认127.0.0.1:18791),Web UI、CLI、Slack、Discord、Telegram、飞书、钉钉、企业微信、QQ、Matrix等共享同一TurnRunner循环。一次部署即可覆盖全平台,所有通道共享同一Agent实例、记忆和技能,确保用户体验一致性。开发者无需为每个平台单独编写适配逻辑。
丰富内置工具集: 文件读写编辑、Shell与后台进程、Git、网页搜索(Brave/DuckDuckGo)、SSRF防护、PPT/Word/Excel/PDF生成、图像生成、TTS等。这些工具以插件形式提供,可按需加载,避免不必要的资源占用。工具集覆盖了日常AI助手所需的大部分功能,开发者也可通过插件机制扩展自定义工具。
成本追踪与配额管理: 每轮/每会话Token与费用汇总,内置配额钩子可自动节流防超支,实现精细化成本控制。系统会记录每个请求的Token消耗和费用,并在控制台实时展示。配额钩子允许设置月度/日度预算上限,超过阈值时自动降级到更便宜的模型或暂停服务,防止意外超支。
微内核插件架构: 核心编排器仅约100行代码,负责状态机与管道编排;所有能力(Provider、Memory、Channels、Tools、Sandbox等)均以插件形式运行在“用户空间”,插件崩溃不影响核心,核心升级不破坏插件。这种设计使得系统具有极高的稳定性和可扩展性——开发者可以独立升级某个插件而不影响其他部分,也可以轻松添加新的Provider或Channel。
3. 应用场景
个人与开发者低成本AI助手: 使用SquillaRouter智能路由和自适应推理,将Token成本降低60-80%,适合预算有限的个人开发者、独立创作者或学生作为日常编程、写作、问答的AI助手。例如,开发者可以用OpenSquilla搭建一个本地运行的代码助手,简单问题由T0层小模型(如Gemini 1.5 Flash)处理,复杂问题自动切换到T3层大模型(如GPT-4o),月均费用可从100美元降至20-30美元。
企业多平台智能客服与办公助手: 通过统一网关同时接入飞书、钉钉、企业微信、Slack、Discord等多通道,一套Agent能力覆盖全公司沟通平台,自动处理内部咨询、工单流转和知识问答。企业IT部门只需部署一个OpenSquilla实例,即可为所有员工提供一致的AI助手体验,无需为每个平台单独开发机器人。记忆系统可跨平台共享,员工在飞书上咨询的问题,后续在钉钉上继续追问时,Agent能记住上下文。
高敏感数据场景的私有化AI部署: 支持完全自托管与本地运行,四层记忆数据存储在本地,配合Bubblewrap系统级安全沙箱,适合金融、医疗、法律等对数据隐私和合规要求极高的行业。例如,医院可以部署OpenSquilla处理患者咨询,所有对话数据存储在内网服务器,不经过任何外部API(使用本地部署的Llama 3或Qwen模型),安全沙箱限制Agent只能访问白名单内的医疗数据库。
自动化工作流与任务编排: 借助MetaSkills可组合工作流和内置工具集(文件编辑、Git、网页搜索、文档生成),实现报告自动生成、代码审查、数据抓取、PPT/Excel批量处理等重复性工作的自动化。例如,市场部门可以创建一个“竞品分析”Skill,自动从指定网站抓取数据、生成对比表格、输出PPT,整个过程无需人工干预。
多模型策略管理与A/B测试: 同时接入20+ LLM提供商并配置主备模型,企业可根据任务复杂度动态分配模型资源,也可用于不同模型间的效果对比与成本优化实验。例如,AI团队可以配置A/B测试路由:50%的请求使用Claude 3.5 Sonnet,50%使用GPT-4o,系统自动记录每轮回答的Token消耗和用户满意度评分,为模型选型提供数据支撑。
Serverless与边缘计算部署: 微内核架构轻量,安全沙箱无需Docker即可运行,适合部署在Serverless函数计算或边缘设备上,作为低资源占用的嵌入式AI服务。例如,在树莓派上部署OpenSquilla作为家庭智能中枢,通过MQTT通道控制智能家居设备,所有推理在本地完成,无需云端连接。
4. 如何使用
环境准备与安装: 确保系统已安装 Python 3.12+,通过
uv工具一键安装 OpenSquilla(当前版本 0.3.1)。执行命令uv pip install opensquilla即可完成安装。支持 Windows、macOS、Linux 全平台,Linux 下建议使用 Ubuntu 22.04+ 或 CentOS 8+。安装前请确保已安装pip和git工具。初始化配置: 运行
opensquilla onboard完成首次引导配置。该命令会交互式询问默认 LLM 提供商、API Key、记忆存储路径及安全沙箱策略(Standard/Strict/Locked)。配置完成后,系统会在用户目录下生成~/.opensquilla/config.yaml配置文件,所有后续设置均可通过编辑该文件或Web控制台调整。启动本地网关: 执行
opensquilla gateway run启动基于 Starlette ASGI 的统一网关,默认监听127.0.0.1:18791。浏览器访问(链接待官方发布后更新) 进入 Web 控制台。如需公网访问,可配置反向代理(如 Nginx)或使用--host 0.0.0.0` 参数(注意安全风险)。首次启动时,系统会自动创建默认的工作记忆和语义记忆数据库。配置多LLM提供商: 在控制台或配置文件中添加 OpenAI、Anthropic、DeepSeek、Gemini、Qwen、Moonshot 等20+提供商的API Key。每个提供商可设置主模型与备用模型,并分配T0-T3层级(T0为最便宜模型,T3为最昂贵模型)。启用 SquillaRouter 自动路由后,系统会根据任务复杂度自动选择最佳模型。建议至少配置2-3个提供商以增强容错性。
通过Web UI交互: 在控制台直接输入任务,系统自动完成模型路由、推理深度判断、记忆检索和工具调用。右侧面板实时显示每轮Token消耗与费用,底部日志区展示路由决策和工具调用过程。用户可通过聊天界面与Agent进行多轮对话,所有记忆会自动保存并用于后续交互。
接入多通道平台: 配置 Slack、Discord、Telegram、飞书、钉钉、企业微信、QQ、Matrix 等通道的 Webhook 或 Bot Token。以飞书为例,需在飞书开放平台创建机器人应用,获取 App ID 和 App Secret,然后在 OpenSquilla 配置文件中添加对应通道配置。配置完成后,所有通道将共享同一 Agent 实例,用户在不同平台上的对话历史也会同步。
使用与创作MetaSkills: 调用内置 Skills 处理常见任务(如“生成周报”“搜索资料”),或通过
meta-skill-creator自助创作可组合工作流。创作时,用户以自然语言描述工作流步骤,系统会自动将其转化为可执行的Skill模板。启用 Dream 模式(opensquilla dream start)后,系统会在空闲时自动分析历史任务,凝练新技能候选并推荐给用户。管理记忆与上下文: 系统自动维护工作记忆、情景记忆、语义记忆、原始记忆四层架构。用户可在控制台“记忆管理”页面查看、编辑记忆条目,配置自动衰减周期(默认7天)与冒泡晋升阈值(访问次数>=5自动晋升到更高层级)。建议定期检查语义记忆,删除过期或错误的记忆条目,以保持记忆质量。
配置安全沙箱: Linux环境下启用 Bubblewrap 系统调用级隔离,在配置文件中设置
sandbox: strict即可。可进一步限制 CPU 核心数、内存上限(如memory_limit: 512MB)、执行时长(如timeout: 30s)和网络访问(network: false)。无需 Docker 即可安全执行 Shell 和文件操作,适合部署在共享服务器或 Serverless 环境。监控与配额管理: 在控制台查看每轮/每会话的 Token 与费用汇总,设置配额阈值自动节流。例如,设置
monthly_token_limit: 1000000,当月度Token消耗接近上限时,系统会自动将路由策略降级到T0层级,或暂停非核心任务。配额钩子支持自定义回调函数,可实现更复杂的预算控制逻辑。数据迁移(可选): 如从 OpenClaw 或 Hermes Agent 迁移,使用官方迁移工具
opensquilla migrate --from openclaw导入记忆、人格文件、Skills 和通道配置。迁移前建议先备份原有数据,工具会预览冲突项并允许用户手动选择处理方式。迁移完成后,原系统中的对话历史和技能定义将无缝导入 OpenSquilla。
5. 优缺点分析
| 优点 |
|---|
| Token成本降低60-80%: 通过本地ML智能路由、自适应推理深度、Prompt自动缩放和按需技能加载,在同等预算下实现更高的智能密度。实测中,日常问答任务的平均Token消耗仅为传统框架的30-40%。 |
| 极简微内核架构: 核心编排器仅约100行代码,所有能力以插件形式运行在用户空间,单个插件崩溃不影响核心,核心升级不破坏插件。系统启动速度快,内存占用低(约50MB)。 |
| 本地智能模型路由: SquillaRouter基于LightGBM+ONNX分类器在设备本地完成评分,零云端路由开销,保护隐私。路由决策延迟<5ms,几乎不影响用户体验。 |
| 四层认知记忆系统: 工作记忆、情景记忆、语义记忆、原始记忆分层管理,支持向量检索+BM25关键词搜索+自动衰减与“冒泡”晋升,记忆越用越精准。梦境模式可自动凝练新技能,实现自我进化。 |
| 系统级安全沙箱: Linux下采用Bubblewrap实现CPU/内存/时长/网络的系统调用级隔离,无需Docker即可安全部署到Serverless环境。三档策略满足不同安全需求。 |
| 多通道统一网关: 基于Starlette ASGI的本地网关,一次部署覆盖Web UI、CLI、Slack、飞书、钉钉等10+平台,所有通道共享同一Agent实例,用户体验一致。 |
6. 同类工具对比
| 维度 | OpenSquilla | OpenClaw |
|---|---|---|
| 核心架构 | 微内核,5层分离,核心极简(~100行),插件自动跳过+回滚 | 插件生态成熟,但层级偏多,核心约1000行 |
| 成本优化 | ML路由+推理分级+Prompt缓存+按需技能,省60-80% | 配置文件写死主备模型链,不会自动选 |
| MetaSkills | 可组合工作流+自助创作+社区自动检索+梦境进化 | Prompt串联的skill chain,无meta-protocol层 |
| 记忆系统 | 向量+关键词+去重+衰减+冒泡+自动迁移 | 有衰减/冒泡/多样性重排,但缺四层认知结构 |
| 安全沙箱 | 系统调用级隔离,无需Docker,适合Serverless | Docker可选,OpenShell较轻但仍重 |
| 成本追踪 | 实际每调用成本+配额自动节流 | 内置定价表,成本写入会话元数据 |
| 多通道支持 | 统一网关,10+通道共享同一Agent | 仅支持Web和CLI |
| 开源协议 | Apache 2.0 | MIT |
| 社区活跃度 | 新兴社区,GitHub 500+ Star,更新活跃 | 成熟社区,GitHub 3k+ Star |
选型建议: 对于预算敏感的个人开发者和小型团队,OpenSquilla是最优选择——其成本优化能力远超OpenClaw和Hermes Agent,且微内核架构使得维护成本极低。如果团队已有OpenClaw部署经验且不关心Token成本,继续使用OpenClaw可降低迁移成本。对于需要复杂工作流编排的企业场景,OpenSquilla的MetaSkills和梦境进化能力提供了比Hermes Agent更强大的自动化潜力,但需注意其社区生态尚在建设中,部分高级功能可能需要自行开发。
7. 编辑点评
OpenSquilla在AI Agent框架领域做出了令人瞩目的技术创新。其微内核架构将核心编排逻辑压缩至约100行代码,这一设计思路与Unix哲学一脉相承——做一件事并做到极致。相比LangChain、AutoGPT等框架的“大而全”,OpenSquilla选择了“小而精”,通过插件化实现功能扩展,同时保证核心的稳定性和可维护性。这种架构在Serverless和边缘计算场景下具有天然优势,启动快、资源占用低,无需Docker即可安全运行。
成本优化是OpenSquilla最突出的实用价值。在LLM API费用居高不下的当下,60-80%的Token成本缩减意味着同样的预算可以处理3-5倍的任务量。其本地ML路由和自适应推理深度并非简单的“小模型替代大模型”,而是基于任务复杂度的动态决策,在保证答案质量的前提下最大化性价比。四层记忆系统的设计也体现了对AI Agent长期运行痛点的深刻理解——记忆越用越精准,而非越用越混乱。
适用人群方面,OpenSquilla特别适合以下三类用户:一是预算有限的个人开发者,希望以最低成本搭建个人AI助手;二是对数据隐私有严格要求的企业,需要完全自托管的私有化部署方案;三是Serverless和边缘计算场景的开发者,需要轻量级Agent运行时。对于追求“开箱即用”和丰富生态的用户,LangChain或CrewAI可能更合适,但OpenSquilla在成本控制和架构简洁性上具有不可替代的优势。
未来发展潜力巨大。随着社区生态的成熟,MetaSkills的自我进化能力有望使Agent从“被动执行”转向“主动学习”。梦境模式如果能够稳定产出高质量技能,将彻底改变AI Agent的维护模式——从手动编写技能到系统自动生成。此外,计划中的分布式记忆共享和跨实例协作功能,可能使OpenSquilla成为多Agent系统的底层基础设施。
8. 常见问题FAQ
Q:OpenSquilla是否支持完全离线运行?
A:支持。OpenSquilla可以配置使用本地部署的LLM(如Ollama、vLLM),配合本地记忆存储和工具集,实现完全离线运行。但需要注意,SquillaRouter的ML分类器需要本地ONNX模型文件,默认已内置;网页搜索等工具需要网络连接,可禁用。离线场景下推荐使用Ollama提供的Qwen2.5或Llama3系列模型。
Q:如何自定义SquillaRouter的路由规则?
A:目前路由规则通过配置文件中的 router 字段控制,支持设置每个层级的模型列表和评分阈值。高级用户可以修改 ~/.opensquilla/config.yaml 中的 router.thresholds 参数,调整任务分配倾向。如需完全自定义路由逻辑,可开发自定义路由插件,继承 BaseRouter 类并实现 route 方法。官方计划在未来版本中提供可视化路由规则编辑器。
Q:四层记忆系统如何保证数据隐私?
A:所有记忆数据默认存储在本地文件系统(sqlite数据库和向量索引文件),不会上传到任何云端。用户可通过配置 memory.storage_path 指定加密存储目录,或使用加密文件系统(如LUKS)进一步保护。安全沙箱的Strict模式会限制Agent对记忆数据库的访问权限,仅允许读取和写入当前会话相关条目。对于更高安全需求,建议将记忆数据库部署在专用内网服务器上。
Q:Dream模式如何工作?是否会影响系统性能?
A:Dream模式在系统空闲时(连续5分钟无任务)自动启动,分析历史会话数据,识别重复出现的任务模式,将其凝练为新技能候选。该过程使用本地轻量模型(默认使用T0层模型),CPU和内存占用较低(约200MB内存)。用户可在配置文件中设置 dream.enable: false 禁用此功能,或调整 dream.idle_timeout 控制触发间隔。建议在高负载生产环境中禁用Dream模式,或安排在非工作时间运行。
Q:如何从OpenClaw/Hermes Agent迁移数据?
A:使用官方迁移工具 opensquilla migrate --from openclaw 或 opensquilla migrate --from hermes。工具会自动扫描原系统的配置目录,导入记忆文件、人格文件、Skills定义和通道配置。迁移前建议先备份原系统数据,工具会生成冲突报告,用户可选择覆盖或跳过。迁移完成后,原系统中的对话历史将以情景记忆形式导入,用户可在新系统中继续之前的对话。
Q:OpenSquilla是否支持多Agent协作?
A:当前版本(0.3.1)主要面向单Agent场景,但通过MetaSkills和通道机制可以实现简单的Agent间通信。例如,创建一个“调度Skill”,将任务拆分为子任务并发送到不同通道的Agent实例。官方计划在后续版本中引入原生多Agent协作支持,包括Agent发现、任务分发和结果聚合机制。
Q:安全沙箱的Locked模式具体限制哪些操作?
A:Locked模式下,Agent只能执行预定义白名单内的操作,包括:读取指定目录下的文件(不可写)、调用白名单API(如内部知识库)、执行白名单Shell命令(如 ls、cat,不包括 rm、wget)。网络访问完全禁止,CPU和内存限制为配置上限(默认1核/256MB),执行时长限制为30秒。任何超出白名单的操作都会被拒绝并记录日志。该模式适合在共享服务器或生产环境中运行不可信的Agent任务。
Q:如何在Windows上启用安全沙箱?
A:Windows下OpenSquilla使用进程级隔离而非系统调用级隔离。可通过配置文件设置 sandbox.windows: true,启用Windows Job Object限制CPU、内存和进程数。相比Linux的Bubblewrap,Windows沙箱无法限制系统调用和网络访问,安全性较低。建议在Windows开发环境中使用Standard模式,生产环境迁移到Linux。
9. 项目地址
相关推荐
DeepSeek Super-agent 深度评测:从被动对话到持续在线协作者的架构跃迁
Super-agent 是由 DeepSeek Harness 团队推出的持续在线 Agent 系统架构。该架构通过双层设计、事件驱动机制、异步多信道交互、存算分离以及 Watchdog 异常自愈能力,实现了连续、高效、主动、持久四个核心特征:跨 IM/GitHub 无缝推进同一任务、并行处理多项工作、主动观察环境事件并自主推进、异常自动恢复。配套开源 MIT 原型 dsh-superagent-...
LongCat-2.5 – 美团 LongCat 推出的原生多模态模型深度评测
LongCat-2.5是美团LongCat团队推出的原生多模态模型,总参数达1.6万亿,每token激活约480亿参数。该模型面向长程智能体任务设计,将视觉信号离散化为多层级token与文本统一处理,显著强化了Visual Coding能力。依托大规模Agentic强化学习、数据合成流水线以及国产算力上的长上下文训练与W4A4量化优化,LongCat-2.5在终端编程、浏览检索、视觉理解等多项评测...
SenseNova Loop-9B-Preview评测:商汤以9B参数挑战27B级复杂任务的循环多模态架构
SenseNova Loop-9B-Preview是商汤科技开源的9B参数级多模态预览模型,其核心创新在于采用Looped Transformer循环架构,保留首尾各4层原始解码器,将中间层替换为参数共享的循环计算模块,通过多轮迭代扩展有效计算深度,使模型以约9B参数实现56层执行深度。该模型引入mHC(Manifold-Constrained Hyper-Connections)机制增强特征交互...
Canva Brush – Canva 推出的视觉-语言设计编辑模型深度评测
Canva Brush是Canva Research团队于2026年10月29日正式发布的首个自研视觉-语言模型(VLM),专为设计编辑场景打造。该模型能够理解设计稿的页面结构、识别用户的编辑意图,并通过智能体循环机制自主执行从单行文案修改到整套演示文稿批量调整的各类编辑任务。与Canva同期推出的图像生成模型Craft形成明确分工——Craft负责从零生成图像,Brush则聚焦于对现有设计的精细...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。