
PixelRAG – 伯克利开源的视觉原生 RAG 框架

导读摘要:
PixelRAG是伯克利SkyLab/BAIR开源的一款视觉原生RAG框架。它跳出传统RAG从网页或PDF中抽取文本再检索的范式,改用无头Chromium将文档渲染为截图瓦片,并通过LoRA微调的Qwen3-VL视觉向量检索模型直接读取图像中的表格、图表和版式信息,从而解决了传统RAG在表格、图表和复杂版式上信息丢失的痛点。该框架提供从渲染、索引到检索、生成的完整工具链,并附带覆盖828万维基百科...
1. PixelRAG是什么
PixelRAG是伯克利SkyLab/BAIR开源的一款视觉原生RAG框架。它跳出传统RAG从网页或PDF中抽取文本再检索的范式,改用无头Chromium将文档渲染为截图瓦片,并通过LoRA微调的Qwen3-VL视觉向量检索模型直接读取图像中的表格、图表和版式信息,从而解决了传统RAG在表格、图表和复杂版式上信息丢失的痛点。该框架提供从渲染、索引到检索、生成的完整工具链,并附带覆盖828万维基百科页面的预建索引,支持免密钥API和本地自建索引。
技术定位与领域: 属于检索增强生成(RAG)领域中的视觉原生RAG,区别于传统的文本抽取RAG。其独特定位在于将文档视为图像直接处理,保留视觉布局信息,适用于对表格、图表、多栏排版等视觉结构敏感的知识密集型任务。
研发背景: 由加州大学伯克利分校的SkyLab和BAIR实验室联合开发,研究团队在视觉语言模型和高效检索系统方面有深厚积累。研发动机源于传统RAG在处理视觉丰富文档时的根本缺陷——文本抽取过程破坏了表格对齐、图表语义和版面结构,导致检索和生成质量下降。
核心价值: 解决了传统RAG“看起来有答案,抽完字就没了”的痛点,实现了信息无损的文档检索。通过像素级表示,不仅保留了完整视觉信息,还带来了独特的效率杠杆——降低截图分辨率可最多降低3倍token成本且精度不降。实验表明,其在多个开放域问答基准上全面超越文本RAG基线,最高提升18.1%。
技术特点: 核心创新在于“表示即图像”的管线设计,用截图代替文本作为检索和生成的统一媒介。技术上融合了无头浏览器渲染、视觉向量嵌入(Qwen3-VL + LoRA)和VLM直接读取,形成了一个从文档到答案的纯视觉通道,省去了复杂的HTML解析和文本清洗流程。
2. 主要功能
页面渲染(pixelshot): 使用无头Chromium将网页或PDF渲染为截图瓦片,完整保留表格行列对齐、图表坐标轴、信息图版式等视觉结构。支持URL与本地文件混合输入,Windows/macOS自动调用系统已安装Chrome,无需额外配置浏览器环境。
视觉语义检索: 将截图编码为向量嵌入,支持文本搜图和以图搜图两种查询模式。本地默认使用FAISS进行高效近邻搜索,大规模部署时可切换至Qdrant,后者支持量化压缩、磁盘存储和多服务共享索引,适应不同规模需求。
像素直接阅读: 检索命中的截图瓦片直接作为图像输入馈送给视觉语言模型(VLM),模型从图像上直接读取数字、文字和版式信息,全程无中间文本转换。这一设计避免了传统OCR或文本解析带来的误差累积。
托管搜索服务: 提供免密钥API和网页Demo,内置828万维基百科页面的预建索引。用户无需任何配置即可通过POST请求
https://api.pixelrag.ai/search进行搜索,或在pixelrag.ai网站即时体验,降低了使用门槛。自建索引管线: 提供完整的命令行工具链,包括
pixelrag index、embed、build-index、serve等命令。用户只需编写YAML配置文件指定文档路径和嵌入模型,即可对自有PDF、网站建立索引,Mac(Apple Silicon)即可运行小规模索引。Agent集成: 提供Claude Code插件
pixelbrowse,无需MCP依赖即可让Claude截图“看”网页而非吞食残缺的HTML。通过claude plugin install pixelbrowse@pixelrag-plugins安装后,Agent能够直接阅读渲染后的页面截图,提升网页理解质量。
3. 如何使用
环境要求: 需要Python 3.10或更高版本,以及pip包管理器。推荐使用Linux或macOS系统,Windows也可运行但需确保系统已安装Chrome浏览器(用于pixelshot渲染)。大规模索引构建建议配备NVIDIA GPU(如A100),小规模测试可在Mac Apple Silicon上运行。
安装核心工具: 执行
pip install pixelrag即可安装PixelRAG及其依赖。该命令会安装pixelshot渲染工具、嵌入管线、检索服务等核心组件。如需使用Claude Code插件,还需执行uv tool install pixelrag。渲染页面为截图: 运行
pixelshot https://example.com -o ./tiles将目标网页或PDF渲染为截图瓦片,输出到指定目录。支持同时传入多个URL或本地文件路径,渲染参数(如分辨率、瓦片尺寸)可在配置文件中调整。体验托管搜索: 无需任何本地配置,直接向
https://api.pixelrag.ai/search发送POST请求(携带查询文本),即可在828万维基百科页面索引中检索。或在浏览器打开pixelrag.ai,使用内置搜索Demo进行交互式体验。自建索引并启动服务: 编写
pixelrag.yaml配置文件,指定文档路径(如本地PDF文件夹)、嵌入模型(默认使用Qwen3-VL-Embedding-2B LoRA权重)、输出目录等。执行pixelrag index build构建索引,然后运行pixelrag serve --index-dir ./my_index --port 30001启动本地搜索服务。Mac Apple Silicon可处理小规模文档集,全量维基索引(约217GB)需GPU算力。对接Claude Code: 安装pixelbrowse插件:
claude plugin marketplace add StarTrail-org/PixelRAG,然后claude plugin install pixelbrowse@pixelrag-plugins。之后Claude在浏览网页时将自动使用截图而非HTML解析,提升对复杂页面的理解能力。进阶训练: 如需自定义嵌入模型,进入
train/目录(独立uv项目),按照README使用提供的LoRA训练数据和官方开源权重进行微调。训练数据基于对比学习构建,可针对特定领域优化检索精度。
4. 优缺点分析
| 优点 |
|---|
| 信息无损: 以截图代替文本抽取,表格行列、图表、版式完整保留,彻底解决传统RAG在视觉丰富文档上信息丢失的问题。 |
| 性能更强: 在NQ、SimpleQA、MMSearch等开放域任务上全面超越文本RAG基线,多模态与Agentic基准最高提升18.1%,纯文本任务同样表现更优。 |
| 成本更低: 像素表示带来独有的效率杠杆,降低截图分辨率可使token成本最多降低3倍且精度不降,为大规模部署提供经济性优势。 |
| 管线更简单: 省去复杂的HTML解析、清洗、切分流程,渲染截图即可入库,工程实现大幅简化,降低维护成本。 |
| 规模已验证: 首个用截图形式覆盖全量维基百科的RAG管线,附带828万页免密钥托管索引,用户可即刻体验大规模视觉检索效果。 |
5. 同类工具对比
| 对比维度 | PixelRAG | 传统文本RAG(BM25) | 传统文本RAG(DPR) |
|---|---|---|---|
| 出品方 | 伯克利 SkyLab/BAIR(2026) | 社区标准方法 | 社区标准方法 |
| 基座模型 | Qwen3-VL-Embedding-2B + LoRA微调 | TF-IDF / BM25统计特征 | BERT / Contriever等文本嵌入 |
| 检索对象 | 网页截图为主,兼容PDF | 纯文本(HTML解析后文本) | 纯文本(段落级别) |
| 嵌入粒度 | 单向量:每块截图对应一个向量 | 词袋或稀疏向量 | 稠密向量(每段落一个) |
| 存储成本 | 单向量方案,存储效率高,易扩展 | 极低(倒排索引) | 中等(每段落一个向量) |
| 索引规模 | 已验证覆盖全量维基百科(3000万张截图) | 可扩展至任意规模 | 可扩展至亿级段落 |
| 检索精度 | 在NQ、SimpleQA等任务全面超越文本基线,最高提升18.1% | 依赖关键词匹配,语义泛化弱 | 语义匹配强,但丢失视觉信息 |
| token效率 | 降低截图分辨率可降最多3倍token成本且精度不降 | 无图像token消耗 | 无图像token消耗 |
| 工程生态 | 全栈工具链:渲染、嵌入、索引、托管API、Claude Code插件 | 工具分散,需自行组合 | 需搭配LangChain等框架 |
选型建议: 对于以纯文本为主、视觉结构简单的文档(如新闻文章、博客),传统文本RAG(BM25或DPR)仍具成本优势,部署简单且存储开销极低。但若文档包含大量表格、图表、多栏排版或信息图,PixelRAG和ColPali等视觉RAG方案能显著提升检索质量。PixelRAG在工程生态和全栈工具链上更为完善,尤其适合需要快速搭建从文档渲染到检索生成完整管线的团队。ColPali在版面密集型文档的细粒度匹配上精度占优,但工程配套相对薄弱,更适合有较强自建能力的研发团队。对于需要处理大规模知识库(如全量维基百科)且希望降低token成本的场景,PixelRAG的像素效率杠杆和已验证的规模覆盖使其成为更务实的选择。在Agent集成方面,PixelRAG的Claude Code插件提供了开箱即用的网页阅读能力,而传统RAG和ColPali目前缺乏类似的深度集成方案。
6. 编辑总结
PixelRAG在RAG技术路线上做出了具有实质意义的创新:将文档直接视为图像进行处理,从根本上绕过了文本抽取的信息损失问题。这一设计并非简单的“用OCR代替解析”,而是构建了一套从渲染、嵌入到生成的纯视觉管线,其中嵌入层基于Qwen3-VL进行LoRA微调,使得截图能够被语义检索,而生成层则直接利用VLM的像素理解能力。从技术实现看,其最大的亮点在于发现了像素表示带来的效率杠杆——降低截图分辨率可大幅压缩token成本而不损失精度,这一特性在成本敏感的大规模部署中极具价值。实验数据支撑了其性能优势:在多个开放域问答基准上全面超越文本RAG基线,最高提升18.1%,且在多模态与Agentic任务上同样表现更优。
实用价值方面,PixelRAG直接击中了企业级RAG应用中最常见的痛点:财报、技术文档、产品手册等包含大量表格和图表的材料,在传统RAG中检索效果往往不尽人意。该框架提供了一条“渲染即索引”的简洁路径,大幅降低了工程复杂度。同时,托管搜索服务和Claude Code插件降低了使用门槛,使个人开发者和中小团队也能快速体验视觉RAG的能力。
适用人群包括:需要处理视觉丰富文档的知识管理团队、希望提升Agent网页理解能力的AI应用开发者、以及研究视觉检索与多模态RAG的学术人员。未来发展潜力上,随着VLM能力的持续提升和多模态数据的爆发,视觉原生RAG有望成为知识检索的主流范式之一。PixelRAG目前已在规模上验证了可行性(全量维基百科),后续若能在中文支持、文档完善度和动态内容渲染稳定性上持续优化,将有望成为该领域的标杆项目。
7. 应用场景
财报与数据表问答: 直接读取财报PDF或网页中的数字表格,避免文本解析导致的行列错位。用户可提问“去年第四季度营收是多少?”,系统检索命中包含该表格的截图区域,VLM直接从图像中读取数字作答,准确率显著高于文本抽取方案。
仪表盘与图表检索: 对包含KPI面板、折线图、柱状图的仪表盘截图进行索引,支持通过文本描述(如“查找用户增长趋势图”)或示例图像进行检索。检索命中的图表区域直接输入VLM,模型可解读趋势和异常点。
信息图与带图解文档: 信息图、流程图、技术架构图等传统文本索引无法覆盖的内容,通过截图瓦片完整保留视觉语义。用户可搜索“微服务架构图”找到对应截图,VLM可进一步解释图中各组件关系。
多栏排版产品页: 电商商品对比页、新闻多栏排版等复杂版式,截图瓦片保持原始布局参与检索。搜索“iPhone 16 Pro vs Samsung S25 参数对比”时,系统能精准定位包含对比表格的截图区域。
Agent网页阅读: 通过Claude Code的pixelbrowse插件,AI Agent在浏览网页时使用截图代替HTML解析,能够正确理解表格数据、按钮状态、图表信息等,提升自动化任务(如数据采集、表单填写)的可靠性。
8. 常见问题FAQ
Q:PixelRAG与传统RAG的核心区别是什么?
A:传统RAG从文档中抽取纯文本(通过HTML解析或PDF文本提取),丢失了表格对齐、图表语义和版面结构。PixelRAG将文档渲染为截图瓦片,直接以图像形式进行检索和生成,完整保留视觉信息,因此对表格、图表等视觉密集型内容检索效果更优。
Q:是否支持中文文档?
A:基座模型Qwen3-VL具备中文理解能力,框架本身对语言无限制。但中文文档的渲染效果和检索精度尚未有公开基准数据,建议用户在小规模测试后评估。对于包含中文表格和图表的文档,PixelRAG的视觉原生方式理论上比文本抽取更具优势。
Q:需要什么样的硬件配置?
A:小规模测试(如几百页文档)在Mac Apple Silicon或普通CPU上即可运行pixelshot渲染和FAISS检索。构建全量维基百科索引(约217GB)则需要GPU算力(如NVIDIA A100)。推理阶段,VLM读取截图需要一定的GPU显存,建议至少8GB显存用于中等规模应用。
Q:托管搜索服务是否免费?有何限制?
A:托管搜索API(https://api.pixelrag.ai/search)和网页Demo目前免费开放,内置828万维基百科页面索引。暂无公开的使用频率限制,但大规模商业使用建议自建索引以避免依赖外部服务。
Q:能否处理PDF文件?
A:可以。pixelshot工具支持将PDF按页渲染为截图瓦片,与网页渲染流程一致。PDF中的表格、图表、公式等视觉元素均能完整保留。对于扫描版PDF(非电子版),渲染效果取决于PDF本身的质量,建议配合OCR增强。
Q:如何将PixelRAG集成到现有应用中?
A:自建索引后可通过REST API(pixelrag serve启动)提供搜索服务,支持文本查询和图像查询。返回的截图瓦片可直接作为VLM输入。也可直接调用托管API进行快速原型开发。Claude Code插件提供了Agent集成的最简路径。
Q:索引构建需要多长时间?
A:取决于文档数量和硬件。小规模文档集(数百页)在Mac Apple Silicon上可在几分钟内完成。全量维基百科索引(3000万张截图)需在GPU集群上运行数小时至数天,具体时间待官方公布。
9. 项目地址
- 产品官网: https://pixelrag.ai/
- 托管搜索API: https://api.pixelrag.ai/search
- GitHub仓库: https://github.com/StarTrail-org/PixelRAG
- 技术论文: https://arxiv.org/pdf/2606.28344
相关推荐

FLUX 3 Max – fal 与 Black Forest Labs 推出的视频生成模型深度评测
FLUX 3 Max 是由 fal Research 与 Black Forest Labs 联合推出的后训练视频生成模型,基于 BFL 自研的 FLUX 3 多模态基础模型,支持文生视频、图生视频与关键帧插值三种工作流,可生成 5–20 秒、最高 1080p 分辨率且自带原生音频的视频内容。该模型主打极致推理速度与成本效率,10 秒成片约 12 秒完成生成,官方宣称在同画质条件下比 Seedan...
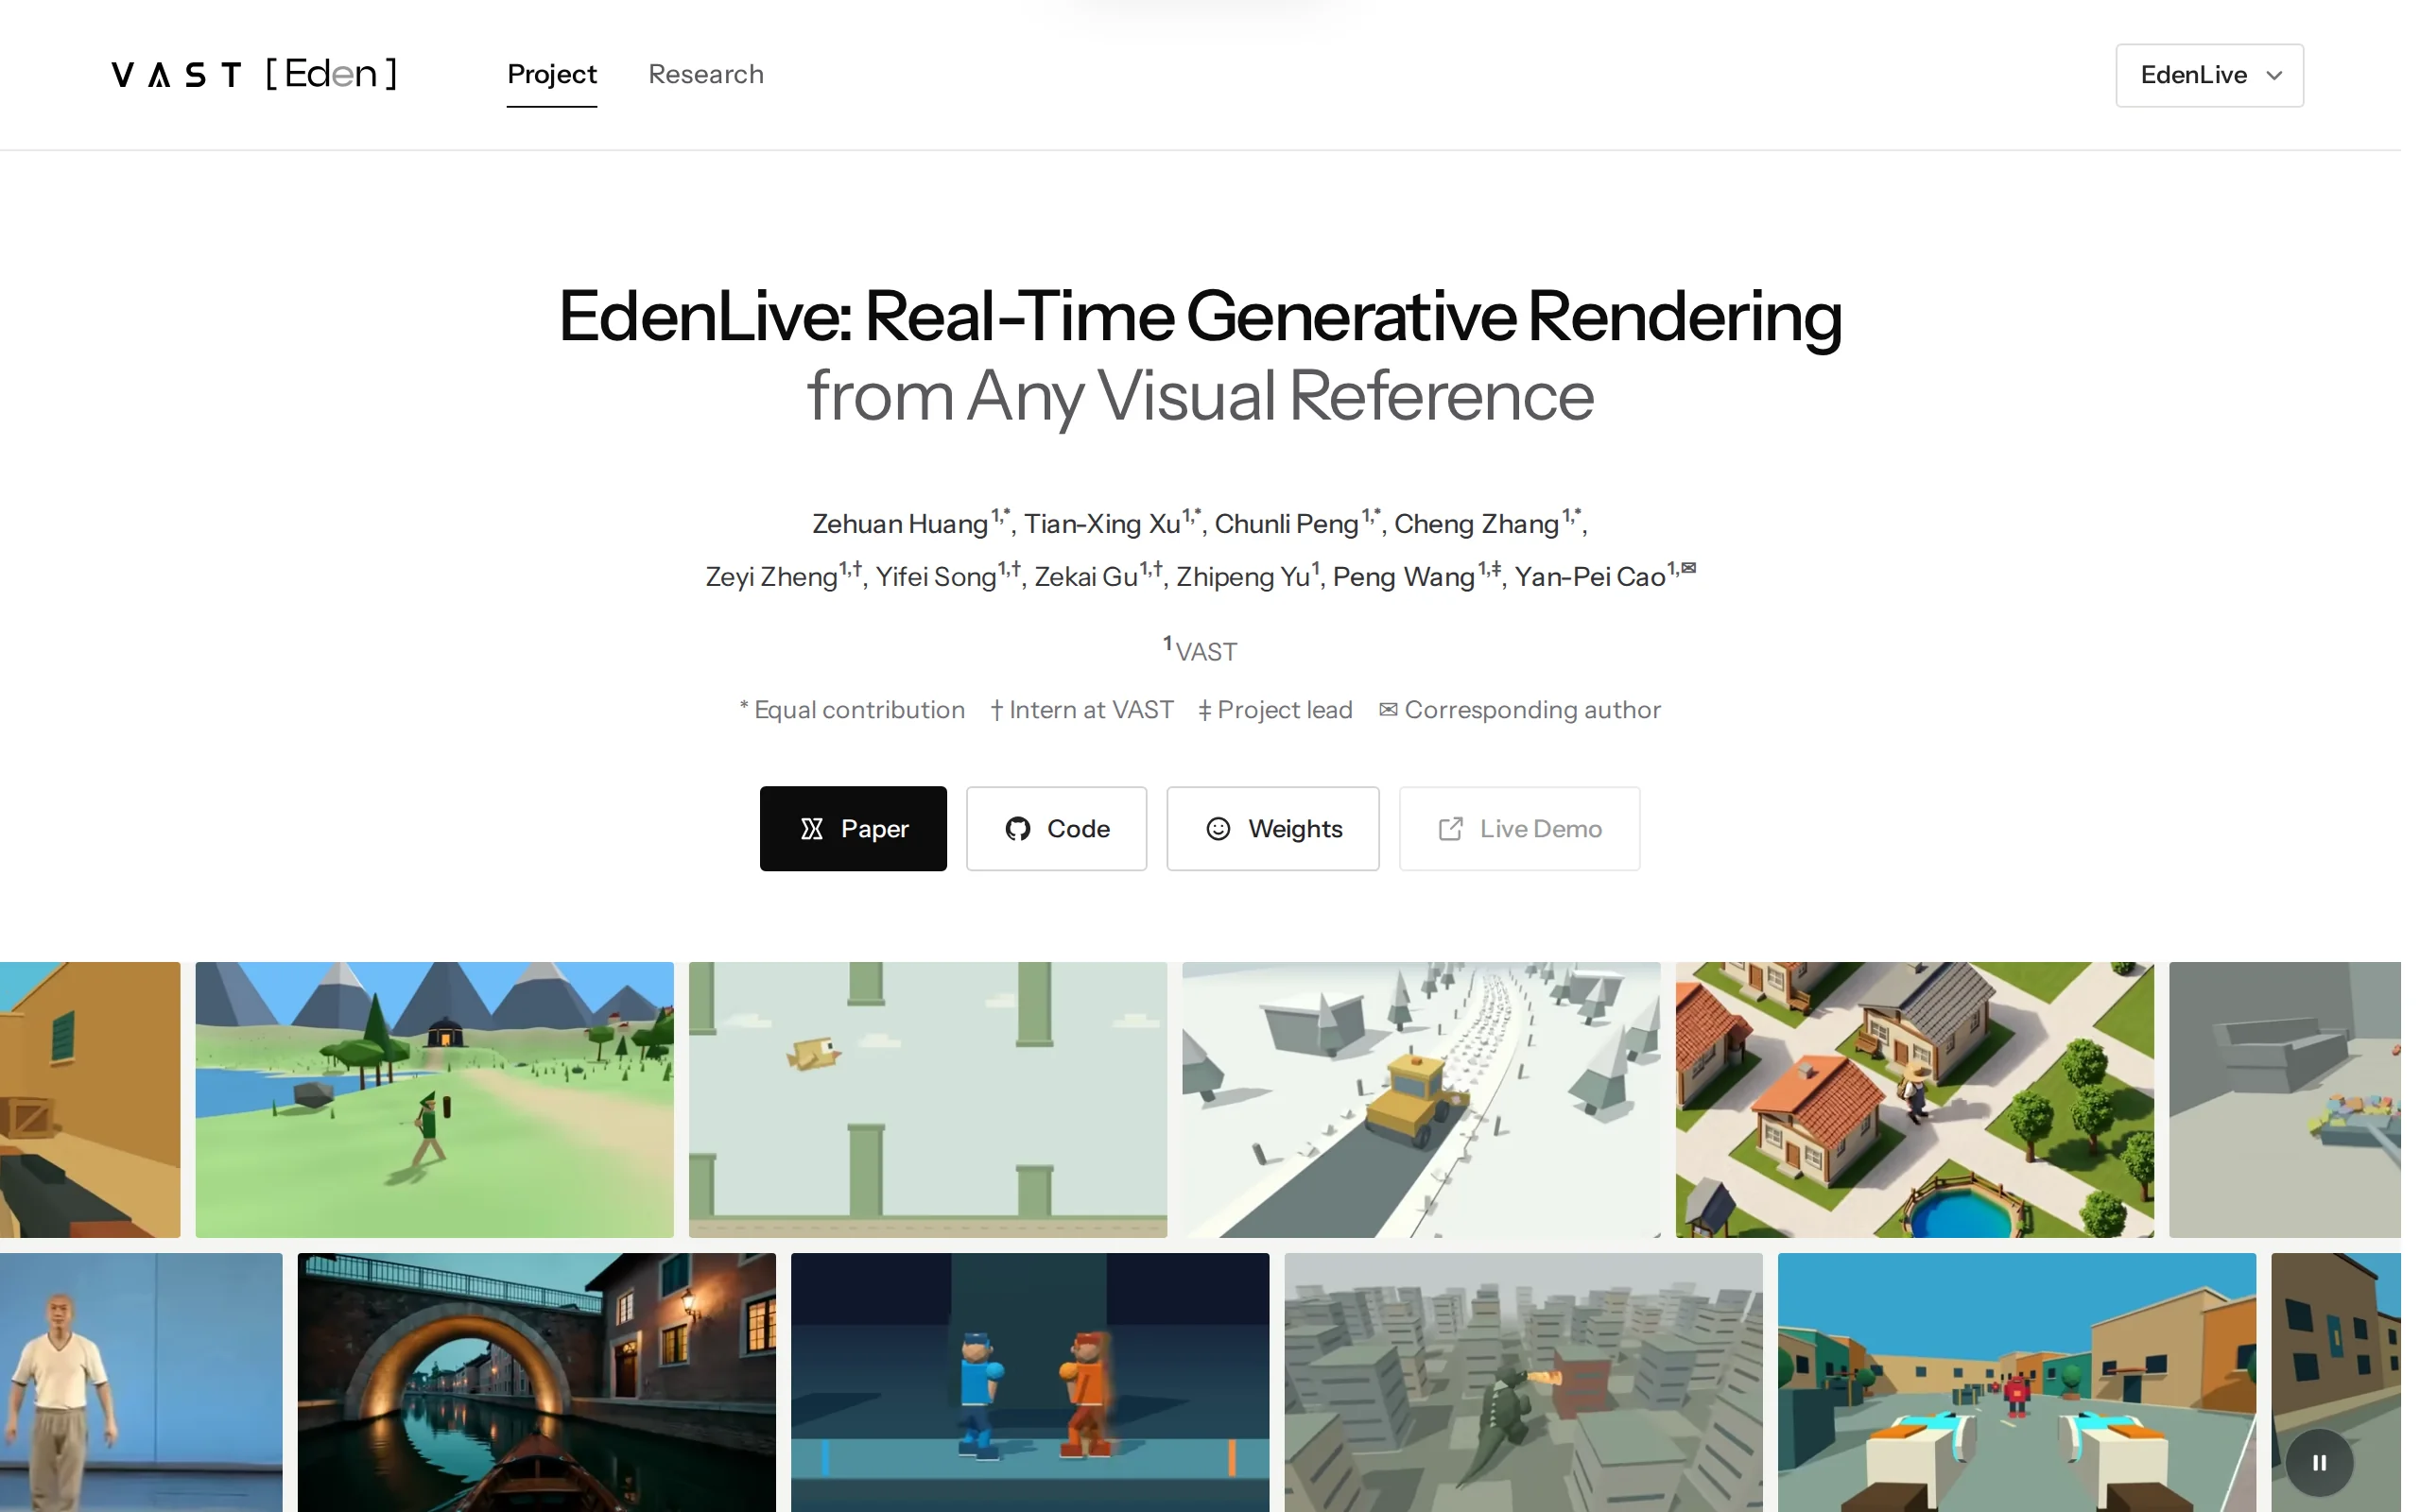
EdenLive – VAST 推出的实时生成式渲染器,重构世界模型渲染范式
EdenLive 是 VAST 推出的实时生成式渲染器,也是其世界模型项目 Project Eden 的阶段性成果。该工具以 Proxy 简化画面或参考视频为控制信号,结合目标首帧与文本提示词,持续实时生成写实或风格化画面,在单张 RTX 5090 上即可实现 720P、24FPS 以上的输出,端到端延迟仅百毫秒量级。其核心设计在于将世界状态维护与视觉渲染解耦,使视频模型不再承担隐式状态推断,从而...

BlenderWorld – Qwen 开源的 3D 创作 Agent 评测基准
BlenderWorld 是 Qwen 团队联合浙江大学、香港中文大学、复旦大学及新加坡国立大学共同推出的 3D 创作 Agent 评测基准,包含 223 项真实制作任务,用于检验 AI 系统能否根据照片、视频或设计规格,在 Blender 环境中交付可编辑的 3D 工程文件。该基准通过多视角渲染与原生工程结构检查的双轨评审机制,以 2,651 条验收标准综合衡量需求完成度与视觉质量。实测 13 ...
MiDashengLM-Spatial – 小米开源的空间音频理解大模型
MiDashengLM-Spatial是小米Dasheng团队开源的空间音频理解大模型,业界首个在单一架构内统一通用音频理解与空间感知的端到端模型。该模型以MiDashengLM-7B为基座,通过新增Spatial-Dasheng空间音频编码器和层级语义到空间条件模块(HSSC),实现了声源方位感知、运动轨迹追踪以及多声源时空关系推理等能力,并支持重叠声源逐帧定位。配套数据方面,模型使用100万个...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。