
SkyClaw-v1.0 – 昆仑万维天工AI推出的高性能Agent模型
导读摘要:
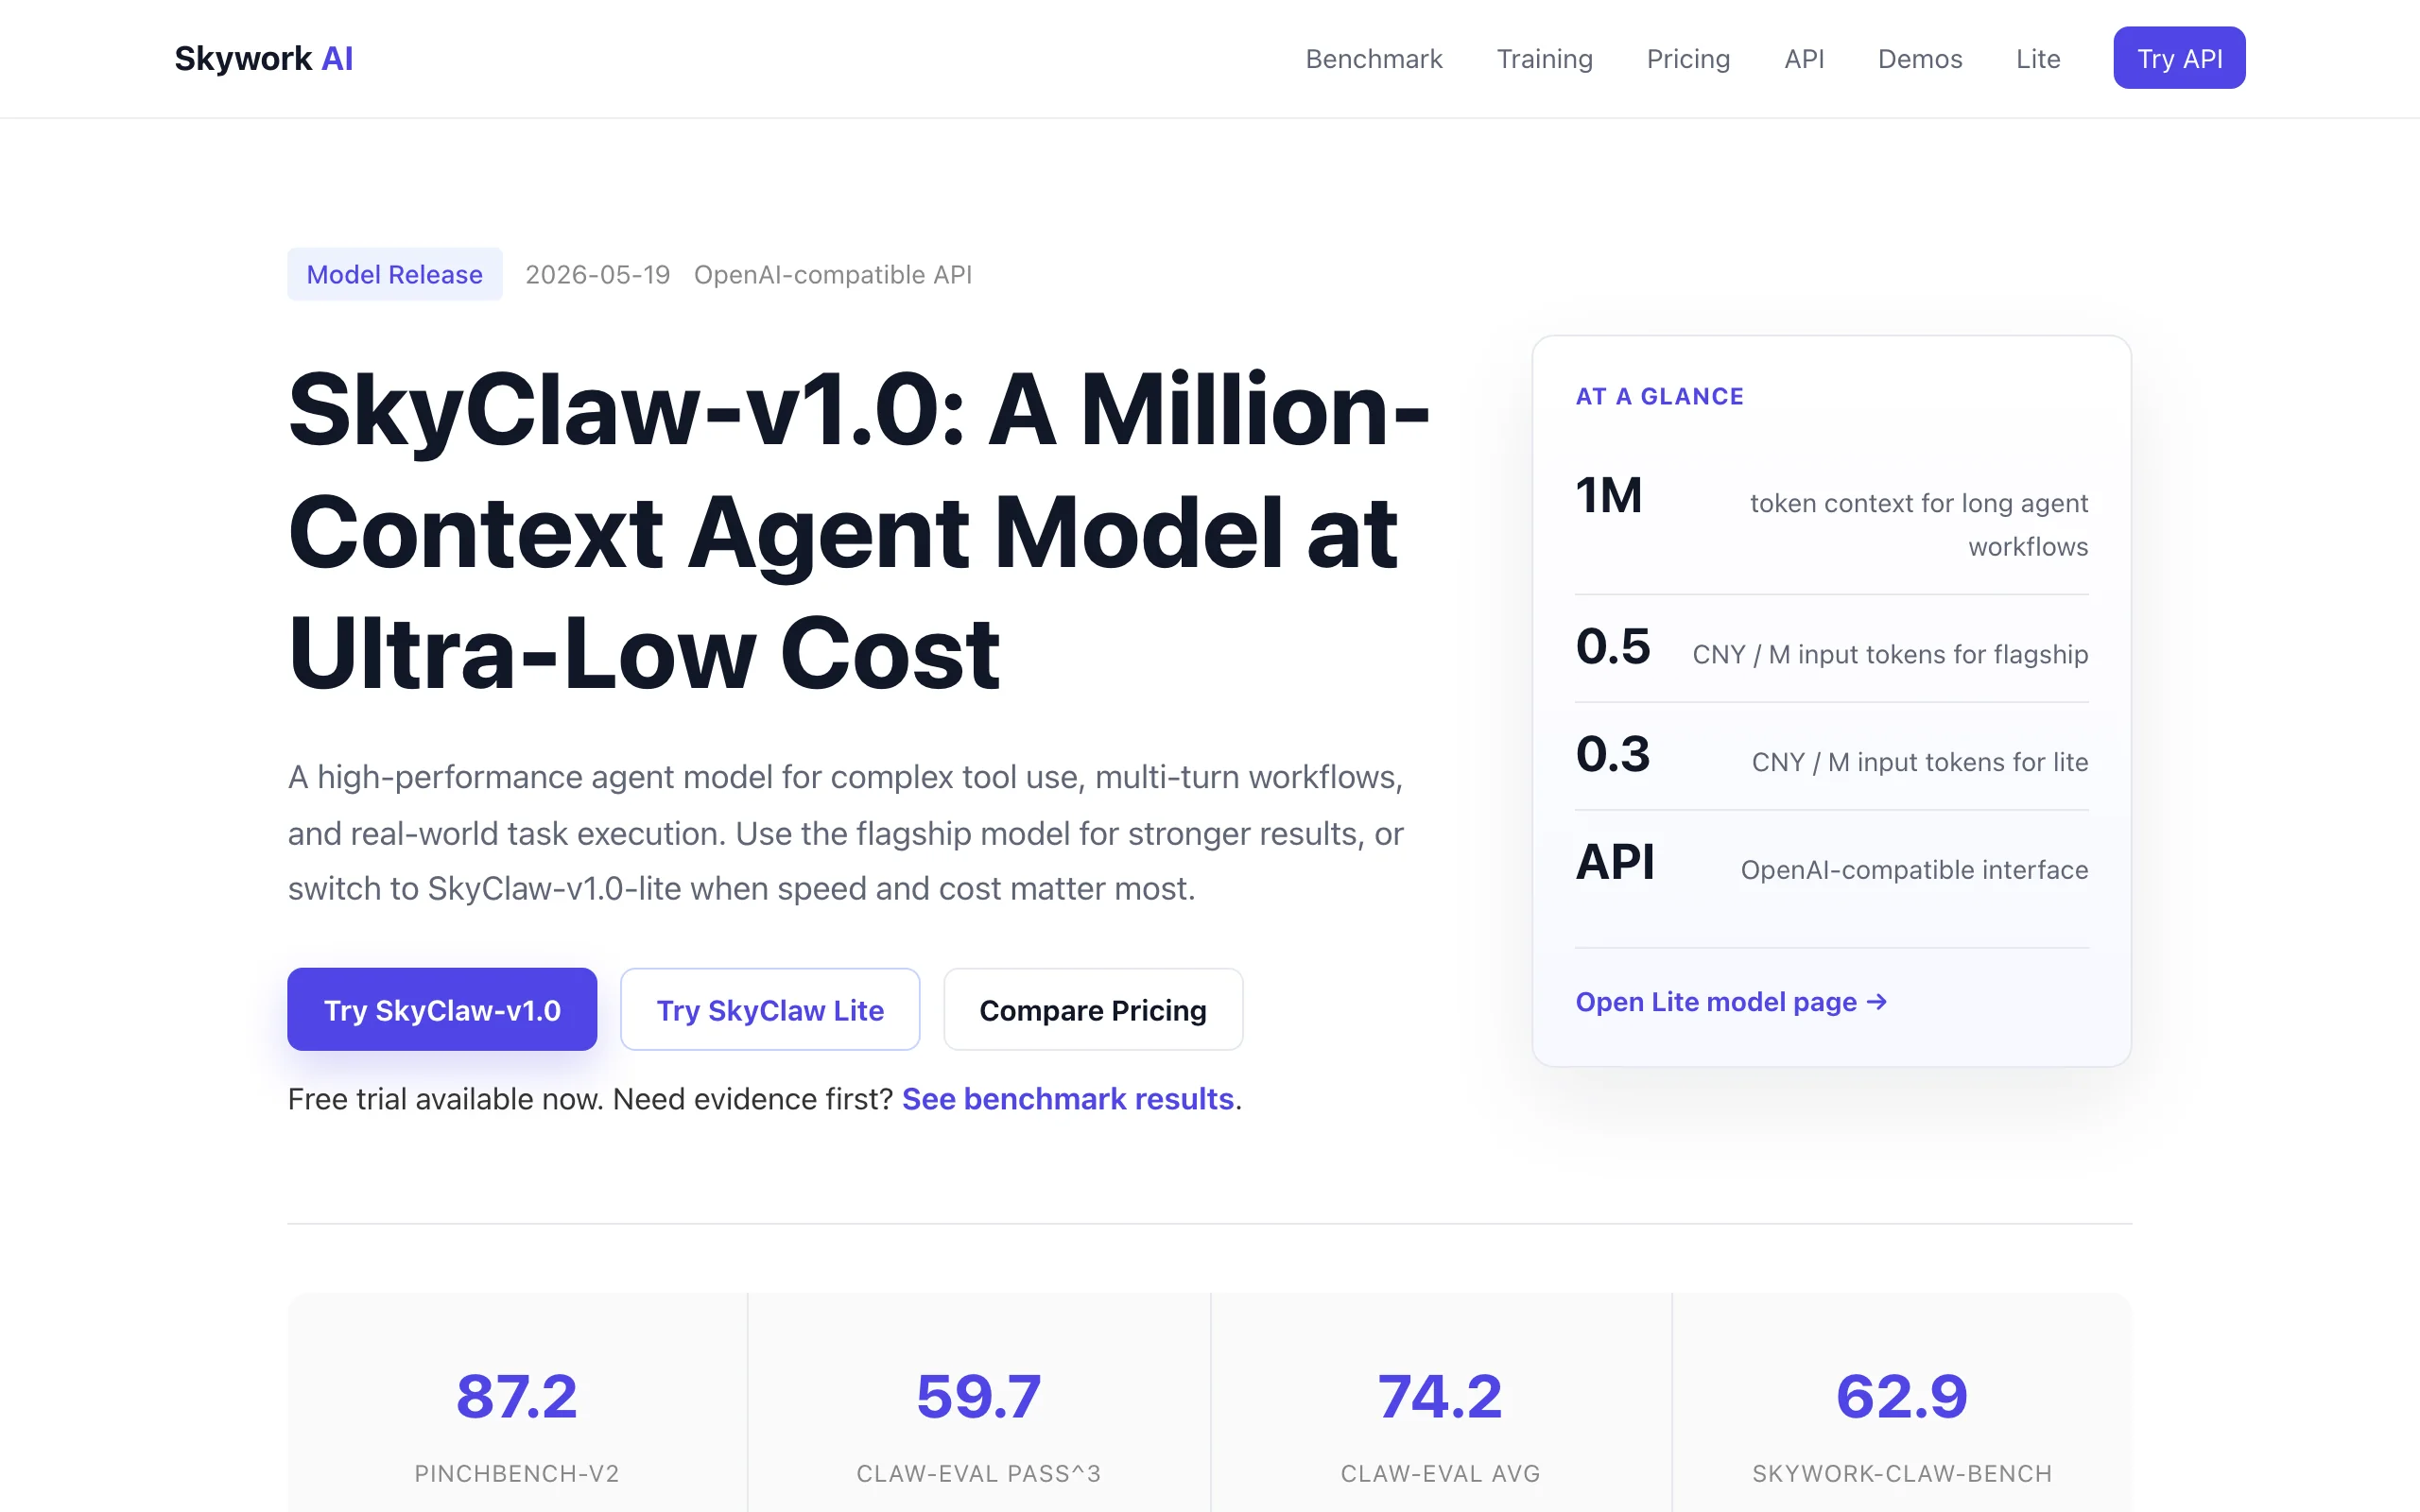
SkyClaw-v1.0是昆仑万维天工AI团队推出的高性能Agent专用模型,专为复杂多步任务和真实工作流场景设计。该模型支持百万token级别的超长上下文窗口,深度适配OpenClaw、Hermes、Claude Code、Codex等主流Agent框架,通过大规模mid-train、合成任务SFT与端到端强化学习优化,在PinchBench-v2、Claw-Eval等专业评测中超越了Minim...
1. SkyClaw-v1.0是什么
SkyClaw-v1.0是昆仑万维天工AI团队推出的高性能Agent专用模型,专为复杂多步任务和真实工作流场景设计。该模型支持百万token级别的超长上下文窗口,深度适配OpenClaw、Hermes、Claude Code、Codex等主流Agent框架,通过大规模mid-train、合成任务SFT与端到端强化学习优化,在PinchBench-v2、Claw-Eval等专业评测中超越了Minimax 2.7、DeepSeek V4 Flash等主流开源模型。模型现已通过天工Skywork平台开放试用,并提供APIFree兼容OpenAI格式的API调用,为开发者提供高性价比的Agent推理能力。
技术定位与领域: SkyClaw-v1.0定位于高性能Agent推理模型,属于自然语言处理与智能体系统交叉领域。与传统通用大模型不同,该模型专注于Agent场景中的工具调用、多步推理、错误恢复和持续执行能力,是面向真实工作流优化的专用模型。其百万token上下文窗口使其在长文档分析、复杂多步任务处理方面具有明显优势。
研发背景: 由昆仑万维天工AI团队研发,团队在AI大模型领域积累了丰富的技术经验,此前已推出Skywork系列模型。SkyClaw-v1.0的研发动机源于当前Agent框架对底层模型的高要求——通用模型在处理复杂工具调用、多轮迭代和错误恢复时表现不佳。团队通过定向训练和强化学习优化,打造了专为Agent场景服务的模型。
核心价值: SkyClaw-v1.0解决了Agent框架中底层模型能力不足的核心痛点。在PinchBench-v2上达到87.2分,在Claw-Eval上平均77.2分,显著优于同规模开源模型。更重要的是,其定价低于竞品50%以上,为规模化Agent部署提供了经济可行的方案。模型在OpenClaw相关任务上表现接近DeepSeek V4 Pro、Claude Opus 4.6等更大规模模型,实现了性能与成本的平衡。
技术特点: 采用mid-train、合成任务SFT与Agentic RL的三阶段训练方法,针对Agent框架中的持续执行、错误恢复和多轮迭代进行专项优化。支持百万token上下文窗口,原生适配OpenClaw、Hermes、Nanobot、Claude Code、Codex等主流Agent框架,具备文件读取、代码编辑、检索、测试、页面观察等高频Agent动作的深度优化能力。
2. 主要功能
百万上下文Agent推理: 支持百万token级别的上下文窗口,能够处理包含大量历史信息、复杂文档和长时间交互的Agent任务。在处理多步骤工作流时,模型可以完整保留中间状态和推理过程,避免信息丢失导致的错误决策。
多框架原生兼容: 深度适配OpenClaw、Hermes、Nanobot、Claude Code、Codex等主流Agent框架,无需额外适配即可直接作为底层模型使用。这种广泛的兼容性降低了开发者的集成成本,使SkyClaw能够快速融入现有Agent生态。
复杂工具调用优化: 针对Agent场景中的高频动作进行专项优化,包括文件读取、代码编辑、信息检索、自动化测试、页面观察等。模型能够准确理解工具描述、正确选择调用参数,并在多轮交互中保持工具调用的一致性。
全形态应用构建: 能够生成具备生产级布局、真实导航流程和完整交互状态的多页面应用。这不仅限于简单的界面原型,而是包含完整的业务逻辑、数据流转和用户交互体验,可直接用于原型演示或产品验证。
沉浸式游戏开发: 支持生成包含物理引擎、碰撞检测、状态管理和用户输入的交互式网页游戏。模型能够理解游戏设计逻辑,自动编写完整的游戏代码,包括物理模拟、AI对手、计分系统等复杂功能。
研究型数据分析: 可围绕开放主题进行信息组织、数据整理、可视化呈现与网页报告生成。模型能够自动收集和分析数据,生成包含图表、表格和文字分析的综合性研究报告,适用于市场分析、学术研究等场景。
高性价比API服务: 通过APIFree提供兼容OpenAI格式的流式API,支持工具调用与多轮对话。定价低于Minimax 2.7与Qwen3.6系列模型的一半,支持规模化高频调用,为企业和开发者提供经济高效的Agent推理能力。
3. 如何使用
环境要求与前置条件: 使用SkyClaw-v1.0无需本地GPU环境,所有推理通过云端API完成。用户需要准备稳定的互联网连接,并注册天工Skywork平台或APIFree账号。对于Agent框架集成场景,需要确保本地环境已安装Python 3.8+及对应框架的依赖库。
网页端直接使用: 登录天工Skywork平台(skyworkai.com),在模型列表中选择“SkyClaw V1.0”即可直接输入任务指令使用。这是最便捷的使用方式,适合快速体验模型能力,无需任何编码操作。
API接入: 注册APIFree账号获取API Key,通过兼容OpenAI格式的接口将SkyClaw接入现有应用或Agent框架。具体步骤包括:获取API Key、配置请求端点、设置模型参数(如max_tokens、temperature)。API支持流式输出,适合需要实时响应的应用场景。
Agent框架集成: 将SkyClaw配置为Claude Code、Codex、Hermes或OpenClaw等框架的底层模型。以OpenClaw为例,需要在框架配置文件中设置模型名称和API端点,使模型具备文件编辑、测试执行与多轮迭代能力。建议在集成前先测试基础功能,确保工具调用参数正确。
最佳实践建议: 对于复杂多步任务,建议将任务拆分为多个子任务并逐步执行,利用百万token上下文窗口保持历史状态。在工具调用场景中,明确指定工具参数和预期输出格式,避免歧义。对于生产环境,建议使用API限流和重试机制,确保服务稳定性。
4. 优缺点分析
| 优点 |
|---|
| 性能领先: 在PinchBench-v2达到87.2分、Claw-Eval平均77.2分,显著超越Minimax 2.7、DeepSeek V4 Flash等主流开源模型,Agent专用能力突出。 |
| 极致性价比: 定价低于Minimax 2.7与Qwen3.6系列模型的一半,同时保持高性能,为规模化Agent部署提供经济可行的方案。 |
| 百万token超长上下文: 支持百万token上下文窗口,远超竞品常见的128K限制,适合处理长文档、复杂多步任务和长时间交互场景。 |
| 真实工作流优化: 针对Agent框架中的持续执行、错误恢复和多轮迭代进行专项训练,在真实工作流场景中表现稳定可靠。 |
5. 同类工具对比
| 维度 | SkyClaw-v1.0 | DeepSeek-V4-Flash | Qwen3.6-27B |
|---|---|---|---|
| 上下文长度 | 百万token | 128K | 128K |
| Agent框架兼容 | OpenClaw/Hermes/Codex/Claude Code原生适配 | 通用框架需适配 | 通用框架需适配 |
| Claw-Eval Avg | 77.2 | 74.2 | 72.6 |
| PinchBench-v2 | 87.2 | 85.9 | 86.4 |
| 定价 | 低于竞品50%+ | 中等 | 中等 |
| 训练方法 | mid-train+SFT+Agentic RL | RL+SFT | RL+SFT |
| 定位 | 真实工作流Agent模型 | 通用推理模型 | 通用推理模型 |
| 开源/开放 | API开放,lite版轻量 | 开源 | 开源 |
选型建议: 对于需要高性能Agent推理能力的开发者,SkyClaw-v1.0是最优选择,尤其在OpenClaw、Hermes等适配框架中,其百万token上下文和工具调用优化能够显著提升Agent任务完成质量。如果项目需要完全开源的模型进行本地部署或二次开发,DeepSeek-V4-Flash和Qwen3.6-27B提供了更灵活的选择,但在Agent专用性能上略逊一筹。
对于预算敏感且需要规模化Agent部署的场景,SkyClaw-v1.0的极致性价比优势明显,其API定价低于竞品50%以上,同时保持领先性能。如果项目主要依赖通用推理能力而非专用Agent任务,Qwen3.6-27B作为通用模型可能更适合,其广泛的社区支持和成熟的开源生态降低了集成风险。
6. 编辑点评
SkyClaw-v1.0的出现标志着Agent专用模型进入了一个新的发展阶段。从技术创新角度看,该模型采用的三阶段训练方法——mid-train、合成任务SFT与Agentic RL——是对传统通用模型训练范式的有效补充。特别是端到端强化学习的引入,使模型能够针对Agent场景中的工具调用、错误恢复和多轮迭代进行定向优化,这种“专精特新”的路线在性能上得到了验证:PinchBench-v2 87.2分和Claw-Eval 77.2分均领先同规模开源模型。
从实用价值分析,SkyClaw-v1.0解决了当前Agent生态中的核心痛点——底层模型能力不足。百万token上下文窗口使其能够处理复杂的长文档和多步任务,多框架原生兼容降低了集成门槛,而极致性价比则为规模化部署提供了经济可行性。对于企业和开发者而言,这意味着可以在不显著增加成本的情况下,显著提升Agent系统的任务完成质量。
适用人群方面,SkyClaw-v1.0最适合以下几类用户:需要构建复杂Agent工作流的开发者、希望降低Agent部署成本的企业、以及需要处理长文档和多步任务的AI应用开发者。对于纯文本生成或简单对话场景,通用模型可能更合适。
未来发展潜力方面,随着Agent框架的普及和复杂度的提升,SkyClaw这类专用模型的市场需求将持续增长。如果团队能够进一步完善开源生态、丰富文档资源和扩展框架兼容性,其影响力有望进一步扩大。同时,模型在游戏开发、应用构建等创意领域的表现也展示了Agent模型的更多可能性。
7. 应用场景
前端应用开发: 利用SkyClaw的代码生成能力,快速构建航旅管理、社交应用、内容社区、地图导航等生产级界面原型。模型能够生成包含完整布局、导航流程和交互状态的多页面应用,大幅缩短原型开发周期。
交互式游戏制作: 开发物理模拟弹球、国际象棋、飞机大战、德州扑克、Roguelike卡牌等网页游戏。模型能够自动编写包含物理引擎、碰撞检测、AI对手和计分系统的完整游戏代码,适合快速验证游戏创意。
数据报告生成: 制作财经资讯终端、美股七巨头深度分析、数字人播报等研究型网页与PPT。模型能够自动收集和分析数据,生成包含图表、表格和文字分析的综合性研究报告,适用于市场分析、学术研究等场景。
代码Agent集成: 作为底层模型接入代码审查、功能开发、自动化测试等企业级开发工作流。模型能够理解代码逻辑、执行测试用例、识别潜在问题,并自动生成修复建议,提升开发效率。
企业内部工具: 通过API接入自研工作流系统、自动化任务平台与IM机器人。模型能够处理复杂的业务流程,如自动化报表生成、智能客服、文档审核等,实现企业级AI自动化。
8. 常见问题FAQ
Q:SkyClaw-v1.0的百万token上下文是如何实现的?
A:百万token上下文通过优化模型架构和推理引擎实现,采用高效的注意力机制和内存管理技术。在实际使用中,建议合理利用长上下文窗口,避免一次性加载过多无关信息,以保持推理效率。
Q:SkyClaw-v1.0与DeepSeek V4 Flash相比,优势在哪里?
A:主要优势体现在三个方面:一是百万token上下文远超DeepSeek的128K;二是在Agent专用评测中表现更优(Claw-Eval 77.2 vs 74.2);三是定价更低,性价比突出。但DeepSeek在开源生态和通用推理能力上更具优势。
Q:SkyClaw-v1.0的API定价具体是多少?
A:官方表示定价低于Minimax 2.7与Qwen3.6系列模型的一半,具体价格需参考APIFree平台的最新定价策略。建议关注官方公告获取最新价格信息,同时注意API调用按token计费。
Q:SkyClaw-v1.0支持哪些Agent框架?
A:原生适配OpenClaw、Hermes、Nanobot、Claude Code、Codex等主流Agent框架。对于未适配的框架,可通过兼容OpenAI格式的API进行集成,但可能需要额外配置。
Q:SkyClaw-v1.0的推理速度如何?
A:推理速度取决于具体任务复杂度和API负载情况。对于简单任务,响应时间通常在秒级;对于需要大量工具调用的复杂任务,响应时间可能延长。建议使用流式API获取实时输出。
9. 项目地址
- 项目官网: https://skyworkai.github.io/skyclaw/
- 天工Skywork平台: https://skyworkai.com
- APIFree平台: https://apifree.ai (需注册获取API Key)
相关推荐
书生-A1.5 – 上海 AI Lab 开源的通专融合科学智能体
书生-A1.5(Sage-A1.5)是上海人工智能实验室推出的 35B 规模通专融合科学智能体,基于 Agents-A1 长程任务能力与书生·端砚科学发现平台构建,面向真实科研场景验证 RSI(Researcher-Scientist-Investigator)闭环。该模型能够自主拆解复杂科研任务、编排多个子智能体并行调研,并触发校验机制识别证据缺口、修正研究假设。书生-A1.5 已覆盖脑科学、电...
WorkForge – 腾讯联合复旦推出的智能体训练环境构建框架深度评测
WorkForge是腾讯混元与复旦大学联合推出的智能体训练环境构建框架,旨在解决当前智能体训练中高质量长程任务数据稀缺的核心瓶颈。该框架从专家工作流蓝图出发,通过获取智能体自动检索真实世界资源搭建工作区,基于工作区中的事实锚点生成任务指令与双重验证标准,让智能体在执行过程中产出可追溯的轨迹数据。目前WorkForge已建成16.7K个可验证环境,横跨40个专业领域,可将35B模型的GDPval得分...
星火X2.6:科大讯飞端云一体基座大模型的国产化突围与产业落地
星火X2.6(Spark-X2.6)是科大讯飞推出的端云一体基座大模型,基于全国产算力完成从训练到推理的完整闭环,是国产AI在安全性与性价比层面的关键布局。云端293-A30B版本支持百万token级超长上下文,输入价格仅为0.9元/百万tokens,显著低于DeepSeek-V4.1-Flash;端侧星火X2.6-4B已全面开源,在办公文档处理、工具协同等智能体任务上表现突出。系统依据任务难度与...
MemT 1.0 – 记忆张量开源的业内首个记忆原生基座模型
MemT 1.0是记忆张量(MemTensor)团队推出的业内首个记忆原生(Memory-Native)基座模型,已全面开源。该模型摒弃了传统大语言模型依赖外部检索或重复注入历史文本的方式,而是将历史信息编码为可持续更新的内部记忆状态,使模型能够在推理计算过程中直接读写记忆。MemT 1.0包含Flash(288B参数/17B激活)和Nano(36B参数/3B激活)两个版本,在11项记忆基准上位列...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。