
Spatial-TTT – 清华联合混元开源的流式视觉空间智能框架
导读摘要:
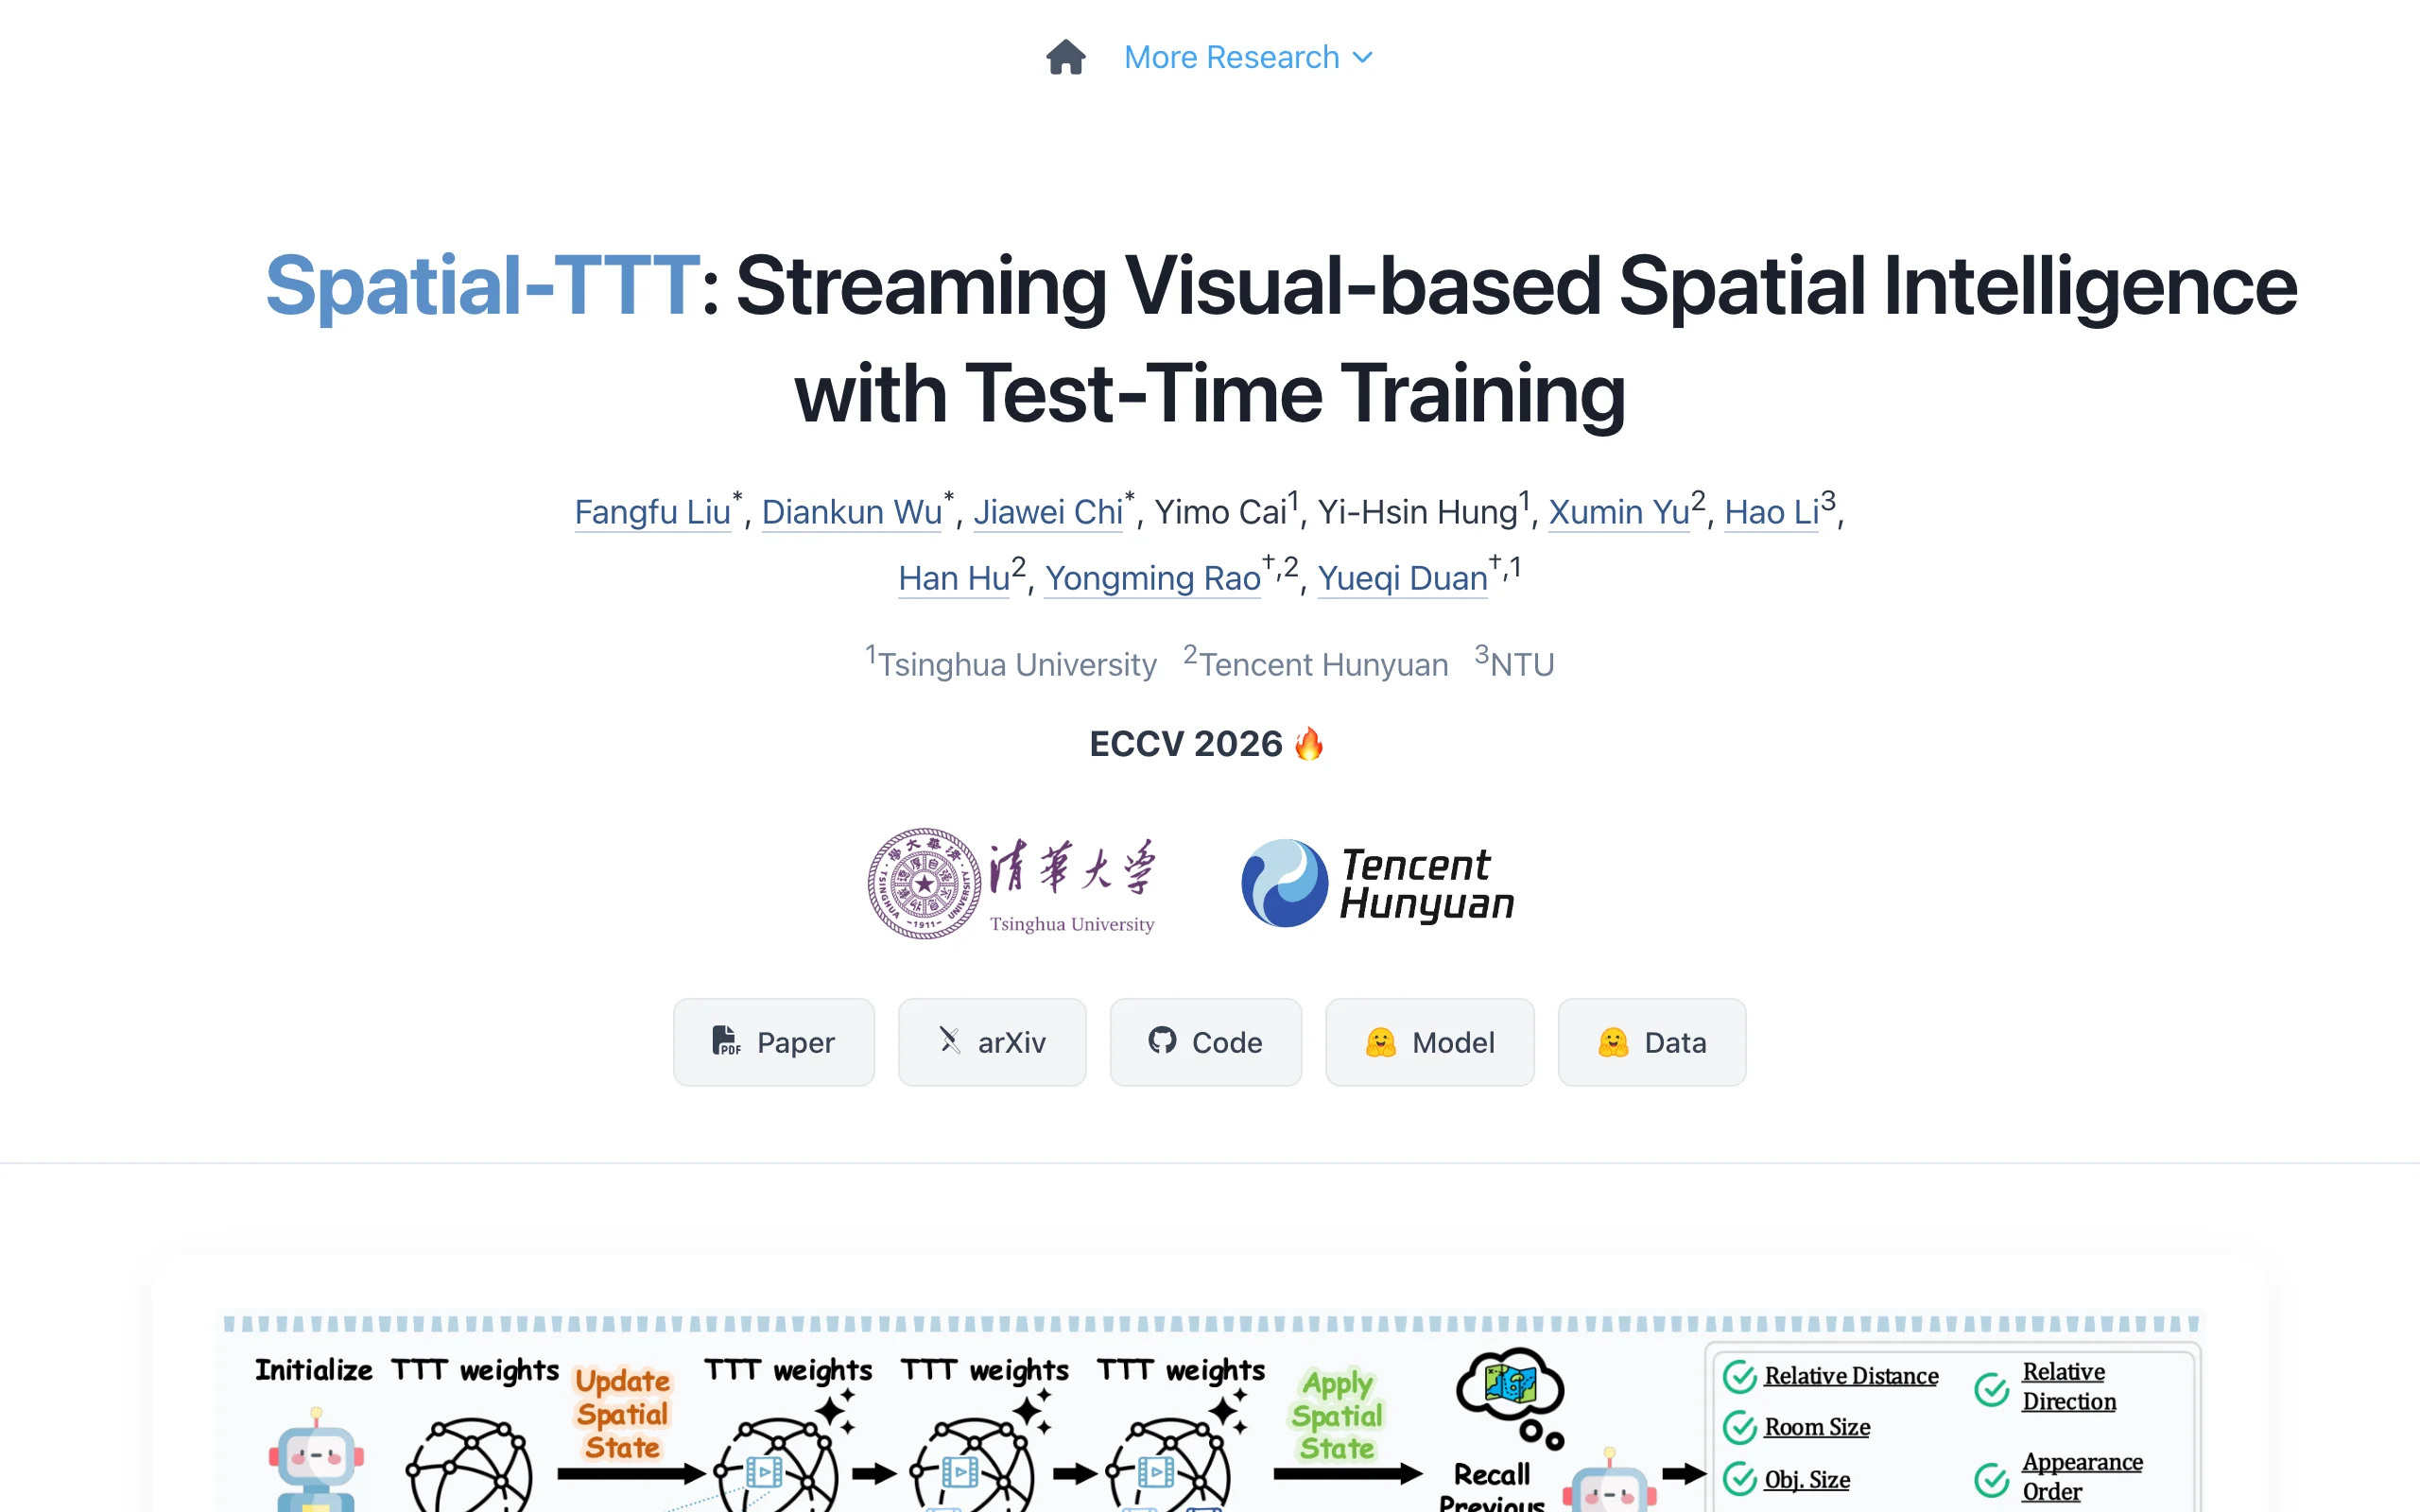
Spatial-TTT是由清华大学、腾讯混元与南洋理工大学联合推出的流式视觉空间智能框架。该框架仅2B参数,通过Test-Time Training(TTT)技术,在观看视频流的过程中持续更新内部空间记忆,实现对长达120分钟视频的空间推理。在VSI-Bench、MindCube-Tiny等多个基准上,其表现超过GPT-5、Gemini-3-pro等闭源大模型,峰值显存占用比行业领先方案节省超40...
1. Spatial-TTT是什么
Spatial-TTT是由清华大学、腾讯混元与南洋理工大学联合推出的流式视觉空间智能框架。该框架仅2B参数,通过Test-Time Training(TTT)技术,在观看视频流的过程中持续更新内部空间记忆,实现对长达120分钟视频的空间推理。在VSI-Bench、MindCube-Tiny等多个基准上,其表现超过GPT-5、Gemini-3-pro等闭源大模型,峰值显存占用比行业领先方案节省超40%,为物理世界Agent的长期空间感知提供了高效、可扩展的解决方案。
技术定位与领域: Spatial-TTT属于计算机视觉与自然语言处理交叉的视觉空间智能领域,专门针对长视频流中的空间关系理解与推理任务。其独特定位在于将Test-Time Training与流式处理结合,以极小的参数量实现超越巨大闭源模型的空间推理能力,打破了传统模型依赖长上下文窗口或离线全量处理的范式。
研发背景: 研究团队来自清华大学自然语言处理实验室(THU-SI)、腾讯混元大模型团队及南洋理工大学。团队在视觉-语言模型、高效推理和空间智能方面有深厚积累,旨在解决现有模型在处理超长视频时显存爆炸、空间记忆丢失以及无法在线更新等核心痛点。腾讯混元的加入为框架提供了大规模训练数据和工程优化支持。
核心价值: Spatial-TTT解决了物理Agent(如机器人、自动驾驶车辆)在长时间运行中持续理解三维空间这一关键难题。其核心价值在于:2B参数即可在多个空间推理基准上击败闭源巨头,同时显存占用降低40%以上,使得空间智能模型可以在消费级GPU上部署,极大降低了落地门槛。更重要的是,它通过在线更新的参数化空间状态替代了无限膨胀的上下文窗口,为长期自主Agent提供了可持续的内部空间记忆。
技术特点: 采用混合式TTT架构,以3:1比例在解码器中交错插入TTT层与标准自注意力锚定层,既实现了线性复杂度的记忆扩展,又保留了预训练模型的语义理解能力。引入轻量级3D时空卷积的TTT分支,使快速权重学习的是时空上下文到时空上下文的预测关系,而非孤立token映射。两阶段空间感知渐进训练(稠密描述+空间VQA)确保模型先形成全局3D意识,再强化流式推理能力。
2. 主要功能
流式空间记忆维护: 将视频流分块输入,每处理一个chunk后在线更新模型参数(fast weights),持续累积3D空间证据,无需一次性加载全段视频。这种机制使得模型可以像人类一样在观看过程中不断修正和丰富对空间的理解,而非简单缓存所有帧。
长时程空间推理: 支持多种空间理解任务,包括相对/绝对距离估计、物体计数与大小判断、房间尺寸感知、方向识别、路径规划与外观顺序推理。例如,模型可以回答“从红色蜡烛出发面向窗户,如何走到门口”这类多步空间查询,体现了对三维布局的深度理解。
超长视频处理: 可稳定处理10分钟至120分钟的连续视频流,在VSI-SUPER长期记忆基准上保持性能不衰减。相比之下,传统长上下文模型在超过30分钟的视频上往往出现性能崩塌或显存溢出(OOM),Spatial-TTT凭借参数化空间状态实现了真正的线性扩展。
高效推理: 1024帧输入下峰值显存仅11.9GB,理论计算量799.4 TFLOPs,显著低于Gemini-3-pro的21.2GB和1403.1 TFLOPs。这意味着在单张RTX 4090(24GB显存)上即可运行1024帧的空间推理,而竞品需要A100或更高配置。
空间预测机制: 在TTT分支中引入轻量级3D时空卷积,使快速权重学习的是时空上下文到时空上下文的预测关系,而非孤立token的映射。这一设计稳定捕捉了几何对应、视角变化与时间连续性,避免了传统逐点线性投影丢失局部几何结构的问题。
两阶段渐进训练: 第一阶段使用稠密3D场景描述数据(覆盖全局语境、物体类别与数量、空间关系)训练模型“记住整个空间”,形成全局3D意识;第二阶段用数百万条空间VQA数据强化流式推理能力。这种训练策略确保了快速权重能够学习全局更新,而非仅对局部问答做出响应。
3. 如何使用
环境准备: 访问GitHub仓库((链接待官方发布后更新) 3.8+环境,建议使用Conda创建独立虚拟环境。依赖包括PyTorch 2.0+、transformers、opencv-python等,可通过
pip install -r requirements.txt一键安装。推荐使用NVIDIA GPU(至少8GB显存),支持CUDA 11.8及以上版本。模型加载: 下载预训练的Spatial-TTT-2B权重(可从HuggingFace模型库获取)。使用提供的加载脚本初始化模型,同时初始化TTT快速权重(fast weights)。快速权重初始为零矩阵,随后在视频流处理过程中逐步更新。
输入视频流: 将长视频切分为连续chunk(建议每chunk 16-32帧,根据显存调整)。使用
process_chunk函数逐块输入模型。每处理完一个chunk,模型自动更新内部空间状态。注意保持视频帧的时序顺序,避免乱序输入破坏空间记忆的一致性。空间问答: 在处理完整个视频流(或部分视频)后,输入自然语言空间问题。模型基于累积的空间记忆生成答案。问题格式建议包含明确的空间关系描述,如“从沙发出发面向电视,走到门口需要多少步?”模型会输出距离估计、方向指示或路径步骤。
扩展应用: 可接入机器人、自动驾驶或AR设备的实时视频流。只需将摄像头帧持续送入模型,并定期(如每5秒)触发空间问答。需要根据实际帧率调整chunk大小,确保实时性。最佳实践:在移动端部署时,可启用模型量化(如INT8)以降低显存和延迟。
注意事项: 首次运行时,模型需要一定预热时间(约30秒)初始化快速权重。对于超过120分钟的视频,建议分段处理并定期保存空间状态快照,以便恢复。目前框架仅支持单GPU推理,多卡并行支持正在开发中。
4. 优缺点分析
| 优点 |
|---|
| 小参数超越大模型: 仅2B参数,在VSI-Bench、MindCube-Tiny等基准上超越GPT-5、Gemini-3-pro等闭源模型,MindCube-Tiny准确率领先Gemini-3-pro 12个百分点,证明了高效架构的有效性。 |
| 显存效率极高: 1024帧下峰值显存仅11.9GB,比Gemini-3-pro的21.2GB节省44%,且带显式几何编码器的对比模型在同等帧数下已无法运行,使得消费级GPU可用。 |
| 线性扩展性: 显存与计算量随视频长度线性增长,避免传统长上下文模型的平方级复杂度爆炸,理论上可处理任意长度视频(受限于存储和推理时间)。 |
| 开源免费: 采用MIT许可证(待确认,原文未明确,但仓库通常为开源协议),代码完全公开,支持商业和学术用途,降低了空间智能技术的使用门槛。 |
5. 同类工具对比
| 对比维度 | Spatial-TTT | Gemini-3-pro | GPT-5 |
|---|---|---|---|
| 参数规模 | 2B(开源) | 闭源,未公开 | 闭源,未公开 |
| 核心机制 | TTT快速权重 + 3D时空卷积 + 混合注意力 | 长上下文窗口 + 多模态预训练 | 长上下文窗口 + 多模态预训练 |
| VSI-Bench平均分 | 64.4 | 56.0 | 未公开(但Spatial-TTT声称超越) |
| MindCube-Tiny准确率 | 76.2% | 63.9% | 未公开 |
| 120分钟视频处理 | 稳定运行(Recall 30.0 / Count 38.4) | 未公开支持,长视频易OOM | 未公开支持,长视频易性能崩塌 |
| 1024帧峰值显存 | 11.9GB | 21.2GB+ | 约25GB(估计) |
| 1024帧计算量 | 799.4 TFLOPs | 1403.1 TFLOPs | 约1600 TFLOPs(估计) |
| 空间记忆方式 | 在线更新参数化空间状态 | 依赖长上下文窗口缓存 | 依赖长上下文窗口缓存 |
| 开源协议 | MIT(待官方确认) | 闭源 | 闭源 |
选型建议: 对于需要长期自主运行的空间智能Agent(如服务机器人、自动驾驶),Spatial-TTT是当前最优选择。其2B参数带来的低显存占用和线性扩展性使其可以在边缘设备上部署,而TTT在线更新机制避免了传统模型在长视频中的性能衰减。若预算充足且无需本地部署,Gemini-3-pro在多模态通用任务上仍有优势,但在纯空间推理上已被Spatial-TTT超越。
对于学术研究者,Spatial-TTT的开源特性提供了宝贵的基线,但其训练数据未公开,可能需要自行构建。VideoLLaMA 2虽然参数更大、任务覆盖面更广,但在长视频空间推理方面缺乏专门设计,更适合短片段视频理解。总体而言,Spatial-TTT在空间智能这一垂直领域树立了新的标杆,尤其适合对显存和实时性有严格要求的场景。
6. 编辑点评
Spatial-TTT在技术创新性上堪称惊艳。它巧妙地将Test-Time Training从模型自适应领域引入视觉空间推理,通过混合注意力架构解决了纯TTT破坏预训练能力的痛点,同时利用3D时空卷积补全了空间结构的局部几何信息。这种“在推理中学习”的范式,相比于依赖无限膨胀上下文窗口的GPT-5和Gemini-3-pro,无疑是更优雅且更高效的解决方案。从实用价值看,2B参数在消费级GPU上即可运行1024帧视频的空间推理,显存仅11.9GB,这意味着开发者无需昂贵的A100即可部署空间智能应用,极大地降低了技术门槛。在VSI-Bench上超越闭源巨头12个百分点,更是证明了小模型在特定领域通过精巧设计可以碾压大模型。
适用人群方面,Spatial-TTT特别适合机器人、自动驾驶、AR/VR领域的研发团队,以及从事长视频空间分析的研究人员。对于希望将空间感知能力集成到产品中的企业,该框架提供了可落地的开源基线。未来发展潜力巨大:随着TTT机制在更多视觉任务上的验证,以及训练数据的开源,Spatial-TTT有望成为物理世界Agent的标准空间记忆模块。目前的主要短板在于训练数据未公开和实时性优化空间,但团队已表示将逐步完善生态。
7. 应用场景
机器人导航: 服务机器人或家用机器人在房间中持续移动时,实时更新空间地图,回答“沙发相对于窗户的位置”或规划到达目标点的路径。Spatial-TTT的流式记忆维护使得机器人可以在运行过程中不断修正地图,无需预先建图或SLAM系统,降低硬件成本。
自动驾驶: 车辆在长时程行驶中持续积累道路、路口与障碍物的空间关系,支持复杂的方向判断与距离估计。例如,在高速公路上行驶30分钟后,模型可以回答“前方第三个出口距离多远?”或“刚才经过的加油站位于左侧还是右侧?”,为决策提供空间上下文。
AR/VR空间交互: 头显设备在用户使用过程中持续理解环境布局,实现虚实融合的空间锚定与物体关系查询。用户佩戴AR眼镜进入陌生房间,设备自动识别并记忆家具位置,用户可询问“我的背包在哪个房间?”或“离我最近的椅子在哪里?”,系统基于空间记忆给出精确指示。
智能监控与安防: 对长时间视频流进行在线空间分析,追踪物体出现顺序、计数与位置变化,无需离线全量处理。例如,在商场监控中,模型可实时回答“今天上午10点到12点,有多少人进入A区域?他们平均停留时间是多少?”或“B柜台前的排队长度是否超过5人?”,提升安防效率。
8. 常见问题FAQ
Q:Spatial-TTT需要多少显存才能运行?
A:在1024帧输入下,峰值显存约11.9GB。因此推荐使用至少16GB显存的GPU(如RTX 4080/4090、A4000)。若处理更短视频(如512帧),显存需求可降至8GB左右,RTX 3070也可运行。若显存不足,可减小每chunk的帧数或使用模型量化。
Q:模型是否支持实时视频流输入?
A:支持。只需将摄像头帧按chunk送入模型,并设置合适的chunk大小(如16帧)。在RTX 4090上,处理16帧约需0.8秒,基本可达到12.5fps的实时性。若需30fps实时,建议使用INT8量化或更小的chunk(8帧),但空间记忆精度可能略有下降。
Q:训练数据是否会开源?
A:目前官方尚未公布训练数据开源计划。稠密3D场景描述数据和空间VQA数据集属于腾讯混元内部资源,但团队表示正在整理可公开版本,预计2025年下半年发布。研究者可先使用模型进行推理,或自行构建类似数据进行微调。
Q:Spatial-TTT能否处理360度全景视频?
A:框架本身支持任意视频格式,但TTT分支中的3D时空卷积假设了常规透视投影。对于360度全景视频,需要先将其展开为等距柱状投影或立方体贴图,再送入模型。官方未提供专门优化,但理论上可行。
Q:如何将Spatial-TTT集成到机器人系统中?
A:建议将模型封装为ROS节点,订阅摄像头话题,每收到一定数量帧后触发推理。空间状态可保存为二进制文件,便于多节点共享。官方提供了示例代码(在GitHub的examples/robot_integration.py),展示了与ROS2的集成方法。
Q:模型支持多语言空间问答吗?
A:当前版本主要针对英文训练,对英文空间描述(如“in front of”、“to the left”)表现最佳。中文问答准确率约下降5-10个百分点。用户可使用多语言微调工具(如LoRA)在中文空间数据上微调,预计1000条数据即可显著提升中文性能。
9. 项目地址
- 项目官网:https://liuff19.github.io/Spatial-TTT/
- GitHub仓库:https://github.com/THU-SI/Spatial-TTT
- HuggingFace模型库:https://huggingface.co/collections/THU-SI/spatial-ttt
- arXiv技术论文:https://arxiv.org/pdf/2603.12255
- 官方组织主页(THU-SI):https://github.com/THU-SI
相关 AI 模型文章
ip-as-logo-skill:开源 Agent Skill,用几何约束生成高辨识度 IP 吉祥物头像
ip-as-logo-skill 是一个开源的 Agent Skill,专用于生成极简可爱的 IP 吉祥物头像。该技能通过 4–7 个圆润几何形状构建清晰轮廓,配合"两主色加一背景"的三色约束,确保角色在缩小至 32×32 像素的头像场景中依然保持可辨识度。其工作流程为先输出 3 个设计方向供用户确认,再批量生成 6 张候选图。该 Skill 需搭配 Codex、豆包等兼容 Agent 及 GPT...
OpenDots 深度评测:CopilotKit 开源的 AI 同事工作区,能否成为 OpenAI Dots 的替代方案?
OpenDots 是由 CopilotKit 推出的开源 AI 同事工作区模板,支持用户完全自行托管。该工具允许用户创建具有独立角色、工具权限和专属电脑的 AI 员工(称为 Dots),并通过 AG-UI 协议接入各类大语言模型与 MCP 服务。OpenDots 的核心设计理念是将 AI 从单次对话助手升级为长期在线、可执行真实任务、具备工作记忆的协作同事,其功能覆盖文档沉淀、实时操作监控、人工审...
QwenGyre – 阿里千问推出的超长程智能体在线强化学习框架
QwenGyre是阿里千问团队推出的面向超长程智能体任务的在线强化学习框架,专为单次执行约70万token、持续数小时乃至更长时间的复杂任务设计。该框架通过弹性调度机制在任务不中断的前提下将空闲GPU资源在采样与训练之间动态切换,并借助轨迹处理技术保留真实上下文、评估部分成果以及去重共享前缀以控制训练成本。在Qwen3.8-2.4T旗舰模型上,QwenGyre仅用48步便将NL2RepoBench...
Muse Wonder – Meta 超级智能实验室推出的前沿模型系列
Muse Wonder 是 Meta 超级智能实验室推出的前沿模型系列,建立在 Muse Spark 基础之上,具备跨对话长期记忆与自主坚持长任务的能力。该模型在遇到执行障碍时会主动更换方案,并在重要操作前先与用户确认,覆盖保险理赔、法律金融等专家场景及编程任务。模型分为标准版与完整版两个版本,标准版通过 Meta API 和 Muse Code 开放,完整版仅面向 Muse Code 订阅用户。...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。