
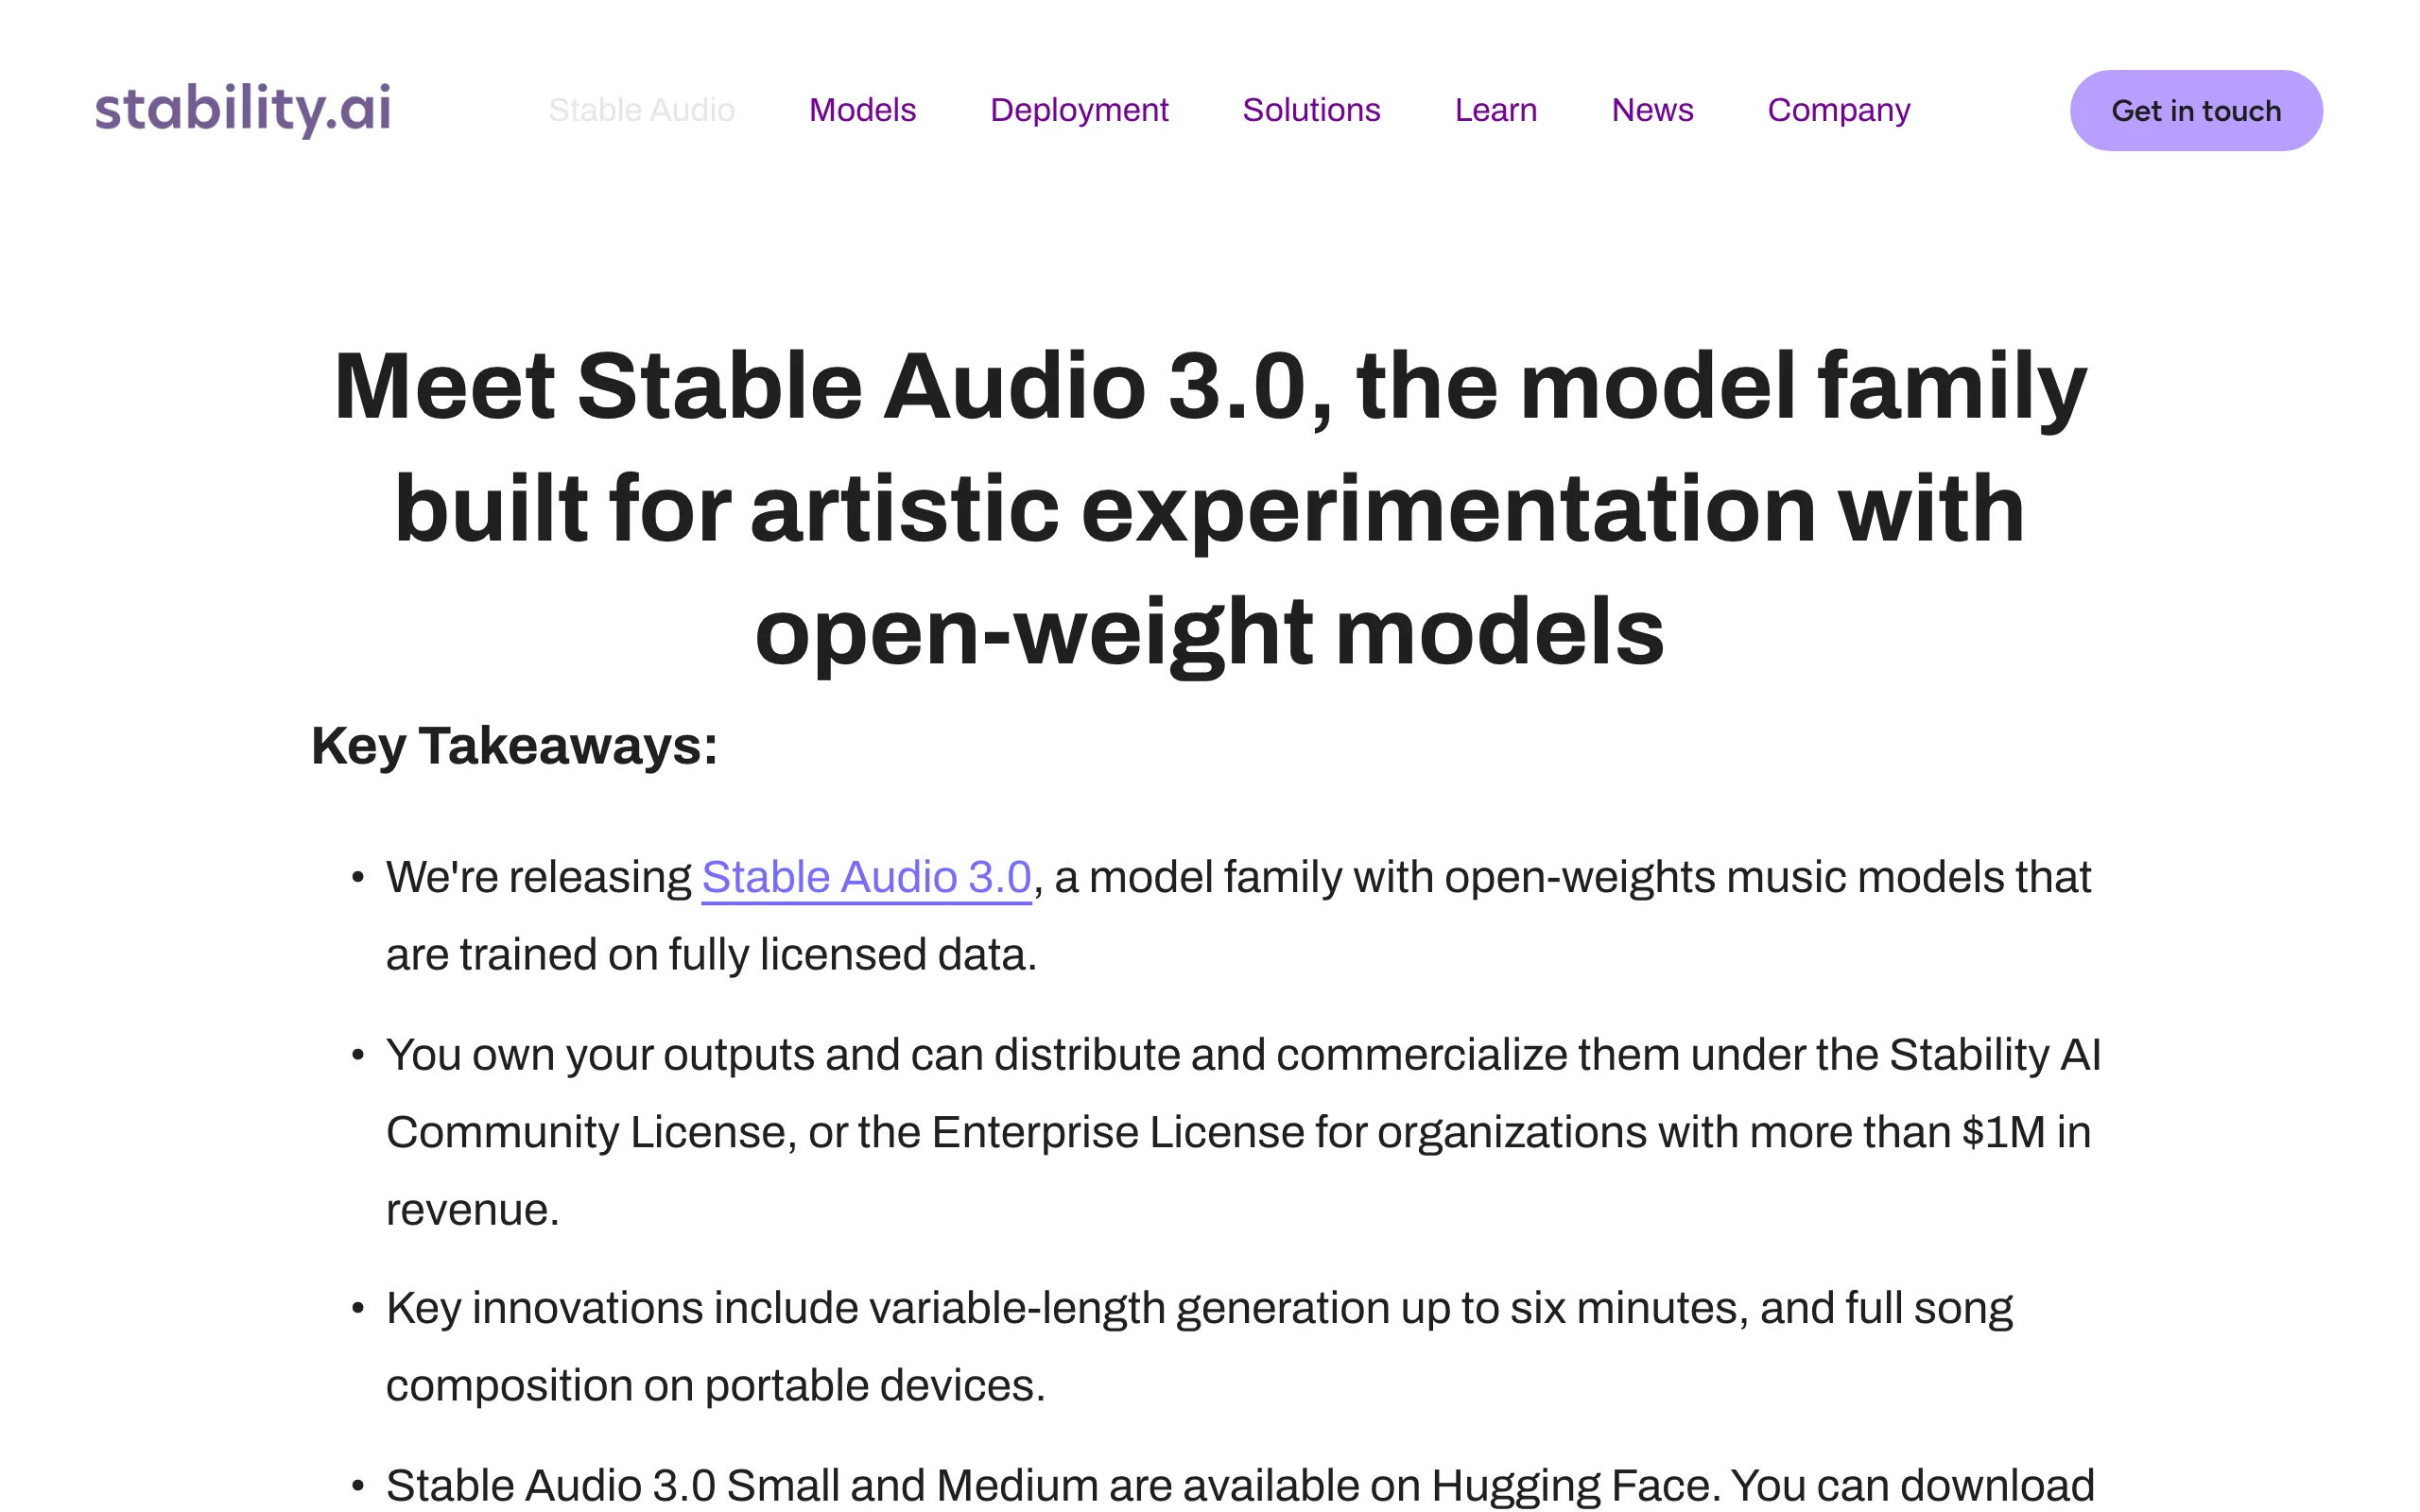
Stable Audio 3 – Stability AI 开源的音频生成模型系列
导读摘要:
Stable Audio 3是Stability AI推出的新一代开源音频生成模型系列,基于流匹配潜空间扩散架构,支持文本转音乐与音效、音频编辑及续写。该系列提供Small、Medium、Large三种规格模型,其中Small版本可在MacBook Pro等消费级设备上本地运行并生成最长2分钟音频,Medium与Large则支持超过6分钟的高质量音频生成。全系模型采用完全授权数据训练,开放Smal...
1. Stable Audio 3是什么
Stable Audio 3是Stability AI推出的新一代开源音频生成模型系列,基于流匹配潜空间扩散架构,支持文本转音乐与音效、音频编辑及续写。该系列提供Small、Medium、Large三种规格模型,其中Small版本可在MacBook Pro等消费级设备上本地运行并生成最长2分钟音频,Medium与Large则支持超过6分钟的高质量音频生成。全系模型采用完全授权数据训练,开放Small与Medium权重,支持LoRA微调,在H200 GPU上实现不到2秒的快速推理。
技术定位与领域: Stable Audio 3属于生成式AI音频领域,具体涵盖文本条件音频生成、音频编辑与续写。其核心定位是面向专业音乐制作人、音效设计师和内容创作者的工业化音频生成工具,填补了开源音频模型在长时长、高质量、可编辑方面的空白。
研发背景: 由Stability AI团队开发,该团队此前已推出Stable Audio Open和Stable Audio 2.0等系列模型。研发动机源于现有开源音频模型在生成时长、编辑能力和本地部署方面的局限性——前代Stable Audio Open仅支持47秒固定长度生成,且缺乏编辑功能。Stable Audio 3旨在通过流匹配架构和对抗后训练技术,突破这些瓶颈。
核心价值: 解决了开源音频模型无法生成长音频、无法进行局部编辑、无法在消费级硬件上运行的三大痛点。其核心创新在于首次实现超过6分钟的高质量音频生成、支持单段/多段掩码编辑与续写、以及Small模型可在MacBook Pro上完全离线运行,为创作者提供了前所未有的灵活性和隐私保护。
技术特点: 基于SAME语义-声学自编码器实现4096倍下采样,将44.1kHz立体声映射至256维潜空间;采用流匹配训练范式配合小批量最优传输耦合,提升训练稳定性;引入差分注意力Transformer增强长序列建模精度;通过对抗后训练将推理步数压缩至极低水平,实现秒级推理。
2. 主要功能
文本转音频生成: 用户输入英文文本提示词,可生成器乐音乐或环境音效,并精确控制输出时长至秒级。该功能基于流匹配潜空间扩散架构,将文本语义映射至音频潜空间,支持从5秒到6分钟以上的任意时长生成,显著优于传统固定长度模型。
可变长度音频合成: 模型按请求时长比例分配潜空间序列长度,避免固定最大长度导致的计算与内存浪费。这一机制突破传统扩散模型的固定序列限制,使短音频生成成本大幅降低,同时长音频生成质量不受影响,在推理效率和生成质量之间实现了最优平衡。
音频局部编辑修复: 通过单段或多段掩码实现音频的局部重绘(inpainting),在保留原始片段的同时替换目标区域。该功能无需额外训练数据标注,直接基于随机掩码策略工作,适用于修正录音中的瑕疵、替换特定音轨或调整音乐段落。
音频智能续写扩展: 采用因果掩码机制对现有音频进行连贯延续,将短录音扩展为超过6分钟的完整作品。该功能在音乐创作场景中尤为实用,用户可录制一段动机旋律,模型将自动生成风格一致的后续段落,保持和声、节奏与音色的自然过渡。
LoRA风格微调: 首次开放LoRA训练文档与Small、Medium权重,支持用户使用自有音频库进行高效的自定义风格适配。通过低秩适配技术,用户可在消费级GPU上以极低显存消耗完成微调,生成具有特定乐器音色、音乐流派或音效风格的定制模型。
全链路本地部署: 3.0 Small支持在MacBook Pro等消费级设备上完全离线运行,实现无需网络的隐私化创作。该功能基于模型量化与推理优化技术,将参数量级控制在适合移动端和笔记本硬件的范围,同时保持生成质量不显著下降。
多规格模型选择: 提供Small、Medium、Large三种规格,分别面向不同硬件场景。Small版本适合消费级设备,生成2分钟音频;Medium与Large版本面向专业工作站,支持超过6分钟的高质量生成,用户可根据硬件配置和任务复杂度灵活选择。
3. 如何使用
获取模型权重: 访问Hugging Face的
Stability-AI/stable-audio-3仓库,下载3.0 Small、Small SFX或Medium的权重文件。注意Large模型权重暂未开放,仅可通过Stability AI API访问。配置运行环境: 克隆
stable-audio-tools代码仓库(git clone https://github.com/Stability-AI/stable-audio-tools.git),安装依赖项。确保PyTorch版本≥2.0,CUDA≥11.8(NVIDIA GPU)或Apple Metal后端(Mac设备)。建议使用Python 3.10及以上版本。加载模型与编码器: 在Python脚本中实例化SAME自编码器与对应规模的扩散Transformer。代码示例:
from stable_audio_tools import create_model_from_config
model, sample_rate = create_model_from_config("path/to/config.yaml")
model.load_state_dict(torch.load("path/to/weights.pt"))
model.eval()
编写生成提示: 输入描述目标音频风格、乐器与情绪的英文提示词,并设置精确的输出时长(秒数)。例如:
"A melodic piano piece with soft strings, upbeat tempo, 30 seconds"。提示词应包含风格、乐器、节奏、情绪等关键要素。执行推理生成: 调用模型生成接口,传入提示词和时长参数。模型将根据时长参数执行可变长度推理,输出44.1kHz立体声WAV文件。在MacBook Pro M4上,生成30秒音频约需5-10秒;在H200 GPU上,生成6分20秒音频不到2秒。
音频编辑与续写: 对于局部编辑,提供原始音频和掩码数组(1表示保留,0表示替换区域),调用inpainting方法。对于续写,使用因果掩码指定续写起点,模型将自动生成后续内容。
4. 优缺点分析
| 优点 |
|---|
| 完全授权商用友好: 全系模型基于licensed与Creative Commons数据训练,Community License允许用户自由拥有并商用生成内容,免除版权顾虑。 |
| 消费级硬件原生支持: 3.0 Small开放权重且可在MacBook Pro M4上离线运行,是首款支持本地全曲作曲的轻量级模型,满足隐私敏感场景。 |
| 超长高质量生成: Medium与Large模型支持超过6分钟的高质量音频生成,较前代Stable Audio Open的47秒上限实现数量级突破,填补市场空白。 |
| 极致推理效率: 经对抗后训练优化,Large模型在H200 GPU上生成6分20秒音频耗时不到2秒,MacBook Pro上仅需数秒,近乎实时生成。 |
| 零标注灵活编辑: 无需额外训练数据标注即可通过随机与因果掩码实现单段、多段编辑及续写,直接融入真实创作工作流,降低使用门槛。 |
5. 同类工具对比
| 对比维度 | Stable Audio 3 | Stable Audio Open | MusicGen |
|---|---|---|---|
| 开发团队 | Stability AI | Stability AI | Meta (FAIR) |
| 模型架构 | 流匹配潜空间扩散 + SAME自编码器 | 潜空间扩散 | 自回归 + EnCodec编码器 |
| 最大生成时长 | 6分20秒(Medium/Large) | 47秒(固定长度) | 约2分钟 |
| 可变长度支持 | 原生秒级控制,潜空间长度与时长成正比 | 不支持(固定47秒) | 有限支持(需截断或填充) |
| 消费级本地运行 | Small可在MacBook Pro运行(M4) | 需独立GPU(≥8GB显存) | 需独立GPU(≥4GB显存) |
| 开放权重范围 | Small / Medium / Small SFX | Small | Small / Medium / Large |
| 音频编辑能力 | 单段/多段掩码编辑 + 因果续写 | 不支持 | 不支持 |
| 推理速度(长音频) | <2秒(H200,6分20秒) | 较慢(47秒需数秒) | 中等(2分钟需数秒) |
| 微调支持 | LoRA微调(开放文档与权重) | 不支持 | 不支持 |
| 许可协议 | Community License(商用友好) | Creative Commons NC | MIT(非商用限制) |
选型建议: 对于需要生成长音频(超过2分钟)或进行音频编辑/续写的专业用户,Stable Audio 3是唯一选择,其可变长度推理和编辑功能在开源模型中独树一帜。对于仅需短音频生成(如游戏音效、短视频配乐)且对硬件要求较低的用户,MusicGen因其成熟的社区生态和丰富的预训练模型可能更易上手。对于需要在消费级设备上完全离线运行的隐私敏感场景,Stable Audio 3 Small版本是当前唯一支持MacBook Pro本地运行的方案。
6. 编辑点评
Stable Audio 3在技术创新性上展现了显著的突破,尤其是在音频生成领域的“长时长”和“可编辑”两个核心难题上。其流匹配潜空间扩散架构配合SAME自编码器,实现了4096倍的下采样率,这在开源音频模型中尚属首次。对抗后训练技术将推理步数压缩至极致,使Large模型在H200上生成6分20秒音频仅需不到2秒,这一性能指标在同类产品中处于绝对领先地位。
从实用价值来看,Stable Audio 3最突出的贡献在于将专业级音频生成能力下放至消费级硬件。Small模型可在MacBook Pro上离线运行,这意味着独立音乐人、小型工作室甚至业余爱好者都能以零成本接触高质量音频生成技术。LoRA微调功能的开放进一步降低了定制化门槛,用户无需大规模数据集即可训练专属风格模型。
适用人群定位明确:专业音乐制作人可通过Medium/Large模型获得高效的创作辅助;音效设计师可利用编辑和续写功能快速迭代;隐私敏感用户可依赖Small模型实现完全离线工作。对于希望将AI音频集成到商业产品的开发者,Community License的商用友好政策也提供了法律保障。
未来发展潜力巨大。当前Large模型未开源是一个遗憾,但Stability AI已承诺未来将开放更多规格。随着社区生态的成熟和第三方工具链的完善,Stable Audio 3有望成为开源音频生成领域的事实标准。建议团队优先完善中文支持、优化编辑精度,并推动更多行业合作案例。
7. 应用场景
游戏与影视音效: 快速生成交互音效、环境氛围音与背景音乐,通过局部编辑精确匹配画面节奏与情感需求。例如,游戏开发者可为不同场景(森林、城市、战斗)生成动态音效,并通过续写功能扩展至完整关卡所需时长。
短视频与广告配乐: 按精确时长生成定制化器乐片段,避免手动裁剪,直接适配短视频、宣传片与播客转场。用户输入“30秒轻快电子音乐”即可获得精确时长的输出,无需后期剪辑。
音乐创作辅助: 帮助音乐人生成动机灵感、扩展未完成草稿或替换歌曲局部段落,显著加速编曲迭代周期。例如,录制一段吉他riff后,使用续写功能自动生成完整的和声进行和打击乐部分。
本地隐私敏感创作: 3.0 Small支持完全离线运行,满足影视工作室、独立音乐人对数据隐私与网络隔离的严格要求。用户无需将音频数据上传至云端,所有处理均在本地完成,适合商业机密项目。
个性化品牌声音: 通过LoRA微调企业自有音频资产,打造一致的UI音效、品牌提示音与专属音乐风格。例如,科技公司可用自有录音库微调模型,生成具有品牌辨识度的通知音和背景音乐。
8. 常见问题FAQ
Q:Stable Audio 3与Stable Audio Open的主要区别是什么?
A:Stable Audio 3在架构、功能和性能上均有显著升级。它采用流匹配潜空间扩散替代传统潜空间扩散,支持可变长度生成(从秒级到6分钟以上),而Stable Audio Open仅支持固定47秒。此外,Stable Audio 3新增了音频编辑、续写和LoRA微调功能,Small模型还支持MacBook Pro本地运行。
Q:能否在MacBook Air上运行Stable Audio 3 Small?
A:可以,但性能受限于硬件配置。Stable Audio 3 Small在MacBook Pro M4上表现最佳,在MacBook Air M2/M3上也能运行,但生成速度较慢(30秒音频约需15-20秒)。建议确保系统内存≥16GB,并关闭其他占用GPU资源的应用。
Q:生成的音频是否可用于商业项目?
A:是的。Stable Audio 3采用Community License,允许用户自由拥有并商用生成内容,无需向Stability AI支付额外费用。但需注意,模型训练数据基于licensed与Creative Commons数据,用户应自行确认最终生成内容不侵犯第三方版权。
Q:如何解决中文提示词生成效果不佳的问题?
A:当前模型主要针对英文场景优化,中文支持有限。建议将中文提示词翻译为英文,并添加风格、乐器、情绪等具体描述。例如,“悲伤的钢琴曲”可译为“A melancholic piano piece with slow tempo”。未来版本可能会增加多语言支持。
Q:LoRA微调需要多少训练数据和显存?
A:LoRA微调通常需要至少10-20条音频样本(每条5-30秒),显存需求取决于模型规格。对于Small模型,在8GB显存的GPU上即可完成微调;Medium模型建议使用16GB以上显存。详细训练文档可在GitHub仓库中找到。
9. 项目地址
- 项目官网: https://stability.ai/news-updates/meet-stable-audio-3-the-model-family-built-for-artistic-experimentation-with-open-weight-models
- GitHub仓库: https://github.com/Stability-AI/stable-audio-3
- HuggingFace模型库: https://huggingface.co/collections/stabilityai/stable-audio-3
- arXiv技术论文: https://arxiv.org/pdf/2605.17991
相关推荐
科大讯飞 SparkAudio 1.0 深度评测:全国产算力驱动的星火语音基座大模型
SparkAudio 1.0 是科大讯飞于 2026 年 10 月 22 日在全球 1024 开发者节上发布的星火语音基座大模型,基于全国产算力完成训练,围绕语音识别、同传翻译、实时交互三大核心方向实现能力跃升,并拓展了音频理解、情绪识别、实时说话人分离与环境声理解等进阶能力。该模型通过半监督音频编码器、动态分段端到端建模、双范式协同解码三项技术创新,实现了整体效果提升 20%、响应时延降低 15...
Eleven Realtime:ElevenLabs 一体化语音 Agent 模型的架构突破与工程实践
Eleven Realtime 是 ElevenLabs 推出的一体化语音 Agent 模型系列,包含 v1 Mini 与 v1 Max 两个版本,核心设计思想是将语音识别(ASR)、语言模型推理、工具调用与语音合成(TTS)整合进单一模型,替代传统方案中多组件串联的复杂架构。该系列支持 90 多种语言,并可调用 ElevenLabs 声音库中 17,000 余种音色,v1 Max 在保持 98....
Ming-3.0:蚂蚁百灵开源全链路语音模型家族深度评测
Ming-3.0是蚂蚁集团百灵大模型团队开源的全链路语音系列模型,围绕语音合成(TTS)、音频理解与对话(Audio)、语音识别(ASR)三类核心任务推出五款模型。该系列以"合成+理解+识别"一体化能力覆盖语音应用全流程,其中TTS系列支持独创的"导演模式"精细控制情绪、节奏与重音,Audio系列可端到端理解长录音并结构化输出,ASR系列支持热词注入与方言识别。模型已落地支付宝、阿福APP等蚂蚁内...
GPT-Live-1.1 – OpenAI 推出的 ChatGPT 一代语音模型
GPT-Live-1.1是OpenAI于2025年推出的ChatGPT新一代语音模型,接替上一代GPT-Live-1成为语音交互的「前台引擎」,同时以轻量版GPT-Live-1.1 Quip替代原mini版本。该模型延续了经典的全双工交互架构,模型无需等待用户说完即可持续采集语音流,实时判断停顿、打断与语速变化,动态决定回应时机,支持用户随时插话或改变提问方向,使对话节奏接近真人交流。在复杂任务处...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。