
TabFM – 谷歌开源的零样本表格基础模型

导读摘要:
TabFM是由Google Research推出的零样本表格基础模型,专为混合数值与类别特征的结构化数据设计,支持分类(最多10类)和回归任务。模型基于结构因果模型(SCM)生成的数百亿合成表格数据预训练,无需微调或超参数搜索,仅以训练数据作为上下文进行单次前向预测即可完成推断。在TabArena基准的51个真实数据集上,TabFM的零样本性能超越了经过大量超参数调优的梯度提升树等强基线模型。该项...
1. TabFM是什么
TabFM是由Google Research推出的零样本表格基础模型,专为混合数值与类别特征的结构化数据设计,支持分类(最多10类)和回归任务。模型基于结构因果模型(SCM)生成的数百亿合成表格数据预训练,无需微调或超参数搜索,仅以训练数据作为上下文进行单次前向预测即可完成推断。在TabArena基准的51个真实数据集上,TabFM的零样本性能超越了经过大量超参数调优的梯度提升树等强基线模型。该项目同时提供PyTorch和JAX两种权重版本,安装简便,接口兼容scikit-learn API,适合快速部署表格推断任务。
技术定位与领域: TabFM属于自然语言处理与表格数据建模的交叉领域,具体定位于零样本表格基础模型。与传统表格建模方法(如梯度提升树、深度学习模型)不同,TabFM不需要针对每个新数据集进行训练或调参,而是通过大规模合成数据预训练获得通用的表格理解能力,在推理时通过上下文学习直接输出预测结果。其独特定位在于将Transformer架构的上下文学习能力迁移到结构化表格数据上,填补了零样本表格基础模型的空白。
研发背景: 由Google Research团队开发,该团队在基础模型、因果推断和表格数据学习方面拥有深厚积累。研发动机源于现实场景中表格数据建模的痛点:传统方法需要大量标注数据和繁琐的超参数调优,且存在隐私和版权风险。TabFM通过合成数据预训练完全规避了真实数据依赖,同时实现零样本推断,大幅降低表格建模的入门门槛。
核心价值: TabFM解决了表格数据建模中“数据稀缺”和“调参成本高”两大核心问题。对于新任务,用户只需提供原始DataFrame,无需任何训练步骤即可获得可靠的预测结果。其基于合成数据的训练方式天然保护数据隐私,特别适合医疗、金融等敏感领域。在TabArena基准上的优异表现证明,零样本表格基础模型已具备超越传统强基线的能力,为表格数据学习开辟了全新范式。
技术特点: TabFM采用Transformer序列架构,将每行样本视为token序列,通过自注意力机制自动捕捉列间高阶交互。其核心创新在于基于结构因果模型(SCM)生成合成数据,通过随机采样有向无环图定义因果结构,再基于父节点条件分布生成特征值,确保合成数据的多样性和统计真实性。推理时,训练数据作为上下文输入,模型通过注意力机制直接输出预测,实现真正的零样本推断。
2. 主要功能
零样本分类: 无需任何训练数据或超参数调整,直接对最多10个类别的表格数据进行分类预测。用户只需提供标注好的训练集和测试集,模型通过上下文学习自动完成分类,在多个基准上达到与调优后的梯度提升树相当甚至更优的效果。
零样本回归: 原生支持数值型目标变量的回归任务,无需模型微调或特征工程。模型能够自动处理数值特征的缩放与编码,对连续值目标进行精确预测,适用于价格预测、风险评估等场景。
混合特征处理: 原生支持数值型与类别型特征混合的表格数据,自动完成类别特征的Ordinal Encoding、数值特征的标准化缩放以及缺失值的鲁棒处理。用户无需手动预处理,可直接传入原始DataFrame,大幅简化工作流。
上下文学习推理: 将训练数据作为“上下文”序列化后与测试样本拼接输入模型。模型通过自注意力机制读取训练样本中的统计规律(如类别分布、数值范围、特征相关性),在不更新任何权重的情况下直接输出预测结果,实现真正的零样本推断。
双后端兼容: 同时提供JAX与PyTorch两种权重版本,用户可根据技术栈偏好选择后端框架。JAX版本适合需要高性能计算和自动微分的研究场景,PyTorch版本则更贴合工业界部署习惯,两者API完全对齐。
scikit-learn兼容接口: 完全兼容scikit-learn的
fit和predict范式,数据科学家可以无缝接入现有工作流。TabFMClassifier和TabFMRegressor封装了所有预处理和推理逻辑,只需调用.fit(X_train, y_train)准备编码器,再调用.predict(X_test)即可获得结果。
3. 如何使用
环境要求: 需要Python 3.8+环境,推荐在Linux或macOS系统上运行。硬件方面,建议使用至少16GB显存的GPU(如NVIDIA V100/A100),CPU模式下也可运行但推理速度较慢。同时需要安装Git用于克隆仓库。
克隆仓库与安装依赖: 执行
git clone (链接待官方发布后更新) install -e .[pytorch](PyTorch版)或pip install -e .[jax](JAX版)。安装过程会自动下载依赖的深度学习框架和预处理库。加载预训练权重: 在Python代码中导入对应后端模块,例如
from tabfm_v1_0_0_pytorch import TabFMClassifier。调用model = TabFMClassifier.from_pretrained()会自动从HuggingFace下载约2GB的预训练权重,首次加载需等待下载完成。初始化分类器/回归器: 使用
TabFMClassifier或TabFMRegressor包装模型。调用.fit(X_train, y_train)准备内部编码器,该步骤仅进行特征编码的统计计算(如均值、标准差、类别映射),不涉及模型训练,耗时极短。执行预测: 调用
.predict(X_test)获取零样本预测结果,或调用.predict_proba()获取分类概率。对于回归任务,.predict()直接返回数值预测值。整个过程仅需一次前向传播,推理速度与数据集大小线性相关。注意事项与最佳实践: 输入数据应包含所有训练集和测试集共有的特征列,缺失值建议用NaN表示(模型会自动处理)。当前版本支持最多10个分类类别,回归任务无此限制。对于超过10,000样本的训练集,建议对训练集进行下采样以避免上下文长度超出模型限制。若使用CPU推理,可考虑将
batch_size参数调小(默认32)以降低内存占用。
4. 优缺点分析
| 优点 |
|---|
| 真正零样本: 无需微调、无需超参数搜索,开箱即用,大幅降低表格建模的使用门槛和计算成本。 |
| 隐私安全: 基于合成数据训练,不依赖任何真实敏感数据,天然规避隐私与版权风险,特别适合医疗、金融等合规要求严格的领域。 |
| 性能强劲: 在TabArena基准的51个真实数据集上,零样本表现超越经过大量超参数调优的梯度提升树(如XGBoost/LightGBM),验证了基础模型的泛化能力。 |
| 框架灵活: 同时提供PyTorch与JAX两种权重版本,兼容不同技术栈的部署环境,用户可根据硬件和生态偏好自由选择。 |
5. 同类工具对比
| 维度 | TabFM (Google Research) | TabPFN (弗莱堡大学/AutoML团队) |
|---|---|---|
| 核心架构 | Transformer序列架构,基于SCM合成数据预训练 | Transformer架构,基于先验分布采样合成数据集预训练 |
| 训练数据 | 数百亿合成表格(SCM生成,因果结构驱动) | 数百万合成数据集(先验分布采样) |
| 零样本能力 | 真正零样本,无需微调或超参数搜索 | 零样本,但需对训练集进行编码拟合 |
| 分类类别限制 | 最多10类 | 最多10类 |
| 回归支持 | 原生支持,无需额外配置 | 早期版本不支持,后续扩展有限 |
| 后端支持 | PyTorch + JAX 双版本 | 主要基于PyTorch |
| 数据规模 | 适合中小规模(<10,000样本) | 同样针对中小规模优化 |
| 接口友好度 | 完全兼容scikit-learn API | 兼容scikit-learn API |
| 隐私保护 | 基于合成数据,天然隐私安全 | 基于合成数据,隐私安全 |
选型建议: 对于零样本表格建模场景,TabFM和TabPFN是最直接的选择。TabFM在回归任务上原生支持且性能更优,同时提供JAX后端适合高性能计算;TabPFN在分类任务上同样表现强劲,但回归支持有限。如果用户需要处理超过10个类别的分类任务或超大规模数据集,传统梯度提升树(如XGBoost/LightGBM)仍是更稳妥的选择,但需要投入调参成本。在隐私敏感领域(如医疗、金融),TabFM的合成数据训练优势使其成为首选。对于已有PyTorch技术栈的团队,TabFM的PyTorch版本可无缝集成;对于追求极致推理速度的团队,JAX版本可借助XLA编译器获得额外加速。
6. 编辑点评
TabFM代表了表格数据学习领域的一次重要范式转变。从技术创新性来看,它将Transformer的上下文学习能力成功迁移到结构化表格数据上,并基于结构因果模型(SCM)生成合成数据,解决了真实数据隐私和版权问题的同时,确保了合成数据的统计真实性。在TabArena基准上的51个数据集验证中,零样本性能超越精心调优的梯度提升树,这一成果意义重大——它证明了基础模型在表格领域同样可以取代传统手工调参范式。
从实用价值分析,TabFM大幅降低了表格建模的门槛。数据科学家不再需要为每个新数据集进行特征工程、模型选择和超参数搜索,只需几行代码即可获得可靠的基线预测。这对于快速原型验证、冷启动场景以及非专业用户尤其有价值。同时,双后端支持和scikit-learn兼容接口使得集成成本极低。
适用人群定位清晰:主要面向数据科学家、机器学习工程师和研究人员,尤其是那些需要快速处理表格数据但缺乏大规模标注资源的团队。对于金融风控、医疗诊断、电商定价等隐私敏感领域,TabFM的合成数据训练特性提供了天然合规优势。
未来发展潜力巨大。当前版本的限制(分类类别上限、数据规模限制)有望通过模型架构优化和更大规模的预训练得到解决。随着Google Research持续投入,TabFM很可能成为表格基础模型的标准参考实现,并催生更多基于合成数据的预训练范式。
7. 应用场景
金融风控: 快速评估贷款申请风险,无需历史数据重新训练模型。用户只需提供申请人的年龄、收入、信用评分等混合特征,TabFM即可零样本输出违约概率,同时保护客户隐私,避免敏感金融数据外泄。
医疗辅助诊断: 基于患者的数值指标(如血压、血糖)和类别特征(如症状类型、既往病史)进行疾病分类。模型在合成数据上训练,完全规避真实医疗数据泄露风险,适合医院和科研机构快速建立诊断基线。
电商定价预测: 对新上架商品进行零样本价格回归。结合商品类别、品牌、规格等类别特征与历史销量、评分等数值特征,TabFM可直接预测合理定价区间,帮助电商平台冷启动阶段快速定价。
广告点击率预估: 在广告冷启动场景下,快速预测新广告的点击率。无需等待积累足够训练数据,TabFM基于广告的受众特征、投放时段、创意类型等混合特征,直接输出CTR预测,加速广告投放优化。
科研数据探索: 研究人员在敏感数据集(如人口普查、社会调查)上进行快速基线建模。TabFM无需接触原始隐私数据即可完成分类或回归任务,为后续分析提供参考基准,同时满足数据保护法规要求。
8. 常见问题FAQ
Q:TabFM支持处理超过10个类别的分类任务吗?
A:当前版本仅支持最多10个类别。对于多分类任务,建议拆分为多个二分类子任务分别预测,或等待后续版本扩展。模型架构本身不限制类别数量,该限制主要来源于预训练数据的类别分布设计。
Q:TabFM的推理速度如何?在CPU上能运行吗?
A:推理速度与训练集样本量和特征数量相关。在GPU(如A100)上,对于1,000样本、50特征的数据集,推理可在数秒内完成。CPU上也可运行,但速度会慢10-50倍,建议使用GPU获得最佳体验。模型权重约2GB,推理时内存占用与数据规模线性增长。
Q:TabFM对缺失值如何处理?需要手动填充吗?
A:不需要。模型内置了鲁棒的缺失值处理机制,在预处理阶段自动将缺失值编码为特殊占位符,并在注意力计算中给予合理权重。用户只需将缺失值保留为NaN或None即可。
Q:TabFM的训练数据是如何生成的?是否包含真实数据?
A:完全基于结构因果模型(SCM)生成的合成数据,不包含任何真实表格数据。具体过程为:随机采样有向无环图定义变量间的因果结构,再基于父节点条件分布生成每个特征的值。这种方式保证了数据的多样性和统计真实性,同时完全规避隐私和版权风险。
Q:TabFM与TabPFN相比哪个更好?
A:两者都是零样本表格基础模型,各有优势。TabFM在回归任务上原生支持且性能更优,同时提供JAX后端;TabPFN在分类任务上同样表现强劲,但回归支持有限。在TabArena基准上,TabFM在51个数据集上的平均表现略优于TabPFN。建议根据具体任务类型和技术栈选择。
Q:TabFM是否支持大规模数据集(如百万级样本)?
A:当前版本主要针对中小规模表格(<10,000样本)优化。当训练集样本量过大时,上下文长度可能超出Transformer的注意力窗口,导致性能下降。若需处理大规模数据,建议对训练集进行下采样或使用传统梯度提升树方法。
9. 项目地址
- 项目官网(Google Research Blog): https://research.google/blog/introducing-tabfm-a-zero-shot-foundation-model-for-tabular-data/
- GitHub仓库: https://github.com/google-research/tabfm
- HuggingFace模型库(PyTorch版): https://huggingface.co/google/tabfm-1.0.0-pytorch
- HuggingFace模型库(JAX版): https://huggingface.co/google/tabfm-1.0.0-jax
相关 AI 模型文章
Claude Sonnet 5.5 – Anthropic 推出的最新 AI 模型
Claude Sonnet 5.5 是 Anthropic 推出的 Claude 5.5 系列第二款模型,距旗舰 Claude Opus 5.5 发布仅隔 6 天,是 Claude Sonnet 5 的全面升级版。该模型定位为 Opus 5.5 的互补与平替,专注于处理范围明确的日常任务,在 Terminal-Bench 4.0 上取得 70.6% 的成绩,多数基准逼近旗舰水平,擅长日常编程、修复...
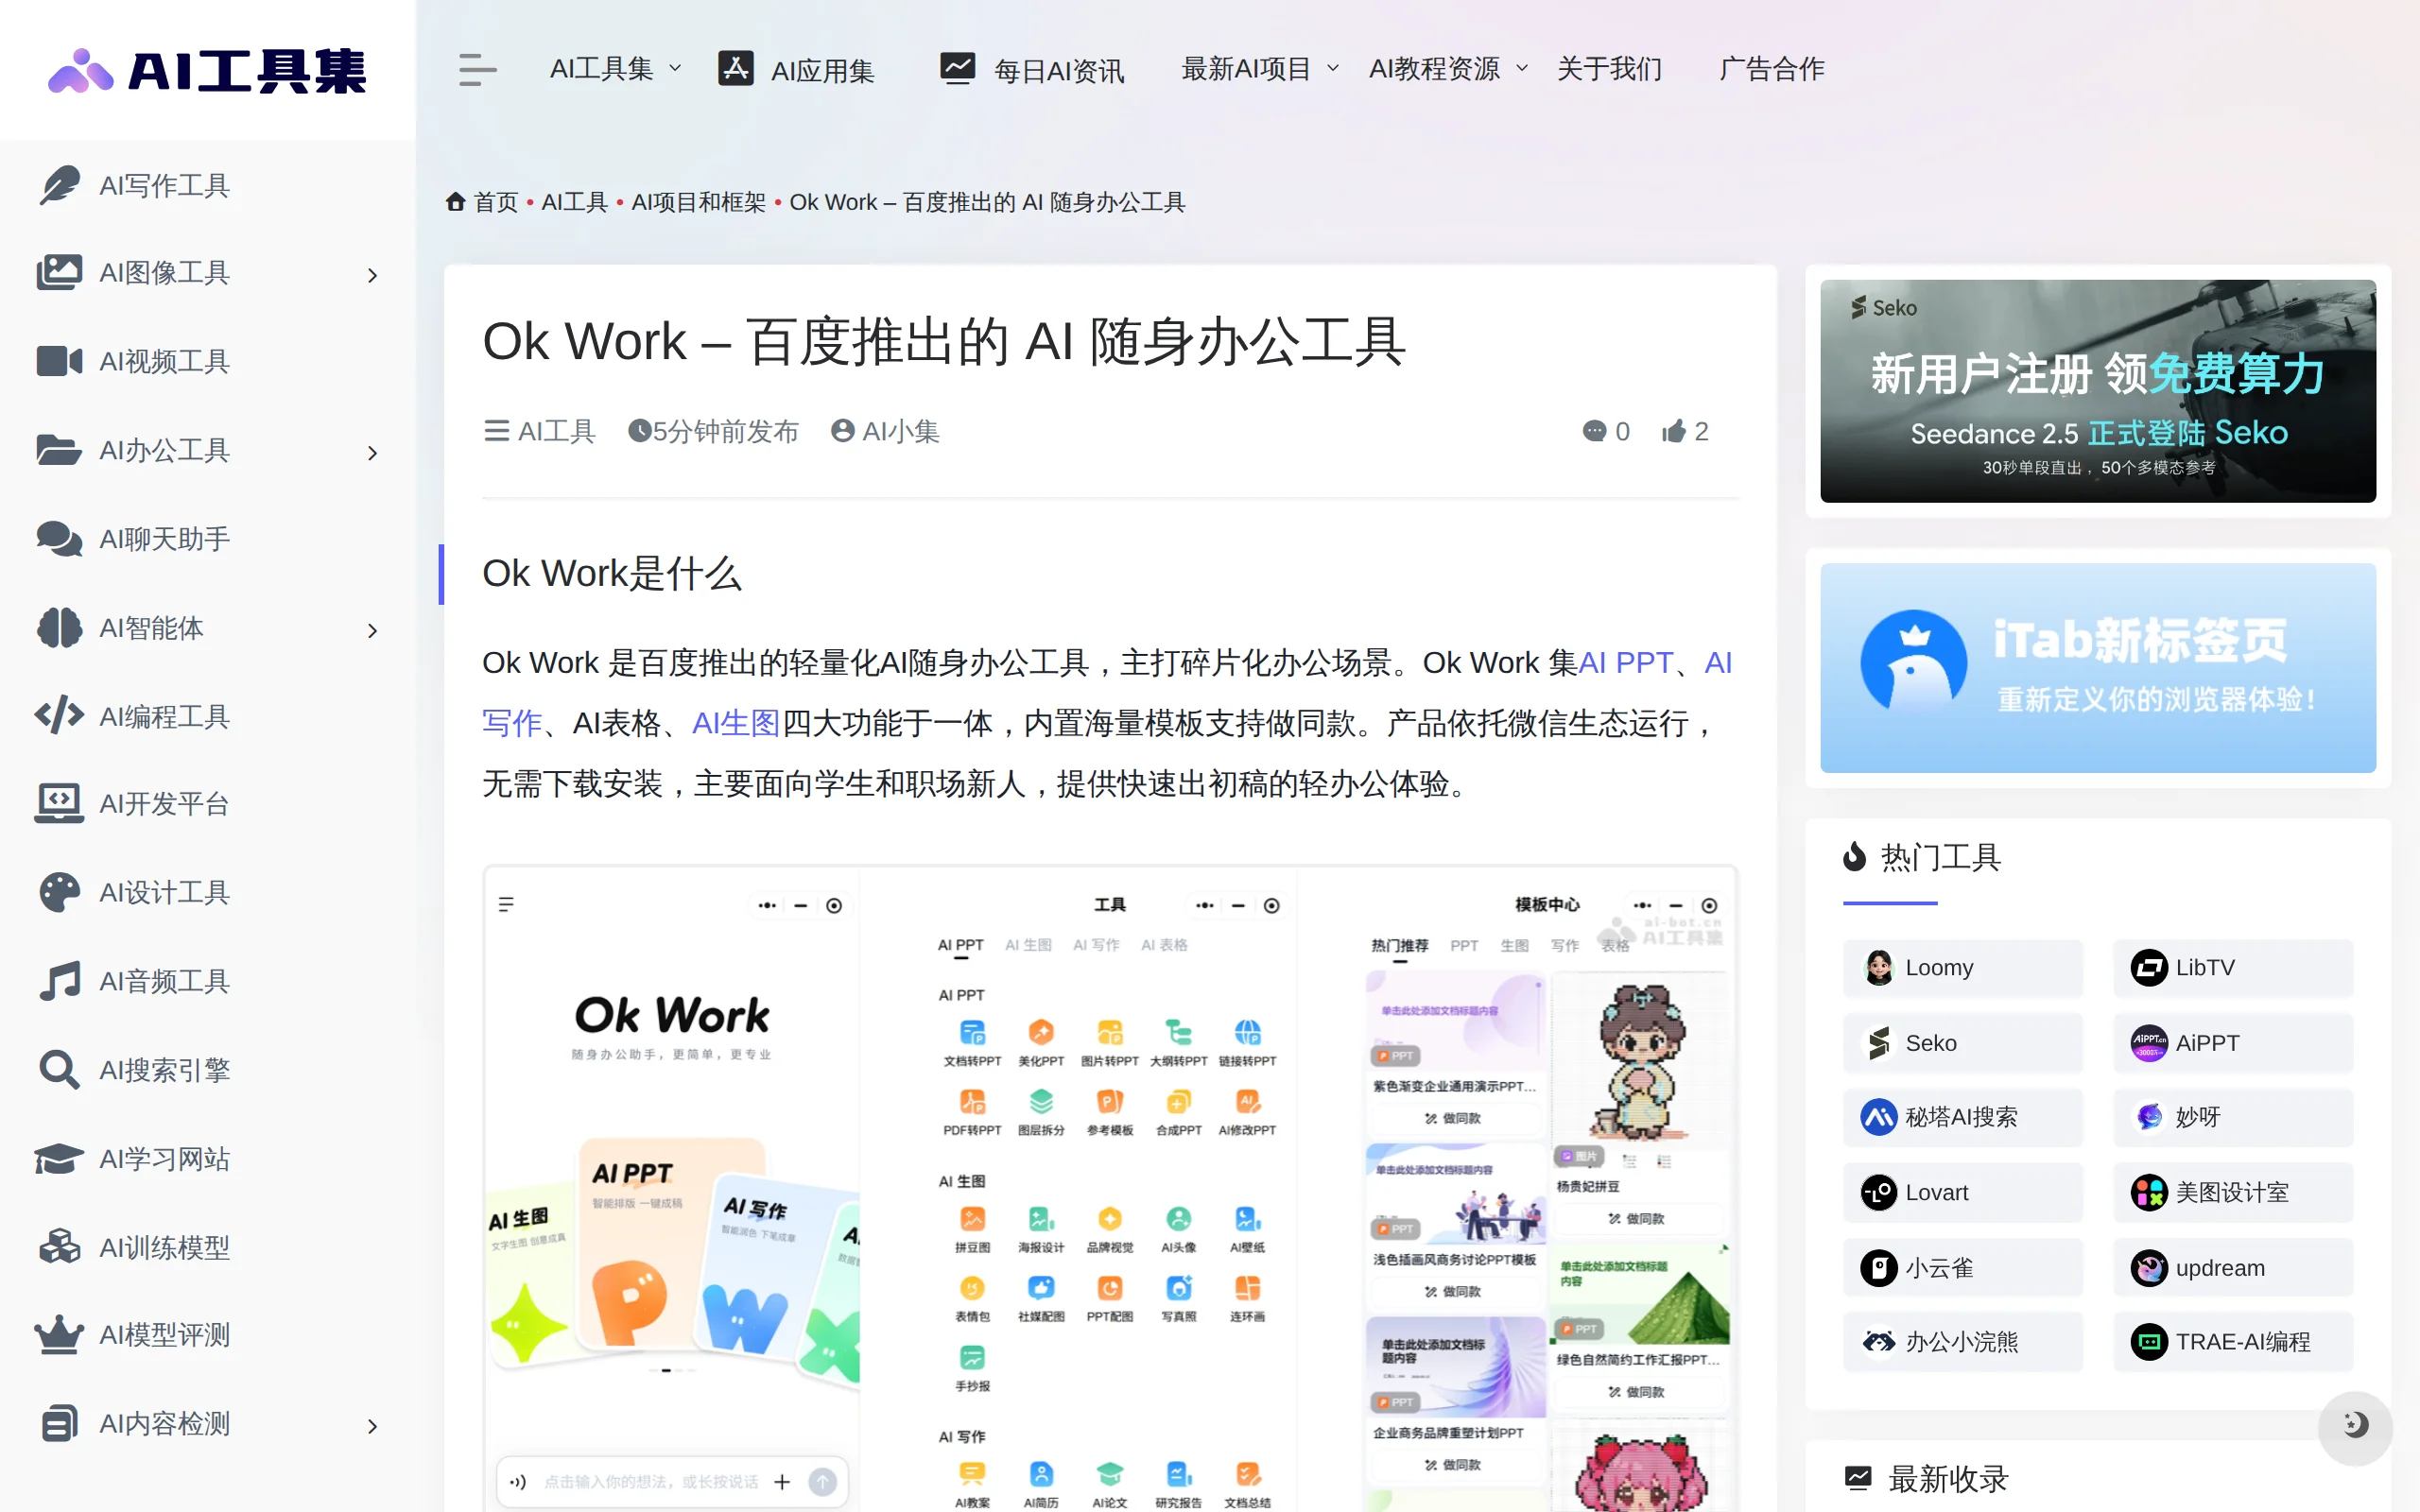
Ok Work – 百度推出的 AI 随身办公工具
Ok Work是百度推出的轻量化AI随身办公工具,以微信小程序形态运行,面向学生与职场新人,聚焦碎片化办公场景。产品将AI PPT、AI写作、AI表格、AI生图四大核心能力整合于同一对话界面,内置海量模板并支持"做同款"快速套用,无需下载安装即可完成从内容生成、文档转换到视觉设计的完整轻办公流程。依托文心大模型的底层能力,Ok Work将复杂的AI能力拆解为颗粒度精细的具体小工具,以极低的上手门槛...
TeleOCR – 中国电信星辰实验室开源的文档解析模型深度评测
TeleOCR 是中国电信星辰实验室开源的文档解析模型,采用约 1.2B 参数的轻量级视觉语言架构,在单一框架内统一处理数字文档与相机拍摄文档,可将文字、版面、表格、公式和科学图表解析为 Markdown、JSON 等结构化结果。该模型在 OmniDocBench v1.6 榜单中登顶,同时获得 PureDocBench 榜首和 ICDAR-2026 科学图解析挑战赛冠军,支持本地 GPU 部署,...
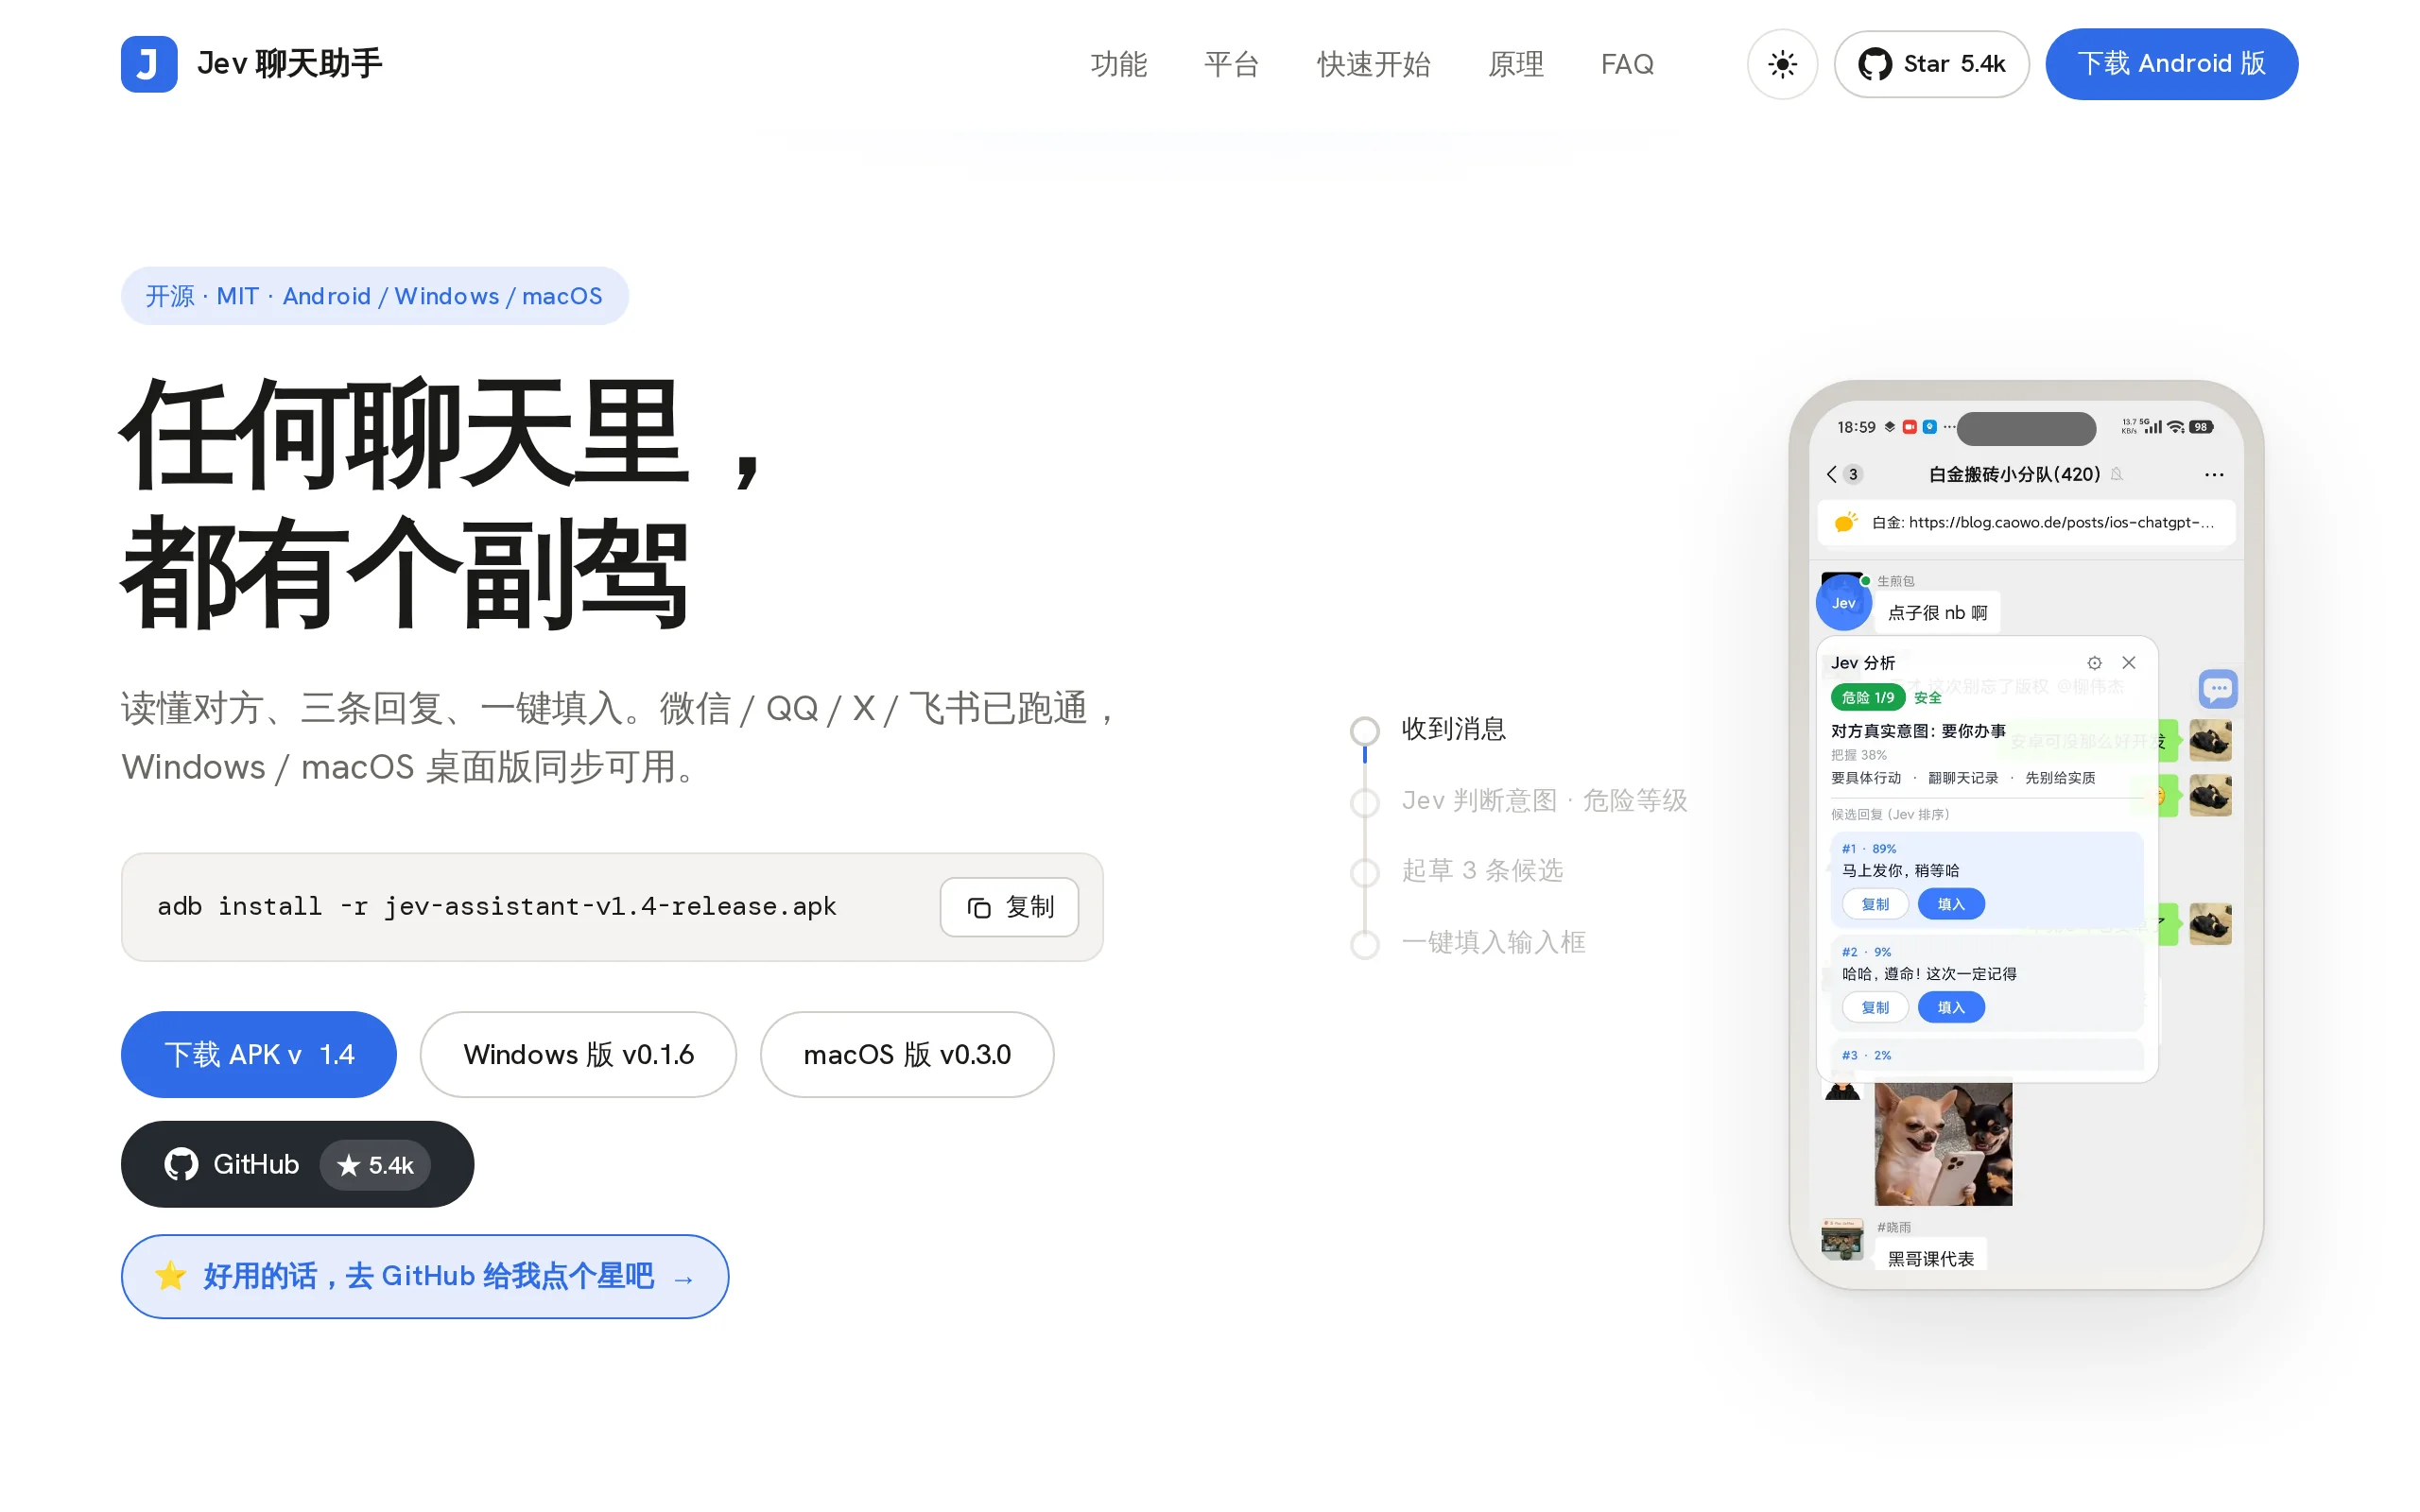
Jev 聊天助手 – 开源 AI 聊天辅助应用,生成最得体的回复
Jev 聊天助手是一款开源的非侵入式 AI 对话辅助应用,能够在微信、QQ、X、飞书等主流聊天场景中实时提供回复建议。该工具通过无障碍服务或离线 OCR 技术读取屏幕对话内容,先由判断模型分析对方意图与风险等级,再生成 3 条候选回复并按合适度排序,用户一键即可填入输入框,且只填不发,发送权始终保留在用户手中。Jev 聊天助手支持 Android、Windows、macOS 三端,密钥仅存本机,兼...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。