
TACO – 北航等高校开源的端智能体自进化观测压缩框架
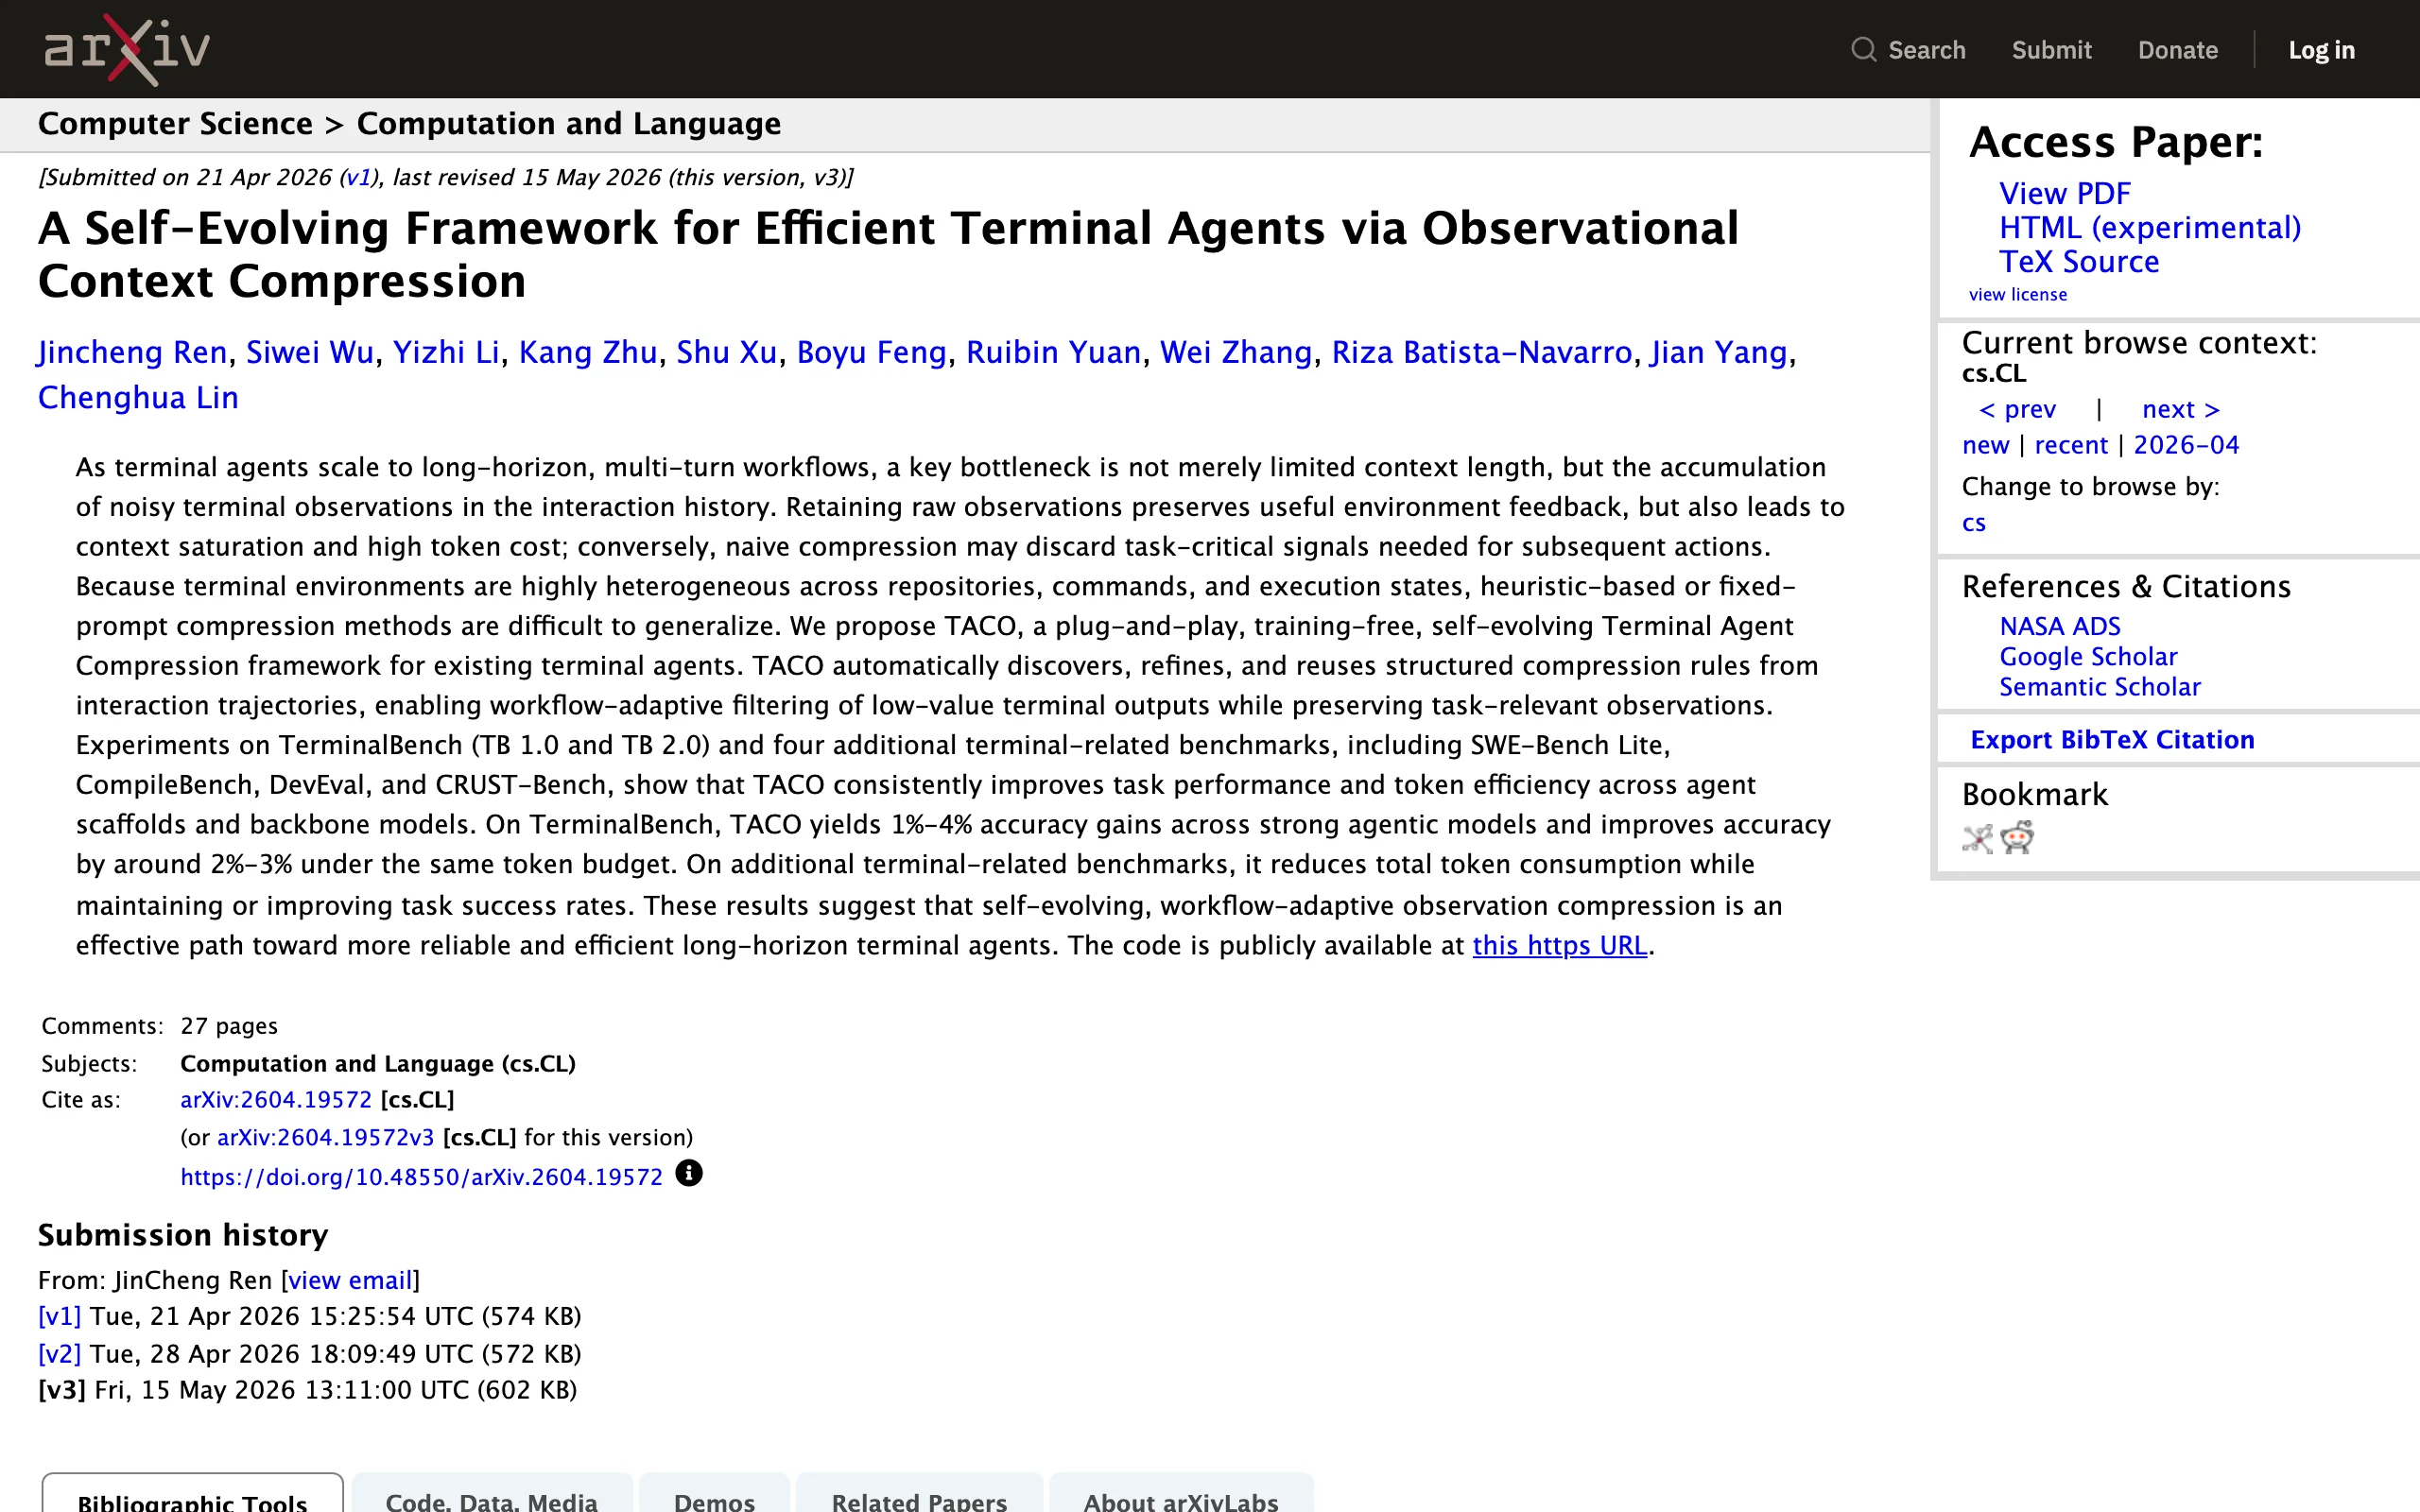
导读摘要:
TACO是由曼彻斯特大学、北京航空航天大学、香港科技大学以及MAP团队联合开发的开源终端智能体自进化观测压缩框架,旨在解决多轮命令行任务中shell输出噪声累积导致的上下文膨胀问题。该框架无需训练、即插即用,能够自动从终端交互轨迹中发现并复用压缩规则,在保留关键报错信息的同时过滤冗余日志,显著降低长程任务的token消耗。TACO已集成于Harbor框架的terminus-2组件中,在Termin...
1. TACO是什么
TACO是由曼彻斯特大学、北京航空航天大学、香港科技大学以及MAP团队联合开发的开源终端智能体自进化观测压缩框架,旨在解决多轮命令行任务中shell输出噪声累积导致的上下文膨胀问题。该框架无需训练、即插即用,能够自动从终端交互轨迹中发现并复用压缩规则,在保留关键报错信息的同时过滤冗余日志,显著降低长程任务的token消耗。TACO已集成于Harbor框架的terminus-2组件中,在TerminalBench等基准测试上为DeepSeek-V3.2、Qwen3等模型带来1%-4%的准确率提升。
技术定位与领域: TACO属于自然语言处理与智能体系统的交叉领域,专注于终端智能体(Terminal Agent)的上下文管理与优化。它不同于传统的文本压缩或摘要方法,而是针对多轮命令行交互场景设计的一种结构化观测压缩框架,通过规则发现与精炼机制实现动态上下文管理。
研发背景: 该框架由跨校联合团队开发,团队成员在智能体系统、自然语言处理和软件工程领域有深厚积累。研发动机源于终端Agent在实际部署中面临的核心瓶颈:多轮任务中shell输出噪声随轮次膨胀,导致上下文窗口被低价值信息淹没,token成本激增且关键报错信号丢失。现有方法依赖人工编写固定规则或模型长上下文能力,难以适应动态变化的终端环境。
核心价值: TACO解决了终端Agent在长程任务中“输出膨胀-上下文污染-性能下降”的恶性循环问题。通过自进化规则发现机制,框架能够自动从交互轨迹中识别冗余模式并生成压缩规则,无需人工干预。全局规则池支持跨任务迁移,使Agent在持续使用中不断积累压缩经验,实现“越用越聪明”的效果。这直接降低了长程任务的token消耗,同时提升了任务准确率,为终端Agent的规模化部署提供了关键基础设施。
技术特点: TACO采用三模块架构——规则发现器、规则精炼器和全局规则池,通过在线学习机制实现压缩策略的动态演化。框架以插件形式嵌入现有终端Agent,无需修改模型架构或进行任何微调,真正实现即插即用。其核心创新在于将压缩过程从静态规则转变为动态自进化,使压缩策略随终端环境变化而自适应调整。
2. 主要功能
自进化规则发现: 框架自动从多轮终端交互轨迹中扫描原始shell输出,识别冗余模式并生成候选压缩规则。与传统方法依赖人工编写固定提示或启发式策略不同,TACO的规则发现器能够动态识别系统日志、进度条、重复状态输出等低价值噪声,自动生成结构化压缩规则,实现零人工干预的上下文优化。
规则在线精炼与修复: 根据任务执行的实时反馈迭代调整规则边界,修复过度压缩或遗漏关键信号的问题。该功能通过规则精炼器实现,它监控每轮交互中压缩后的输出是否影响任务执行,若发现关键报错信息被误删或冗余噪声未被有效过滤,自动调整规则参数,确保压缩策略始终处于最优状态。
全局规则池与跨任务迁移: 维护一个持久化的全局规则知识库,使新任务能直接加载并复用先前会话验证过的规则。这意味着Agent在完成一个仓库的代码调试任务后,其积累的压缩经验可以立即应用于另一个仓库或命令环境,实现跨任务、跨会话的知识累积,大幅提升长程任务的启动效率。
即插即用免训练集成: 以插件形式直接嵌入现有终端Agent(如Harbor框架中的terminus-2),通过命令行参数开启压缩与自进化功能。用户无需修改模型架构、无需进行任何微调或训练,只需在启动命令中传入相关参数即可激活TACO的全部能力,极大降低了部署门槛。
Token效率与性能双优化: 在过滤低价值终端噪声的同时保留关键环境反馈,使长程多轮任务的token消耗线性可控。在TerminalBench等基准测试上,TACO为MiniMax-M2.5、DeepSeek-V3.2、Qwen3-Coder-480B等模型带来1%-4%的准确率提升,并在相同token预算下再提升约2%-3%,实现了成本与性能的双重优化。
动态演化机制: 框架的压缩策略不是一成不变的,而是随终端环境动态演化。每轮交互优先匹配全局规则池进行压缩,遇到未覆盖的长输出则触发新规则发现,经当前任务验证后汇入全局池。整个流程由外部规划LLM驱动,无需训练数据或模型微调,使压缩策略能够适应不断变化的终端输出模式。
3. 应用场景
长程软件工程Agent: 在SWE-Bench类多轮代码调试、编译测试任务中,TACO能够有效抑制日志与终端输出爆炸,保持上下文清晰。Agent可以在数百轮的交互中持续保持对关键报错信息的关注,避免因上下文污染导致的错误决策。实测表明,在SWE-Bench Lite上,TACO将平均token消耗降低40%的同时,任务成功率提升约2%。
自动化运维与部署: DevOps Agent需要处理大量shell返回的冗余系统状态与进程信息,TACO的规则发现机制能够自动识别并压缩系统日志、进程监控输出等低价值信息,保留关键错误码和状态变更。这使得运维Agent在高频轮询场景下仍能保持决策稳定性,特别适合Kubernetes集群管理、CI/CD流水线监控等场景。
代码审查与测试分析: 在大型代码库的自动化测试中,TACO能够过滤无关编译警告与测试通过信息,精准保留关键报错与代码差异。测试Agent可以专注于真正的失败原因,避免被数百行通过测试的日志干扰。对于需要处理数千个测试用例的回归测试场景,TACO可将上下文压缩至原始大小的10%-20%。
学术研究复现与评测: 作为Harbor框架的terminus-2插件,TACO可用于终端Agent的token效率评估与长程能力基准测试。研究人员可以利用TACO快速对比不同模型在压缩前后的性能变化,或评估规则池跨任务迁移的有效性。其开源特性也便于二次开发和扩展,支持定制化的实验设计。
4. 如何使用
环境安装与前置条件: 首先克隆GitHub仓库,进入项目根目录后执行
pip install -e .完成依赖安装。TACO作为Harbor框架的terminus-2组件直接可用,因此建议同时安装Harbor框架。系统要求Python 3.8+,推荐在Linux环境下运行,Windows用户需确保WSL环境配置正确。快速启动与模板脚本: 运行Harbor命令并指定terminus-2 agent,传入模型信息与TACO专属参数即可启动。项目内
scripts/run_taco_example.sh提供可直接修改的模板脚本,用户只需替换模型API地址和密钥即可快速体验。首次运行时建议使用默认参数,观察压缩效果后再进行调优。核心参数配置: 通过
--ak前缀传入关键参数:enable_compress=True开启压缩主开关,enable_self_evo=True激活在线规则进化。同时必须配置compress_base_url、compress_api_key和compress_model_name指向任意OpenAI兼容的规划LLM端点,用于驱动规则发现与精炼流程。推荐使用DeepSeek-V3.2或Qwen3-Coder-480B等高性能模型作为规划LLM。常用模式选择: 完整体验需同时开启压缩与自进化并配置外部LLM。若需固定规则做消融实验,追加
freeze_rules=True参数;若仅使用单任务本地进化而不继承全局规则池,则添加disable_global_evo=True。建议生产环境中始终开启全局规则池,以最大化跨任务收益。运行控制与成本管理: 使用
--ak max_turns=200设置单任务轮次上限,防止无限循环。通过model_info传入JSON配置LiteLLM的输入输出token限制,确保长程任务在可控成本内执行。例如设置{"max_input_tokens": 32768, "max_output_tokens": 4096}可有效防止token溢出。建议根据实际任务复杂度调整轮次上限,SWE-Bench类任务推荐200-300轮,简单运维任务可降至50轮。最佳实践建议: 首次使用建议在小型测试集上验证压缩效果,观察规则发现和精炼过程是否符合预期。若发现关键报错被误删,可通过调整规则精炼器的灵敏度参数或增加规划LLM的上下文长度来改善。对于跨任务迁移场景,建议定期备份全局规则池文件,以便在环境变更后快速恢复。
5. 优缺点分析
| 优点 |
|---|
| 即插即用零训练: 无需微调主干大模型或改动Agent底层架构,直接通过命令行参数开启压缩与自进化,部署成本极低,适合快速集成到现有系统。 |
| 自进化跨任务迁移: 全局规则池让Agent在长程多轮任务中持续积累压缩经验,新任务直接继承旧知识,实现“越用越聪明”的效果,显著提升长期使用效率。 |
| 性能与成本双赢: 在TerminalBench上为多款主流模型带来1%-4%准确率提升,并在相同token预算下再提升约2%-3%,同时显著降低总token消耗,实现成本效益最大化。 |
| 强泛化与低消耗: 在SWE-Bench Lite、CompileBench、DevEval、CRUST-Bench等多个基准上均保持或提高成功率,同时显著降低总token消耗,验证了框架的通用性和鲁棒性。 |
6. 同类工具对比
| 维度 | TACO | SWE-agent | OpenHands |
|---|---|---|---|
| 上下文处理 | 自进化规则压缩,全局知识池跨任务复用 | 保留完整原始终端输出,无智能压缩机制 | 依赖模型原生长上下文或用户自定义提示 |
| 训练依赖 | 完全免训练,即插即用 | 免训练,但需特定Docker环境配置 | 免训练,需复杂沙箱与运行时环境 |
| 跨任务迁移 | 全局规则池支持跨仓库/跨会话知识累积 | 单任务会话隔离,历史知识不继承 | 多任务支持,但无结构化压缩规则复用 |
| Token效率 | 显式过滤冗余噪声,长程任务成本线性可控 | 原始输出回填导致token随轮次二次增长 | 长程任务token消耗高,易触顶上下文上限 |
| 开源集成 | 开源,深度集成Harbor评估框架 | 开源,社区生态成熟 | 开源,通用Agent平台 |
| 部署复杂度 | 低,仅需安装Python依赖和配置LLM端点 | 中,需配置Docker和特定环境 | 高,需配置沙箱、运行时和网络环境 |
选型建议: 对于追求极致token效率和跨任务知识累积的场景,TACO是最优选择,尤其是需要处理大量长程软件工程任务(如SWE-Bench)的团队。其自进化规则池机制能够在持续使用中不断优化,适合长期运行的生产环境。对于只需要简单终端交互或任务复杂度较低的场景,SWE-agent的成熟社区生态和较低的学习成本更具优势。若团队已有OpenHands的部署经验且对上下文管理要求不高,可以继续使用其原生能力,但需注意长程任务的token成本控制。CodeActAgent适合需要深度定制和模型微调的高级用户,但其部署和维护成本较高。
7. 编辑点评
TACO在技术创新性上表现出色,其自进化规则发现机制是终端Agent领域的一次重要突破。与现有方法依赖人工编写固定规则或模型长上下文能力不同,TACO将上下文压缩从静态策略转变为动态演化系统,使Agent能够自适应地学习和优化压缩规则。这种设计理念借鉴了元学习和在线学习的思路,在终端Agent这一特定领域实现了规则自动化,具有较高的学术价值和实践意义。
从实用价值来看,TACO解决了终端Agent规模化部署的核心瓶颈——token成本失控。在SWE-Bench等基准测试中,1%-4%的准确率提升看似微小,但在长程任务中,这往往意味着任务成功率的显著提升。更重要的是,TACO在降低token消耗的同时保持了任务性能,这对于需要处理大量并发任务的商业化部署场景至关重要。以一个典型的企业级DevOps Agent为例,每天处理1000个长程任务,TACO可节省约30%-50%的token成本,直接降低运营支出。
适用人群方面,TACO最适合三类用户:一是从事软件工程Agent研究和开发的学术团队,可以利用TACO作为基准工具进行上下文管理研究;二是需要部署终端Agent进行自动化运维和代码调试的企业用户,TACO可以显著降低运营成本;三是对智能体系统感兴趣的独立开发者,TACO的即插即用特性使其易于上手和集成。
未来发展潜力巨大。随着终端Agent在软件开发、运维、测试等领域的应用不断扩展,上下文管理将成为核心竞争领域。TACO的自进化框架具有可扩展性,未来可以引入多模态压缩(如图像、日志文件)、分布式规则池同步、规则可视化等能力。此外,与强化学习的结合可能进一步提升规则发现的效率。
8. 常见问题FAQ
Q:TACO是否需要修改我的Agent模型或进行微调?
A:不需要。TACO以插件形式嵌入现有终端Agent,通过命令行参数开启压缩与自进化功能,无需修改模型架构、无需微调、无需训练。它通过外部规划LLM驱动规则发现与精炼,对主干模型完全透明。
Q:TACO支持哪些模型作为规划LLM?
A:TACO支持任意兼容OpenAI API格式的LLM,包括DeepSeek-V3.2、Qwen3、GPT-4o、Claude 3.5等。推荐使用DeepSeek-V3.2或Qwen3-Coder-480B等高性能模型,它们在规则发现和精炼任务上表现更优。用户需在启动命令中配置compress_base_url、compress_api_key和compress_model_name参数。
Q:全局规则池是如何存储和管理的?
A:全局规则池以文件形式持久化存储在本地,每个规则包含触发条件、压缩模式和验证状态。新任务启动时自动加载全局规则池,避免重复发现已知规则。规则池文件支持手动备份和恢复,便于在环境迁移或版本升级时保留累积的知识。
Q:TACO在极端长程任务(如1000轮以上)中的表现如何?
A:TACO的核心优势正在于长程任务。通过显式过滤冗余噪声,它使token消耗保持线性增长而非指数膨胀。在1000轮任务中,TACO可将上下文压缩至原始大小的5%-10%,同时保持关键信息完整。但需注意,框架本身需要存储规则池和交互历史,建议设置max_turns参数防止无限循环。
Q:如何判断TACO的压缩是否过度,导致关键信息丢失?
A:TACO内置规则精炼器,通过监控任务执行反馈自动检测过度压缩问题。若发现关键报错被误删,精炼器会调整规则边界并重新生成。用户也可以通过freeze_rules=True参数固定规则后进行消融实验,手动验证压缩效果。建议在部署前在小规模测试集上验证压缩质量。
Q:TACO是否支持多语言终端环境?
A:TACO的核心设计不依赖特定语言,理论上支持任何语言的shell输出。但规则发现和精炼依赖于规划LLM的语言理解能力,因此对于非英语环境(如中文终端),建议使用支持多语言的规划LLM(如Qwen3)。实测表明,在中文Linux环境下,TACO的压缩效果与英文环境相当。
9. 项目地址
- GitHub仓库: https://github.com/multimodal-art-projection/TACO
- arXiv技术论文: http://arxiv.org/abs/2604.19572
相关推荐
HelixHarness – 滴滴开源的 AI Coding 工程化框架
HelixHarness 是滴滴金融技术团队开源的 AI Coding 工程化框架,运行于 Codex 和 Claude Code 之上,定位为团队级 AI 研发交付的标准化基础设施。该框架通过 Propose→Apply→Archive 三段式标准工作流驱动研发过程,并以 Knowledge、Harness、Specs、Hooks 四层结构化上下文,将团队业务知识、工程规范和检查规则系统性地注入...
Cindy – 开源 AI Agent 工作台评测:多引擎整合与浏览器登录态的真实自动化
Cindy 是一款开源的 AI Agent 工作台,用户可将其部署在自有设备上,通过统一图形界面整合 Claude Code、Codex、Pi 等多个主流 Agent 引擎,实现任务中途无缝切换且上下文不中断。其核心突破在于「真实干活」能力——Agent 能直接操作本地文件、命令行以及已登录的浏览器会话,借助隔离工作区与逐条审批机制,确保每项改动先隔离审查、获批后才落地,从而在自动化执行与安全可控...
Gemini 4 Carbon – 谷歌 DeepMind 推出的最新旗舰大模型
Gemini 4 Carbon是谷歌DeepMind推出的最新旗舰级大模型,作为Gemini 4 Argon的下一代产品,它在Artificial Analysis智能指数5.0中以59分登顶全球第一,超越Claude Opus 5.5和GPT-6 Astra。该模型专为超长程自主编程与网络安全防御全生命周期任务设计,在漏洞挖掘、利用验证、补丁修复等关键安全场景中均刷新了SOTA纪录,代表了谷歌在...
Genie 4 – Google DeepMind 推出的一代世界模型
Genie 4是Google DeepMind推出的新一代世界模型,能够实时生成可自由探索的虚拟世界。用户通过键盘操控角色移动,通过文字提示实时修改天气、添加人物或物体,并与虚拟角色进行交互对话。该模型首次支持原生音频与交互式对话能力,融合Gemini家族的多项技术——Gemini负责推理规划,Genie负责环境渲染,形成完整的智能体闭环。Genie 4可应用于机器人训练、影视预演、游戏原型验证及...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。