
VeriSpoof:墨尔本大学开源音频大模型,统一语音取证分析框架
导读摘要:
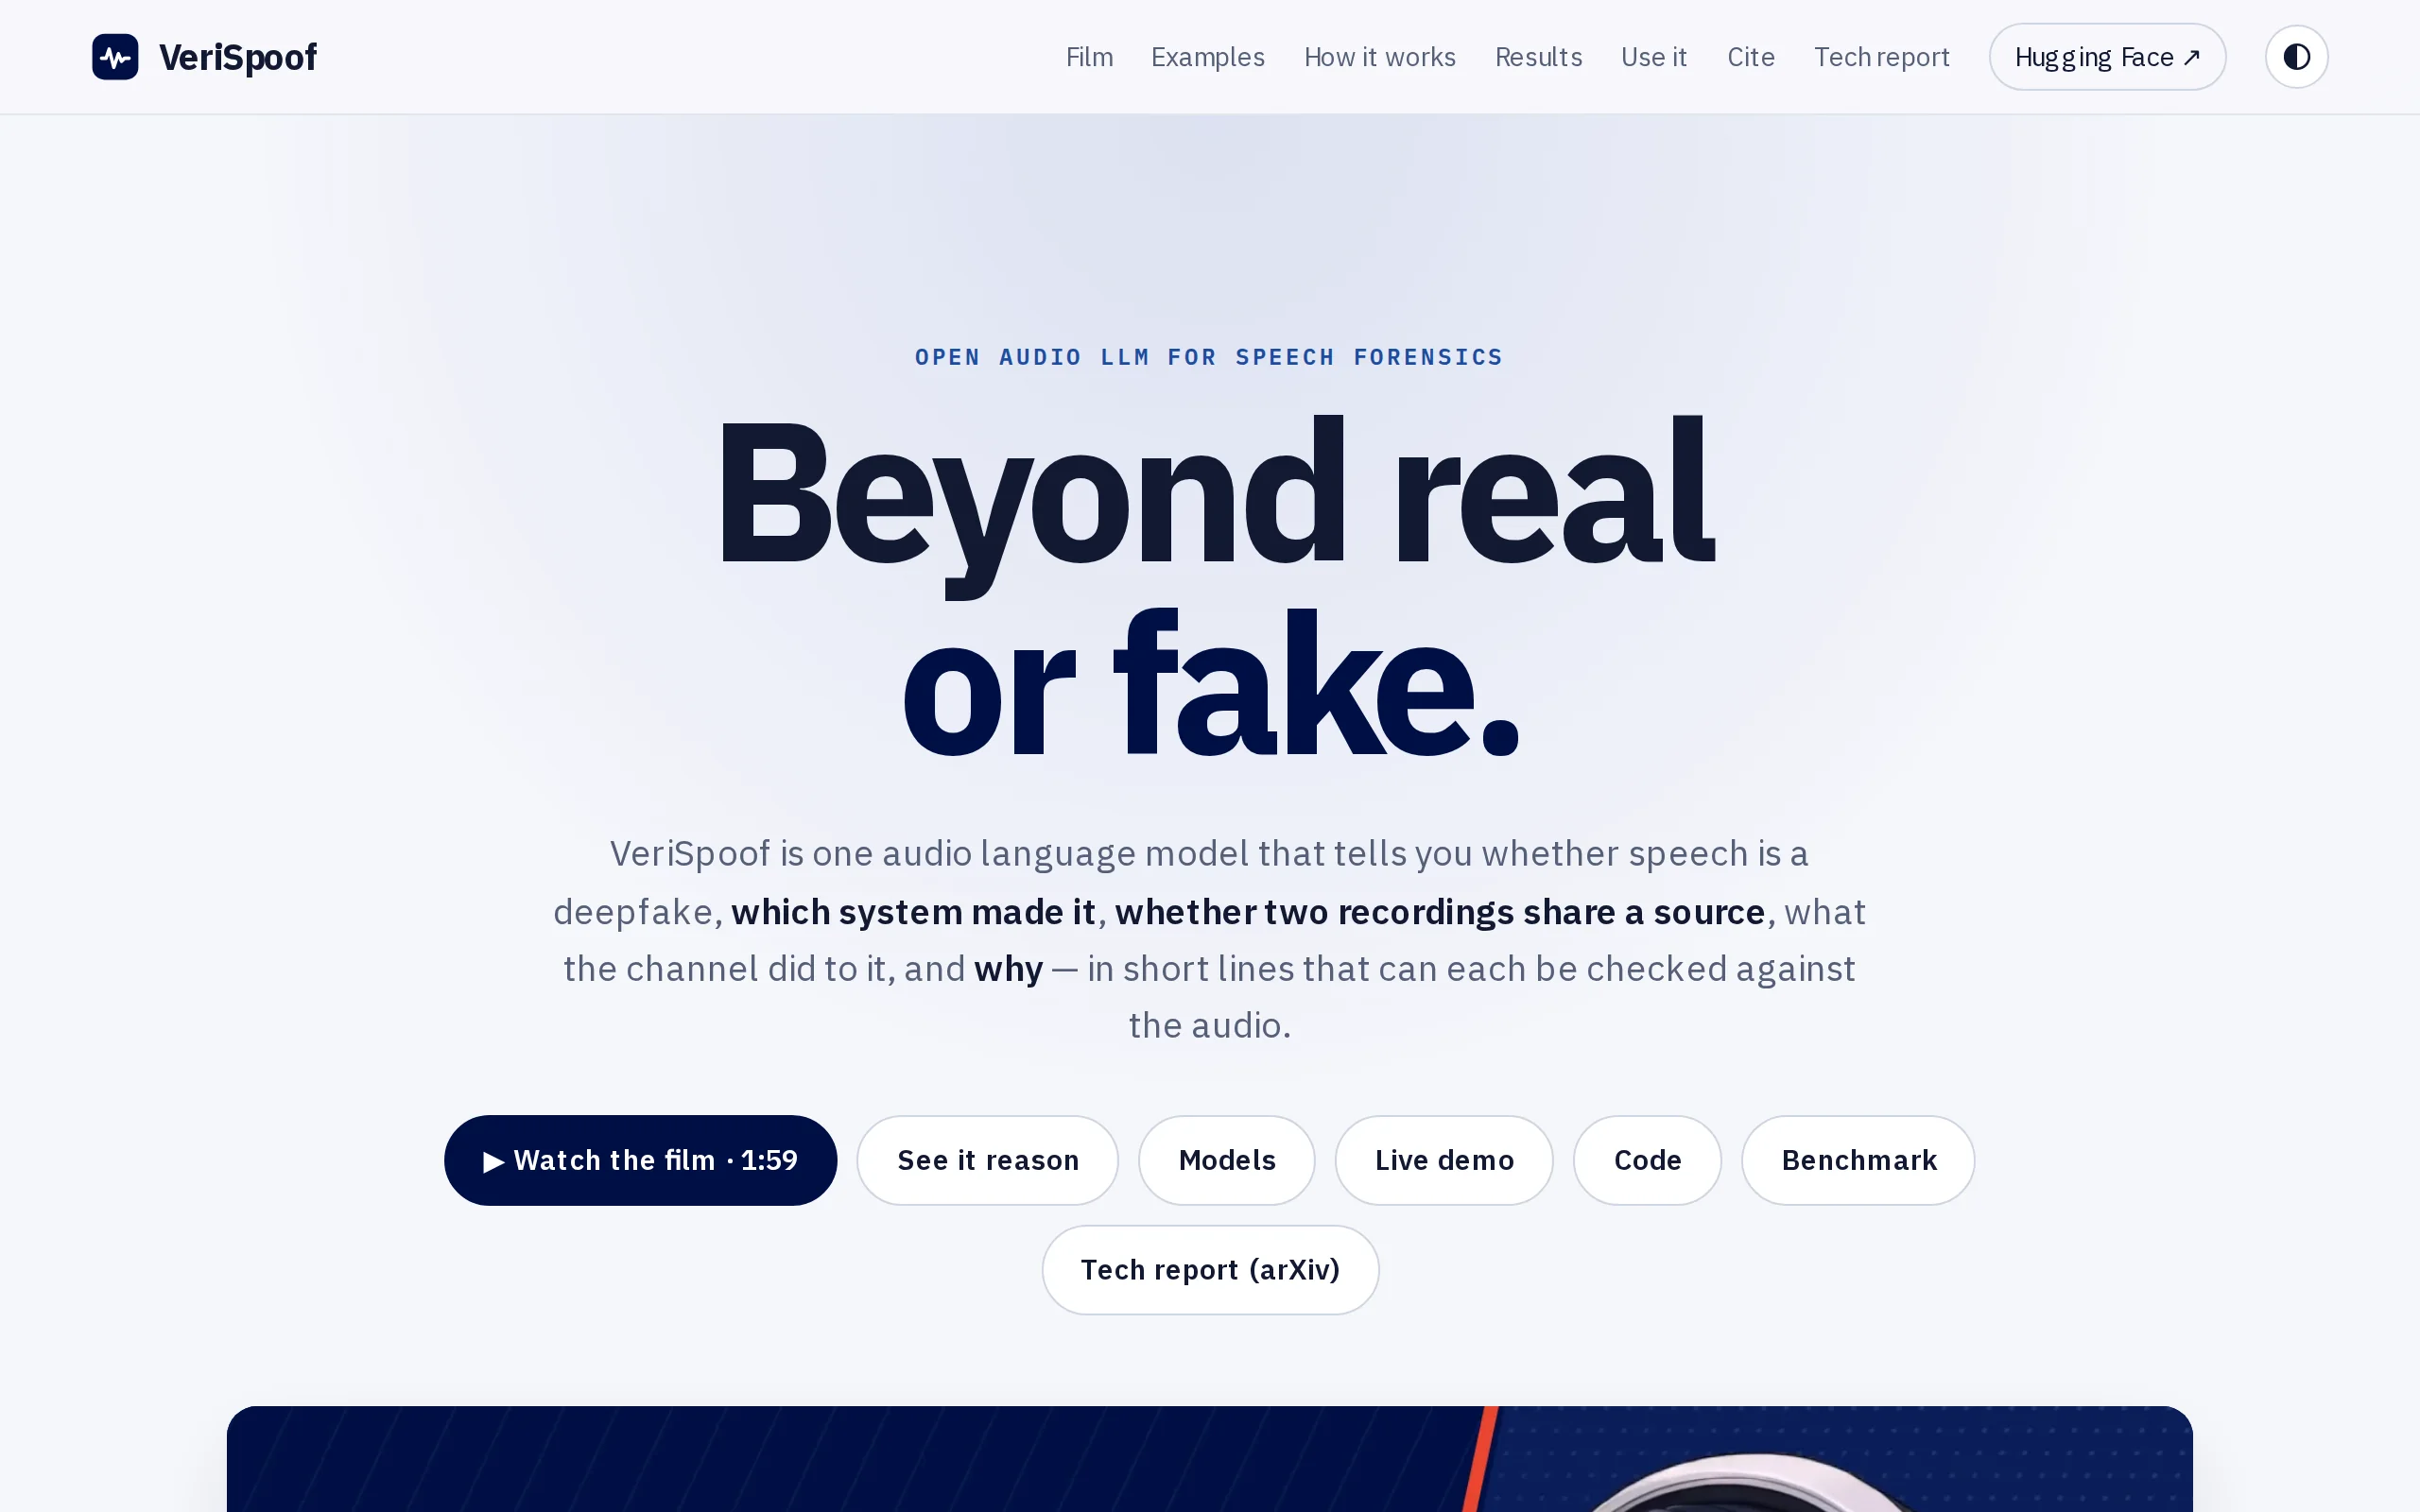
VeriSpoof是墨尔本大学推出的开源音频大模型,以2.85B参数规模仅训练29.7M参数,将语音伪造取证任务统一为对模型的自然语言提问。该模型使用同一套权重完成真伪检测、系统溯源、同源验证、信道识别和可核实推理五大类任务,在Speech-DF-Arena基准上取得合并EER 2.14%的成绩,跻身28个参评系统中的第三名、开源权重模型中的第一名。
1. VeriSpoof是什么
VeriSpoof是墨尔本大学推出的开源音频大模型,以2.85B参数规模仅训练29.7M参数,将语音伪造取证任务统一为对模型的自然语言提问。该模型使用同一套权重完成真伪检测、系统溯源、同源验证、信道识别和可核实推理五大类任务,在Speech-DF-Arena基准上取得合并EER 2.14%的成绩,跻身28个参评系统中的第三名、开源权重模型中的第一名。
技术定位与领域: 属于语音安全与伪造取证领域,是首个将语音防伪检测与溯源分析统一为生成式问答框架的音频大模型。区别于传统专用检测器仅输出二元判断,VeriSpoof构建了从"音频输入-语言模型回答-可核实推理"的完整取证链条,覆盖从信号层到语义层的多层级分析需求。
研发背景: 由墨尔本大学研究团队开发,针对语音克隆技术滥用导致的伪造音频泛滥问题,提出以生成式模型替代传统分类头的技术路线。团队观察到现有检测器普遍存在"分类头强、回答弱"的能力脱节,进而设计出以回答句对数似然作为检测分数的统一架构。
核心价值: 解决了语音取证领域长期存在的两大痛点——多任务模型割裂和推理过程不可验证。传统方案需要为检测、溯源、同源验证分别训练专用模型,而VeriSpoof以单一权重覆盖全任务链;同时引入字段化推理输出和反事实训练,使模型的每条判断结论都可追溯到波形测量或数据集标注,从根本上遏制生成式编造。
技术特点: 采用双分辨率音频分词器,以16个整句token承载全局来源信息、52个帧token保留逐0.16秒的时序细节;三阶段训练配方从感知对齐到任务学习再到反事实约束,在数据效率上实现突破——仅训练29.7M参数即在主流基准上超越众多全量微调方案。
2. 主要功能
真伪检测: 基于"伪造/真人"两个答案句的对数似然之差生成检测分数,在Speech-DF-Arena合并EER 2.14%,位列28个参评系统第三、开源权重第一。检测过程仅需单次前向传播即可同时获得标签、分数与逐token定位,无需额外生成文本,兼顾了精度与时延。
生成系统溯源: 在候选TTS/VC系统中识别具体生成器,支持按需拆分为声学模型、声码器两个独立层级分别判断,在MLAAD数据集的已见生成器12分类任务中准确率达96.8%。该能力对追踪伪造音频的生产链路、定位责任源头具有关键价值。
同源验证: 判断两段录音是否出自同一生成系统,对训练中从未见过的生成器配对EER仅为6.2%,相较于在专用检测器冻结特征上训练的配对探针(EER 26.5%)降低了77%。评估协议将未见生成器从训练数据中整体剔除,保证了泛化性能评测的纯净性。
录音条件识别: 识别音频中叠加的噪声类型、混响环境及编解码格式,Plus版本在条件识别任务上达到81.3%准确率。该功能支持还原音频的传输与处理链路,为取证分析提供信号层面的辅助线索。
可核实推理: 按观测、信道、定位、来源画像、结论五个固定字段输出推理文本,每行陈述均可对照波形测量或数据集标注独立核实;同时提供逐0.16秒的伪造片段定位能力,将局部伪造检出率从78.4%提升至99.6%。反事实训练机制确保结论仅随"哪里是合成的"这一因素翻转。
统一架构设计: 全部任务共用同一套权重,无任何任务专用分类头——检测分数来自伪造与真人答案句的对数似然之差,同源分数来自yes/no回答之差,多选题则为每个候选答案句打分取最大。该设计避免了传统"分类头强、回答答非所问"的脱节问题。
3. 应用场景
媒体与社交平台审核: 内容安全团队可集成模型检测用户上传的音频及"语音截图"是否由AI合成,有效拦截利用深度伪造克隆声音制造的虚假新闻、诈骗音频等内容。基于统一架构,平台无需部署多套专用系统即可覆盖检测与溯源双重需求。
金融与电话反欺诈: 银行和金融机构可对客服来电、转账指令录音进行实时真伪核验,防范语音克隆冒充亲属或高管的电信诈骗场景。同源验证功能还可用于关联分析——判断多通可疑电话是否出自同一生成系统,辅助锁定犯罪团伙的作案工具链。
司法取证与执法: 在语音证据鉴定中,模型输出的结构化推理报告按固定字段书写,鉴定人员可逐行对照波形测量、数据集标注和生成器元数据进行复核。伪造片段逐0.16秒定位能力为庭审质证提供了精细的技术支撑,显著提升了证据链的可靠性。
呼叫中心身份核验: 企业可利用同源验证能力判断留存录音与实时通话是否出自同一生成系统、是否为真人发声,从而降低声纹认证被合成语音绕过的风险。信道识别功能还能辅助侦测音频是否经过了异常处理,提示潜在篡改痕迹。
科研与模型评测: 作为目前开源权重中检测性能领先的统一取证模型,研究者可使用配套的VeriSpoof-Bench基准评测自有模型,开展受控对比实验。模型附带的低成本复现配方(14 GPU小时训练完成)使学术团队在有限算力下即可复现验证。
4. 如何使用
获取代码: 使用
hf download AustinXiao/VeriSpoof-Plus --include "code/**" --local-dir verispoof命令从HuggingFace拉取代码,然后执行pip install ./verispoof/code安装推理包。需确保Python环境为3.9+版本,并已安装HuggingFace Hub下载工具。加载模型: 在Python脚本中执行
from verispoof import VeriSpoof导入模块,再调用model = VeriSpoof.from_pretrained("AustinXiao/VeriSpoof-Plus")完成模型加载。首次加载将自动下载模型权重,需保持良好的网络连接。执行真伪检测: 调用
model.detect("sample.wav")即可返回标签与检测分数,检测过程与逐token定位在一次前向传播内同步完成,无需额外生成文本。适合对单条音频进行快速核验。生成可核实推理: 调用
model.explain("sample.wav")返回完整推理文本、结论、定位片段列表及逐token合成概率。需要批量处理时推荐使用vLLM后端,在NVIDIA A100上每条约0.05秒,兼顾吞吐量与成本。实施同源验证: 调用
model.same_source("a.wav", "b.wav", level="generator")判断两段录音是否出自同一生成系统,其中level参数还支持设为acoustic_model或vocoder进行层级化溯源分析。执行条件识别与自定义溯源: 调用
model.condition("sample.wav", attr="codec")识别噪声、混响或编解码类型;溯源时通过model.generator("sample.wav", ["XTTS-v2", "Bark", "VITS"])在自定义候选列表中识别具体生成系统。
5. 优缺点分析
| 优点 |
|---|
| 性能开源第一: Speech-DF-Arena合并EER 2.14%,在28个参评系统中位列第三、开源权重模型第一,且是唯一附带低成本复现配方的头部系统。 |
| 统一架构效率高: 以2.85B参数仅训练29.7M参数,14 GPU小时即可完成训练,规避了全量微调的高算力成本,同时以单一权重覆盖五类取证任务。 |
| 推理可核实性强: 输出按固定字段书写且逐行可对照波形测量或标注验证,反事实训练从训练信号上约束结论稳定性,忠实率最高可达100%。 |
| 泛化能力经严格验证: 未见生成器上同源判断EER 6.2%,较专用配对探针低77%,评估协议从数据层面剔除了测试生成器,杜绝了泄漏风险。 |
| 多粒度溯源能力: 支持在生成系统、声学模型、声码器三个层级分别判断,为追踪伪造音频生产链路提供细化视角。 |
6. 同类工具对比
| 对比维度 | VeriSpoof-Plus | DF-Arena-1B | SEAHELM系列 |
|---|---|---|---|
| 模型定位 | 统一取证问答的音频大模型 | 专精语音真伪检测的开源模型 | 音频理解基准驱动的开源模型 |
| 检测性能 | Speech-DF-Arena合并EER 2.14%,28系统第三、开源第一 | 合并EER 9.52%,明显落后 | 未聚焦防伪,更侧重通用理解 |
| 功能覆盖 | 检测、溯源、同源验证、信道识别、可核实推理五类 | 仅真伪检测 | 通用音频理解任务,不含专业取证功能 |
| 可解释性 | 输出逐行可对照波形与标注核实的推理文本,含逐0.16秒定位 | 仅输出分数,无推理过程 | 文本问答形式,但无字段化核查机制 |
| 训练成本 | 2.85B参数仅训练29.7M,14 GPU小时完成 | 1B级全量微调,无低成本配方公开 | 依赖大规模多任务训练,成本较高 |
| 开源协议 | CC BY-NC 4.0,限非商业使用 | 开源可商用 | 开源,具体协议需查证 |
| 社区生态 | 附VeriSpoof-Bench基准与可复现脚本,生态初建 | 无配套基准,社区支持有限 | 基准丰富,社区活跃 |
选型建议: 对于将检测性能与可解释性视为优先级的学术研究组和安全评测团队,VeriSpoof-Plus综合能力领先,其可核实推理和低成本复现配方具有独特价值,但需注意非商业许可对成果转化的限制。对于已在生产环境运行的传统检测方案、希望在短期内不增加算力开销的前提下完成防伪升级的企业,轻量级的专用检测器在工程集成和合规风险上更为稳妥,可考虑与VeriSpoof的离线评测结果结合进行方案选型。
7. 编辑总结
VeriSpoof在语音伪造取证领域展现了明确的技术创新性。其核心贡献在于将"检测分数"与"模型回答"在架构层面统一——以回答句的对数似然差值作为评测分数,从根本上化解了传统方案中分类头强、生成文本弱的脱节问题。这一设计思路与RAG、思维链等生成式AI演进方向保持同频,为音频取证分析提供了可复用的新范式。
从数据效率和实用价值来看,仅训练29.7M参数便在主流基准中超越众多全量微调模型,验证了感知对齐、任务学习、反事实约束三阶段训练配方的有效性。可核实推理机制的引入更是将生成式模型的输出由"猜"转变为"证",对司法、金融等要求严苛的行业场景具有重要意义。
适用人群方面,该模型对学术研究者、安全产品研发团队、内容审核服务商均有适配价值;但非商业许可协议限制了直接商用,科研验证与产品原型探索是目前最恰当的定位。
展望未来发展,若团队能补充商业授权通道并持续扩充数据增强与推理核查覆盖,该框架有望成为语音取证领域的基础设施级工具。其统一问答范式具有向其他伪造媒介(如视频、图像)延展的潜力,值得持续关注。
8. 常见问题FAQ
Q:VeriSpoof与普通语音检测器有何本质区别?
A:传统检测器将音频映射为特征后连接专用分类头,仅输出概率分数,缺乏可解释性。VeriSpoof将所有任务转化为语言模型的问答——检测分数来自"伪造/真人"答案句的对数似然之差,同源分数来自yes/no回答之差,用户直接看到被评分的回答文本,二者在架构层面完全统一,不存在脱节。
Q:模型的同源验证为什么对未见生成器表现良好?
A:得益于三阶段训练中的感知对齐设计与反事实样本训练。感知对齐阶段让音频分词器在冻结语言模型条件下充分学习携带伪造痕迹的表征,而反事实训练使模型学习"结论只随定位变化而翻转"的因果逻辑,从而对训练阶段未接触的生成器也具备较好的判断稳定性。
Q:可核实推理的"可核实"是如何实现的?
A:推理文本按观测、信道、定位、来源画像、结论五个固定字段生成,每类陈述都配有独立于模型的检查器——观测行对照波形上的带宽、SNR、电平等实测数据,信道行对照增强记录,定位行对照数据集标注。反事实样本训练保证结论仅随真伪定位翻转,从训练信号上约束了输出的验证能力。
Q:模型在哪些硬件条件下可以运行?
A:推理推荐使用具备16GB以上显存的GPU(如NVIDIA A100/V100等),使用vLLM后端批量生成时A100上每条推理约需0.05秒。CPU推理在技术上可行,但速度显著下降,不推荐用于实时检测。完整复现官方训练配方需约14 GPU小时(以A100计)。
Q:该模型能否直接用于商业产品?
A:VeriSpoof采用CC BY-NC 4.0许可协议,明确限非商业用途,不允许直接集成至商业产品中盈利。企业如需商业使用,需联系墨尔本大学团队获取授权或评估替代方案,建议将模型用于内部研究、概念验证或作为采购参考基准。
Q:与DF-Arena-1B相比有哪些优势?
A:在Speech-DF-Arena合并EER上,VeriSpoof为2.14%,DF-Arena-1B为9.52%;功能方面VeriSpoof覆盖检测、溯源、同源验证、信道识别、推理五类任务,DF-Arena-1B仅支持检测;同源验证方面VeriSpoof在未见生成器上EER 6.2%,对比模型的配对探针方案EER 26.5%。VeriSpoof同时还公开了低成本复现配方与基准工具链。
9. 项目地址
- 项目官网:https://swagshaw.github.io/verispoof/
- GitHub仓库:https://github.com/swagshaw/verispoof
- HuggingFace模型库:https://huggingface.co/collections/AustinXiao/verispoof
- arXiv技术论文:https://arxiv.org/pdf/2611.04634
相关推荐
AI开源项目周刊 – 电视换桌面、AI配音等热门项目精选
VoiceStudio是一款专注于语音合成与音频处理的本地化桌面工具,将语音生成、声音克隆、视频配音和语音转录整合进统一工作台。用户可通过参考录音或文字描述生成定制化配音,所有处理均在本地完成,隐私性强。工具支持CPU与GPU双模式运行,面向Windows、macOS(Apple Silicon)与Linux平台,适合内容创作者、有声书制作者及视频编辑人员使用。
Sophon-Realtime v1 深度评测:开源全双工语音对话模型的技术突破与工程实践
Sophon-Realtime v1 是由 AI降临派(Adventists AI)开源的全双工语音对话模型,基于 32B 参数规模设计,实现了边听边判断话轮、随时可被打断、理解语气与副语言信息、并以带感情的声音进行回应的完整对话能力。该模型在语音评测基准 VoiceBench 上取得 82.8 分,位列开源全双工模型第一,与 GPT-4o-mini-Audio 持平。项目提供 Tag(表现力强)...
MOSS-Live – 模思智能推出的全双工实时交互系统
MOSS-Live是模思智能推出的全双工实时交互系统,其核心突破在于实现语义级全双工对话控制,让AI能够在持续倾听的同时动态判断回应、等待或接受打断的时机,实现类人的自然交流节奏。系统采用前后台协同架构,将实时交互与复杂任务解耦,前台模型负责持续的语音、画面与环境声多模态感知,后台模型异步执行查询、规划等深度推理任务,在不打断对话的前提下完成工作并主动反馈结果。该产品基于复旦MOSS团队的技术积累...
Nemotron 3.5 Transcribe – 英伟达开源的语音大模型
Nemotron 3.5 Transcribe 是英伟达推出的开源语音大模型,采用语音编码器加 MoE 架构,约 43 亿活跃参数,支持 40 种语言,可处理最长 1 小时、最多 8 人讲话的录音,覆盖逐字转写、说话人区分、语音翻译等功能。该模型通过语音增强语言模型(SALM)架构将语音编码器与冻结的说话人分离模型接入大语言模型,实现了带说话人标注的转写能力。Nemotron 3.5 Transc...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。