
VibeThinker-3B – 微博开源的 30 亿参数密集推理模型
导读摘要:
VibeThinker-3B是新浪微博AI团队开源的30亿参数密集推理模型,基于Qwen2.5-Coder-3B基座,通过升级版Spectrum-to-Signal后训练流程,在数学、编程等可验证推理任务上达到Gemini 3 Pro、Claude Opus 4.5等千亿级前沿大模型的同级性能。该模型以极小参数规模探索小模型能力边界,与传统Scaling Law形成互补,为低算力环境下的高性能推理...
1. VibeThinker-3B是什么
VibeThinker-3B是新浪微博AI团队开源的30亿参数密集推理模型,基于Qwen2.5-Coder-3B基座,通过升级版Spectrum-to-Signal后训练流程,在数学、编程等可验证推理任务上达到Gemini 3 Pro、Claude Opus 4.5等千亿级前沿大模型的同级性能。该模型以极小参数规模探索小模型能力边界,与传统Scaling Law形成互补,为低算力环境下的高性能推理提供了全新路径。
技术定位与领域: VibeThinker-3B属于自然语言处理领域的推理密集型小模型,专门面向数学、编程、STEM等可验证推理任务。其核心定位是“以极小参数实现前沿推理性能”,与当前主流大模型依赖参数规模提升性能的路线形成差异化。模型采用密集Transformer架构,未改动基座结构,全部性能提升来自后训练技术栈的极致优化。
研发背景: 由新浪微博AI团队主导开发,团队在自然语言处理、推荐系统等领域有深厚积累。研发动机源于对Scaling Law边界的反思——随着参数规模膨胀,训练和部署成本急剧上升,而小模型在特定任务上仍有巨大潜力未被挖掘。VibeThinker-3B旨在证明通过精细化的训练策略,小模型可在可验证推理领域与大模型比肩,从而降低AI应用门槛。
核心价值: 解决了“小模型推理能力上限”这一关键问题。传统观点认为推理能力随参数规模单调增长,但VibeThinker-3B以3B参数在AIME’26数学竞赛中达到94.3分,在LiveCodeBench编程测试中达到80.2 Pass@1,性能超越许多百亿级模型。其价值在于为资源受限场景(如手机、IoT设备、离线环境)提供了高性能推理引擎,同时为学术界探索小模型推理上限提供了基准。
技术特点: 采用Spectrum-to-Signal后训练范式,将训练分为“频谱阶段”(SFT扩展能力覆盖)和“信号阶段”(RLVR精准优化可验证任务)。创新性地引入两阶段课程SFT、多样性探索蒸馏、MGPO强化学习和多领域顺序RL(Math→Code→STEM)等技术,并支持测试时缩放(CLR)策略,可在推理阶段进一步提升答案可靠性。
2. 主要功能
高难度数学推理: 在AIME’26竞赛中达到94.3分,HMMT’25达89.3分,BruMO’25达93.8分。模型能够处理复杂数学竞赛题,输出带完整推理链(CoT)的解答,支持多路径探索。其数学能力已接近或超越部分人类金牌选手水平,远超同参数级别模型。
竞技编程: LiveCodeBench v6测试中达到80.2 Pass@1,LeetCode最新周赛/双周赛通过率高达96.1%。模型不仅能够生成正确代码,还能提供详细解题思路和复杂度分析。在编程领域,其表现可与闭源大模型Claude Opus 4.5相媲美。
STEM推理: 在IMO-AnswerBench上达到76.4分,结合CLR策略后提升至80.6分。支持物理、化学、生物等科学问题的逐步推导,能够处理多步骤计算和逻辑推理。该功能对STEM教育场景尤为重要。
指令遵循: IFBench测试达到74.5分,具备格式敏感和约束检查能力。模型能够准确理解复杂指令要求(如输出格式、长度限制、特定术语使用等),在对话和任务执行中表现出良好的可控性。
测试时缩放(CLR): 引入Claim-Level可靠性评估策略,可在推理阶段对模型生成的中间推理步骤进行逐条验证,筛选出最可靠的答案路径。该功能无需重新训练,仅在推理时增加少量计算开销即可提升准确率,尤其适合数学等需要精确结果的场景。
多领域顺序强化学习: 严格按Math→Code→STEM的顺序依次进行强化学习,实验发现此顺序对整体效果最优。模型在每个领域上独立优化,避免不同任务间的干扰,同时保留完整64K长上下文推理轨迹,确保深度推理能力。
离线自蒸馏: 筛选高质量推理轨迹进行统一蒸馏,优先学习学生模型尚未掌握的正确路径。该技术避免了传统蒸馏中“教师模型输出可能包含错误”的问题,通过自我对比提升模型在困难样本上的表现。
3. 如何使用
环境要求: 模型基于Qwen2.5-Coder-3B架构,推荐使用支持CUDA 12.0+的NVIDIA GPU(如RTX 3090/4090或A100),显存需求约8GB(FP16)或16GB(FP32)。操作系统建议Linux(Ubuntu 20.04+)或Windows 10+,需安装Python 3.9+及PyTorch 2.0+。
下载模型: 访问HuggingFace模型库((链接待官方发布后更新) Transformers格式发布,可直接通过
transformers库加载。建议使用git lfs下载大文件。本地部署: 使用以下Python代码加载模型并启动推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("WeiboAI/VibeThinker-3B", torch_dtype="auto", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("WeiboAI/VibeThinker-3B")
模型支持消费级GPU运行(如RTX 3090 24GB可流畅运行),也可在CPU上推理但速度较慢。
调用推理: 输入数学、编程或STEM类问题,模型将输出带完整推理链(CoT)的答案。示例:
prompt = "Solve: Let x be a positive integer. Find the smallest x such that x^2 + 5x + 6 is a perfect square."
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=2048, temperature=0.6, top_p=0.9)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
启用CLR(可选): 对数学类任务可开启Claim-Level可靠性评估。需额外加载CLR验证模块(详见GitHub仓库中的
clr.py),在推理时对模型输出的每个推理步骤进行可靠性打分,最终选择得分最高的答案路径。该功能可进一步提升准确率约3-5个百分点,但会增加约20%的推理时间。注意事项: 模型针对可验证推理任务优化,在开放式对话、创意写作等非结构化任务上表现可能不如通用大模型。建议使用温度参数0.6-0.8以平衡多样性与准确性,数学题推荐0.6,编程题推荐0.8。长上下文推理(超过4096 tokens)需确保GPU显存足够,或使用梯度检查点技术。
4. 优缺点分析
| 优点 |
|---|
| 极小参数前沿性能: 仅3B参数即可在AIME’26、LiveCodeBench等基准上达到千亿级模型水平,验证了小模型推理能力的巨大潜力,颠覆了“参数越大越强”的传统认知。 |
| 完全开源: 论文、代码、模型权重全部开源(Apache 2.0许可),支持商业和学术用途,开发者可自由复现、修改和部署,降低了高性能推理模型的获取门槛。 |
| 测试时缩放(CLR): 引入Claim-Level可靠性评估策略,可在推理阶段动态提升答案可靠性,无需重新训练,为小模型提供了一种“即插即用”的精度增强手段。 |
| 多领域顺序RL: 严格按Math→Code→STEM顺序进行强化学习,实验证明该顺序最优,避免了多任务学习中的负迁移问题,每个领域都能获得独立优化。 |
| 离线自蒸馏: 通过筛选高质量轨迹进行自我蒸馏,优先学习模型尚未掌握的正确路径,有效提升了困难样本的泛化能力,且不依赖外部教师模型。 |
5. 同类工具对比
| 维度 | VibeThinker-3B | Claude Opus 4.5 | Gemini 3 Pro |
|---|---|---|---|
| 参数规模 | 3B(密集) | 未公开(推测数百B~千亿级) | 未公开(推测数百B级) |
| 开源程度 | 完全开源(论文+代码+权重,Apache 2.0) | 闭源(仅API/产品) | 闭源(仅API/产品) |
| 部署方式 | 本地消费级GPU可运行(RTX 3090) | 仅云端API | 仅云端API |
| 核心定位 | 可验证推理专用引擎 | 通用智能助手 | 通用多模态智能助手 |
| 数学推理(AIME’26) | 94.3分 | 约92分(非官方,推测) | 约93分(非官方,推测) |
| 编程推理(LiveCodeBench v6) | 80.2 Pass@1 | 约78 Pass@1(非官方) | 约82 Pass@1(非官方) |
| 上下文长度 | 64K | 200K | 1M |
| 测试时缩放支持 | 是(CLR) | 否(仅静态推理) | 否 |
| 许可协议 | Apache 2.0 | 商业闭源 | 商业闭源 |
选型建议: 对于需要本地部署、低算力环境且专注于数学、编程等可验证推理任务的用户,VibeThinker-3B是最优选择。其完全开源、消费级GPU可运行的特点使其成为教育、科研和边缘端推理的理想引擎。相比之下,Claude Opus 4.5和Gemini 3 Pro在通用任务和长上下文处理上更强,但完全依赖云端API,成本较高且受网络限制。DeepSeek-R1-1.5B参数更小但性能明显落后,适合对推理质量要求不高的极低算力场景。若用户需要同时处理多模态任务(如图像、视频),则Gemini 3 Pro更为合适。总体而言,VibeThinker-3B在“小参数+高性能”的交叉点上具有独特优势。
6. 编辑点评
VibeThinker-3B在技术创新性上令人印象深刻。其Spectrum-to-Signal后训练范式将训练拆分为“频谱阶段”(能力覆盖)和“信号阶段”(精准优化),逻辑清晰且可复现。两阶段课程SFT、多样性探索蒸馏、MGPO强化学习等技术的组合使用,展现了团队对训练策略的深刻理解。特别是多领域顺序RL(Math→Code→STEM)的实验发现,为后续小模型训练提供了宝贵经验。CLR测试时缩放策略更是点睛之笔,让模型在推理阶段也能动态优化,这种“训练+推理”双层优化思路具有很高的学术价值。
在实用价值方面,VibeThinker-3B直接降低了高性能推理模型的使用门槛。3B参数意味着可以在千元级消费级GPU(如RTX 3060 12GB)上运行,甚至部分手机端SoC(如高通骁龙8 Gen3)也能通过量化实现本地推理。这对于教育、编程竞赛、边缘AI等场景意义重大。不过,模型在通用任务上的短板也限制了其作为“全能助手”的潜力,用户需要明确其适用边界。
适用人群包括:AI研究人员(探索小模型推理上限)、算法竞赛选手(辅助解题)、编程学习者(刷题辅导)、STEM教育从业者(智能辅导工具)、以及需要在离线或低算力环境下部署推理功能的开发者。
未来发展潜力巨大。随着Spectrum-to-Signal范式的成熟,团队可能将其扩展到更多基座模型和更多任务类型。若能在保持推理性能的同时增强通用对话能力,VibeThinker系列有望成为小模型领域的标杆。此外,CLR策略若能与动态量化、模型剪枝等技术结合,将进一步提升小模型的实用性和效率。
7. 应用场景
算法竞赛备赛: 参赛者可使用VibeThinker-3B辅助解答AIME、HMMT、IMO等数学竞赛题目。模型能够输出多路径推理参考,帮助选手理解不同解法思路,提升解题效率。在备赛阶段,可作为智能陪练反复训练。
编程面试训练: 求职者在刷LeetCode、LiveCodeBench等编程题时,可借助模型获取带详细解释的正确解法。模型不仅给出代码,还会分析时间/空间复杂度、边界条件和测试用例,帮助用户深入理解算法本质。
STEM教育辅导: 教师或学生可向模型提出物理、化学、生物等理科问题,获得逐步推导的解题过程。模型支持多步骤计算和公式推导,适合作为课后辅导工具,尤其适合自学场景。
边缘端推理部署: 因模型仅3B参数,可通过量化(如INT4)压缩至约1.5GB,适合手机、IoT设备、树莓派等低算力环境本地运行。开发者可将其嵌入教育类APP、离线编程助手等产品中,无需联网即可提供高质量推理服务。
推理能力研究: 学术界可将VibeThinker-3B作为小模型推理上限的探索基准,研究Scaling Law的替代路径。其完全开源的技术报告和训练代码,为后续研究提供了可复现的实验基础。
8. 常见问题FAQ
Q:VibeThinker-3B与Qwen2.5-Coder-3B相比,性能提升了多少?
A:在AIME’26数学竞赛上,Qwen2.5-Coder-3B的得分约为40分,而VibeThinker-3B达到94.3分,提升超过50分。在LiveCodeBench v6上,基座模型Pass@1约为30%,VibeThinker-3B达到80.2%。提升主要来自Spectrum-to-Signal后训练流程的极致优化,包括两阶段SFT、多样性蒸馏和多领域RL。
Q:模型能否用于通用对话或内容生成?
A:VibeThinker-3B主要针对可验证推理任务优化,在开放式对话、创意写作等非结构化任务上表现一般。若需要通用能力,建议使用Qwen2.5-3B-Instruct或类似通用模型。不过,模型在指令遵循方面表现不错(IFBench 74.5分),可以处理简单的格式约束任务。
Q:CLR(Claim-Level可靠性评估)具体如何工作?
A:CLR在推理阶段对模型生成的每个推理步骤(Claim)进行逐条可靠性评估。它使用一个轻量级验证器(基于同一模型的微调版本)对每个步骤的正确性打分,然后选择得分最高的完整推理路径作为最终答案。这相当于在推理时进行“自我纠错”,无需重新训练即可提升准确率约3-5个百分点。
Q:模型需要多少GPU显存?能否在消费级显卡上运行?
A:FP16精度下约需8GB显存,FP32约需16GB。RTX 3090(24GB)、RTX 4090(24GB)可流畅运行,RTX 3060(12GB)可通过4-bit量化(约3GB显存)运行。支持CPU推理但速度较慢(生成100 tokens约需30秒)。官方推荐使用NVIDIA GPU,AMD GPU可通过ROCm支持。
Q:如何复现论文中的训练结果?
A:论文和代码已完全开源,包括Spectrum-to-Signal训练流程、两阶段SFT脚本、MGPO RL代码等。用户需准备至少4块A100 80GB GPU(或等效算力),并按照GitHub仓库中的train/目录下的README逐步操作。训练数据部分来自公开数据集(如MATH、GSM8K、CodeContests等),部分为内部构造,但团队已提供数据生成脚本。
Q:模型支持中文输入吗?
A:基座模型Qwen2.5-Coder-3B支持中英文混合输入,VibeThinker-3B保留了这一能力。中文数学题和编程题均可正常处理,但训练数据以英文为主,中文场景下的性能略低于英文。建议用户输入英文问题以获得最佳效果。
9. 项目地址
- GitHub仓库:https://github.com/WeiboAI/VibeThinker
- HuggingFace模型库:https://huggingface.co/WeiboAI/VibeThinker-3B
- arXiv技术论文:https://arxiv.org/pdf/2606.16140
- 微博AI官方组织:https://github.com/WeiboAI
相关 AI 模型文章
VeriLoop E2 – 清华大学开源的 27B 后训练模型
VeriLoop E2 是清华大学深圳国际研究生院机器人实验室开源的 27B 后训练模型,基于 Qwen3.8-27B 底座,面向代码、数学与物理推理场景。该模型采用 Apache-2.0 协议发布权重与分词器,原生支持 262,144 tokens 的上下文窗口。其核心创新在于 VGR(VeriLoop-Governed Recurrence)机制,将"模型提案"与"外部验证/持久化"彻底分离,...
Clef – Cloudflare 开源的决策模型家族深度评测
Clef是Cloudflare开源的一组决策模型家族,其核心定位并非生成开放式文本,而是在请求中临时定义问题、为每个候选选项输出概率化评分,让代码据此执行路由、拦截或升级人工等后续动作。与传统分类器需要针对新增类别反复重训不同,Clef允许在推理时动态定义类别,显著提升了决策系统的灵活性与迭代效率。该家族包含两个规格:27B参数的Clef主打精度,在Jev Decision Index基准上排名第...
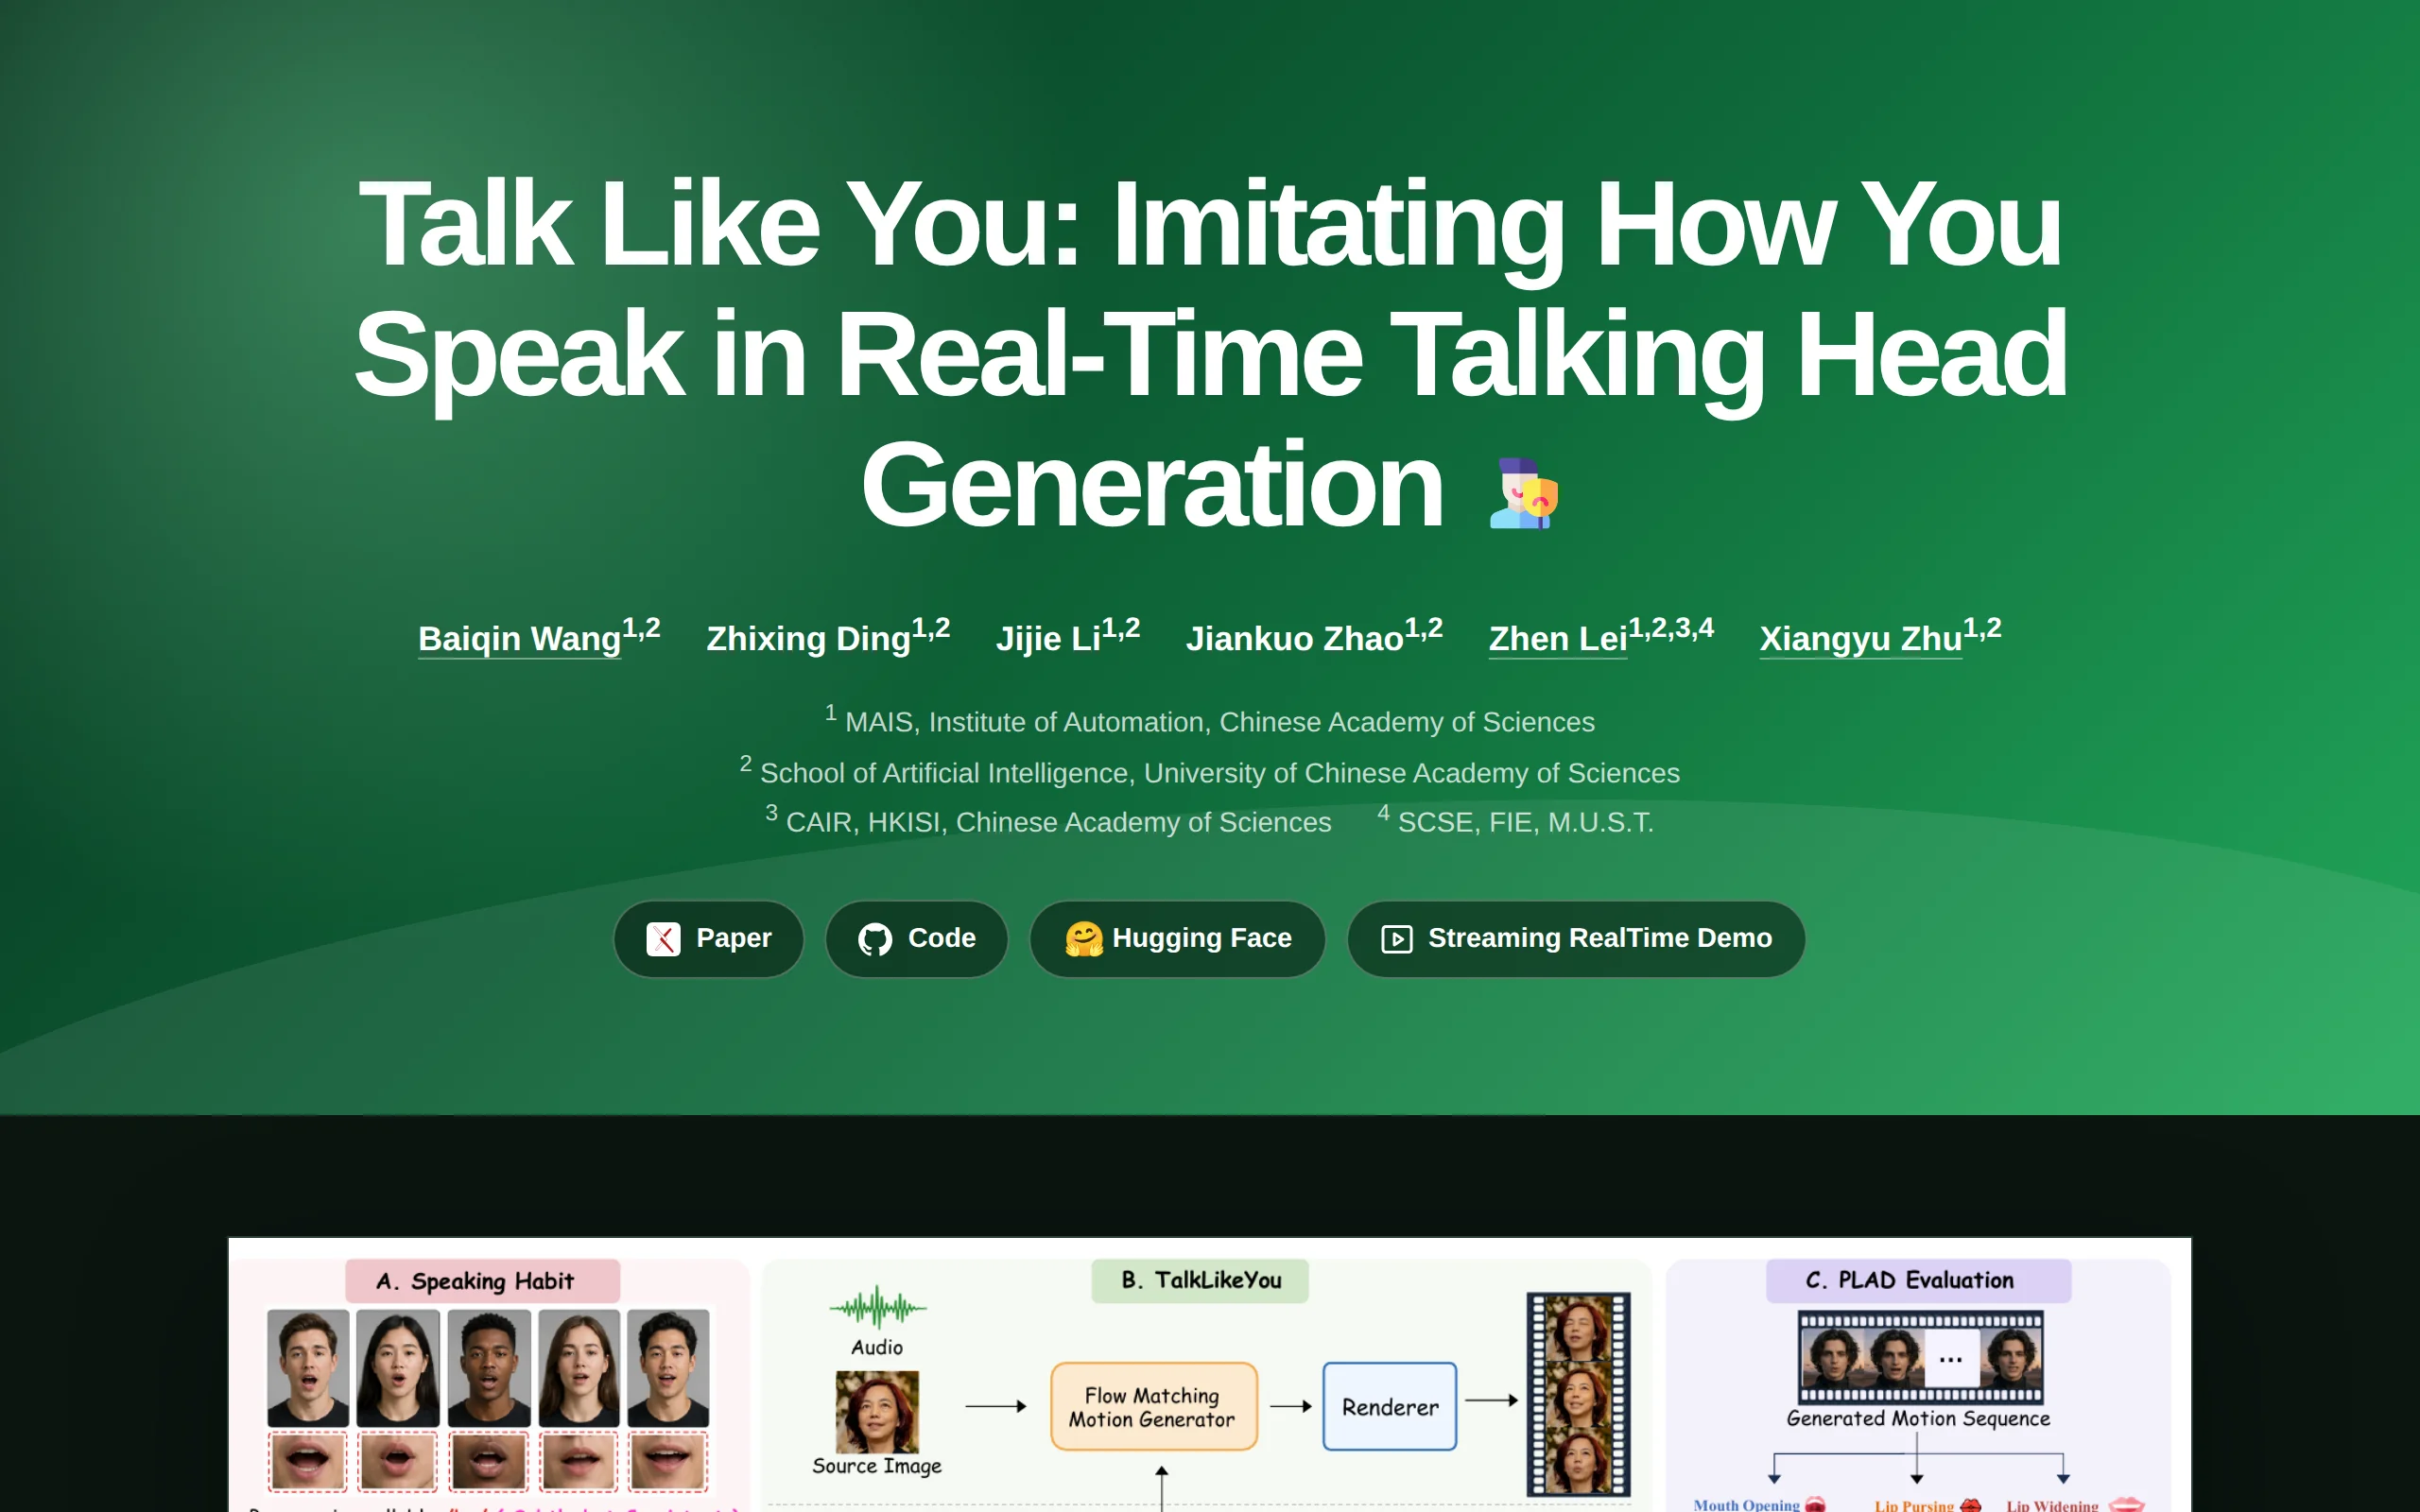
TalkLikeYou —— 中科院自动化所开源的实时数字人框架深度评测
TalkLikeYou 是由中国科学院自动化研究所开源的一款实时数字人(Talking Head)生成框架,其核心能力在于仅凭一张人像照片和一段音频,即可驱动照片中的人物开口说话,且嘴部动作能够精准模仿指定真人的个性化说话习惯。该框架通过运动空间建模与一步采样技术,在单张 RTX 3090 显卡上实现了 32.43 FPS 的实时生成速度,打破了以往数字人生成在速度与画质之间的平衡限制。项目代码与...
Mellum2.1 深度评测:JetBrains 开源智能体编程模型的技术跃迁
Mellum2.1 是 JetBrains 推出的开源 AI 编程模型,采用 12B 混合专家(MoE)架构,每次推理仅激活 2.5B 参数。该模型的核心突破在于将强化学习(RL)从传统训练流程中的收尾环节提升为训练主体,结合数百万次沙盒环境运行,使模型能够自主探索代码库、编辑文件并自查修改,智能体编程能力实现显著跃升。在高负载场景下,Mellum2.1 的吞吐能力接近 Qwen3.5-9B 的两...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。