
WBench – 美团推出的交互式视频世界模型多轮评测基准
导读摘要:
WBench是由美团LongCat团队推出的首个系统性多轮评测基准,专为交互式视频世界模型设计。该基准包含289个测试案例和1058个交互轮次,覆盖自然、城市、室内、工作区、幻想、运动共6类场景与写实、动漫、卡通、油画、水墨、扁平、素描7种艺术风格。WBench通过统一交互接口对20个前沿模型进行标准化评估,精准定位模型从被动观看到主动交互的能力边界,揭示当前世界模型在多轮交互、导航控制和视角切换...
1. WBench是什么
WBench是由美团LongCat团队推出的首个系统性多轮评测基准,专为交互式视频世界模型设计。该基准包含289个测试案例和1058个交互轮次,覆盖自然、城市、室内、工作区、幻想、运动共6类场景与写实、动漫、卡通、油画、水墨、扁平、素描7种艺术风格。WBench通过统一交互接口对20个前沿模型进行标准化评估,精准定位模型从被动观看到主动交互的能力边界,揭示当前世界模型在多轮交互、导航控制和视角切换等维度的核心短板,为行业提供了首个可量化、可复现的交互式视频世界模型评测框架。
技术定位与领域: WBench属于AI评测基准领域,聚焦于交互式视频世界模型这一新兴方向。相较于传统视频生成评测(仅关注单帧质量或短时序一致性),WBench首次将“多轮交互”纳入评测体系,填补了行业在动态交互场景下模型能力评估的空白。
研发背景: 由美团LongCat团队主导开发,该团队长期深耕视频生成与世界模型技术。随着Genie、Kling、Wan等交互式视频模型快速演进,业界亟需一个统一、公平、多轮的评测标准来衡量模型在真实交互场景中的表现。WBench应运而生,旨在推动该领域的标准化进程。
核心价值: WBench的核心价值在于系统性地解决了交互式视频世界模型评测的三大难题:一是缺乏多轮交互评测框架,导致模型在长程交互中的错误累积无法被量化;二是不同模型输入协议异构(文本、6DoF、离散动作),难以公平对比;三是场景与交互耦合过紧,无法精准定位模型短板。WBench通过场景-交互解耦设计、统一Action Router接口以及五维评测套件,实现了对模型能力的“CT扫描”式诊断。
技术特点: 采用四大核心要素架构(世界定义+指令集+统一交互接口+评测套件),实现场景与交互的独立配置与自由组合。评测流程采用自回归多轮机制,每一轮输出帧作为下一轮输入,模拟真实交互闭环,能够精准测量模型在长程交互中的性能衰减(如导航能力多轮后平均下降33点)。
2. 主要功能
多维度世界定义: 支持6类场景(自然、城市、室内、工作区、幻想、运动)和7种艺术风格(写实、动漫、卡通、油画、水墨、扁平、素描)的自由组合,同时提供第一人称、第三人称、具身第一人称三种视角,构建了丰富且可控的测试环境,覆盖从现实到虚构的广泛域。
四类核心交互: 提供导航(前进、后退、转向等)、主体动作(奔跑、跳跃、抓取等)、事件编辑(添加物体、改变天气等)、视角切换(自由视角、锁定目标等)四种交互方式,全面模拟用户在虚拟世界中的典型操作,覆盖了从基础移动到高级场景编辑的全链路需求。
统一交互接口(Action Router): 通过Action Router将文本指令、6DoF坐标(六自由度位姿)、键盘离散动作统一映射为标准化输入,适配不同模型的原生接口(如Kling 3.0的文本驱动、HY-World 1.5的动作控制),实现异构模型间的公平对比,消除了协议鸿沟。
五维评测套件: 从视频质量(清晰度、帧稳定性)、设定遵循度(场景/风格匹配度)、交互遵循度(动作执行准确性)、一致性(时序连贯性)、物理真实性(重力、碰撞等物理规则)五个维度进行量化评分,包含NavScore(导航准确率)、Gated Spatial Consistency(空间一致性门控指标)等硬核指标,输出雷达图与得分表。
多轮长程评估: 支持连续多轮交互测试(默认最多8轮),采用自回归机制将上一轮输出帧作为下一轮输入,测量模型在长时间交互后的性能衰减情况。通过对比单轮与多轮得分差异,可量化模型的错误累积效应,例如导航能力在多轮后平均下降33点。
批量横向对比: 支持同时配置多个模型运行相同测试用例,自动生成横向对比数据。评测结果以雷达图与得分表形式展示,直观呈现各模型在不同维度上的强弱分布,为模型选型提供客观依据。
3. 如何使用
环境要求: 需要Python 3.8+环境,建议使用Linux或macOS系统。硬件方面,推荐配备至少16GB显存的GPU(如NVIDIA RTX 4090或A100),用于运行待测模型的推理。克隆仓库前需安装Git和pip。
克隆仓库与安装依赖: 执行
git clone https://github.com/meituan-longcat/WBench.git下载代码,然后进入目录运行pip install -r requirements.txt安装所需Python包(包括PyTorch、Transformers、OpenCV等)。下载评测数据集: 从HuggingFace仓库
meituan-longcat/WBench拉取数据集,执行命令huggingface-cli download meituan-longcat/WBench --local-dir ./data。数据集包含289个测试案例的配置文件(JSON格式)和1058个交互轮次的指令序列。接入待测模型: 通过Action Router接口适配模型。首先在
config/models.yaml中注册模型名称和调用方式(如文本驱动模型需提供API端点,专用世界模型需提供本地推理脚本)。WBench提供了示例适配代码,开发者可按需修改。定义测试场景: 在
config/scenario.yaml中选择场景类型(如“自然”)、艺术风格(如“写实”)、主体对象(如“人物”)、观察视角(如“第一人称”)。支持自定义组合,也可直接使用预置的289个案例。选择交互指令集: 在
config/interaction.yaml中从导航、主体动作、事件编辑、视角切换四类交互中组合测试动作。例如可设置“先前进5步,然后向右转90度,再跳跃”的序列。运行单轮测试: 执行
python run.py --mode single --scenario config/scenario.yaml --interaction config/interaction.yaml,系统会生成初始帧并执行第一轮交互,输出单轮评测得分。运行多轮测试: 使用
--mode multi --rounds 8参数启动自回归模式,将上一轮输出帧作为下一轮输入,自动完成多轮交互并记录每轮得分,最终输出性能衰减曲线。批量对比测试: 在配置文件中列出多个模型,执行
python run.py --mode batch --models model1,model2,model3,系统会并行运行相同测试用例,生成横向对比雷达图与得分表。查看评测报告: 评测结束后,结果保存在
results/目录下,包含雷达图(PNG格式)、得分表(CSV格式)以及详细的日志文件。可使用内置可视化工具python visualize.py --report results/report.json生成交互式图表。
4. 优缺点分析
| 优点 |
|---|
| 首个多轮交互评测基准: 填补了行业空白,系统性评估模型在连续交互中的表现,能够量化长程错误累积效应,为模型迭代提供关键方向。 |
| 场景与交互解耦设计: 场景和交互独立配置,可自由组合,精准定位模型短板(如导航能力差还是风格遵循度低),提供“CT扫描”式诊断。 |
| 五维评测套件硬核指标: 从视频质量、设定遵循度、交互遵循度、一致性、物理真实性五个维度量化评分,包含NavScore等原创指标,评估全面且可复现。 |
| 揭示关键行业洞察: 通过评测20个前沿模型,得出“文本驱动模型擅长理解,专用世界模型擅长导航”“视频质量与导航能力无关”等结论,对研发方向有直接指导意义。 |
5. 同类工具对比
| 维度 | WBench | WorldScore | VBench |
|---|---|---|---|
| 定位 | 多轮交互式视频世界模型评测 | 世界生成统一评测基准 | 视频生成质量评测基准 |
| 发布时间 | 2026年5月 | 2025年 | 2024年 |
| 案例规模 | 289案例,1058交互轮次 | 3000案例 | 1600+提示词 |
| 交互类型 | 导航、主体动作、事件编辑、视角切换 | 轨迹条件控制(无自由交互) | 无交互(仅单帧生成) |
| 多轮支持 | 原生多轮自回归评测,支持长程衰减分析 | 单场景/多场景序列,非交互式 | 不支持多轮 |
| 统一接口 | Action Router(文本/6DoF/离散动作) | 统一世界规格(布局+语义) | 不适用 |
| 评测维度 | 视频质量、设定遵循、交互遵循、一致性、物理真实性 | 可控性、质量、动态性 | 质量、风格、时序、语义 |
| 核心特色 | 多轮交互衰减诊断,场景与交互解耦 | 跨3D/4D/I2V/T2V统一评测 | 细粒度视频质量指标 |
| 开源协议 | Apache 2.0 | MIT | MIT |
| 社区生态 | 美团LongCat维护,GitHub 1.5k星 | 香港大学维护,GitHub 2k星 | 南洋理工维护,GitHub 4k星 |
选型建议: 如果您的研究或产品聚焦于交互式视频世界模型(如Genie、Kling、Wan等),且需要评测多轮交互能力、导航控制及长程衰减,WBench是唯一的选择。其场景-交互解耦设计和Action Router接口能够精准定位模型短板,适合模型迭代优化。对于传统视频生成模型的单帧质量评测,VBench提供了更丰富的视频质量指标(如动态质量、时序一致性),但缺乏交互能力评估。WorldScore虽然覆盖了世界生成的多个模态(3D、4D、I2V、T2V),但其交互仅支持轨迹条件控制,无法模拟自由交互。如果您需要快速评估多个模型的基础生成质量,EvalCrafter的自动化评分系统更为轻量。综合来看,WBench在交互式视频世界模型评测领域具有不可替代的独特价值,尤其适合需要长程交互能力的应用场景。
6. 编辑点评
WBench的推出标志着交互式视频世界模型评测从“单帧生成”迈入“多轮交互”时代。从技术创新角度看,其场景-交互解耦设计是评测框架领域的一大突破——传统评测往往将场景和交互绑定,导致难以区分模型在哪个环节失败。WBench通过“舞台与剧本分离”的理念,使评测者可以独立控制环境变量和动作指令,从而精准定位模型短板(例如,在相同场景下切换不同交互类型,观察得分差异)。此外,Action Router统一接口解决了异构模型无法公平对比的痛点,为行业标准化奠定了基础。五维评测套件中的NavScore和Gated Spatial Consistency等原创指标,从导航准确率和空间一致性角度提供了量化依据,这些指标在其他评测基准中未见。
实用价值方面,WBench的评测结果已揭示多项关键洞察:文本驱动模型(如Kling 3.0)在理解指令方面表现出色,但导航能力弱;专用世界模型(如HY-World 1.5)导航能力突出,但场景遵循度低;视频质量与导航能力几乎无关——这意味着追求高画质的同时不能忽视交互能力。这些结论对模型研发具有直接指导意义。WBench的适用人群包括:视频世界模型的研究者(用于模型迭代)、具身智能方向的研究者(评估导航与场景理解能力)、AI视频/游戏产品开发者(测试长程交互体验),以及学术评审者(作为标准化评测工具)。
未来发展潜力上,WBench可扩展的方向包括:增加更复杂的物理交互(如流体、碰撞检测)、支持更大规模的自定义场景生成、引入对抗性测试(如极端动作指令),以及提供在线排行榜以促进社区竞争。目前其案例规模(289个)相对较小,但随着模型的演进,测试案例库的扩充将是必然趋势。但瑕不掩瑜,WBench作为首个多轮交互评测基准,其创新性和实用性在行业内处于领先地位。
7. 应用场景
世界模型研发迭代: 研究人员可使用WBench对正在开发的视频世界模型(如Genie、Kling、Wan等)进行系统性评测,通过对比单轮与多轮得分、不同场景下的表现,定位模型在导航、动作执行或长程一致性上的弱点,从而针对性优化模型架构或训练策略。
导航与具身智能评估: 在机器人、自动驾驶等具身智能领域,WBench的导航交互评测(NavScore)可用于评估模型在虚拟环境中的路径规划、空间记忆与避障能力。例如,将模型接入WBench的导航指令集,测试其在多轮转向与前进后是否仍能保持位置一致性,从而判断其是否具备具身智能所需的空间推理能力。
多轮交互产品测试: 对于AI视频游戏(如虚拟世界探索类游戏)或交互式视频生成产品,WBench可模拟用户在游戏中的长程操作(如探索、解谜、场景编辑),评测模型的响应连贯性与交互跟随度。产品团队可通过WBench的批量对比功能,快速筛选出最适合其交互场景的底层模型。
学术研究基准: 高校和研究机构可将WBench作为交互式视频世界模型的标准评测框架,用于论文实验中的横向对比。WBench的公开数据集和开源代码保证了实验的可复现性,其五维评测套件提供了统一的量化指标,有助于推动该领域的标准化进程。
开源vs闭源模型选型: 企业和开发者在选择视频世界模型时,可使用WBench对多个候选模型(如开源模型vs商业API模型)进行公平对比。通过查看各模型在导航、主体动作、视角切换等维度的得分,结合自身业务需求(如需要强导航能力还是强场景遵循度),做出数据驱动的选型决策。
8. 常见问题FAQ
Q:WBench支持哪些类型的模型?
A:WBench支持所有能够生成交互式视频的模型,包括文本驱动模型(如Kling 3.0、Wan)、专用世界模型(如Genie、HY-World 1.5),以及基于扩散或自回归架构的视频生成模型。通过Action Router统一接口,模型只需适配文本、6DoF坐标或离散动作中的任意一种输入协议即可接入。
Q:WBench的评测结果可信度如何?
A:WBench的评测流程完全自动化且可复现,所有测试案例和交互指令都是公开的。五维评测套件中的指标均经过人工验证与交叉校验,例如NavScore通过计算预测轨迹与真实轨迹的匹配度来量化导航准确性。评测结果以雷达图和得分表形式输出,支持多次运行取平均,确保统计可靠性。
Q:WBench的多轮评测如何模拟真实交互?
A:采用自回归机制:第一轮输入初始帧和指令,模型输出视频帧;第二轮将上一轮输出帧作为输入,再加上新指令,如此循环。这模拟了用户在观看视频过程中不断发出新指令的真实场景。通过对比单轮与多轮得分,可以量化模型在长程交互中的错误累积效应(如导航能力下降、场景漂移等)。
Q:WBench是否支持自定义场景和交互?
A:支持。用户可以在配置文件中自由组合6类场景、7种艺术风格、5类主体对象和3种视角,也可以创建全新的场景描述(JSON格式)。交互指令集同样可自定义,支持从导航、主体动作、事件编辑、视角切换四类中选取任意动作序列。WBench的解耦设计使得场景和交互可以独立配置,极大提升了灵活性。
Q:WBench的评测对硬件有什么要求?
A:运行WBench评测套件本身对硬件要求不高(CPU即可执行评测逻辑),但运行待测模型需要相应的GPU资源。建议使用至少16GB显存的GPU(如RTX 4090或A100),具体取决于模型的规模。WBench支持多模型并行评测,可通过配置同时启动多个推理进程,但需注意显存分配。
Q:WBench与VBench有什么区别?
A:VBench主要评测单帧视频生成质量(如清晰度、动态性、时序一致性),不涉及交互能力。WBench则专注于交互式视频世界模型,评测维度包括导航、动作执行、视角切换等交互相关能力,且支持多轮长程评估。两者定位不同:VBench适用于传统文本到视频模型,WBench适用于需要用户实时控制的交互式视频模型。
9. 项目地址
相关 AI 模型文章
TalkLikeYou —— 中科院自动化所开源的实时数字人框架深度评测
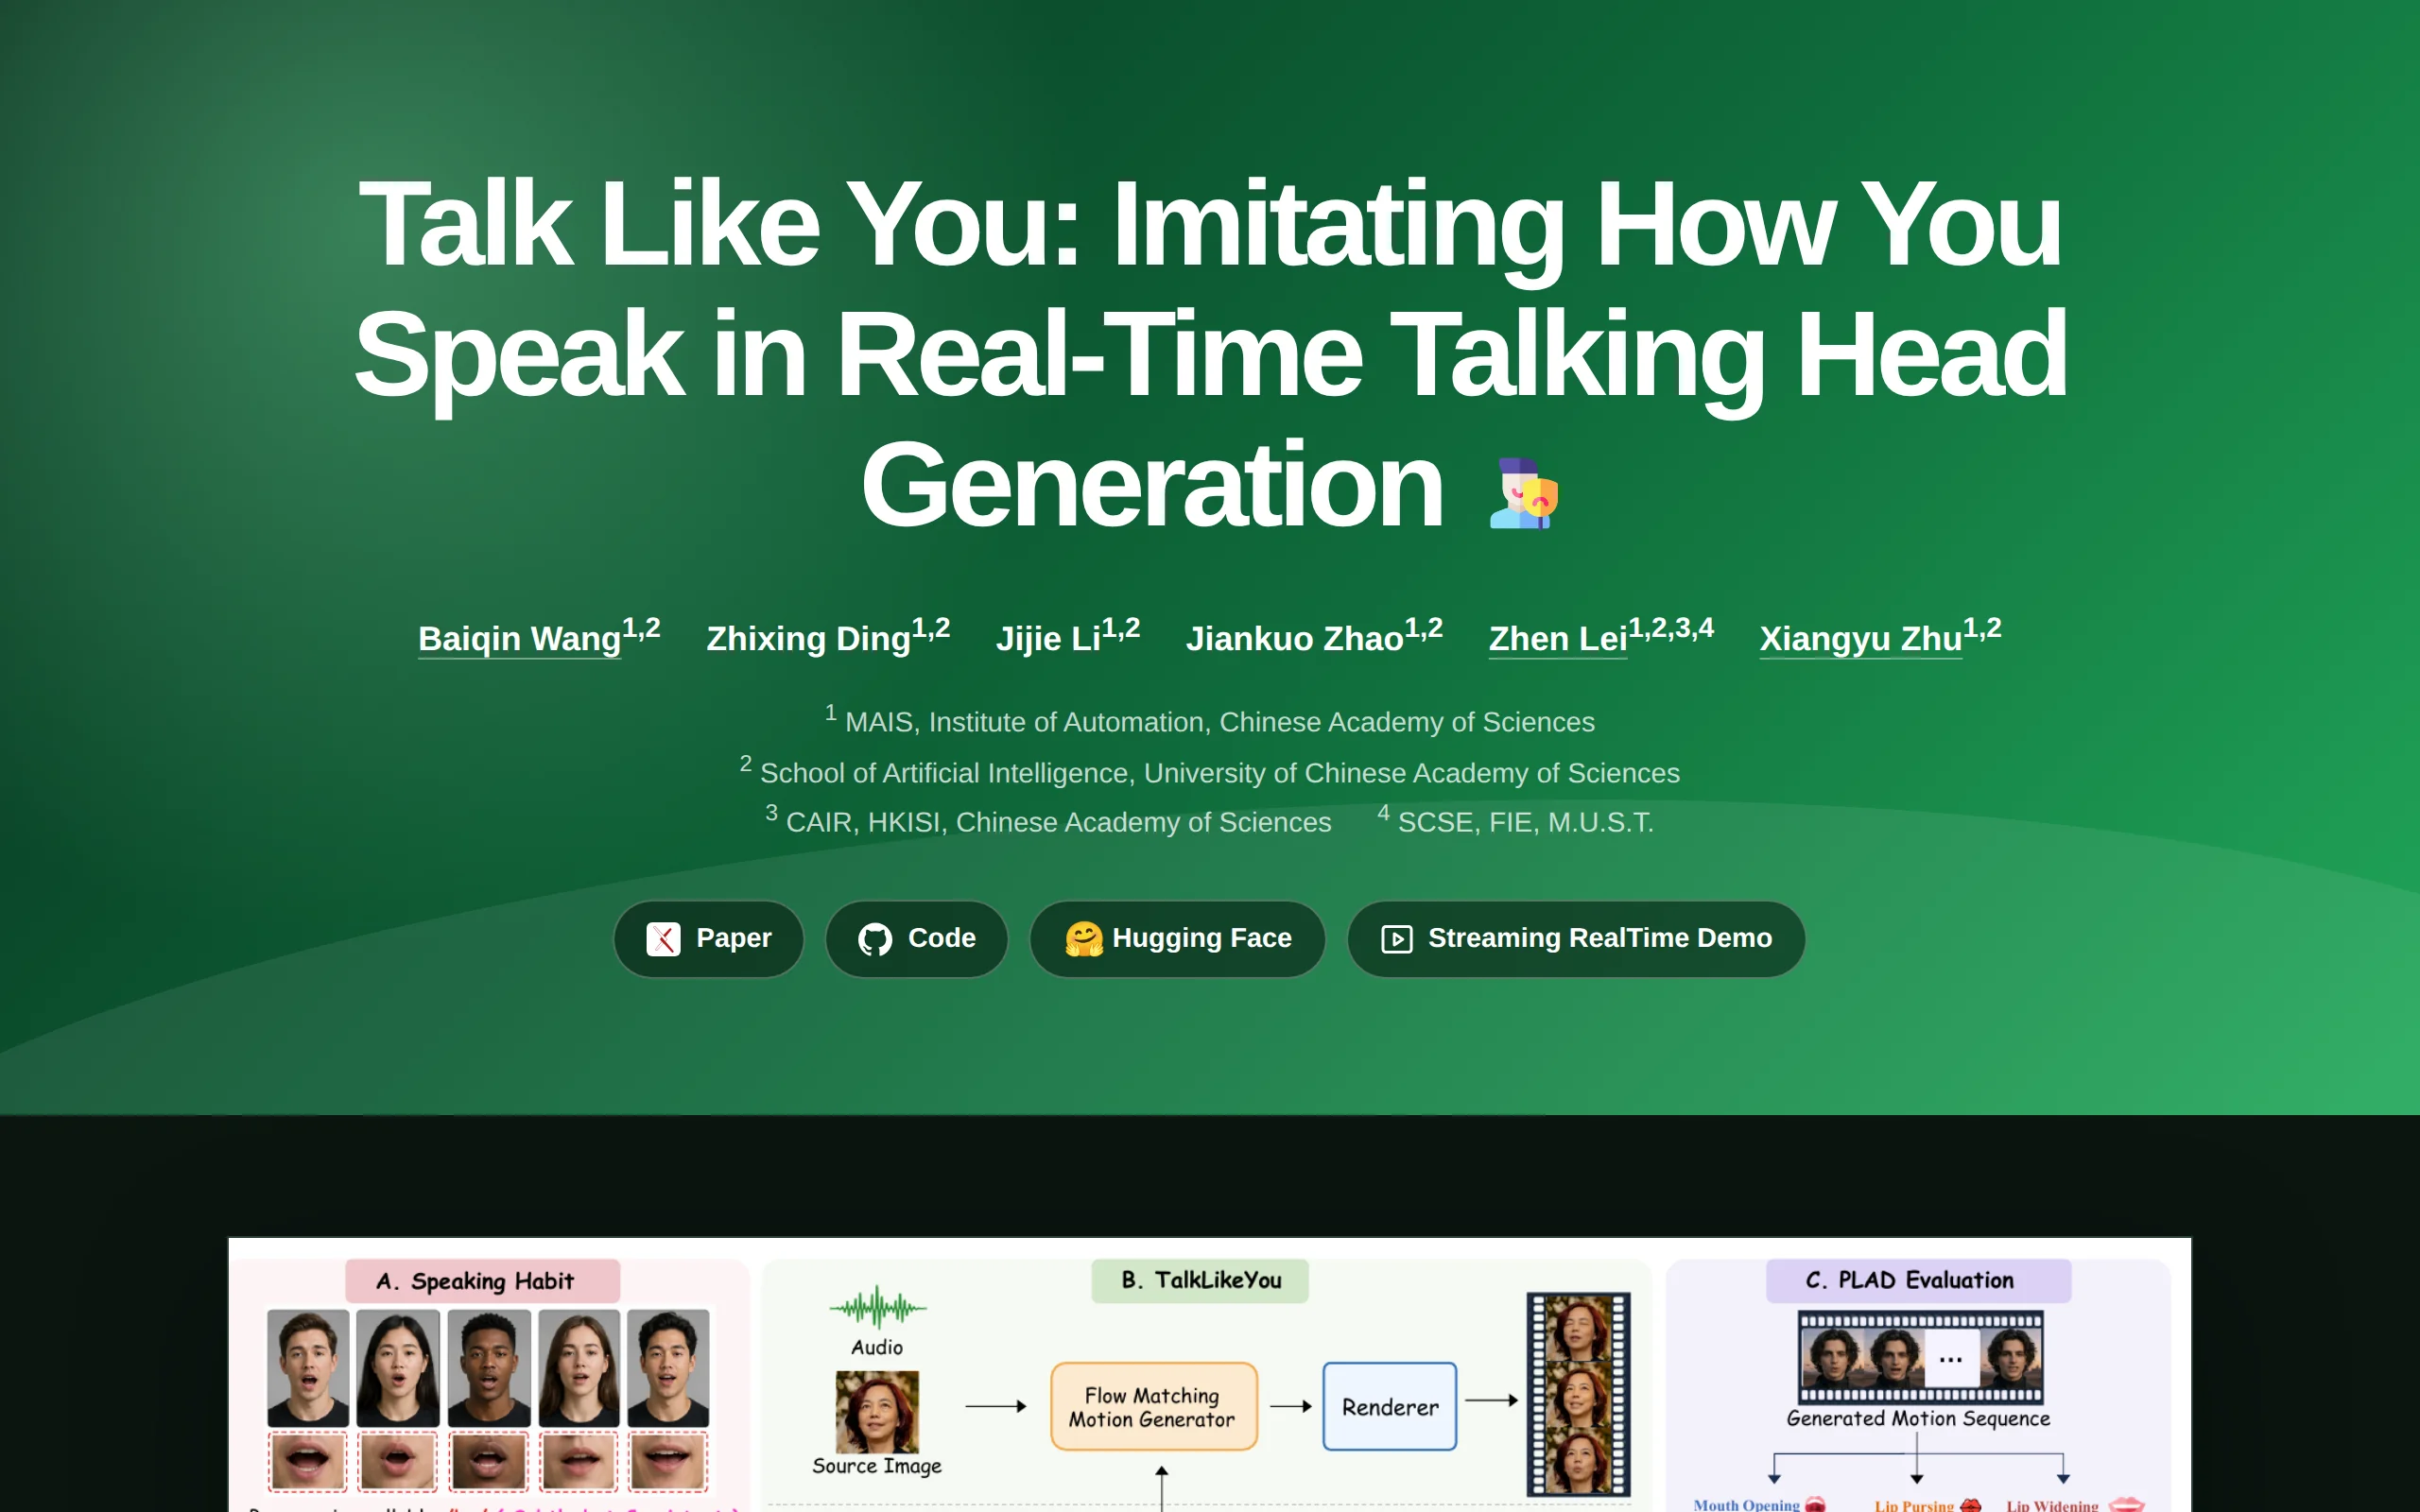
TalkLikeYou 是由中国科学院自动化研究所开源的一款实时数字人(Talking Head)生成框架,其核心能力在于仅凭一张人像照片和一段音频,即可驱动照片中的人物开口说话,且嘴部动作能够精准模仿指定真人的个性化说话习惯。该框架通过运动空间建模与一步采样技术,在单张 RTX 3090 显卡上实现了 32.43 FPS 的实时生成速度,打破了以往数字人生成在速度与画质之间的平衡限制。项目代码与...
Vidu Q4 Preview:生数科技旗舰视频生成模型的传神演绎与多主体一致性实践
Vidu Q4 Preview是生数科技于2026年10月7日推出的新一代旗舰视频生成模型的首个公开预览版,主打"传神表现力"。该模型在人物演绎层面实现显著升级,面部表情更细腻、情绪传递更饱满、肢体动作更自然,同时支持最多15张参考图与3段参考音频,可在生成全程锁定人物形象、场景风格与角色音色的高度一致。在镜头语言方面,模型强化了动态运镜、丝滑切镜与复杂场景衔接能力,爆炸、烟火、粒子等视觉特效更具...
EmbeddingGemma 2 – 谷歌开源的原生多模态嵌入模型评测
EmbeddingGemma 2 是谷歌开源的原生多模态 Embedding 模型,基于 Gemma 4 架构构建,将文本、代码、图片、视频、音频五类模态统一映射到同一向量空间,实现跨模态语义检索。该模型采用模块化设计,全模态仅 740M 参数,上下文窗口为 8K token,量化后在 Pixel 11 Pro 上仅占约 567MB 内存。作为 1B 参数以下性能领先的多模态向量模型,其代码检索能...
Index-Translate – B站开源的多语言翻译模型家族
Index-Translate是B站(哔哩哔哩)Index LLM团队开源的多语言翻译模型家族,基于Qwen3.5底座构建,采用Apache-2.0协议开放权重。该家族文本模型覆盖150种语言互译,提供2B、9B、35B-A3B三种参数规模,支持术语统一、格式保留、指定字段翻译等指令约束。除文本翻译外,家族还包含Index-Echo语音翻译、Index-Homura音节可控翻译、Index-Nat...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。