
WeVisCut – 腾讯微信视觉开源的长视频自动剪辑 Agent
导读摘要:
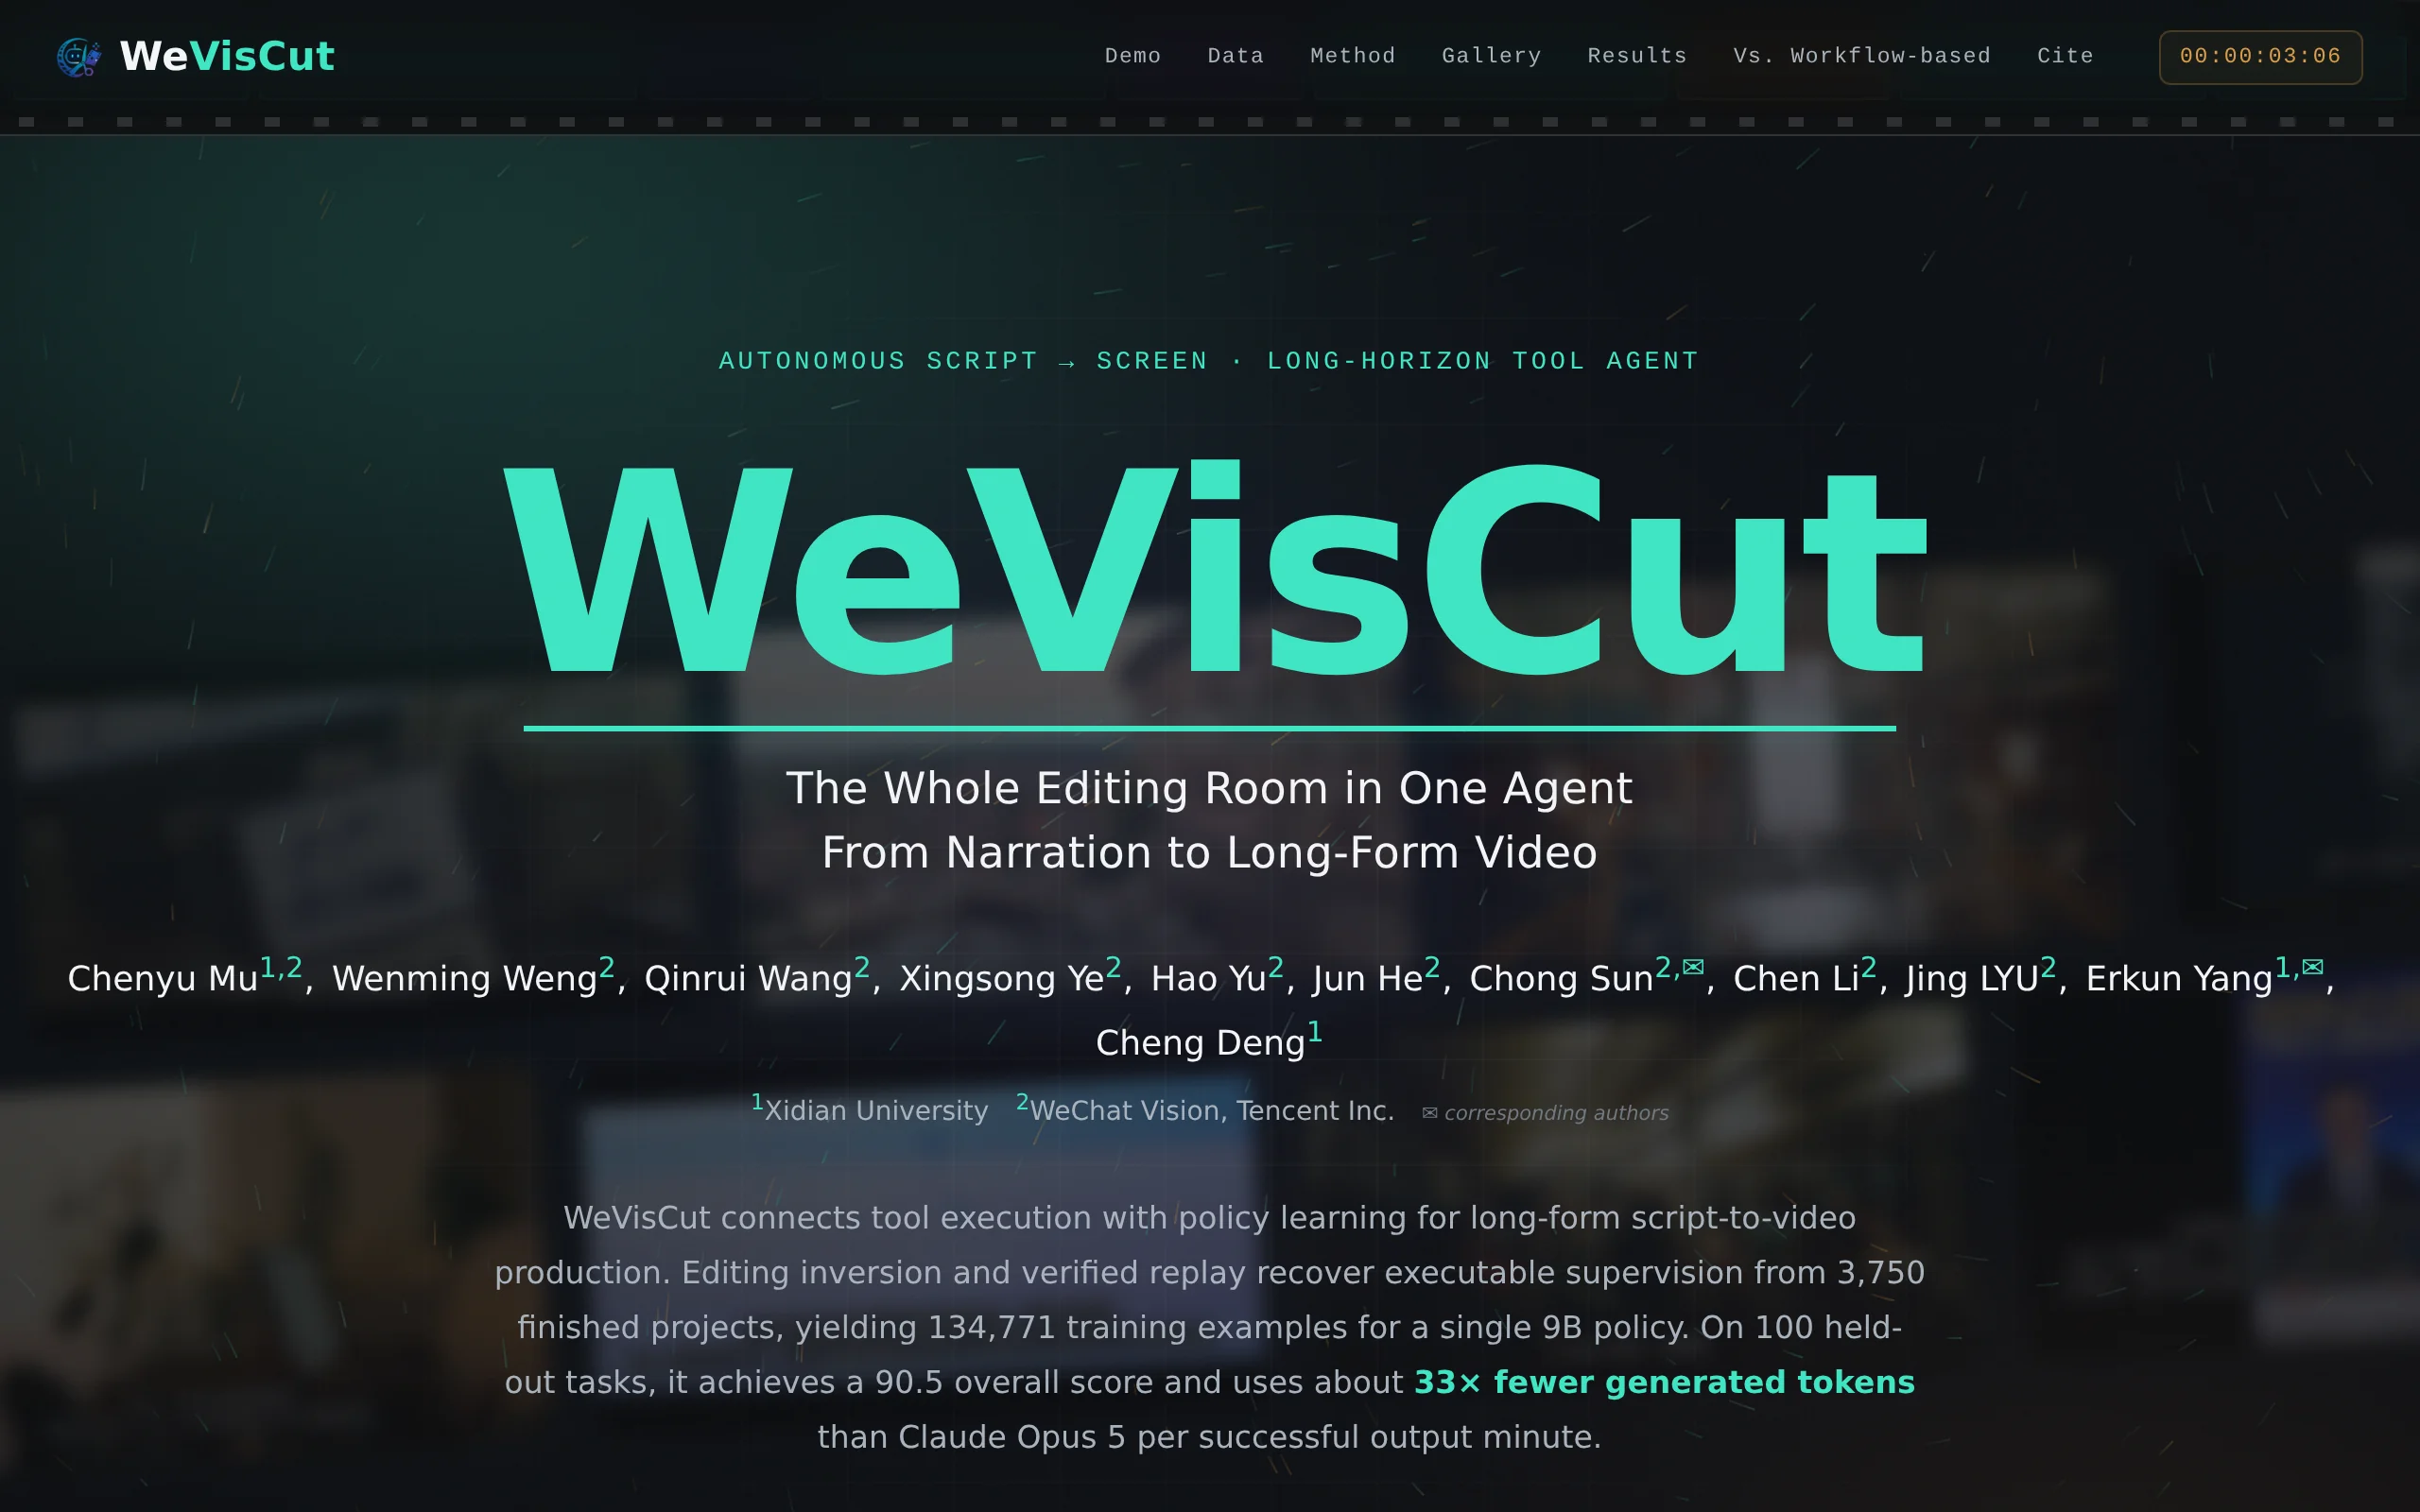
WeVisCut是腾讯微信视觉团队开源的长视频自动剪辑Agent。输入旁白脚本后,一个9B小模型策略借助共享生产状态的运行时,自动完成分镜、配音、素材检索、合成与质检修复,直接输出数分钟成片。其核心创新在于用编辑反演与验证回放管线从3,750条成片恢复出13万余条训练数据,评测中与Claude Opus 5表现相当,生成token节省约33倍,每分钟成片成本仅0.09美元。
1. WeVisCut是什么
WeVisCut是腾讯微信视觉团队开源的长视频自动剪辑Agent。输入旁白脚本后,一个9B小模型策略借助共享生产状态的运行时,自动完成分镜、配音、素材检索、合成与质检修复,直接输出数分钟成片。其核心创新在于用编辑反演与验证回放管线从3,750条成片恢复出13万余条训练数据,评测中与Claude Opus 5表现相当,生成token节省约33倍,每分钟成片成本仅0.09美元。
技术定位与领域: 属于AI视频生成与自动剪辑的交叉领域,聚焦长视频脚本到成片的端到端自动化制作。与传统视频生成模型直接生成画面不同,WeVisCut通过智能体调度将文本脚本转化为包含分镜、配音、素材检索和时间线合成的完整视频作品,在视频生产的自动化编排层面具备独特定位,填补了长视频结构化制作方向的开源空白。
研发背景: 由腾讯微信视觉团队研发并开源。团队观察到长视频制作链路中素材选择、工具执行和修复决策相互依赖,每个镜头局部正确不等于全片有节奏。若拆成多个通用Agent阶段,每阶段都要重新序列化全局上下文,token与调用成本随镜头数线性累积。因此团队设计了一个9B策略维持整条制作状态,把理解全局从每步重复做变成一次持续做,从架构层面解决长链路状态管理难题。
核心价值: 解决了长视频自动化制作中状态管理难、成本高、修复能力弱三大核心问题。通过共享生产状态让前一步工具结果直接约束后一步决策,避免上下文反复重建;通过闭环质检与有界局部修复保留已成功部分,不重做;将每分钟成片成本降至0.09美元,使长视频自动化生产从概念验证走向可规模化落地。
技术特点: 单一策略三角色架构(编排者、生成者、批评者)配合12个固定工具动作空间,无硬编码阶段机,整条轨迹由策略自主决策。训练层面采用Editing Inversion + Verified Replay数据管线与三阶段训练(统一SFT加RFT、Guided-OPD、RCF-DAPO),将Overall从基座的74.5提升至90.5,验证了数据反演与状态化管理在视频制作智能体中的有效性。
2. 主要功能
脚本转长视频: 输入旁白或知识类脚本,自动输出数分钟完整成片。系统自动完成分章、分镜、配音、素材检索与时间线构建,无需人工干预,适合知识科普、课程讲解等长文本内容的高效视频化,显著缩短从文本到成片的制作周期。
单一策略全链路决策: 一个9B模型通过角色路由分饰编排者、生成者、批评者三种角色,替代多阶段Agent工作流。动作空间固定为12个工具,无硬编码阶段机,整条制作轨迹由策略自主决定,护栏仅拦截非法调用,避免多Agent协作中的上下文反复重建与协调开销。
共享生产状态管理: Runtime维护一份持久化的production state,仅将验证通过的工具结果写入状态。策略每次只发一个工具调用,从当前状态中选择合法动作,非法调用被类型化blocker拒绝,强制先补齐依赖再重试。状态与模型上下文分离,策略无需重复携带全量历史,长链路制作不丢节奏。
闭环质检修复: 策略自动检查成片质量,定位失败环节并做有界局部修复,保留已成功部分不重做。训练数据包含失败恢复轨迹,使模型具备质检、定位问题与恢复执行的能力,相比整体重跑方案大幅降低返工成本。
导演对话式改片: 首轮成片后可通过聊天方式换素材、改音乐、调字幕,策略在局部范围内重新规划并重新交付。无需重新生成整条视频,修改效率显著提升,为人工介入提供自然语言交互入口。
可编辑时间线交付: Studio运行时提供8轨时间线,支持逐镜重渲染与版本回滚。用户可以在时间线界面逐镜确认,按需回滚版本重新渲染,兼顾自动化效率与人工控制力,满足专业剪辑流程的交付要求。
低成本私有化部署: 每成功输出一分钟视频仅需约2,377个生成token和0.09美元成本,墙钟时间约2.1分钟。9B权重开源,可本地部署,适合对数据隐私和成本敏感的生产环境,降低视频自动化制作的使用门槛。
3. 应用场景
知识科普视频批量生产: 将科普长文或旁白脚本自动转为数分钟讲解视频,适合MCN机构与自媒体账号日更需求。系统自动完成分镜、配音和素材检索,批量处理多篇脚本时保持全片风格一致,显著降低人工剪辑工作量。
企业培训与课程制作: 把培训教材、课件旁白快速转化为视频课程,降低内训视频外包成本。支持多章节内容的批量处理,自动生成配音与字幕,让培训内容更新周期从数周缩短到数小时。
新闻资讯可视化: 财经、科技资讯脚本自动配图配乐成片,适配资讯类账号的快节奏发布需求。从文字到成片的自动化流程缩短内容生产周期,使资讯类账号能够以更高频率发布视频化内容。
营销与产品讲解: 产品文案一键生成宣传片初版,再由市场人员通过对话式微调素材与风格。兼顾批量生成效率与品牌调性把控,市场团队可以在首轮成片基础上快速迭代,减少从零制作的时间成本。
多语言内容出海: 脚本翻译后直接重新生成配音与字幕版本,批量复用同一制作管线。同一份知识内容可以快速产出多种语言版本,降低多语言视频内容的生产成本,适合内容出海团队规模化运营。
4. 如何使用
获取代码: 从GitHub克隆仓库,执行
git clone https://github.com/Tencent/WeVisCut.git,获取完整项目源码,包含策略模型、Studio运行时与工具注册表。准备环境: 按仓库说明安装Studio运行时及相关依赖。建议使用Linux操作系统并配置Python环境,具体依赖版本以仓库requirements文件为准,GPU环境推荐配备至少16GB显存。
下载模型: 从HuggingFace拉取tencent/WeVisCut的9B权重。可使用
huggingface-cli download tencent/WeVisCut命令,或通过Git LFS方式下载,确保权重文件完整。启动服务: 运行启动脚本加载策略与工具注册表,打开Studio网页界面。启动后确认12个工具全部注册成功,生产状态运行时正常工作,即可开始制作任务。
输入脚本: 在界面粘贴或上传旁白/知识类长文脚本。系统自动进行分章与分镜规划,将长文本拆解为可执行的制作单元,为后续配音、素材检索与合成做准备。
观察制作: Agent自动分章、分镜、配音、检索素材并实时构建时间线,制作过程可视化呈现。用户可实时查看每一步的工具调用与状态变更,了解制作进度与决策逻辑。
对话修改: 首轮成片后通过导演聊天窗口提出修改要求,如更换素材、调整音乐或修改字幕。策略在局部范围内重新规划并交付修改版本,保留已成功部分不重做。
导出成片: 在时间线界面逐镜确认后导出最终视频,或按需回滚版本重新渲染。8轨时间线支持精细调整,确认无误后输出成品文件,完成整个制作流程。
5. 优缺点分析
| 优点 |
|---|
| 成本极低: 每成功输出一分钟视频仅需约2,377个生成token和0.09美元,相比通用工作流成本降低约10.8倍,适合规模化视频生产。 |
| 交付可靠: 五指标Overall达90.5,超过基座16分,计划实现率、长程一致性、渲染产出率全面占优,成片交付稳定性有保障。 |
| 一个策略管全程: 单一9B模型分饰编排、生成、批评三角色,替代多阶段Agent工作流,避免上下文反复重建,长链路不丢节奏。 |
| 自我修复能力: 训练数据包含失败恢复轨迹,策略能质检、定位问题并做有界局部修复,保留已成功部分,减少返工成本。 |
| 交互式改片: 成片后可用自然语言对话修改,局部重规划不重拍,显著提升修改效率,降低人工介入成本。 |
6. 同类工具对比
| 维度 | WeVisCut(腾讯微信视觉) | Crayotter |
|---|---|---|
| 系统形态 | 单一9B策略+共享状态运行时 | 任务匹配的原生工作流系统 |
| 决策方式 | 一个策略分饰编排/生成/批评三角色,无硬编码阶段机 | 预定义编辑流水线 |
| 训练方式 | 3,750条成片反演监督,13万余例可执行数据 | 环境内最终成片偏好训练 |
| 修复能力 | 闭环质检+有界局部修复,保留成功部分 | 无等价显式恢复学习机制 |
| Overall得分 | 90.5 | 84.9 |
| 人工盲评Overall | 4.56(六维全领先) | 3.48 |
| 墙钟速度 | 2.1分钟/输出分钟 | 8.6分钟/输出分钟 |
| 成本 | 0.09美元/输出分钟 | 0.97美元/输出分钟 |
| 交互改片 | 导演对话式局部重规划 | 未提供同等级交互 |
| 开放性 | 权重+运行时+数据管线全开源(Apache-2.0) | 生态封闭 |
对于追求低成本、高效率、可私有化部署的视频自动化生产团队,WeVisCut凭借单一策略架构和共享状态运行时,在成本、速度和修复能力上具备明显优势。其9B模型权重与完整数据管线开源,适合知识科普、企业培训等长文脚本转视频场景的规模化落地。
对于已深度使用Crayotter且依赖其原生工作流的团队,特定任务匹配度可能更顺手,但0.97美元/输出分钟的成本和8.6分钟/输出分钟的速度差距需要在选型时权衡。对于需要极高创意自由度或复杂视觉风格的项目,通用大模型配合人工后期仍有价值,但成本与效率劣势明显,更适合单条精品制作而非批量生产。
7. 编辑总结
WeVisCut在技术上的核心创新在于将长视频制作重新定义为状态管理问题,而非单纯的生成问题。通过单一9B策略分饰三角色、共享生产状态运行时以及编辑反演训练管线,系统在保持低成本的同时实现了与Claude Opus 5相当的表现。这种设计思路对AI视频生产领域具有参考价值,它证明了在复杂工具链任务中,小模型配合精心设计的训练数据和状态管理机制,可以达到甚至超越通用大模型的效果。
从实用价值看,每分钟0.09美元的成本和2.1分钟的墙钟速度,使长视频自动化生产从概念验证走向了可规模化的实际应用。开源策略进一步降低了采用门槛,团队可以在本地部署并基于8轨时间线进行人工干预,兼顾效率与可控性。训练数据的反演恢复方法也为其他工具链Agent的训练提供了可借鉴的范式。
适用人群包括MCN机构、自媒体创作者、企业培训部门、营销团队以及AI应用开发者。对于需要日更视频内容、批量处理长文本视频化、或对数据隐私有要求的团队,WeVisCut提供了可落地的解决方案。其Apache-2.0协议允许商业使用,降低了企业采用的法律风险。
在技术演进方向上,训练数据规模的扩大和工具注册表的扩展,将推动其适用场景从知识科普类视频向更多垂直领域延伸。交互式改片能力的持续完善,也在推动AI视频制作从纯自动化向人机协作的精细化生产演进,这一方向值得行业持续关注。
8. 常见问题FAQ
Q:WeVisCut与Sora等视频生成模型有什么区别?
A:Sora等模型直接生成视频画面,而WeVisCut是自动剪辑Agent,通过调度分镜、配音、素材检索与合成工具完成视频制作。两者解决的问题不同,WeVisCut更侧重长脚本的结构化视频化,而非像素级画面生成,因此对旁白类知识内容的生产效率更高。
Q:9B小模型如何做到与Claude Opus 5表现相当?
A:关键在于训练数据与状态管理。WeVisCut从3,750条成片反演恢复出13万余条可执行监督数据,让模型学会工具使用与失败恢复;共享生产状态让模型无需重复携带全量历史,将token消耗降低约33倍,从而以更少的计算资源实现相当的输出质量。
Q:部署WeVisCut需要什么硬件配置?
A:模型权重为9B参数,建议配备至少16GB显存的GPU(如NVIDIA RTX 4090或更高)运行推理。完整Studio运行时与8轨时间线渲染对内存和存储也有一定要求,具体配置建议参考仓库文档中的环境说明。
Q:支持哪些语言和视频风格?
A:WeVisCut面向旁白/知识类脚本设计,支持多语言内容出海场景,脚本翻译后可直接重新生成配音与字幕。视频风格受限于模板库,当前阶段更适配知识科普、课程讲解等类型,高度定制化的视觉风格需要结合人工后期完成。
Q:如何修改生成的视频?
A:首轮成片后可通过导演聊天窗口提出修改要求,如换素材、改音乐、调字幕,策略会进行局部重规划并重新交付。也可以在Studio的8轨时间线界面逐镜手动调整,按需回滚版本重新渲染,两种方式结合实现高效迭代。
Q:训练数据是如何构建的?
A:采用Editing Inversion + Verified Replay四阶段管线:先从成片反推脚本—镜头意图,再在runtime中重放验证可执行性,回放暴露缺陷时做有界修复并保留成功产物,最后将执行记录物化为带工具反馈的训练例。3,750条成片最终转化为134,771条可执行监督数据。
9. 项目地址
- 产品官网: https://tencent.github.io/WeVisCut/
- GitHub仓库: https://github.com/Tencent/WeVisCut
- HuggingFace模型库: https://huggingface.co/tencent/WeVisCut
- arXiv技术论文: https://arxiv.org/pdf/2610.38352
相关推荐
LoopForge – 腾讯开源的云端 AI 研发协作平台
LoopForge是腾讯开源的一款团队级云端AI研发协作平台,旨在解决多Agent接力交付过程中出现的工程断点问题。不同于传统AI编程助手仅面向单个开发者,LoopForge将任务运行在7×24小时云端沙箱中,用户关闭电脑后任务依然持续执行;产品、设计、研发等角色共用同一个Main Bot会话,上下文自动流转,无需手动复制粘贴。需求经SOP标准流水线推进,编译和测试按退出码客观判定,失败自动附日志...

Muse Ember 评测:Meta 重新定义轻量级模型的效率边界
Muse Ember 是 Meta 于 2026 年中推出的最小参数规模 AI 模型,专为智能体(Agent)高频重复性任务设计。据官方基准测试数据,该模型以约 1/3 于 Claude Haiku 5.5 的单任务成本达到与之持平的综合跑分,并在智能体工作流(AutomationBench-AA)中以 37.8 分大幅领先,位居 Artificial Analysis 效率前沿。其核心配置包括 ...
Claude Fable 5.2 – Anthropic 推出的旗舰级 AI 模型
Claude Fable 5.2是Anthropic推出的旗舰级AI模型,与专攻网络安全的Claude Mythos 5.2同源。该模型以千级Agent集群自主协作能力著称,曾由1000个Agent连续运转8天,从零写出可开机运行的完整操作系统,并在30小时内完成费马大定理的Lean语言形式化证明。相比上代,Claude Fable 5.2生成速度提升30%,API价格降至输入$8、输出$40每百...

ComfyTV – 开源 ComfyUI 插件,本地无限画布媒体工作台
ComfyTV 是一款开源的 ComfyUI 插件,免费且完全在本地运行,能够将 ComfyUI 改造成类似 TapNow、LibTV 的无限画布式媒体工作台。画布上的每个操作都是独立节点,修改任意段落只需重跑该节点,无需整链重算。约 190 个节点覆盖图片生成、视频剪辑、调色、抠像、音频、分镜和图层编辑,并支持 Agent 接入。由于生成能力依赖本地已安装的模型,ComfyTV 适合希望减少节点...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。