
Xiaomi OneVL – 小米具身智能团队开源的自动驾驶大模型
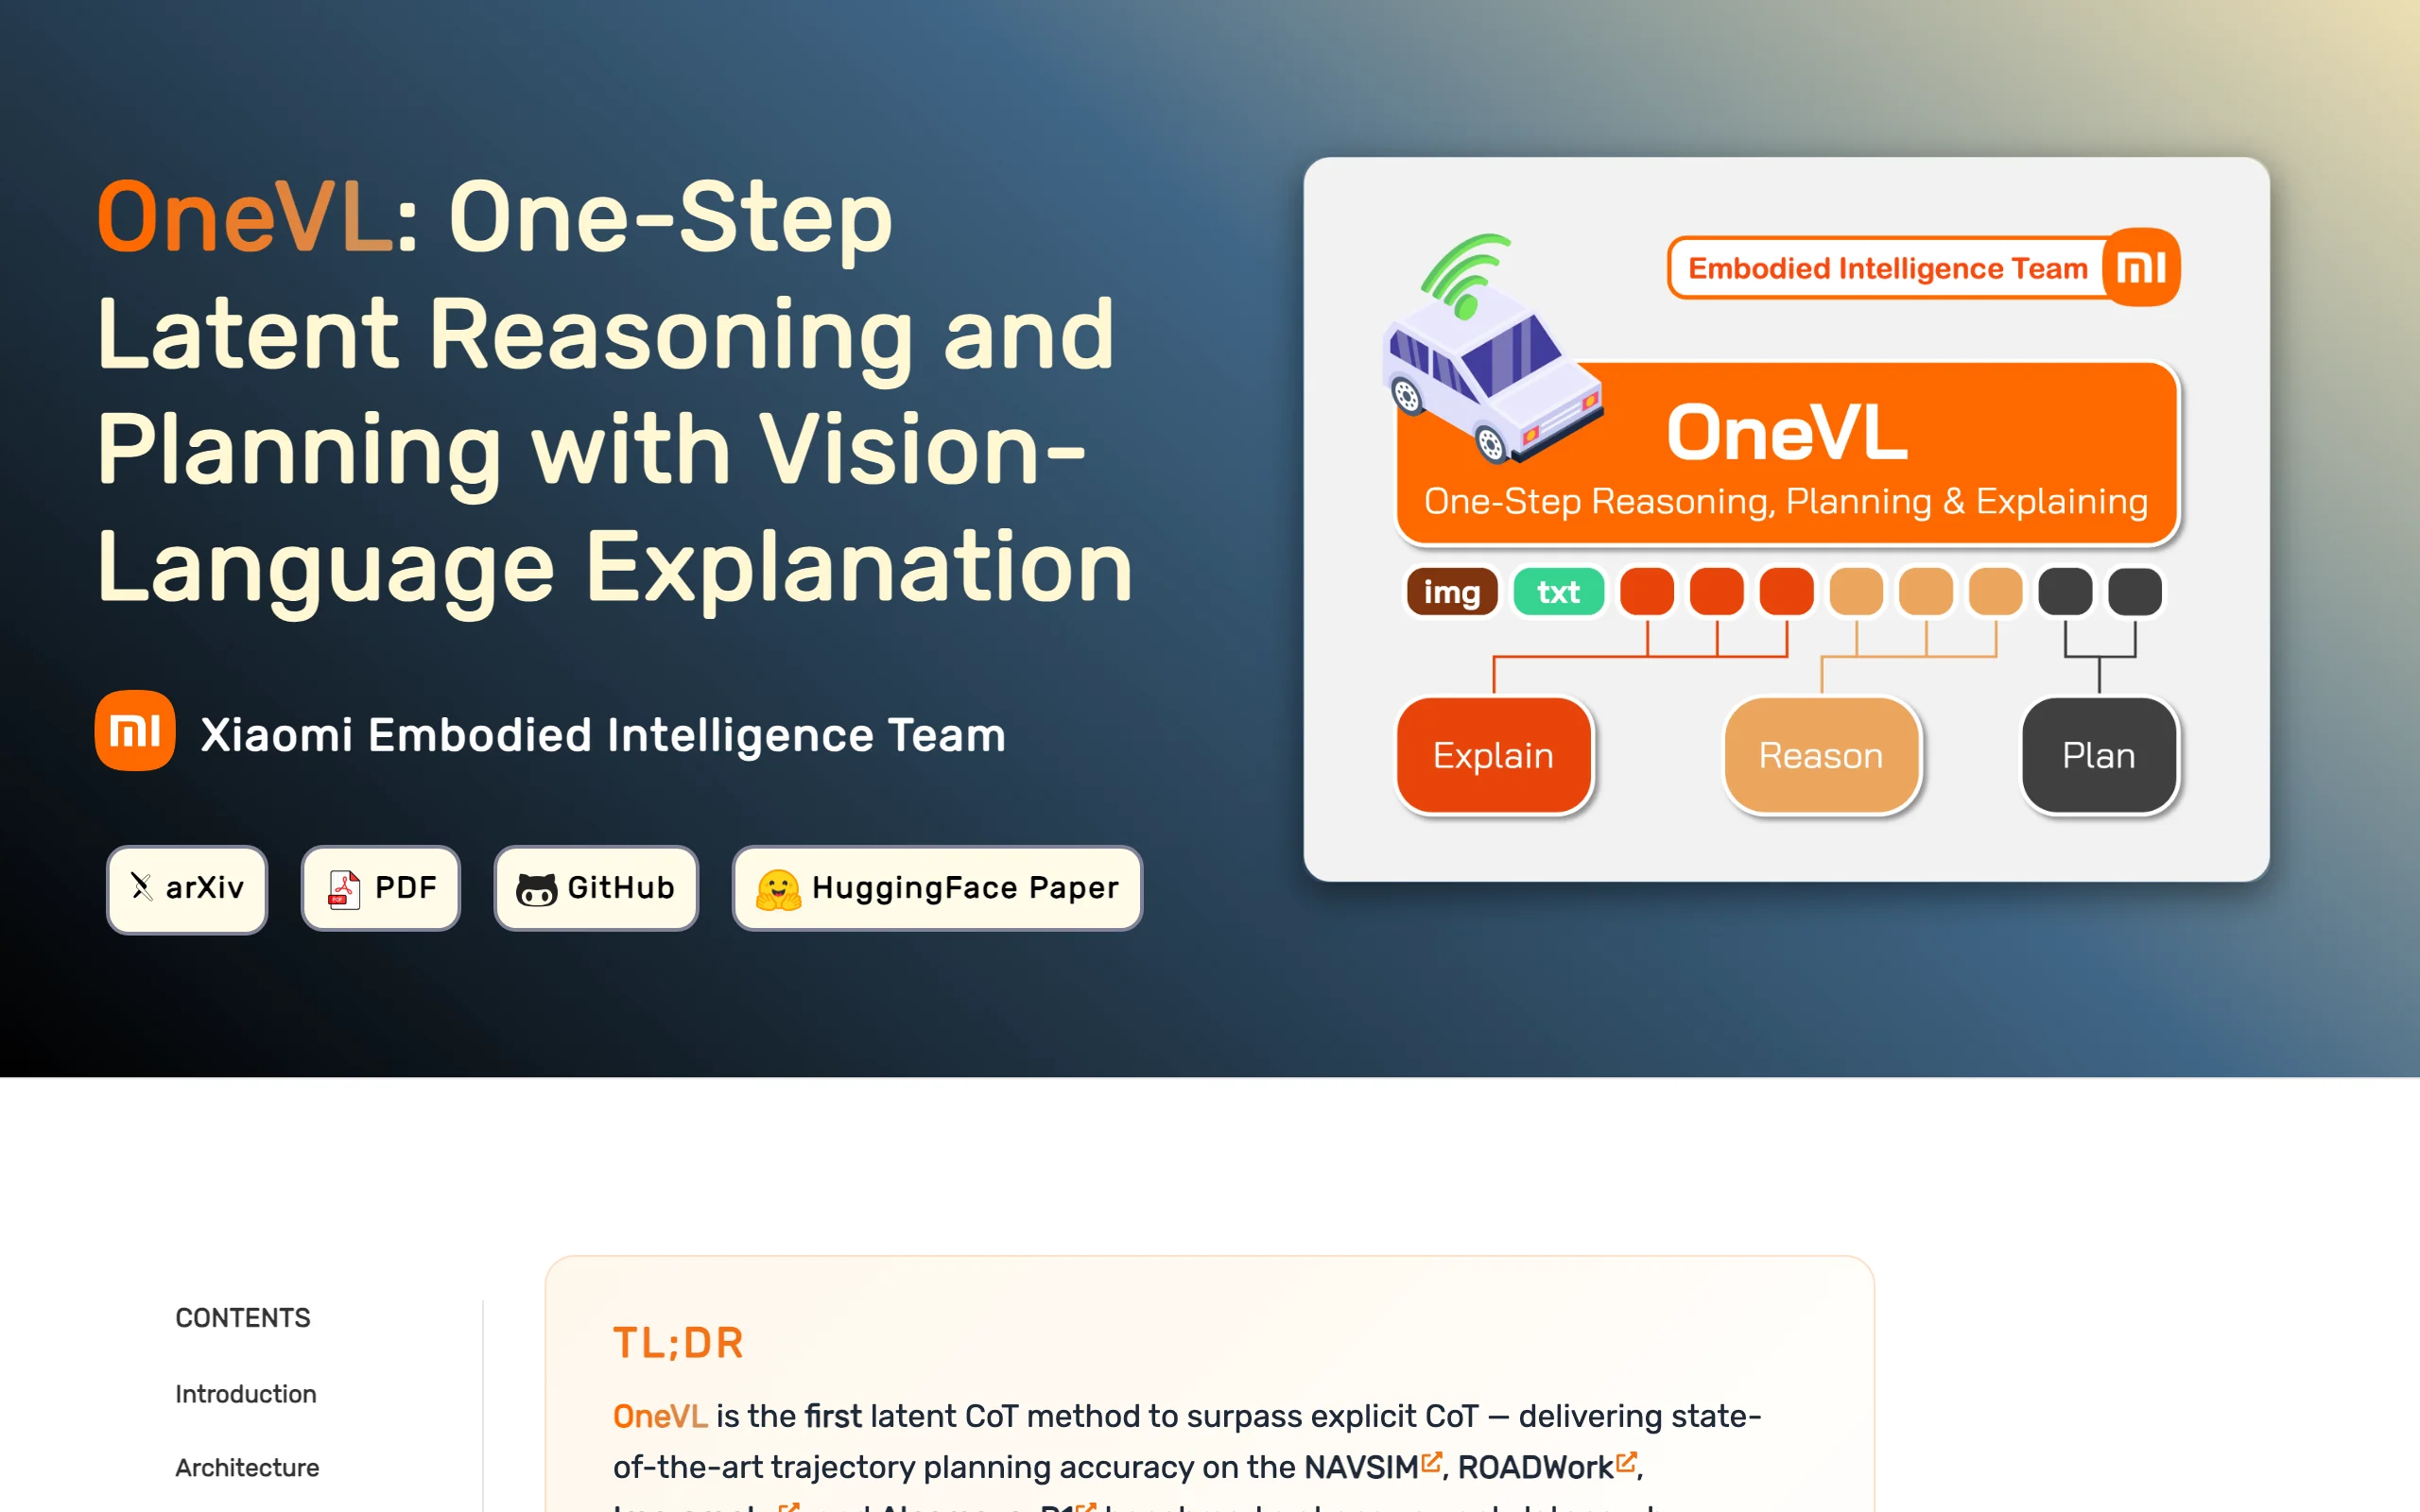
导读摘要:
Xiaomi OneVL是小米具身智能团队推出的开源自动驾驶大模型,在业内首次将VLA(视觉-语言-动作)、世界模型与潜空间推理三大技术路线统一于单一框架。该模型通过双辅助解码器监督紧凑潜变量的训练方式,实现了“思考速度与不思考一样快,效果比思考更好”的突破性性能。在车端推理延迟仅0.24秒(4.16Hz)的条件下,Xiaomi OneVL在NAVSIM、ROADWork、Impromptu、Al...
1. Xiaomi OneVL是什么
Xiaomi OneVL是小米具身智能团队推出的开源自动驾驶大模型,在业内首次将VLA(视觉-语言-动作)、世界模型与潜空间推理三大技术路线统一于单一框架。该模型通过双辅助解码器监督紧凑潜变量的训练方式,实现了“思考速度与不思考一样快,效果比思考更好”的突破性性能。在车端推理延迟仅0.24秒(4.16Hz)的条件下,Xiaomi OneVL在NAVSIM、ROADWork、Impromptu、Alpamayo-R1四项权威基准测试中均达到当前最优水平(SOTA),其模型权重与代码以Apache 2.0协议全面开源,支持学术界与产业界自由二次开发与商业应用。
技术定位与领域: Xiaomi OneVL属于自动驾驶领域的端到端运动规划模型,具体定位于视觉-语言-动作(VLA)统一推理框架。与传统的模块化自动驾驶系统(感知-预测-规划分离)不同,该模型将场景理解、语言推理与驾驶动作输出集成到单一神经网络中,实现从感知到决策到执行的一步式端到端闭环。其独特之处在于首次将潜空间推理与视觉世界模型融合,使得模型在保持实时性的同时具备因果推理能力。
研发背景: 该模型由小米具身智能团队研发,依托小米在自动驾驶和机器人领域的长期技术积累。团队选择基于Qwen3-VL-4B-Instruct作为主干网络,并采用Emu3.5-VisionTokenizer进行视觉分词,体现了对轻量化、高性能路线的追求。研发动机源于当前自动驾驶系统面临的核心矛盾:显式思维链(CoT)推理虽然精度高但延迟过大,无法满足车端实时性要求;而直接预测虽然快但缺乏可解释性和因果推理能力。Xiaomi OneVL试图在两者间找到最优平衡点。
核心价值: Xiaomi OneVL解决了自动驾驶领域长期存在的“快与准”二元对立问题。传统方法要么牺牲精度换取速度(直接预测),要么牺牲实时性换取可解释性(显式CoT)。该模型首次证明潜空间推理可以在与直接预测相当的延迟下,实现超越显式CoT的精度。具体而言,其推理延迟仅0.24秒,比显式自回归CoT快32%,但在NAVSIM基准上PDM-score达到88.84,超越8B参数的竞品AdaThinkDrive与LaST-VLA。此外,模型同时提供语言解释和视觉预测两种决策依据,解决了自动驾驶“黑盒”不可解释问题。
技术特点: Xiaomi OneVL的核心技术特点包括:双辅助解码器监督架构(语言解码器重建文本思维链,视觉世界模型解码器预测未来帧)、三阶段渐进式训练(轨迹对齐→语言推理对齐→视觉世界模型对齐)、一步式潜空间并行推理(所有潜变量token通过单次并行预填完成)。这些技术共同实现了轻量化(4B参数)与高性能(超越8B竞品)的兼得,以及速度与精度的双赢。
2. 主要功能
视觉-语言-动作(VLA)统一推理: 将场景理解、语言推理与驾驶动作输出集成到单一框架,实现从感知到决策到执行的一步式端到端闭环。该功能消除了传统模块化系统各组件之间的信息损失和延迟累积,使得模型能够基于全局上下文做出更一致的驾驶决策。
世界模型未来预测: 内置视觉世界模型解码器,可预测未来0.5秒和1.0秒的场景帧。这一功能强迫模型内化道路几何、车辆运动与环境变化的因果动力学,使得模型不仅理解当前场景,还能预判未来演变,从而在变道、避障等动态场景中做出更安全的决策。
潜空间思维链(Latent CoT)推理: 在紧凑潜变量中完成深度推理,推理时丢弃辅助解码器,所有潜变量token通过单次并行预填完成。该功能实现了0.24秒的低延迟(4.16Hz),与“直接预测”速度相当但精度更高,成为业内首个精度超越显式思维链的潜空间推理方法。
双辅助解码器监督训练: 训练阶段通过语言解码器重建文本思维链、视觉解码器预测未来帧,双维度监督确保潜变量同时编码语义推理与物理世界因果规律。这种训练方式使得模型在推理时虽然丢弃了解码器,但潜变量已经内化了完整的推理能力和物理知识。
高精度轨迹预测: 基于Qwen3-VL-4B-Instruct主干网络,顶部附加MLP头输出连续轨迹。在NAVSIM基准上PDM-score达到88.84,超越8B参数的竞品,证明了轻量化模型同样可以实现顶尖性能。
双维度可解释决策: 同时提供语言解释和视觉预测两种决策依据,能用文字说明驾驶逻辑(如“因为前方车辆减速,所以本车保持安全距离”),也能用生成画面展示未来场景(如预测0.5秒后的道路状态)。这一功能解决了自动驾驶系统的“黑盒”不可解释问题,为系统审计和故障排查提供了有力工具。
3. 如何使用
环境要求与前置条件: Xiaomi OneVL推荐在Linux操作系统(Ubuntu 20.04或更高版本)上运行,需要至少32GB显存的NVIDIA GPU(如A100或V100)。Python版本要求3.8及以上,依赖PyTorch 2.0+、Transformers 4.30+、CUDA 11.7+等核心库。建议使用Anaconda创建独立虚拟环境以避免依赖冲突。
克隆仓库与安装依赖: 首先从GitHub克隆项目代码:
git clone https://github.com/xiaomi-research/onevl.git。然后进入项目目录,运行pip install -r requirements.txt安装所有依赖。如果遇到视觉分词器相关错误,需要单独安装Emu3.5-VisionTokenizer:pip install git+https://github.com/baaivision/Emu3.git。下载预训练权重: 从Hugging Face或项目官网下载预训练模型权重。权重文件较大(约8GB),建议使用
git lfs或wget命令下载。下载完成后将权重文件放置于./checkpoints/目录下。权重文件命名格式为onevl_qwen3_4b_vla.pth。模型部署与推理: 使用提供的推理脚本进行测试。运行命令:
python scripts/inference.py --checkpoint ./checkpoints/onevl_qwen3_4b_vla.pth --input ./data/sample_scenario.json。该脚本会加载模型,对输入场景进行推理,输出轨迹预测、语言解释和未来帧预测结果。如需批量测试,可使用scripts/batch_inference.py并指定数据目录。关键配置说明: 在
configs/default.yaml中可调整关键参数:model.backbone指定主干网络(默认Qwen3-VL-4B-Instruct);training.stages控制是否启用三阶段训练;inference.latent_tokens设置潜变量token数量(默认64,增加可提升精度但降低速度)。对于车端部署,推荐设置inference.fp16=True以启用混合精度推理,可进一步降低延迟。注意事项与最佳实践: 首次运行需要下载Qwen3-VL-4B-Instruct基础模型,建议提前设置
HF_ENDPOINT环境变量以加速下载。训练时,三阶段渐进式训练必须按顺序执行,跳过任一阶段都会导致性能灾难性下降(最高达21.71分)。推理时,建议使用批量大小为1以确保最低延迟。对于生产环境部署,推荐使用TensorRT或ONNX Runtime进行模型优化,可将推理延迟进一步降低至0.15秒以内。
4. 优缺点分析
| 优点 |
|---|
| 速度与精度兼得: 车端推理延迟仅0.24秒,与直接预测速度相当,但精度超越显式CoT方法,成为业内首个实现这一平衡的潜空间推理方案。 |
| 三大技术路线统一: 首次将VLA、世界模型与潜空间推理融合,使模型同时具备场景理解、物理因果推演和未来预测能力,架构创新性强。 |
| 双维度可解释性: 同时提供语言解释和视觉预测两种决策依据,解决了自动驾驶“黑盒”问题,为系统审计和故障排查提供了有力工具。 |
| 轻量化与高性能并存: 基于4B参数模型在NAVSIM基准上PDM-score达88.84,超越8B竞品,证明小模型同样可实现顶尖性能,降低部署成本。 |
| 全面开源可商用: 模型权重、训练与推理代码均以Apache 2.0协议开源,支持商业应用,降低产业界使用门槛。 |
5. 同类工具对比
| 对比维度 | Xiaomi OneVL | EMMA (Waymo) | UniAD |
|---|---|---|---|
| 所属机构 | 小米具身智能 | Waymo(Google) | 上海AI Lab |
| 模型定位 | 端到端VLA+世界模型统一框架 | 端到端多模态通用ist自动驾驶模型 | 端到端自动驾驶统一框架 |
| 基础模型 | Qwen3-VL-4B-Instruct(4B参数) | Gemini/PaLI-X(大规模,未公开参数) | ResNet-50/101(视觉编码器) |
| 核心架构 | 潜空间推理+双辅助解码器 | 纯文本VQA范式 | 多任务联合训练(检测、跟踪、规划) |
| 推理速度 | 0.24秒(4.16Hz) | 高延迟(自回归CoT逐token生成) | 约0.1秒(10Hz) |
| 世界模型 | 内置视觉解码器,预测未来0.5s/1.0s帧 | 无显式世界模型 | 无显式世界模型 |
| 可解释性 | 语言+视觉双维度 | 文本CoT推理链+视觉定位 | 多任务中间结果可视化 |
| 传感器输入 | 视觉(相机) | 视觉(相机) | 视觉(相机) |
| 开源协议 | Apache 2.0(完全开源) | 未开源 | Apache 2.0 |
| 基准性能 | NAVSIM PDM-score 88.84(4B参数) | 未公开具体数值 | nuScenes规划指标优秀 |
选型建议:
对于追求实时性与可解释性平衡的量产部署场景,Xiaomi OneVL是最优选择。其0.24秒的推理延迟满足车端实时性要求,同时双维度可解释性(语言+视觉)为系统审计提供了便利。相比之下,EMMA虽然由Waymo背书,但未开源且延迟较高,不适合独立开发团队使用。UniAD和VAD虽然推理速度更快,但缺乏世界模型和语言解释能力,在复杂路况决策中的可解释性不足。
对于学术研究场景,Xiaomi OneVL的Apache 2.0开源协议和完整的训练代码提供了极大的灵活性。研究者可以基于其三阶段训练框架进行改进,或将其作为潜空间推理的基线模型。UniAD和VAD在nuScenes数据集上表现优秀,适合专注于传统端到端规划的研究。而EMMA由于未开源,仅适合作为理论参考。
对于需要多模态感知(如LiDAR融合)的应用场景,VAD可能是更合适的选择,因为它支持LiDAR输入,在恶劣天气条件下具有更好的鲁棒性。Xiaomi OneVL目前仅支持视觉输入,在雨雾、夜间等场景下的表现有待验证。
6. 编辑点评
Xiaomi OneVL在技术创新性上展现了令人印象深刻的突破。其首次将VLA、世界模型与潜空间推理三大独立技术路线统一于单一框架,这一架构创新本身具有重要的学术价值。更值得关注的是,该模型通过双辅助解码器监督和渐进式训练,成功解决了潜空间推理长期存在的训练不稳定和精度不足问题,使得潜空间推理首次在性能上超越显式CoT。这一成果对于整个自动驾驶领域具有里程碑意义——它证明了“思考更快、效果更好”并非不可能,为实时推理与深度思考的融合提供了可行的技术路径。
在实用价值方面,Xiaomi OneVL的轻量化设计(4B参数)和全面开源策略极大地降低了使用门槛。与依赖大规模模型和私有数据的EMMA不同,Xiaomi OneVL可以在消费级GPU上进行推理,且Apache 2.0协议允许商业应用,这对于中小型自动驾驶公司和技术团队而言是巨大的利好。其双维度可解释性功能(语言解释+视觉预测)也填补了当前自动驾驶系统在可审计性方面的空白,有助于推动行业从“黑盒”向“白盒”转变。
适用人群方面,该模型主要面向自动驾驶算法工程师、学术研究人员以及智能驾驶系统集成商。对于算法工程师,可以直接基于开源代码进行二次开发和场景适配;对于研究人员,可以作为潜空间推理和世界模型融合的研究基线;对于系统集成商,可以评估其在特定量产车型上的部署可行性。需要注意的是,该模型对硬件有一定要求(推荐32GB显存GPU),且训练流程较为复杂,不适合完全没有深度学习经验的开发者。
未来发展潜力方面,Xiaomi OneVL有多个可预见的演进方向:一是扩展传感器输入,支持LiDAR和雷达数据,以提升在恶劣天气下的鲁棒性;二是优化推理速度,通过模型量化和剪枝将延迟降低至0.1秒以下;三是增强长尾场景泛化能力,通过数据增强和域自适应技术提升在罕见场景中的表现。考虑到小米在自动驾驶和机器人领域的持续投入,该模型有望成为小米智能驾驶系统的核心技术基础。
7. 应用场景
高阶智驾量产部署: 将Xiaomi OneVL集成到量产车型的智能驾驶系统中,利用其0.24秒的低延迟满足实时性要求。模型可以直接处理前置摄像头输入,输出轨迹预测和驾驶指令,替代传统的感知-预测-规划模块化流水线。这种方式不仅简化了系统架构,还通过端到端学习减少了各模块之间的信息损失。
复杂路况决策支持: 在城市道路、交叉路口、拥堵路段等复杂场景中,Xiaomi OneVL的世界模型能力可以预判行人意图、车辆并道等动态行为。例如,当检测到右侧车辆有并道意图时,模型会预测未来0.5秒和1.0秒的场景帧,并基于此做出加速或减速的决策,同时生成语言解释(如“右侧车辆转向灯亮起,预计将并入本车道”),为驾驶员或自动驾驶系统提供决策依据。
模型决策可视化与审计: 在自动驾驶系统开发阶段,利用Xiaomi OneVL的双维度可解释性功能,对模型决策进行可视化和审计。开发人员可以通过语言解释了解模型的推理逻辑(如“因为前方车辆刹车灯亮起,所以本车减速”),并通过视觉预测查看模型对未来场景的预期。这一功能有助于发现模型在特定场景下的错误推理,加速故障排查和模型迭代。
学术研究与二次开发: 学术界和产业界研究者可以基于Xiaomi OneVL的开源代码和权重进行二次开发。例如,研究者可以尝试替换主干网络(如使用更轻量的MobileNet系列),或者修改三阶段训练流程以适应特定场景(如高速公路场景)。Apache 2.0协议允许商业应用,企业可以将其作为基础模型,针对自身车型和驾驶场景进行微调,开发定制化的自动驾驶系统。
8. 常见问题FAQ
Q:Xiaomi OneVL是否支持在消费级显卡上运行?
A:支持,但性能会受限于显存大小。推荐使用32GB显存的NVIDIA GPU(如A100、V100)以获得最佳性能。在RTX 3090(24GB显存)上可以运行,但推理延迟可能从0.24秒增加到0.5秒以上,且无法使用混合精度推理。RTX 3060(12GB显存)可能无法加载完整模型,需要通过模型量化或降低输入分辨率来适配。
Q:Xiaomi OneVL的三阶段训练必须全部执行吗?
A:是的,三阶段渐进式训练(轨迹对齐→语言推理对齐→视觉世界模型对齐)必须按顺序执行,跳过任一阶段都会导致性能灾难性下降。实验数据显示,跳过语言推理对齐阶段会导致PDM-score下降约15分,跳过视觉世界模型对齐阶段会导致下降约21.71分。三阶段联合优化对于稳定训练和最终性能至关重要。
Q:Xiaomi OneVL与EMMA相比有哪些优势?
A:主要优势有三点:一是推理速度更快,Xiaomi OneVL的0.24秒延迟远低于EMMA的自回归CoT生成方式;二是完全开源,EMMA未开源代码和权重,而Xiaomi OneVL以Apache 2.0协议全面开源;三是轻量化设计,4B参数模型即可超越8B竞品,部署成本更低。EMMA的优势在于其基于Gemini的大规模预训练知识,在多任务泛化能力上可能更强。
Q:Xiaomi OneVL是否支持LiDAR或雷达输入?
A:目前不支持。Xiaomi OneVL仅支持视觉(相机)输入,使用Emu3.5-VisionTokenizer进行视觉分词。这意味着在雨雾、夜间等低光照条件下,模型的感知能力可能受限。未来版本可能会扩展传感器支持,但当前版本建议仅在良好光照条件下使用。
Q:如何解决Xiaomi OneVL在罕见交通场景中的泛化问题?
A:目前可以通过两种方式改善:一是数据增强,在训练数据中加入更多长尾场景的模拟数据,如施工区域、动物横穿等;二是域自适应,使用少量目标场景数据对模型进行微调。由于模型已开源,研究者可以自由收集和标注特定场景数据,进行针对性训练。建议在部署前对目标驾驶场景进行充分测试。
Q:Xiaomi OneVL的推理延迟0.24秒是在什么硬件条件下测得的?
A:官方公布的0.24秒延迟是在NVIDIA A100 GPU上,使用FP16混合精度推理,输入分辨率为640×480像素,潜变量token数量为64的条件下测得的。在实际部署中,延迟会因硬件配置、输入分辨率和潜变量数量而有所变化。建议在目标硬件上进行实际测试以获取准确数据。
9. 项目地址
相关 AI 模型文章
PixelUMM深度评测:NVIDIA与滑铁卢大学联合打造的无编码器统一多模态模型
PixelUMM是NVIDIA与滑铁卢大学联合推出的无编码器统一多模态模型,其核心创新在于彻底移除传统多模态系统中的VAE和视觉编码器,构建了一个纯粹的Decoder-only Transformer架构,直接在原始像素空间读写图像与视频。该模型将图像按16×16 patch、视频按4帧tubelet切分,理解和生成任务共享同一解码器与自注意力机制,实现了端到端的像素级信息处理,代码已全面开源。
Mistral Large 4 – Mistral AI 开源的最旗舰大模型
Mistral Large 4 是法国人工智能公司 Mistral AI 推出的最新旗舰级开源大模型,绰号「Le Chonk 胖猫」。该模型采用细粒度混合专家(MoE)架构,总参数规模达 1.05T,每次推理仅激活约 49B 参数,并配备 1.6B 视觉编码器,实现原生多模态理解与 1M token 的超长上下文窗口。模型已在 Mistral API 上线,在软件工程、财务流程分析、遥感图像定位等...
EmbeddingGemma 2 – 谷歌开源的原生多模态嵌入模型评测
EmbeddingGemma 2 是谷歌开源的原生多模态 Embedding 模型,基于 Gemma 4 架构构建,将文本、代码、图片、视频、音频五类模态统一映射到同一向量空间,实现跨模态语义检索。该模型采用模块化设计,全模态仅 740M 参数,上下文窗口为 8K token,量化后在 Pixel 11 Pro 上仅占约 567MB 内存。作为 1B 参数以下性能领先的多模态向量模型,其代码检索能...
Nano Banana 2.1:Google DeepMind 图像生成与对话式编辑模型深度评测
Nano Banana 2.1(模型 ID:gemini-nano-banana-2.1)是 Google DeepMind 于 2026 年 10 月 6 日正式发布的第二代图像生成与对话式编辑模型,隶属于 Gemini 3 系列,底层架构基于 Gemini 3.6 Flash。该模型深度融合了原生多模态推理、1M token 长上下文与知识 grounding 能力,支持 1K/2K/4K 分...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。