AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
Grok Voice Think Fast 2.0 – SpaceXAI 推出的语音模型
Grok Voice Think Fast 2.0 是由 SpaceXAI(xAI)推出的新一代端到端语音到语音模型,采用原生统一架构,摒弃传统语音识别—语义推理—语音合成的级联流程,直接理解用户语音并生成回应。其核心创新在于“边听边推理”的流式处理机制,首次音频响应仅 0.70 秒,在 Artificial Analysis 语音到语音综合评测中以 82.9% 的质量指数领先 GPT‑Realt...
MiniMax H3 – 稀宇科技推出的通用全模态生成模型
MiniMax H3是稀宇科技(MiniMax)于2026年7月31日正式发布的通用全模态生成模型。该模型打破了传统任务与模态之间的边界,首次实现对文本、图像、视频、音频的统一理解与原生生成,无需任何后期拼接或合成。H3可直接输出原生双声道音视频内容,最高支持15秒2K分辨率,在指令遵循、品牌信息呈现、视频到视频动作迁移等商用场景中展现出显著优势。其自研的Contextual Omni Repre...
Qwen-Audio-3.0-ASR-Flash – 阿里千问推出的语音识别大模型
Qwen-Audio-3.0-ASR-Flash是阿里千问团队推出的语音识别大模型,通过阿里云百炼平台提供Flash、Filetrans、Streaming三个版本的API服务。该模型具备长音频上下文记忆、行业词精准识别、热词即时定制和语音实时润色等核心能力,能够在识别过程中一步完成去口头禅、语义重组等文本优化,直接输出结构化书面文本。在Artificial Analysis评测中,该模型以1.7...
FLUX 3 – Black Forest Labs 推出的多模态基础模型
FLUX 3是由Black Forest Labs推出的多模态基础模型,首次在统一架构下联合学习图像、视频与音频。基于Self-Flow技术,模型将生成与理解对齐于同一框架,能够单次生成长达20秒带原生音频的视频,支持文生视频、图生视频、视频生视频及关键帧转视频。通过模态间的物理约束学习世界表征,FLUX 3在机器人操控等具身智能任务上表现优异。
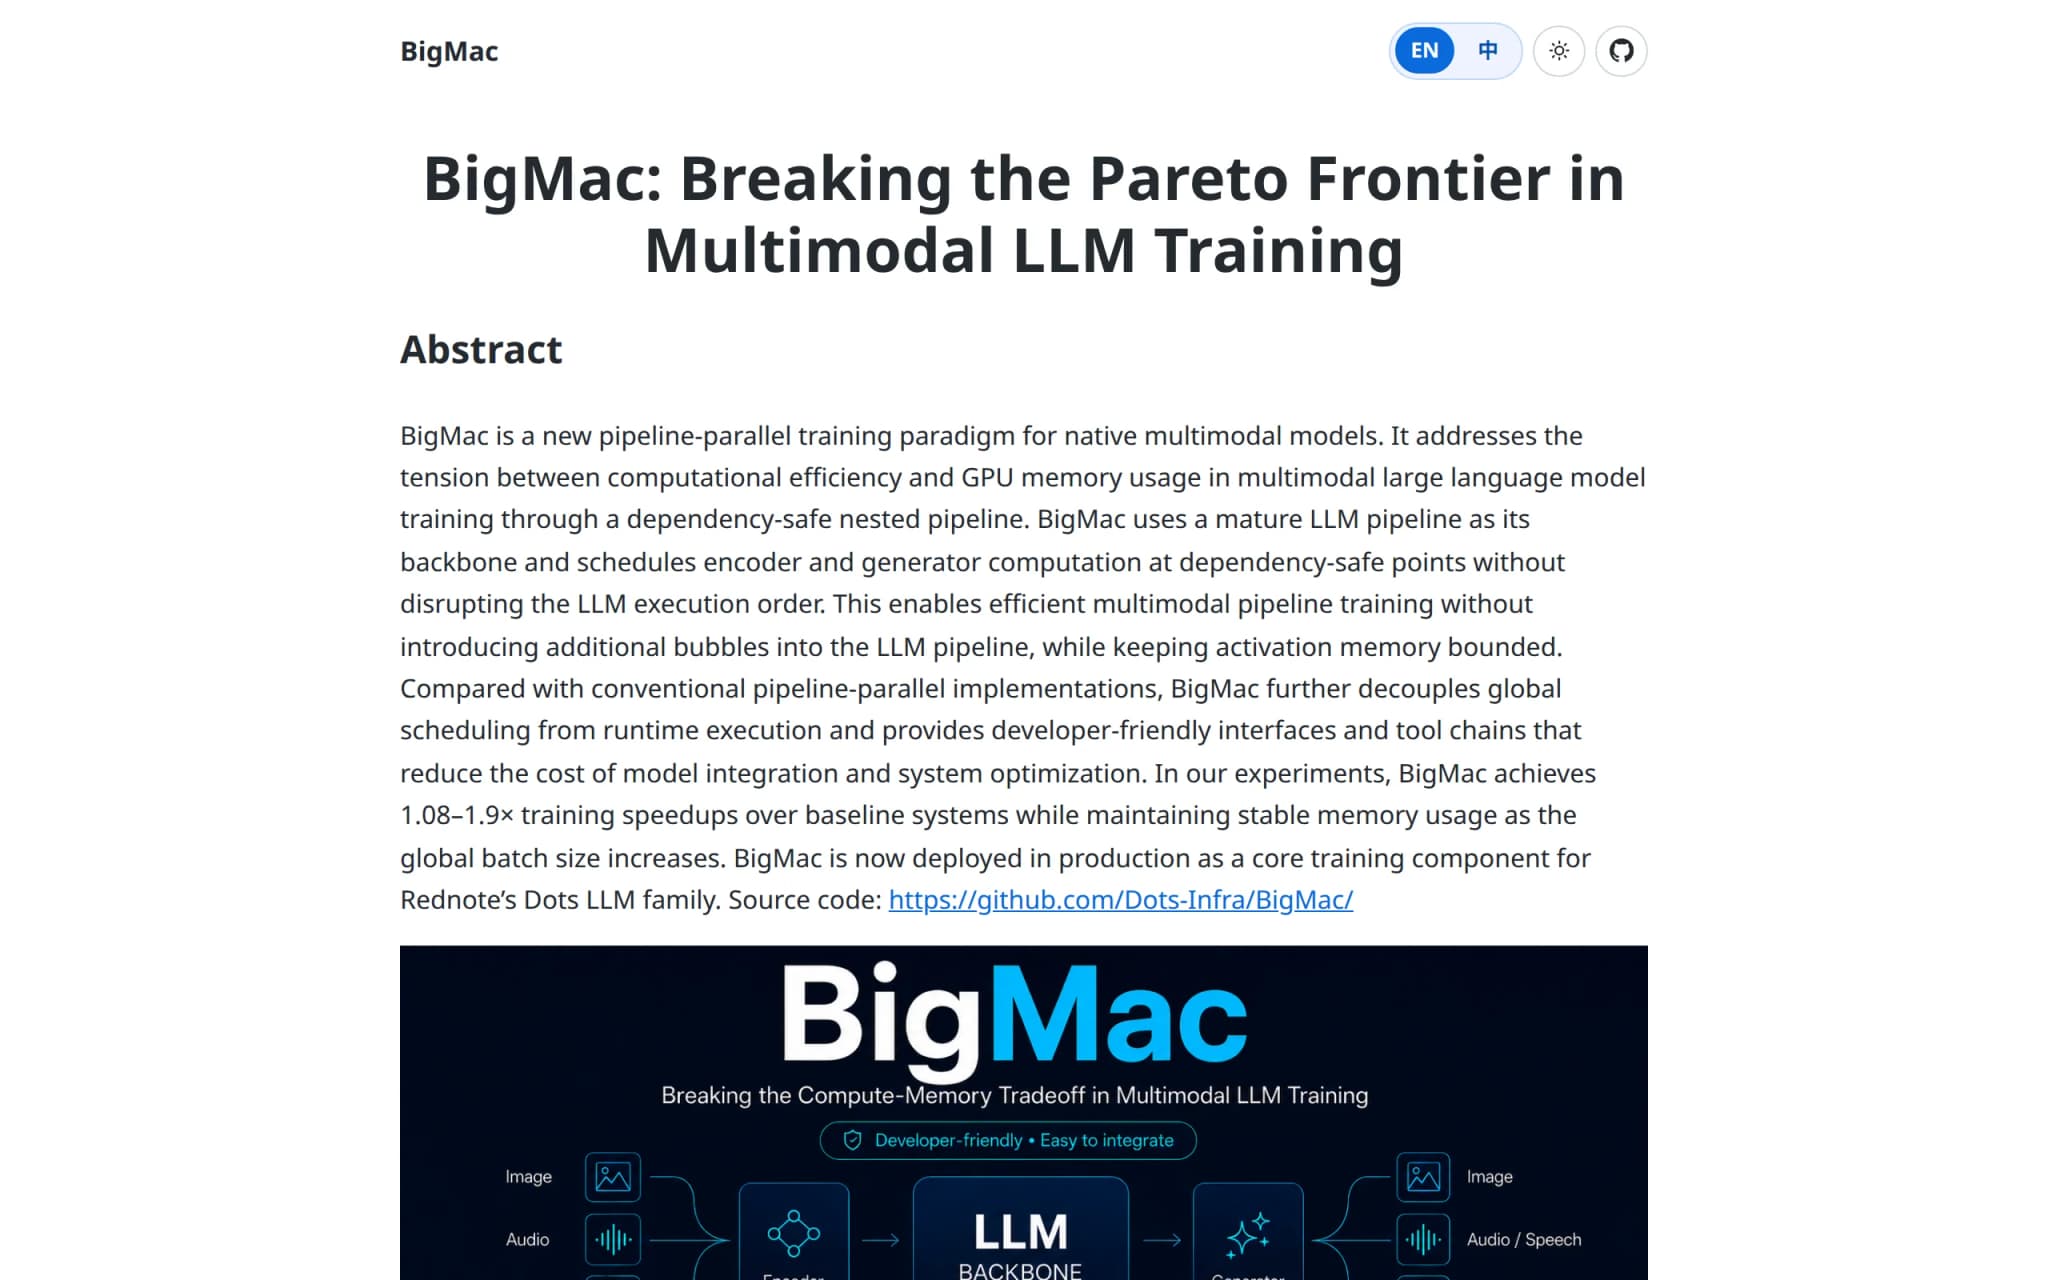
BigMac – 小红书开源的多模态大模型流水并行训练框架
BigMac是小红书dots infra团队开源的多模态大模型流水并行训练框架,旨在解决多模态大模型(MLLM)训练中计算效率与显存占用之间的根本矛盾。该框架提出依赖安全的嵌套流水线范式,以成熟的大语言模型(LLM)流水线为稳定主干,在不打乱执行顺序的前提下嵌入编码器和生成器的前向与反向计算,从而实现训练速度提升1.08~1.9倍的同时保持显存占用稳定。BigMac已作为dots多模态训练核心组件...
Cosmos 3 Edge – 英伟达开源的 4B 参数世界模型
Cosmos 3 Edge 是 NVIDIA 推出的 4B 参数开源世界模型,专为机器人和边缘 AI 实时推理设计。模型基于 Nemotron 架构,融合自回归与扩散双 Transformer 塔,共享多模态注意力层,可在 Jetson Thor、RTX GPU 及 DGX 等设备上本地运行,实现 15 Hz 实时控制。开发者可在约一天内将模型适配至特定机器人或环境,无需依赖云端即可感知、推理并生...
MineExplorer – 美团推出的开放世界分钟级长程任务评测基准
MineExplorer是美团LongCat团队推出的首个基于Minecraft的开放世界分钟级长程任务评测基准。该基准包含813个1-4跳人工验证实例,任务设计采用隐藏前置条件,指令不枚举依赖图,要求模型自主推断子任务。MineExplorer主动剥离游戏专有知识,仅测试通用动态探索能力,并配套五智能体协作数据合成与规则化里程碑自动评测框架,代码与数据集已开源。
SciReasoner – 上海AI Lab等推出的科学推理多模态基础模型
SciReasoner是上海人工智能实验室联合香港中文大学、中国科学院上海药物研究所、斯坦福大学、牛津大学等团队推出的新一代科学推理多模态基础模型。该模型首次提出原生结构推理范式,将蛋白质三维结构、分子拓扑与晶体晶格转化为可寻址的推理证据单元,使AI能够像科学家一样围绕真实结构证据组织分析过程。模型基于Qwen3进行持续预训练,在86项跨学科基准评测中67项达到SOTA水平,覆盖蛋白功能注释、逆合...
Mage-Flow – 微软开源的轻量级多模态图像生成模型系列
Mage-Flow 是微软开源的轻量级多模态图像生成模型系列,基于流匹配架构,仅 4B 参数。模型包含 Base 基础版、RL 强化学习版、Turbo 加速版和 Edit 图像编辑版四个变体,支持文本到图像生成、局部编辑与风格迁移。模型在保持高质量输出的同时大幅降低部署门槛,可在消费级 GPU 上高效运行,适用电商设计、广告创意、游戏开发等场景。
SenseNova U1 Pro – 商汤科技推出的旗舰图片创作模型
SenseNova U1 Pro是商汤科技推出的旗舰级图片创作模型,核心定位为理解、生成与行动的原生统一。该模型支持原生8K分辨率直出,具备图文交错思维能力,能够围绕目标连续完成草图、细化、着色、检查和调整的全流程,瞄准信息图、影视分镜、商业设计等可直接交付的专业场景。通过端到端的统一架构,它将图像理解、内容规划、信息组织、多模态生成、质量检查与最终交付整合为单一流程,而非传统分阶段拼接,从而在复...