
AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
LongCat-Video-Avatar 1.5 – 美团开源的数字人视频生成模型
LongCat-Video-Avatar 1.5 是美团 LongCat 团队开源的音频驱动数字人视频生成框架,基于 13.6B 参数的基础视频生成模型 LongCat-Video 构建,通过将音频编码器从 Wav2Vec2 升级为 Whisper-Large-v3 实现口型同步精度质的飞跃,并采用 Step Distillation 技术将推理步数压缩至 8 步,支持 480P/720P 分辨率...

Gemini Omni Flash – 谷歌推出的多模态视频生成模型
Gemini Omni Flash 是谷歌在 I/O 大会上推出的统一多模态世界生成模型,其核心定位是打破传统生成模型的模态壁垒,实现从任意输入到任意输出的全链路内容生成。该模型将 Gemini 强大的推理引擎与 Veo 视频生成、Nano Banana 图像生成、Genie 交互模拟能力深度融合,构建了一个能够理解并模拟物理世界规则的多模态生成框架。其独特之处在于不仅支持文本、图像、视频、音频的...
Qwen3.5-LiveTranslate – 阿里通义推出的实时同声传译模型
Qwen3.5-LiveTranslate是阿里通义团队推出的新一代实时同声传译大模型,它打破了传统级联式翻译系统的延迟天花板。通过创新的“流式可读单元”架构,该模型将端到端字均延迟压缩至惊人的2.8秒,接近人类专业同传水平。它并非简单的翻译工具,而是一个集语音识别、机器翻译与语音合成于一体的端到端多模态AI系统,支持60种语种输入、29种语种输出,并拥有超过3500种翻译组合,专为跨境会议、直播...
Higgs Avatar v1 – 面向语音智能体的实时 AI 数字人模型
Higgs Avatar v1 是由 BosonAI(李沐创办)推出的面向语音智能体的实时 AI 数字人模型,仅需一张静态照片即可生成具备口型同步、面部表情与头部动作的实时交互数字人。模型单帧渲染仅需 16 毫秒,远低于 62.5 毫秒的实时对话阈值,单张 H100 GPU 可并发支持 8 路独立实时对话,与自研 Higgs Audio 语音模型实现端到端协同,适用于客服、销售、培训等企业级交互场...
StepAudio 2.5 Realtime – 阶跃星辰推出的实时语音大模型
StepAudio 2.5 Realtime 是由阶跃星辰(StepFun)推出的端到端实时语音大模型,其核心定位是提供具备“真人级”体验的AI语音对话。该模型不仅突破了传统TTS的机械感,更在内容理解的深度和情感表达的细腻度上达到了行业领先水平。它能够精准捕捉语调、语速、停顿等副语言信息,并支持千万级别的个性化人设定制,旨在创造一个“有温度、有灵魂、有态度”的AI聊天搭子,而非仅仅是语音问答工具...
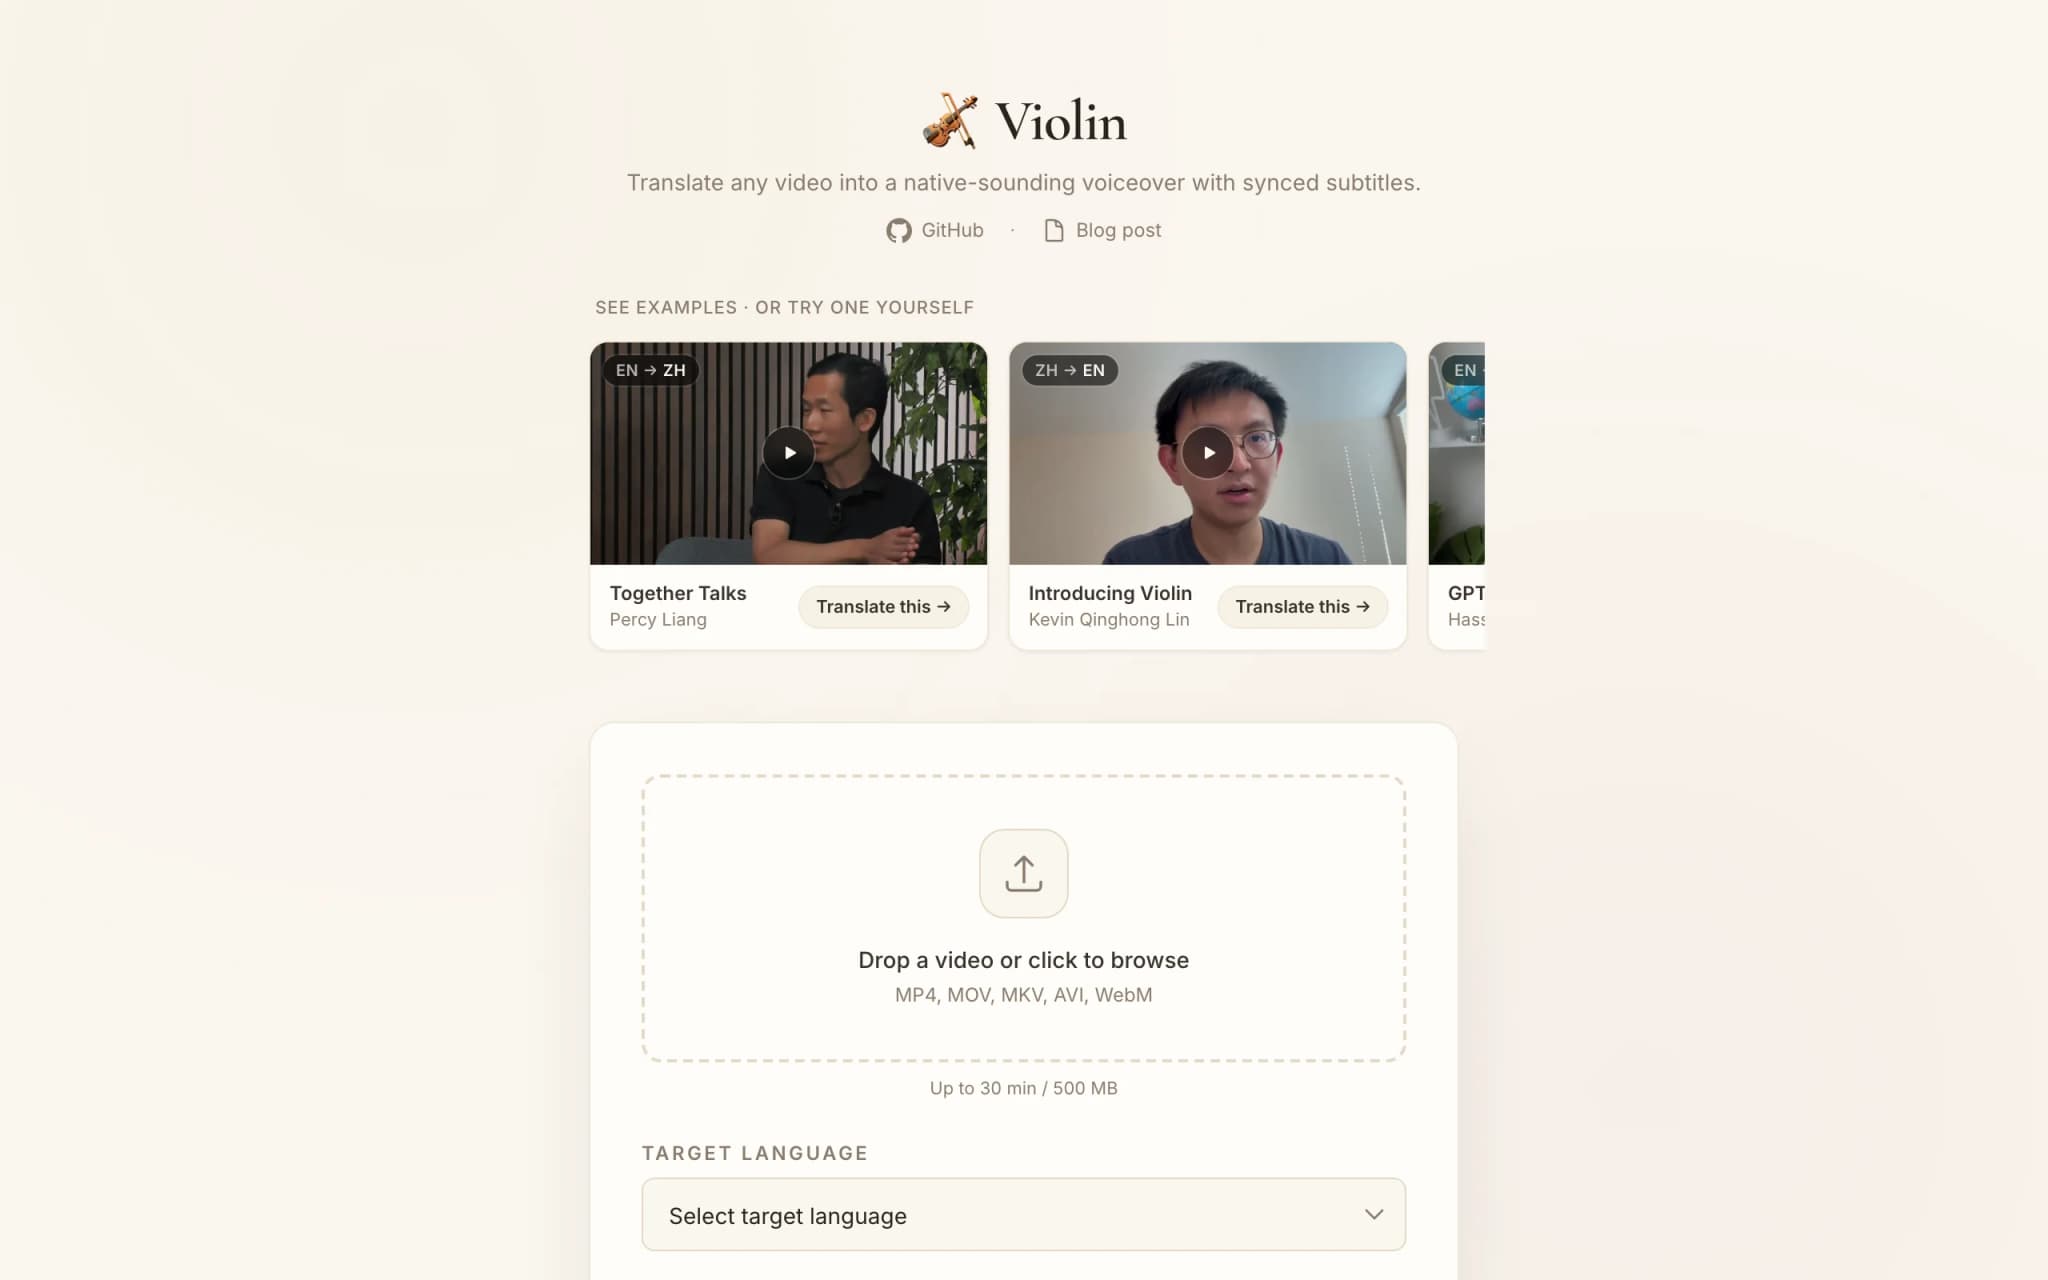
Violin – 牛津大学 Kevin Lin 开源的端到端 AI 视频翻译工具
Violin 是由牛津大学博士后研究员 Kevin Lin 主导开发的开源端到端 AI 视频翻译工具,旨在打破高质量视频内容的语言壁垒。该项目巧妙整合了 OpenAI Whisper 语音识别、大语言模型(LLM)驱动的智能翻译以及 TTS 语音合成三大核心技术,能够将任意语言的视频自动翻译并配音为 33 种目标语言,且输出音频与原始画面口型节奏高度对齐。Violin 采用 MIT 开源协议,支持...
AudioLib – 开发者音频基础设施平台,单 API 调用海量音乐
AudioLib是由杨樾与43Music团队打造的一款面向开发者的音频基础设施平台,其核心定位是成为“音频版OpenRouter”。该平台通过一个统一的REST API,将团队自主创作的超过10万首原创音乐库开放给开发者,彻底革新了应用内背景音乐的集成方式。开发者无需集成复杂的SDK、自行开发播放器、进行繁琐的版权谈判或管理庞大的曲库,只需一个API Key和一个曲库名称,通过简单的POST请求即...
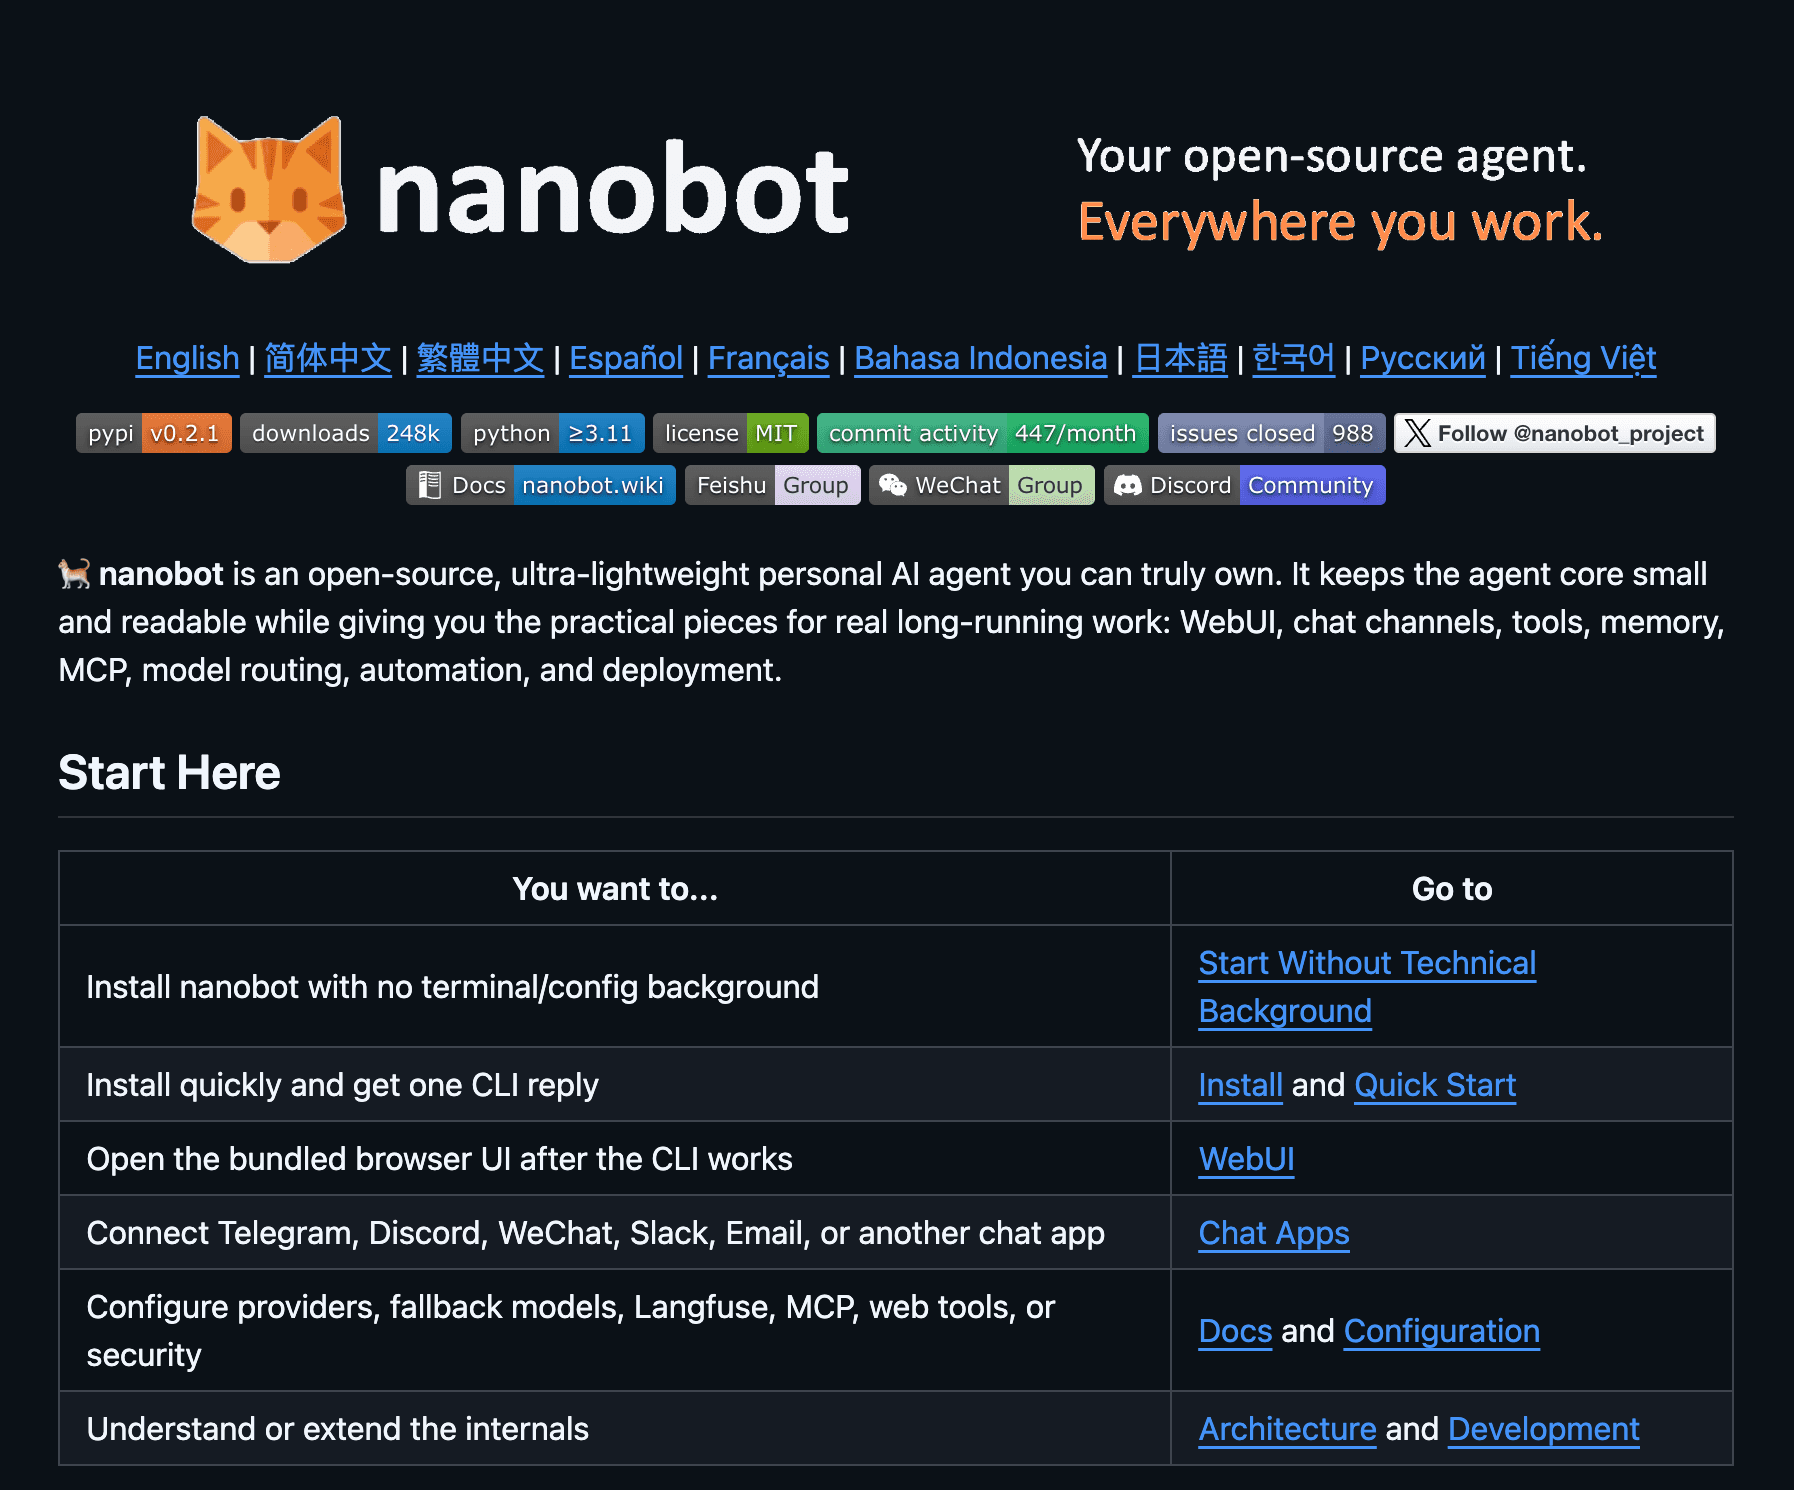
Nanobot – 香港大学数据科学实验室开源的个人AI助手
Nanobot是由香港大学数据智能实验室(HKUDS)开源的超轻量级个人AI助手框架,仅约4000行代码即完整复刻了OpenClaw智能体的核心功能。该项目覆盖网页搜索、文件操作、定时任务、记忆机制、语音交互等多项关键能力,能够支持24小时实时行情分析、全栈开发辅助、日程管理和个人知识库构建等场景。相比OpenClaw原版43万行的代码规模,Nanobot以99%的代码精简实现了同等级别的生产力,...
Clawdbot – 开源个人AI助手框架
Clawdbot是一款开源的个人AI助手框架,允许用户在自己的设备上运行私有化的AI助手。该项目由Peter Steinberger及开源社区共同开发,目前在GitHub上已获得超过40,000颗星标。Clawdbot的核心定位是提供一个本地优先、多渠道、始终在线的个人AI助手解决方案,支持在WhatsApp、Telegram、Slack、Discord、Signal、iMessage等多个主流通...