AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
Step Edge – 阶跃星辰推出的端侧模型全家桶
Step Edge是阶跃星辰推出的端侧模型全家桶,包含基础模型、Audio、GUI、Gen四大成员,面向手机与汽车等终端打造。模型通过端云协同架构,让Agent在本地实现0.1秒级响应,同时保障全模态数据隐私,在29项核心评测中取得第一,并配套自研Step Inference NPU引擎优化终端推理。
SenseNova-Vision – 商汤开源的理解生成统一视觉大模型
SenseNova-Vision是商汤科技开源的理解与生成统一视觉大模型,其核心创新在于将目标检测、图像分割、深度预测、3D重建等经典视觉任务原生融入大模型底座,无需任务特定头或架构改动。模型基于统一多模态生成框架(UMM),通过自然语言指令即可定义任意视觉任务,输出文本符号记录、图像稠密预测或混合格式。SenseNova-Vision具备零样本泛化能力,可处理跨域游戏画面、镜面反射等极端场景,在...
HyOCR-1.5 – 腾讯混元开源的轻量级端到端 OCR 专家大模型
HyOCR-1.5是腾讯混元团队推出的轻量级端到端光学字符识别(OCR)专家大模型,参数量仅1B,却集文档解析、文本检测识别、信息抽取、拍照翻译、图表解析、古文字识别、视频字幕提取及多页文档问答等全栈能力于一体。该模型基于DFlash投机解码技术,在长结构化输出场景下推理速度最高提升6.37倍,并在OmniDocBench v1.6基准测试中以94.74分的成绩位居端到端OCR榜首,展现出优异的精...
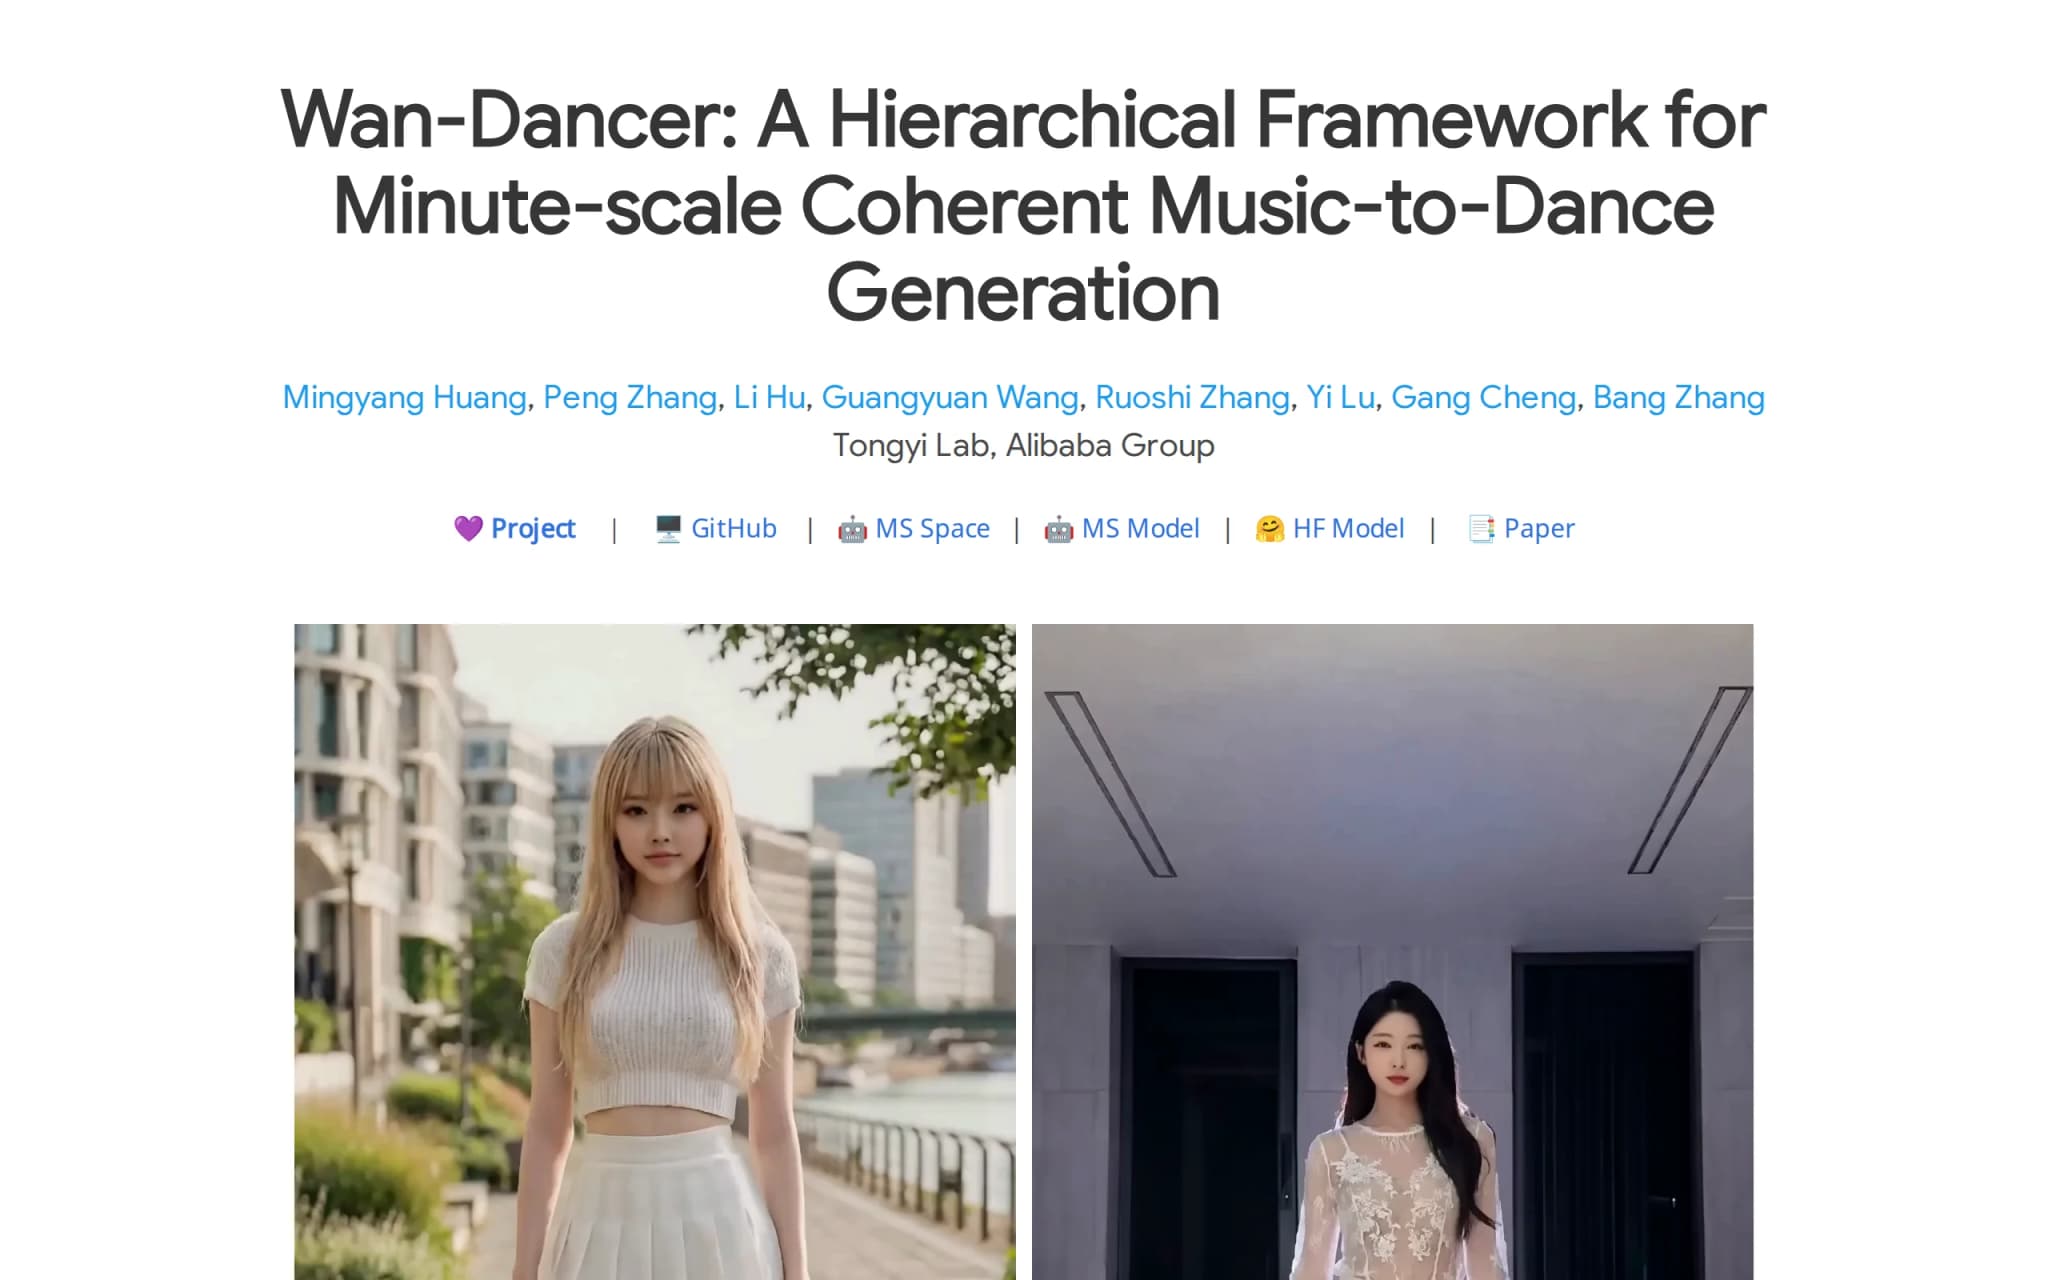
Wan-Dancer – 阿里通义开源的人像舞蹈视频生成模型
Wan-Dancer 是阿里通义万相开源的音乐驱动人像舞蹈视频生成模型,用户仅需提供一张单人正面照片和一段音乐,即可自动生成节奏精准、动作流畅且风格鲜明的舞蹈视频。该模型首次突破分钟级时序生成瓶颈,支持输出 15 秒至 3 分钟的 720p/30fps 超长连贯视频,覆盖中国古典舞、韩舞、街舞、踢踏舞和拉丁舞五种舞种,并允许通过 LoRA 技术进行个性化舞蹈风格定制。Wan-Dancer 在长序列...
StepAmoo – 阶跃星辰推出的一代个人智能体
StepAmoo是由阶跃星辰(StepFun)推出的新一代个人智能体,基于全球首个智能体原生操作系统Step AOS构建,具备操作系统级身份和系统级权限。它集感知、记忆、规划、连接、执行五大核心能力于一身,采用双域三步记忆结构,能够持续理解用户的习惯与偏好。通过端云协同路由机制,StepAmoo可跨应用调度原子化服务,完成复杂任务闭环,并在多设备间实现无缝接续,旨在从底层重构人机交互方式,成为真正...
OvisOCR2 – 阿里ATH-MaaS团队推出的端到端文档解析模型
OvisOCR2是由阿里巴巴ATH-MaaS团队研发并完全开源的端到端文档解析模型,基于Qwen3.5-0.8B基座模型训练,参数规模仅0.8B。该模型在OmniDocBench v1.6评测基准中以96.58分登顶榜首,展现出对复杂版式文档的高精度识别与结构化提取能力,支持多栏排版、表格、公式等场景的解析,适用于学术研究、档案数字化及企业知识库构建等文档智能处理需求。其端到端架构直接输出Mark...
MOSS-VL-Realtime – OpenMOSS 开源的视觉语言模型
MOSS-VL-Realtime 是 OpenMOSS 开源的 11B 参数流式视觉语言模型,专为实时视频理解设计。模型支持边看边答、即时修正与主动沉默,将视频理解从看录像升级为看直播。模型通过双通道交叉注意力架构与绝对时间戳编码,实现感知与生成并行,让 AI 与物理世界保持时间同步,在多个流式基准测试中达到开源领先水平。
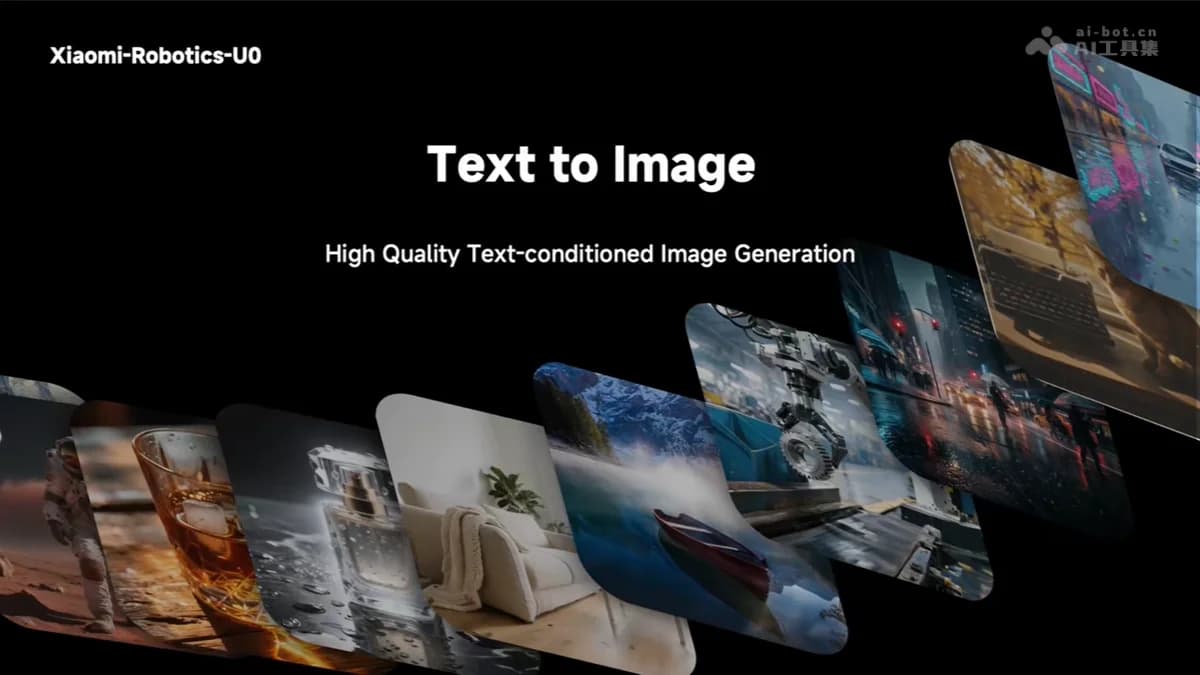
Xiaomi-Robotics-U0 – 小米推出的统一具身合成模型
Xiaomi-Robotics-U0 是小米推出的 380 亿参数统一具身合成模型,基于世界基础模型持续训练,联合优化文生图、图像编辑、具身场景生成、具身迁移及具身视频生成五大任务。该模型是首个支持跨多种机器人形态的高质量多视角场景生成模型,在具身场景生成与迁移的人工评估中超越 GPT-Image-2.0,在 World Arena 具身视频生成榜单排名第一,并将 π0.5 在真实世界操控任务的分...
Inkling – Thinking Machines Lab 推出的多模态基础模型
Inkling是由Thinking Machines Lab开发的开放权重多模态基础模型,采用混合专家(MoE)架构,在410亿激活参数下原生支持文本、图像与音频的统一推理。该模型不追求单一基准的领先,而是强调在智能体、编程、视觉、音频等广泛任务中的均衡能力,定位为可嵌入不同工作流的后台推理引擎。通过Tinker平台,开发者可下载权重、按需微调,实现从研究到生产的灵活部署。
Wan-Streamer v0.2 – 阿里通义推出的全模态理解与生成模型
Wan-Streamer v0.2是阿里通义实验室推出的面向实时双工交互的端到端全模态理解与生成模型。该模型通过单个Transformer统一处理文本、音频、视频的实时理解与同步生成,端到端响应延迟仅550ms,视频输出分辨率640×368@25FPS,支持边说边听边回应的全双工交互,使AI能够像真人一样进行面对面的视频交流,显著提升了人机交互的自然度和实时性。