AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
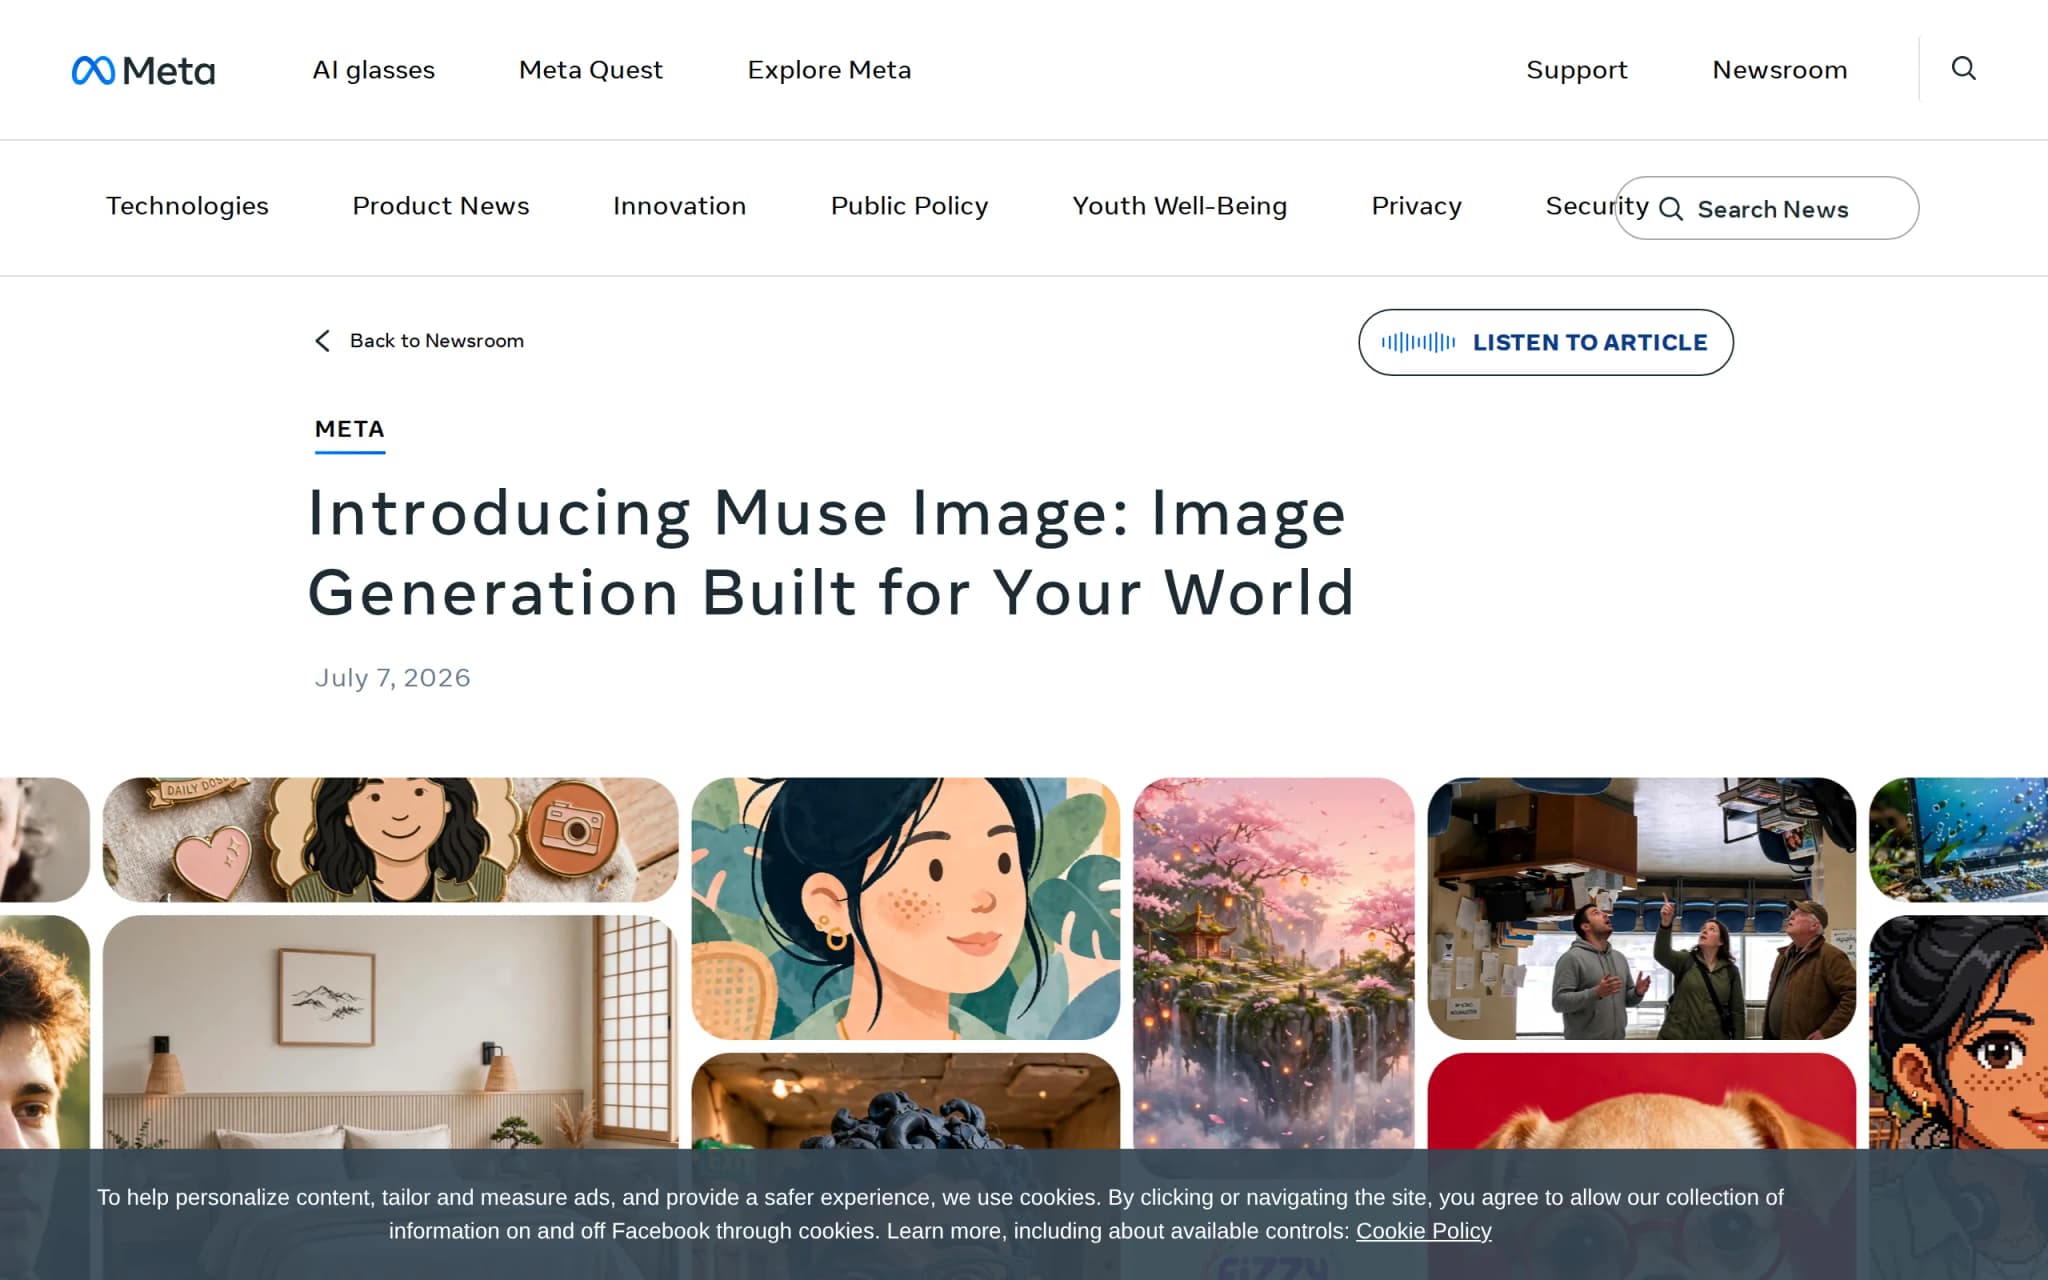
Muse Image – Meta 超级智能实验室推出的AI图像生成模型
Muse Image 是 Meta 超级智能实验室推出的首个自研 AI 图像生成模型,采用 Agent 架构,与 Muse Spark 协作进行多步规划与自我精炼。模型支持文生图、智能编辑、背景擦除、文字渲染及多素材融合,在 Arena AI 排行榜位列全球第二。模型深度整合 Instagram、WhatsApp 等 Meta 社交生态,用户可通过对话式提示或预设模板快速创作。
MemGUI-Agent – 浙大联合快手推出的长程手机GUI智能体
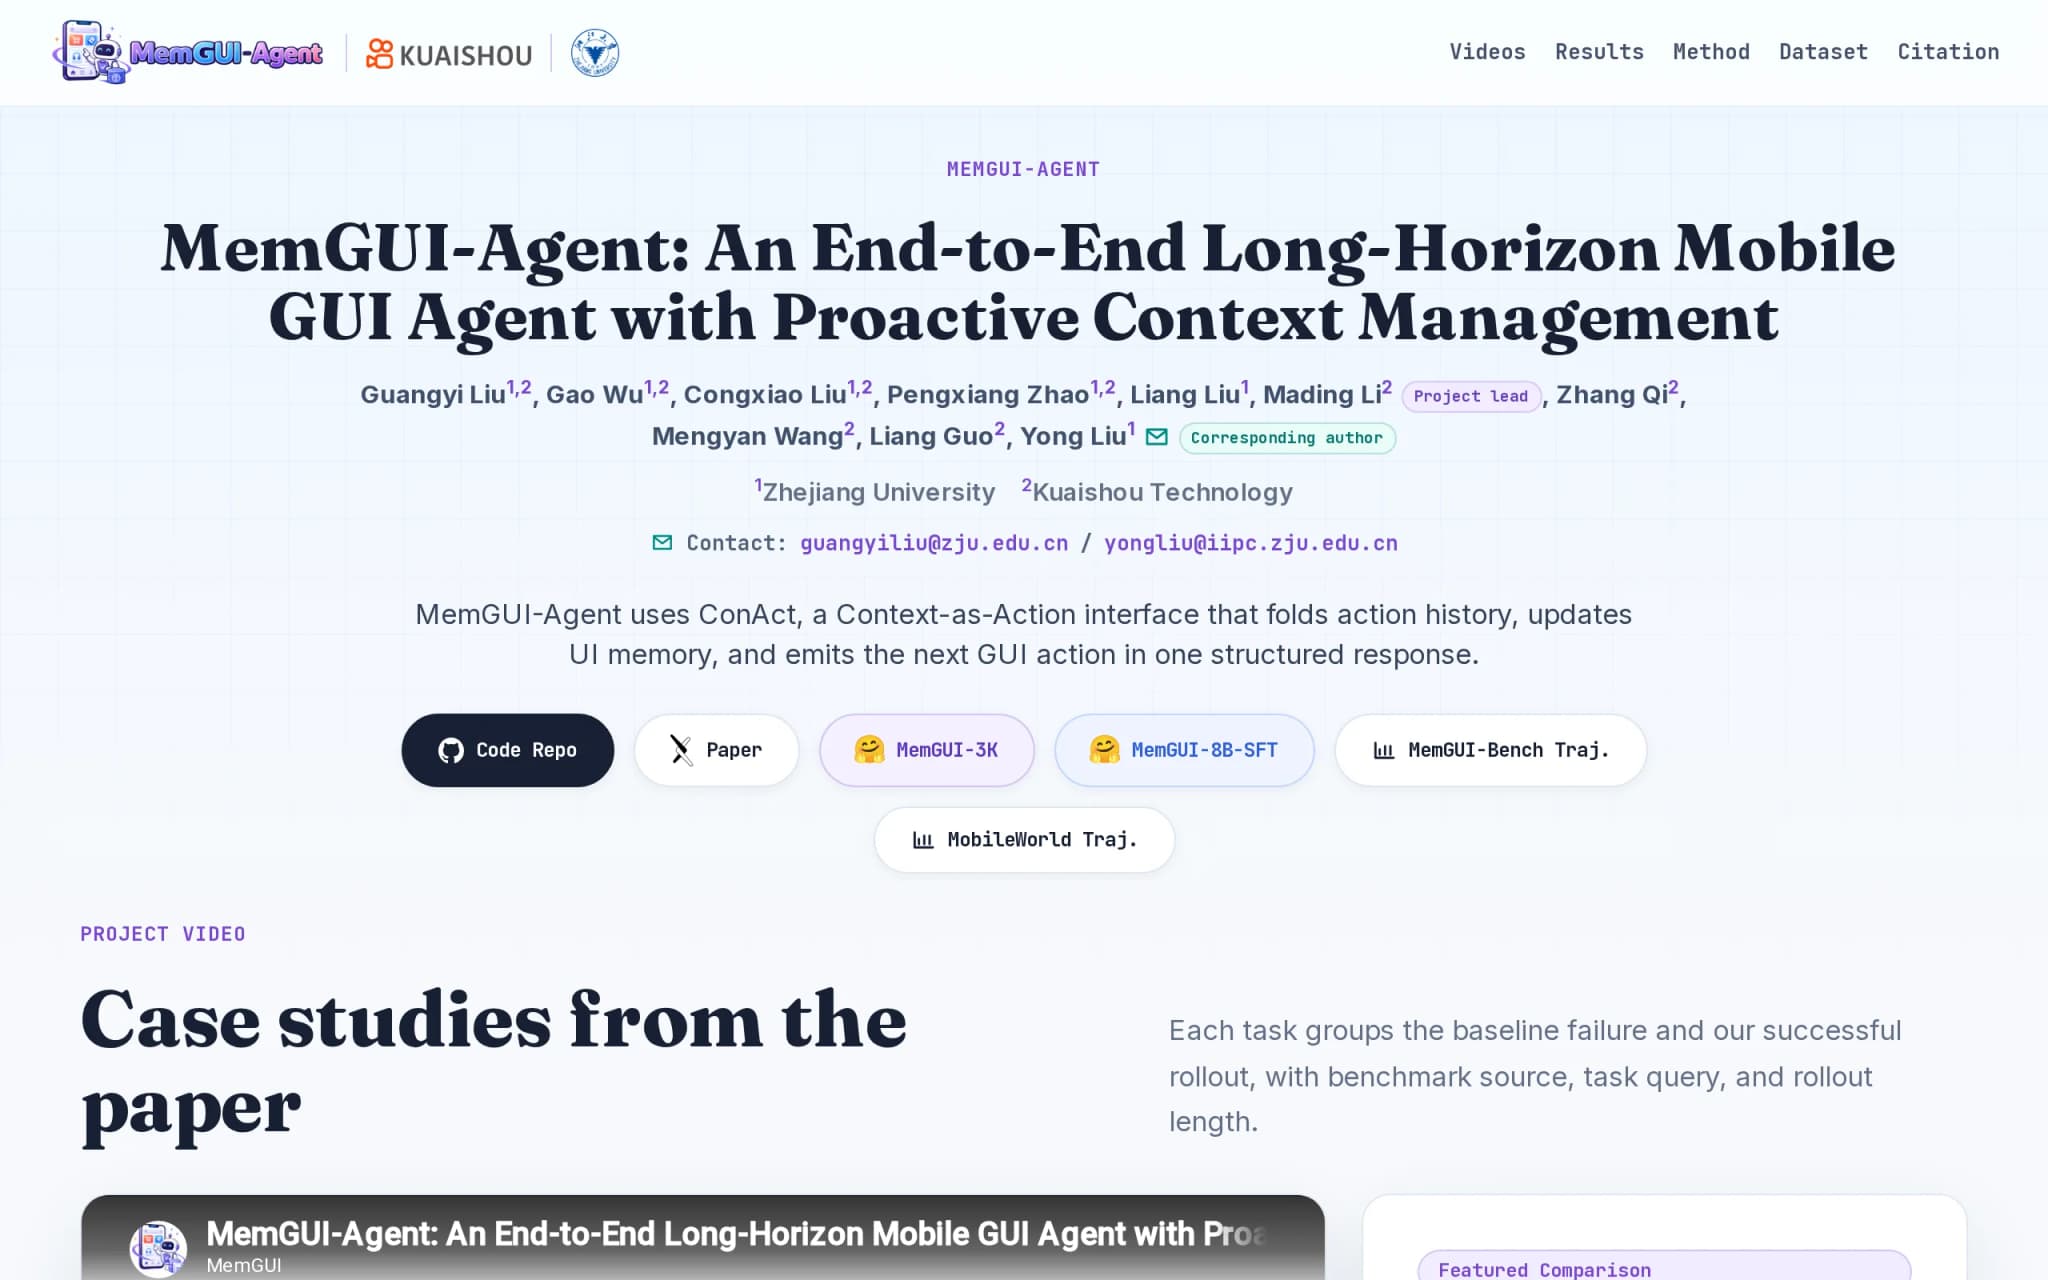
MemGUI-Agent 是由浙江大学与快手联合研发的长程手机GUI智能体,专门用于跨App、多步骤、长链条的移动端自动化任务。传统ReAct风格Agent在长程任务中会因历史记录线性膨胀导致关键信息被稀释,MemGUI-Agent通过创新性的ConAct(Context-as-Action)协议,让模型在每一步同时决定如何操作UI和如何整理记忆,实现紧凑且结构化的上下文管理。基于Qwen3-VL...
GPT-Realtime-2.1 – OpenAI推出的一代实时语音模型
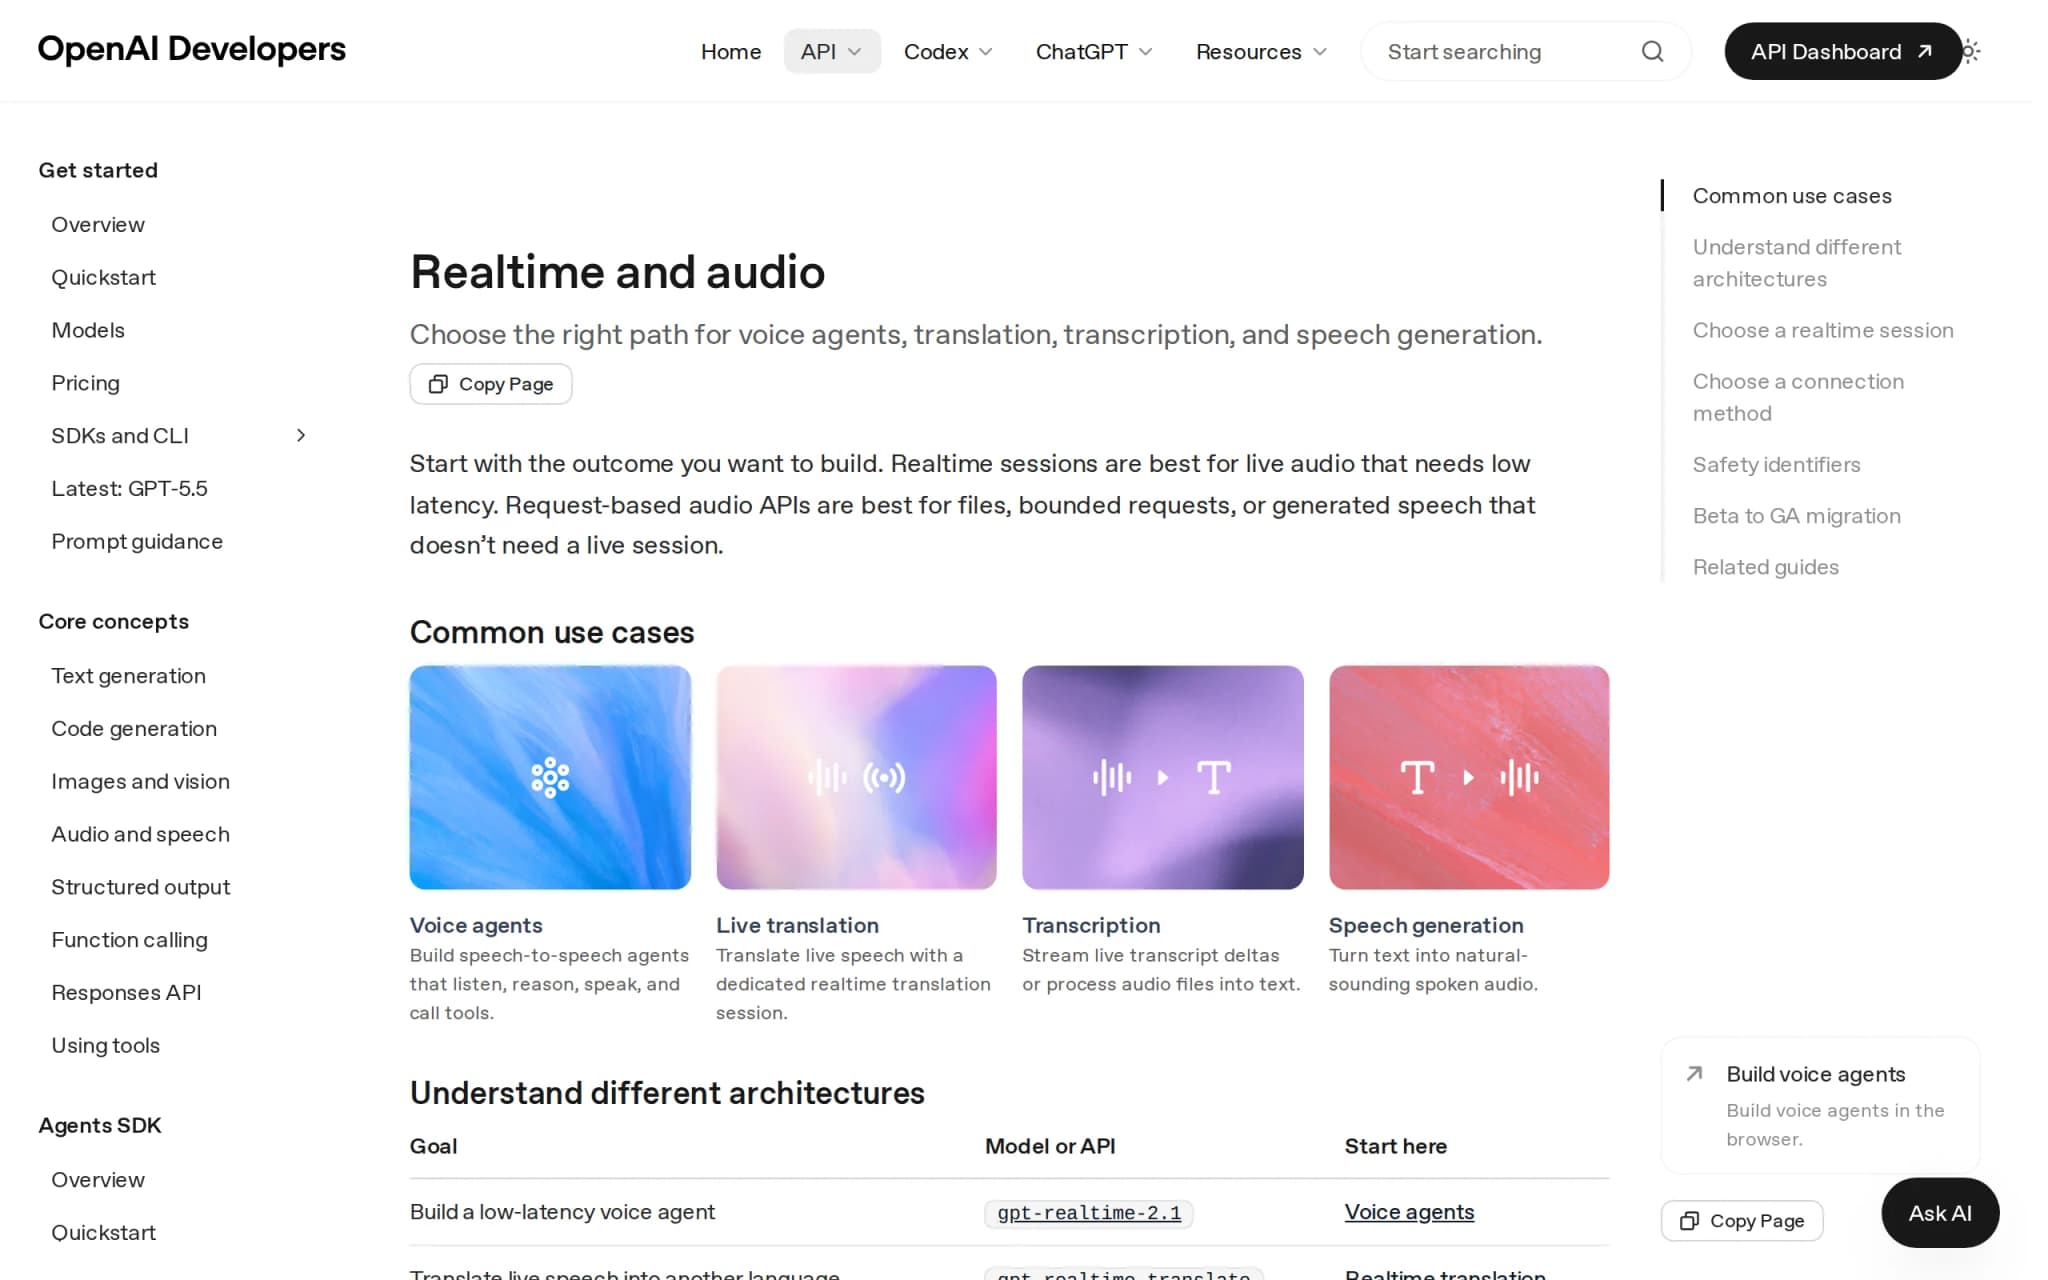
GPT-Realtime-2.1是OpenAI于2025年推出的新一代实时语音模型系列,包含旗舰版GPT-Realtime-2.1和高性价比版GPT-Realtime-2.1-mini。该系列采用端到端原生音频建模架构,直接处理音频Token,避免了传统语音转文字再转语音的级联方案所带来的信息损失与延迟。相较于前代,2.1版本在字母数字识别、静音/噪音处理及对话中断响应方面实现了显著提升,同时支持...
GenEvolve – 美团等推出的自演进图像生成 Agent
GenEvolve是由香港科技大学(广州)、美团与新加坡国立大学联合研发的自演进图像生成Agent,它将开放式图像生成任务形式化为工具编排的视觉轨迹,通过搜索文本证据、检索视觉参考、调用生成知识,最终合成可执行的prompt-reference program,交由任意参考条件生成器渲染。该Agent基于Qwen3-VL-8B-Instruct模型,采用两阶段训练策略——SFT冷启动与GRPO强化...
Leanstral 1.5 – Mistral AI 开源的形式化验证大模型
Leanstral 1.5 是 Mistral AI 开源的形式化验证大模型,专为 Lean 4 自动定理证明深度优化。该模型采用 119B 参数的稀疏混合专家(MoE)架构,每 token 仅激活 6.5B 参数,在保持强大推理能力的同时显著降低推理成本。模型支持 256k 超长上下文窗口与图文多模态输入,在 miniF2F、PutnamBench、FATE-H 等数学证明基准上均达到当前最优(...
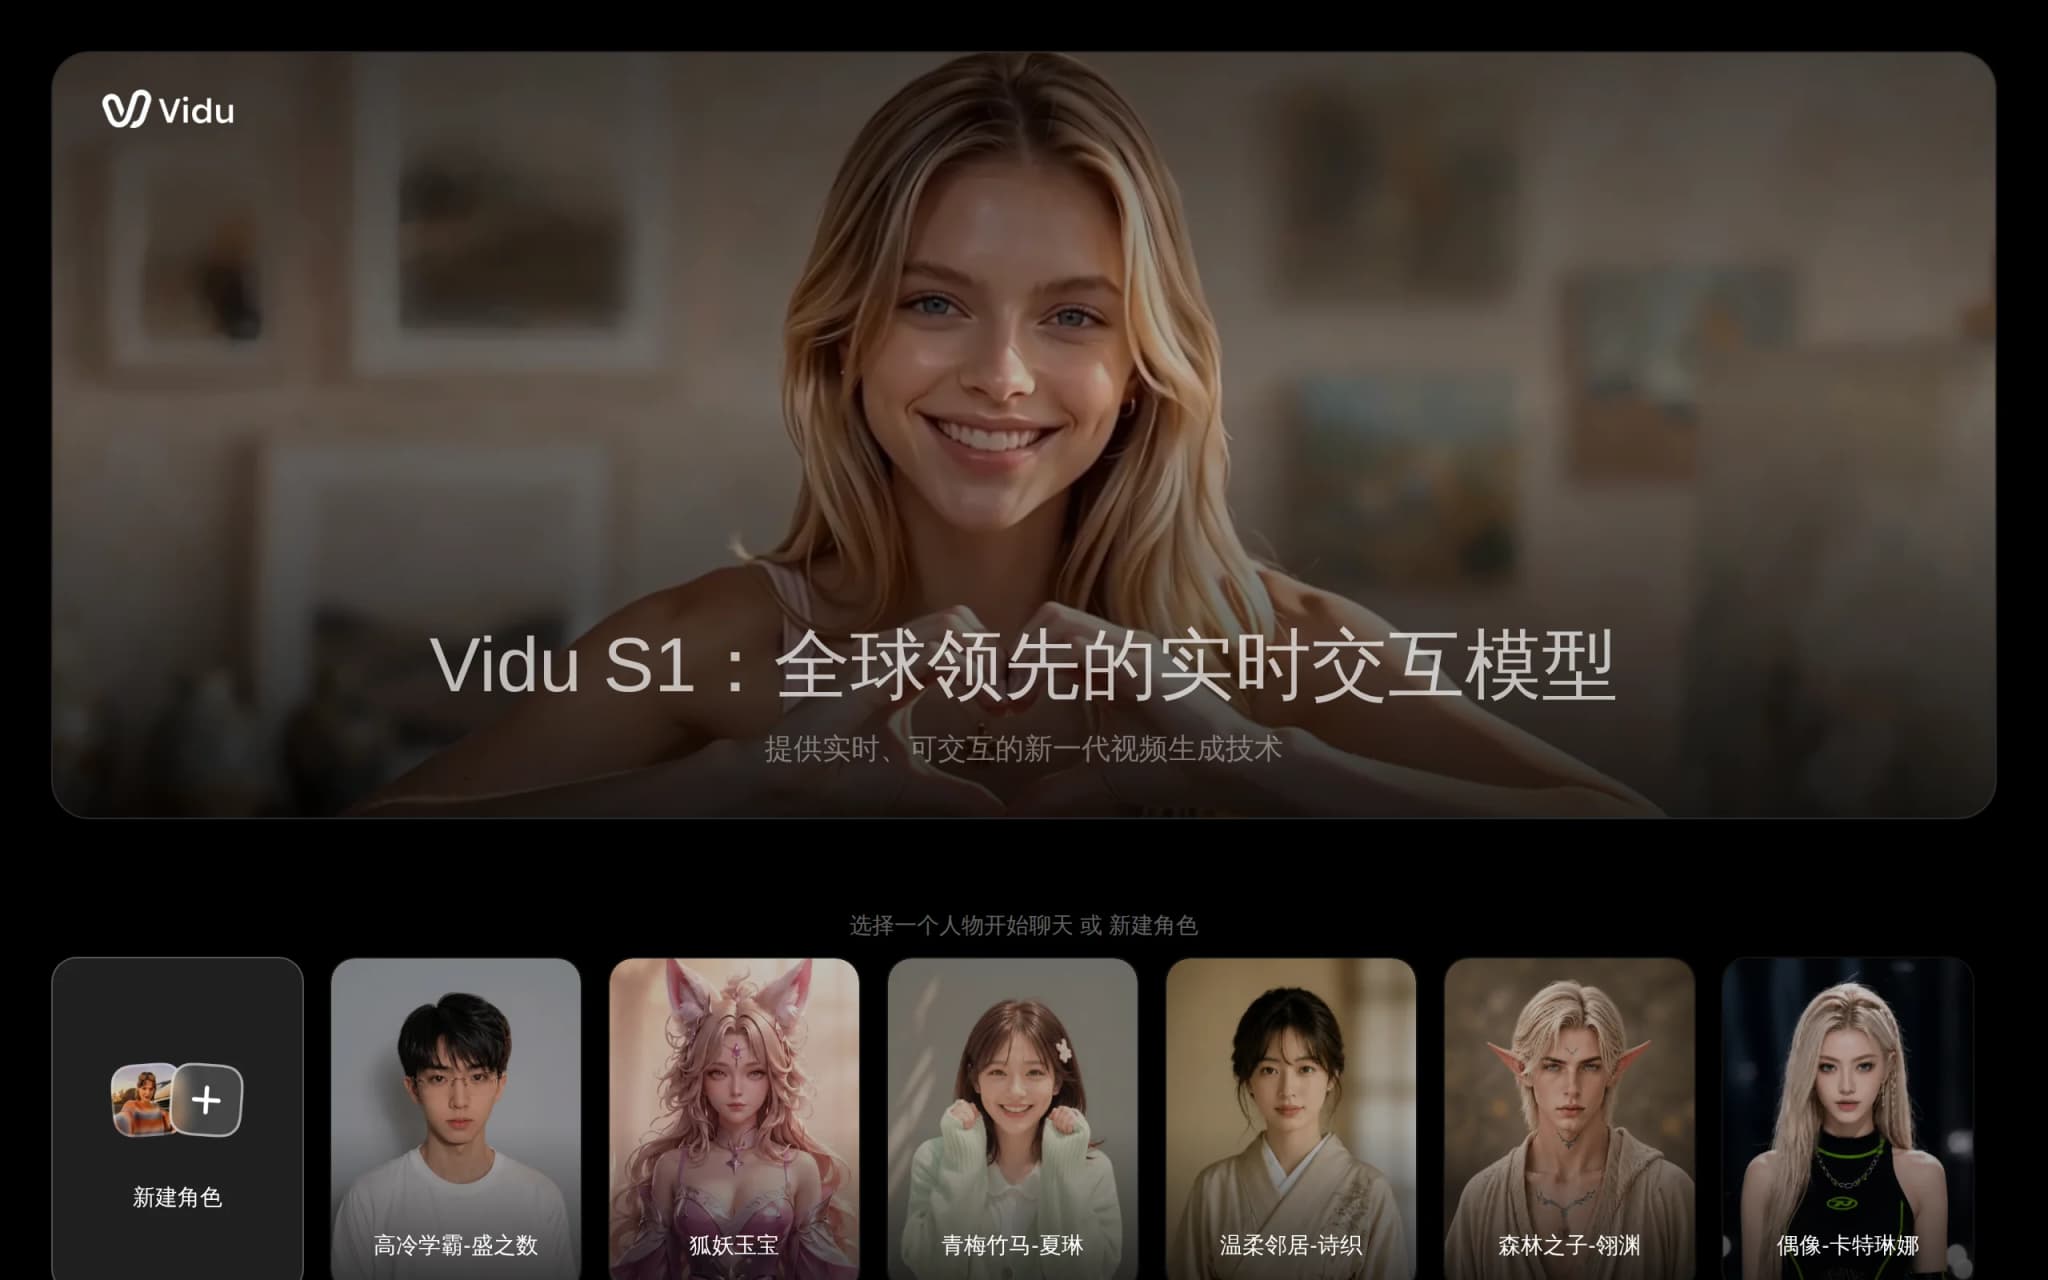
Vidu S1 – 生数科技推出的实时交互视频基础模型
Vidu S1是生数科技推出的全球领先实时交互视频基础模型,标志着AI视频生成从离线批量渲染迈入实时双向互动时代。该模型基于自回归扩散(AR+Diffusion)混合架构,支持540P分辨率、25FPS(最高可达42FPS)的实时视频流式生成,并且可在消费级GPU上运行,大幅降低了部署门槛。用户只需上传一张图片即可零训练创建数字角色,通过语音指令实时驱动角色的表情、口型、手势及全身动作,实现无限时...
WorldCupVoice – 开源的 AI 实时体育解说系统
WorldCupVoice 是一款基于开源理念构建的 AI 实时体育解说系统,通过接入 Agora RTC 直播流,由视觉模型实时分析比赛画面并生成语音解说,再回传至直播间与观众同步收听。系统支持 OpenAI TTS、ElevenLabs 和 Fish Audio 等多语音引擎,可配置英语、法语、中文等多语言解说风格,专为世界杯等大型体育赛事设计,同时兼顾视障用户的无障碍观赛需求,提供球场空间细...
LiveWorld – 阿德莱德大学等推出的生成式视频世界模型
LiveWorld是由阿德莱德大学、澳大利亚国立大学等机构联合推出的生成式视频世界模型,核心解决视野外动态问题——当物体离开相机视野后,传统模型会将其状态冻结,而LiveWorld通过显式解耦世界演化与观察渲染,让动态实体在不可见时仍能持续推进,实现真正的4D世界模拟。该模型将世界状态表示为静态3D背景与动态4D实体的结构化近似,而非直接预测2D帧,从而在长时序、多视角场景下保持几何一致性与事件逻...
Nano Banana 2 Lite – 谷歌推出的轻量级 AI 图像生成模型
Nano Banana 2 Lite 是谷歌推出的自研轻量级 AI 图像生成模型,定位速度优先的极速版,可在 4 秒内生成单张图像,每千张收费仅 0.034 美元。该模型基于 Gemini 3.1 Flash 底层能力进行蒸馏压缩,在保留核心生成质量的同时大幅削减计算开销,相比标准版 Nano Banana 2 延迟更低、成本更便宜,主打高频批量生产与快速迭代场景。目前已取代初代 Nano Ban...
LocateAnything – 英伟达推出的视觉语言定位模型
LocateAnything是英伟达(NVIDIA)推出的视觉语言定位模型,基于并行框解码(PBD)技术,用户输入自然语言即可在图像中精准框选目标。该模型以3B参数量实现了多目标检测、GUI元素定位、OCR文本检测和点级指向等多样化任务,在单张H100 GPU上推理速度达到12.7 BPS(边界框每秒),较Qwen3-VL快约10倍,在LVIS、M6Doc、ScreenSpot-Pro、DocLa...