AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
Magenta RealTime 2 – 谷歌Magenta开源的实时音乐生成模型
Magenta RealTime 2(MRT2)是谷歌 Magenta 团队推出的第二代开源本地实时音乐生成模型,基于逐帧自回归架构,将音频生成延迟压缩至约200毫秒,实现接近真实乐器演奏的交互体验。该模型采用编解码器语言模型范式,通过 SpectroStream 音频编解码器将48kHz立体声离散化为25Hz帧率的标记序列,以40毫秒每帧的粒度逐帧预测并解码输出。MRT2提供 mrt2_base...
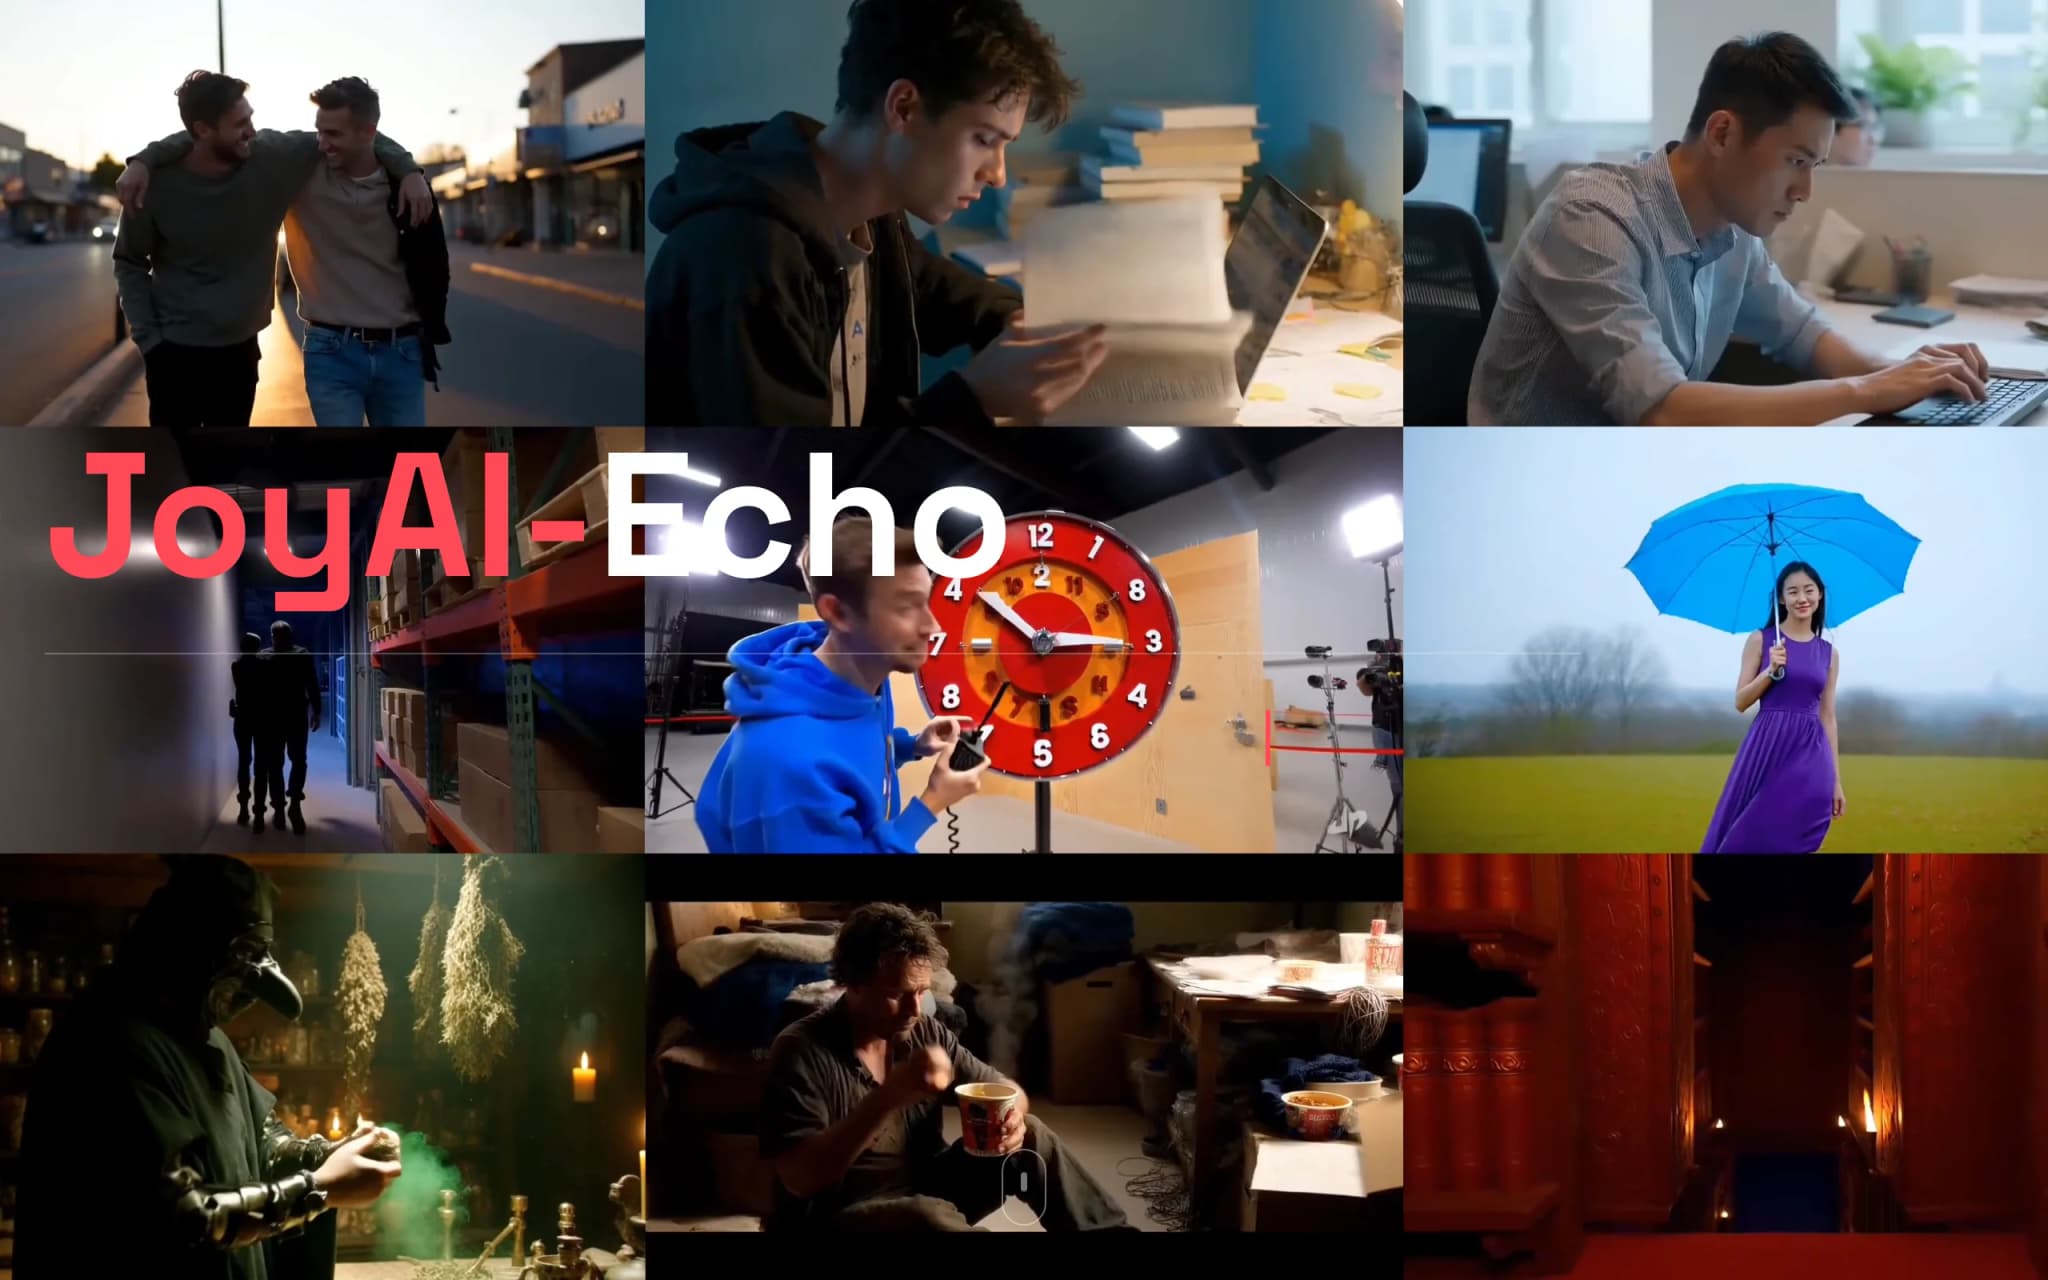
JoyAI-Echo – 京东开源的长音视频生成框架
JoyAI-Echo是京东未来实验室推出的开源长音视频生成框架,专为分钟级多镜头故事生成设计。该框架通过跨模态记忆库、记忆驱动后训练、Director Agent对话式编辑和轻量化实时超分四大技术创新,解决了长视频生成中角色变脸、音色突变、生成缓慢等核心痛点,首次实现长达5分钟的高一致性、可交互、高清长视频生成。作为基于LTX-2.3与Gemma-3-12B构建的端到端系统,JoyAI-Echo标...
Odysseus – 开源的本地自托管 AI 工作空间
Odysseus是一个开源的、可本地自托管的AI工作空间,旨在为用户提供一个集成了聊天、智能体、深度研究、笔记、任务、日历和邮件等十余项功能的私有化AI中枢。它通过统一抽象层对接vLLM、Ollama、OpenRouter等多种模型后端,支持本地模型与云端API的无缝切换,并采用ChromaDB实现本地持久化向量记忆。其核心价值在于将AI能力完全本地化运行,确保所有数据不离开本机,从根本上解决隐私...
Hermes Desktop – Nous Research 推出的 Hermes 桌面端
Hermes Desktop 是由 Nous Research 推出的官方桌面客户端,旨在将强大的 Hermes AI Agent 能力带入本地图形化环境。它支持 macOS、Windows 和 Linux 三大平台,具备持久记忆、任务调度、子代理委派、网页浏览、多模态推理和隔离沙箱等核心功能,用户无需接触命令行即可在桌面端运行复杂的 AI 任务,显著降低使用门槛。作为一款本地优先的智能体平台,H...
PaddleOCR-VL-1.6 – 百度推出的文档解析视觉语言模型
PaddleOCR-VL-1.6 是百度飞桨团队推出的面向文档解析的视觉语言模型(VLM),以仅 0.9B 参数在 OmniDocBench v1.6 权威基准上达到 96.33% 的全新 SOTA 成绩,全面超越开源与闭源方案。该模型采用“版面分析+VLM识别”的两阶段解耦架构,通过纯数据驱动的训练策略升级,实现了文本、公式、表格、古籍、印章等多场景的精准解析,同时支持零成本从 1.5 版本迁移...
Bernini – 字节跳动开源的统一视频生成与编辑框架
Bernini是字节跳动开源的一套统一视频生成与编辑框架,采用“多模态大语言模型(MLLM)语义规划 + Diffusion Transformer(DiT)视觉渲染”的两阶段解耦架构。该框架先由MLLM理解文本指令、参考图像或视频素材,在ViT嵌入空间中预测目标语义表示(语义草图),再交由DiT在VAE潜在空间中执行流匹配去噪,生成高质量视频帧。Bernini支持文本生成视频、图像生成视频、环境...
Qwen3.7-Plus – 阿里通义推出的智能体多模态大模型
Qwen3.7-Plus是阿里云通义千问团队推出的新一代多模态大模型,以“智能体基座”为核心定位,将视觉感知、语言理解、代码生成与GUI操控整合为统一的工作流闭环。该模型能够实时理解真实世界场景、读取屏幕内容并执行多步操作、基于视觉参考生成可执行代码,在单一智能体循环中无缝融合命令行(CLI)与图形界面(GUI)交互。作为全能型编码智能体与生产力助手,Qwen3.7-Plus覆盖从前端原型设计到复...
Dubbing v2 – ElevenLabs 推出的 AI 配音模型
Dubbing v2是ElevenLabs在AI配音领域的最新力作,一个集语音识别、神经机器翻译、语音克隆与合成于一体的端到端多语言配音平台。它能够将视频或音频内容自动翻译并配音成29种语言,同时高度保留原始说话人的音色、情感和语调,彻底颠覆了传统配音行业高成本、低效率的工作模式。该模型通过双工作流设计(快速自动配音与精细项目编辑),兼顾了内容创作者对效率和质量的双重需求,为全球内容本地化提供了一...
Cosmos 3 – 英伟达开源的全模态物理 AI 基础大模型
Cosmos 3 是英伟达推出的全球首款全开源、全模态物理 AI 基础大模型,采用创新的混合 Transformer 架构,原生融合视觉推理、世界生成与动作预测能力。该模型能够统一处理并生成文本、图像、视频、环境音效及动作轨迹等多种模态内容,在物理仿真精度上达到了业界领先水平。英伟达同步发起 Cosmos Coalition 联盟,联合 Runway、Black Forest Labs 等顶尖 A...
MiniMax M3 – MiniMax 推出的一代 AI 模型
MiniMax M3是MiniMax公司推出的新一代AI模型,采用创新的MSA稀疏注意力架构与MoE混合专家结构,在编程、Agent与长文本处理领域展现出领先性能。该模型总参数量196B,但每次推理仅激活约11B参数,支持高达100万tokens的超长上下文,处理效率较传统模型提升20倍。在SWE-Bench Pro等权威评测中,M3的编程能力已超越GPT-5.5等主流模型,同时原生支持图像与视频...