AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI科学
共 34 篇文章 · 清除标签
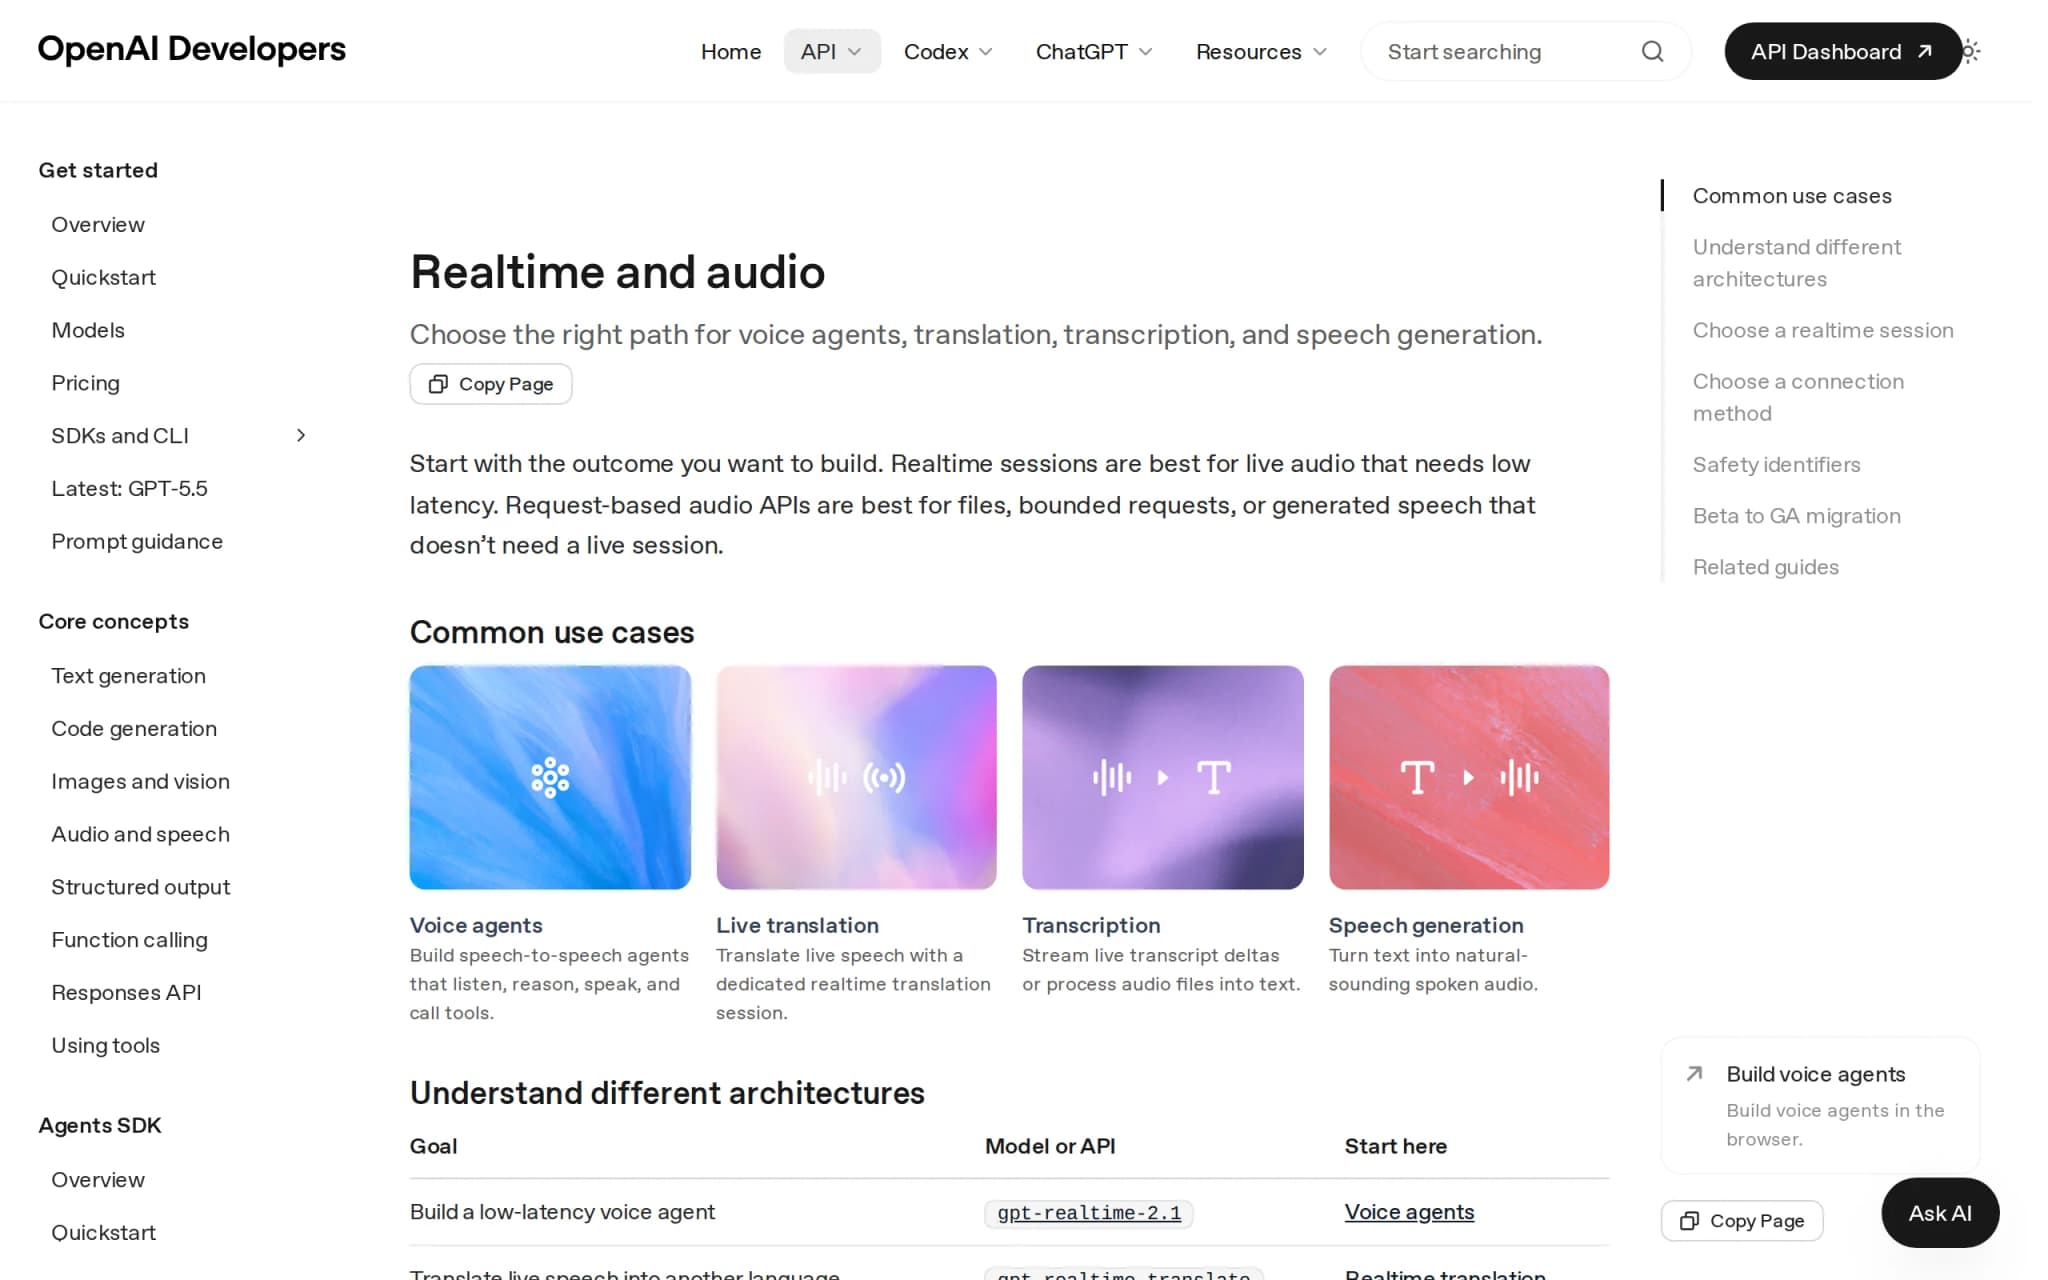
GPT-Realtime-2.1 – OpenAI推出的一代实时语音模型
GPT-Realtime-2.1是OpenAI于2025年推出的新一代实时语音模型系列,包含旗舰版GPT-Realtime-2.1和高性价比版GPT-Realtime-2.1-mini。该系列采用端到端原生音频建模架构,直接处理音频Token,避免了传统语音转文字再转语音的级联方案所带来的信息损失与延迟。相较于前代,2.1版本在字母数字识别、静音/噪音处理及对话中断响应方面实现了显著提升,同时支持...
OpenScience – Synthetic Sciences 开源的 AI 科研工作台
OpenScience 是由 Synthetic Sciences 推出的开源 AI 科研工作台,旨在为机器学习、生物学、物理学和化学研究者提供从文献综述、假设生成、代码编写、实验执行到结果分析与论文撰写的完整科研循环。平台采用模型无关路由架构,支持按请求切换 Claude、GPT、Gemini、GLM、Kimi、DeepSeek 及本地微调模型,内置 250 余项可编辑技能和约 30 个科学数据...
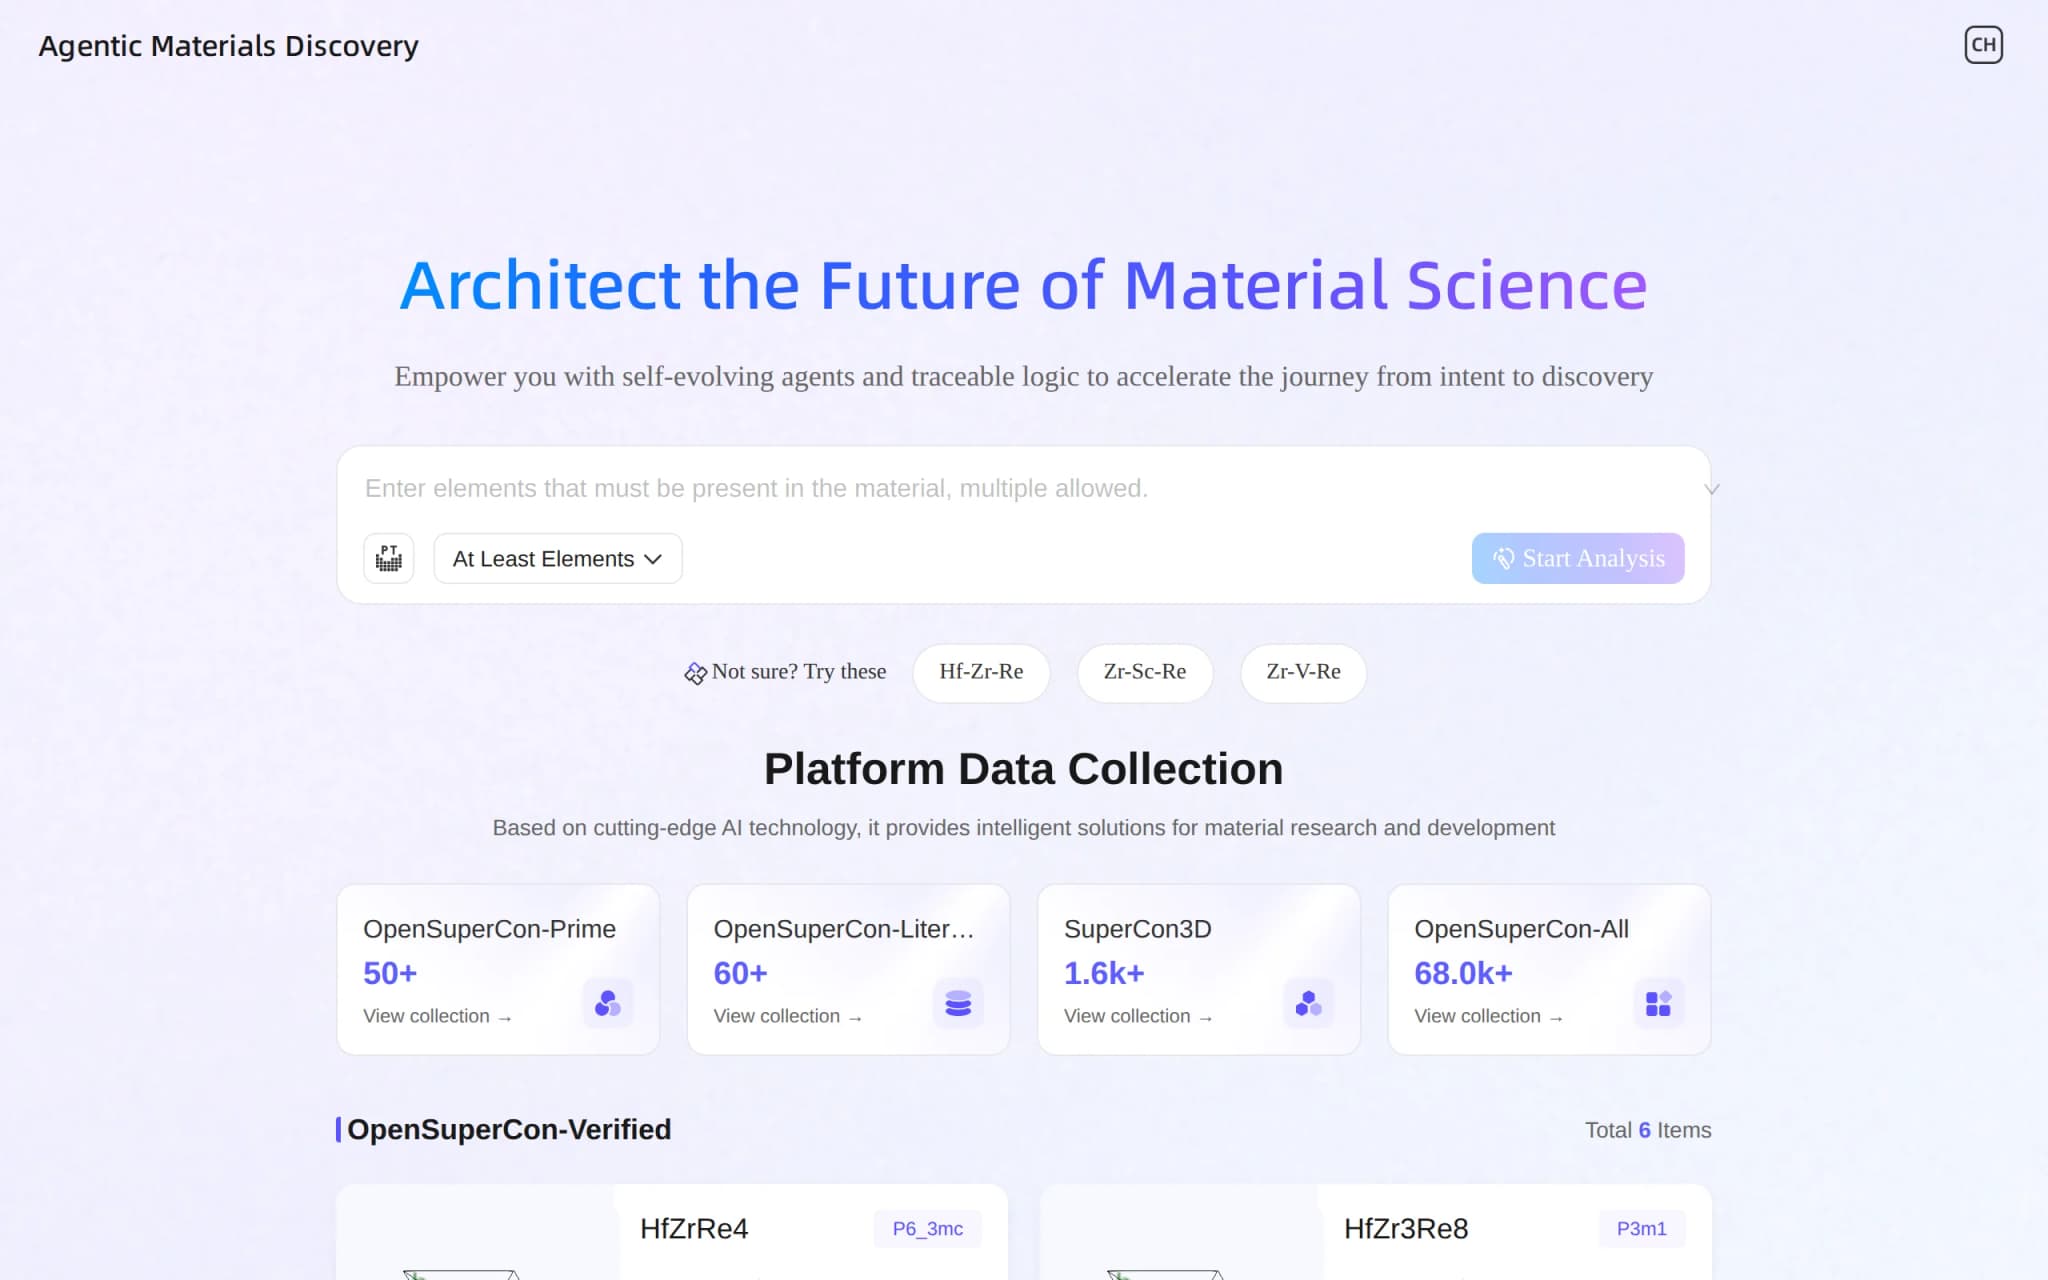
Elements Claw – 阿里达摩院推出的超导材料发现 AI 智能体
Elements Claw是阿里达摩院联合中国人民大学、中国科学院大学推出的行业首个超导材料发现AI智能体。它采用专通融合架构,将10亿参数原子基础模型Elements与大型语言模型(LLM)深度耦合,实现从文献检索、性质预测到实验方案设计的全流程自动化材料筛选。该智能体仅用28个GPU小时即完成240万晶体结构筛选,预测出6.8万个超导候选材料,并成功实验验证4种全新超导材料,标志着AI在功能材...
EdgeBench – 字节跳动推出的 AI 学习能力基准测试框架
EdgeBench 是字节跳动 Seed 团队推出的基准测试框架,专用于评估自主 AI Agent 在真实世界环境中的长期学习能力。框架包含 134 个真实任务,覆盖科学计算、软件工程、组合优化等 6 大领域,通过 12‑72 小时的持续运行追踪 Agent 的尝试‑观察‑吸收‑改进学习曲线,揭示 AI 从环境中学习的可预测缩放规律。该框架不仅提供人类专家(平均 57.2 小时)的完成基准,还通过...
GeneBench-Pro – OpenAI 推出的计算生物学研究级基准测试
GeneBench-Pro是OpenAI推出的研究级基准测试,专门用于评估AI模型在计算生物学中处理判断密集型分析的能力。该基准包含129个跨基因组学、定量生物学和转化医学的问题,每个任务均提供真实且混乱的合成数据集,要求模型自主探索数据、选择分析路径、迭代实验并给出最终答案,核心考察的是高阶科学推理与决策能力。作为继GeneBench原始版本后的重大升级,GeneBench-Pro通过全合成数据...
GPT-5.6 – OpenAI 推出的最一代大语言模型系列
GPT-5.6 是 OpenAI 推出的最新一代大语言模型系列,受美国政府监管要求目前仅以“有限预览”形式向少数可信合作伙伴开放。该系列首次采用天文学命名体系,推出三档型号:旗舰版 Sol(太阳)面向高难复杂任务,是目前性能最强的版本;均衡版 Terra(地球)性能对标 GPT-5.5 但价格仅一半,适合日常工作流;轻量版 Luna(月亮)主打速度与低成本。核心能力聚焦于编程、生物信息学和网络安全...
Baichuan-M4 – 百川智能联合清华推出的医疗增强模型
Baichuan-M4是百川智能联合清华大学推出的新一代医疗增强大模型,在HealthBench综合、Hard、Professional三个权威榜单同时位列世界第一,幻觉率低至3.3%为全行业最低。该模型突破通用大模型被动应答的局限,聚焦深度问诊、全病程记忆、证据锚定与Agent自主调度四大临床核心能力,让AI从会答题真正迈向会看病。

LOGOS – 阿里开源的首个统一科学大模型
LOGOS(Language Of Generative Objects in Science)是阿里 ATH-Token Foundry 联合中国人民大学高瓴人工智能学院开源的首个统一科学语法多领域科学生成基础模型。该模型创新性地将蛋白质、小分子、材料、抗体等异构科学对象编码为统一的 Token 序列,基于纯序列建模范式,在口袋配体生成、逆合成预测、蛋白质编辑、材料生成等六大科学任务上一致性匹配...
Science Skills – 谷歌 DeepMind 开源的科研技能工具包
Science Skills是谷歌DeepMind推出的开源科研技能工具包,旨在通过标准化、模块化的AI Agent架构,重塑生命科学领域的研究工作流。该工具包整合了AlphaGenome、AlphaFold Database、UniProt等超过30个生命科学数据库与工具,覆盖基因组学、结构生物学、化学信息学和文献检索等核心领域。其核心价值在于,通过让AI Agent自主执行脚本,将原本需要数小...
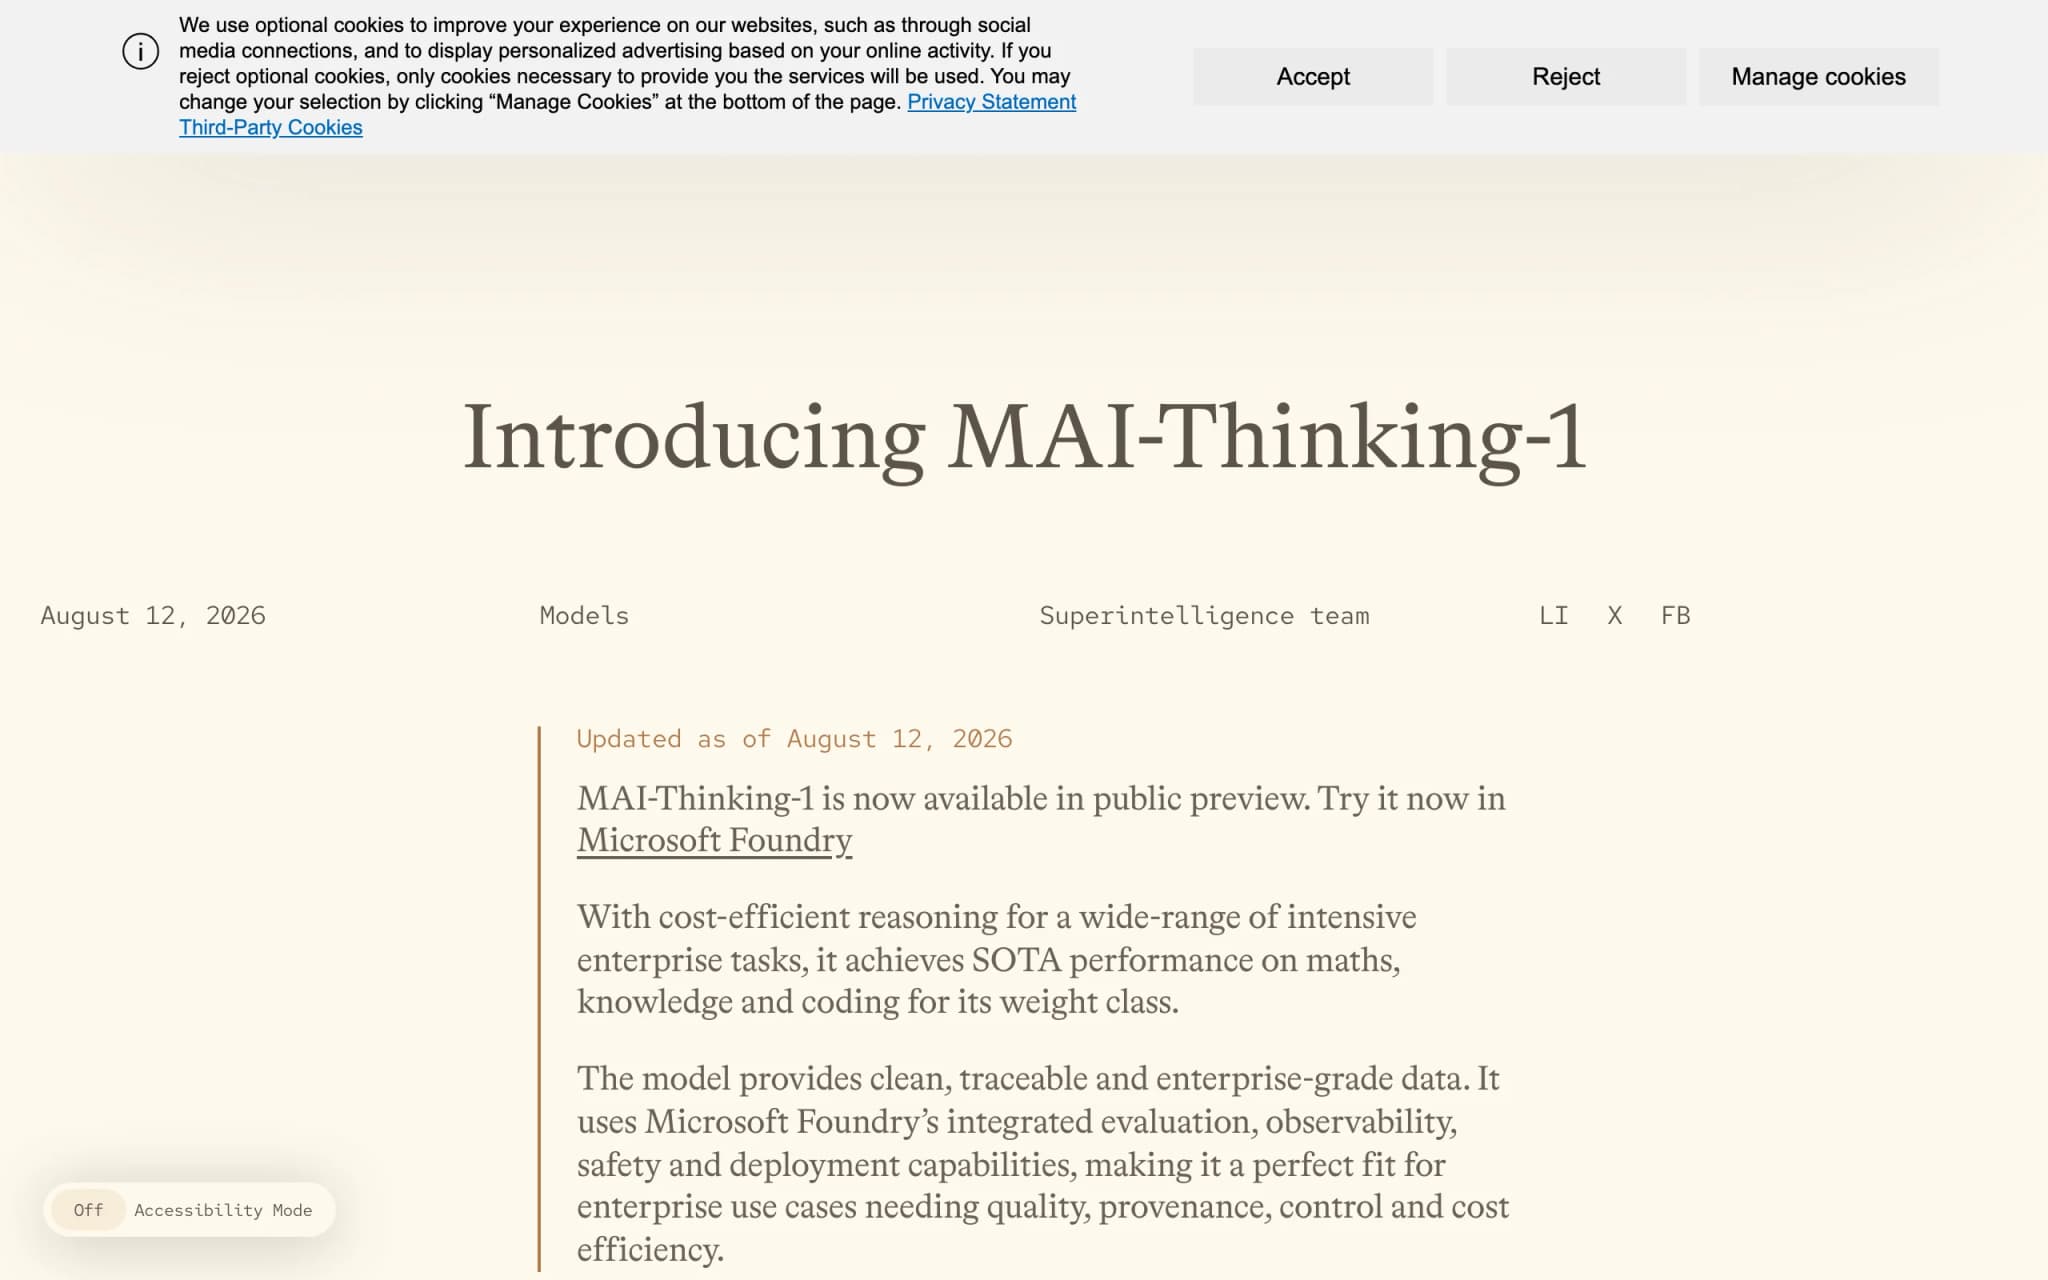
MAI-Thinking-1 – 微软推出的首款自研高级推理模型
MAI-Thinking-1是微软推出的首款自研高级推理模型,标志着微软在基础大模型领域从跟随者向领跑者的战略转型。该模型采用35B活跃参数/约1T总参数的稀疏MoE架构,完全基于干净、商业授权数据从头训练,未使用任何第三方模型蒸馏,在SWE-Bench Pro、AIME 2025/2026等关键基准上达到业界顶尖水平,与Claude Opus 4.6持平,在盲测中优于Sonnet 4.6。MAI...