AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:图像生成
共 63 篇文章 · 清除标签
MiniMax H3 Max:fal 后训练的实时视频生成,快于实时,benchmark 缺失
H3 Max 已正式发布,是 MiniMax 与 fal.ai 联合推出的托管视频生成服务,其基座 H3 已开源。它适合要把视频生成接进内容生产流程的团队,以及想零门槛试用的个人用户;不适合把权重可控、评测可复现、本地部署当硬性要求的团队。
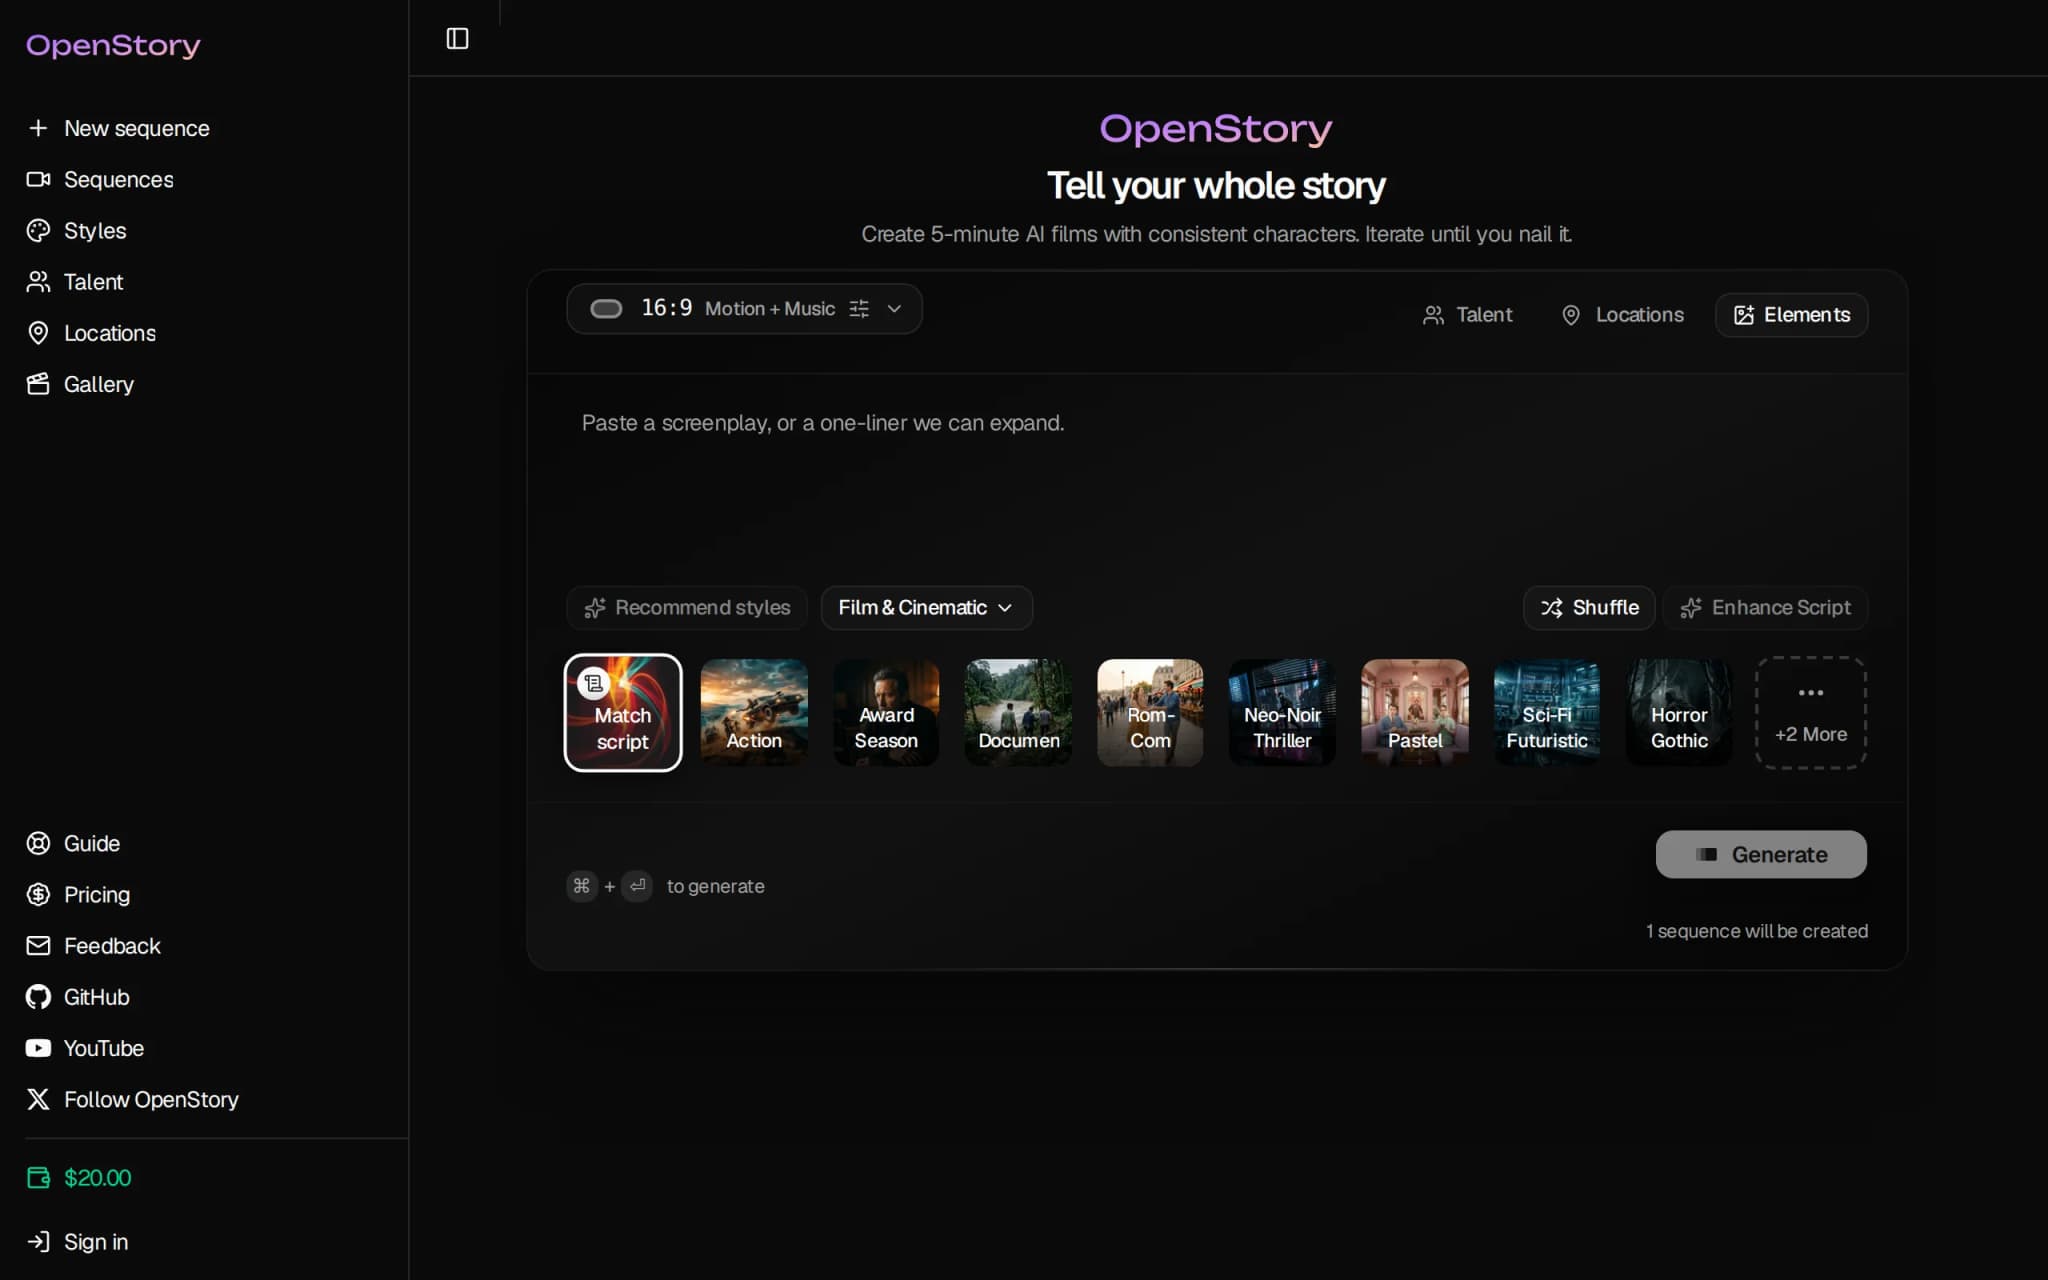
OpenStory:开源AI视频制作平台,一键生成风格统一的短剧视频
OpenStory是一款开源的AI视频制作平台,专注于将剧本一键转化为风格统一的短剧视频。平台能够自动拆分场景、设计镜头、分析情绪氛围,并调用Fal.ai等成熟模型生成图片、视频与音频,同时确保角色外貌、场景布局和视觉风格跨镜头保持一致。OpenStory支持团队协作与素材共享,采用MIT协议完全开源,为独立创作者和内容团队提供了一条从剧本到成片的标准化生产流水线。
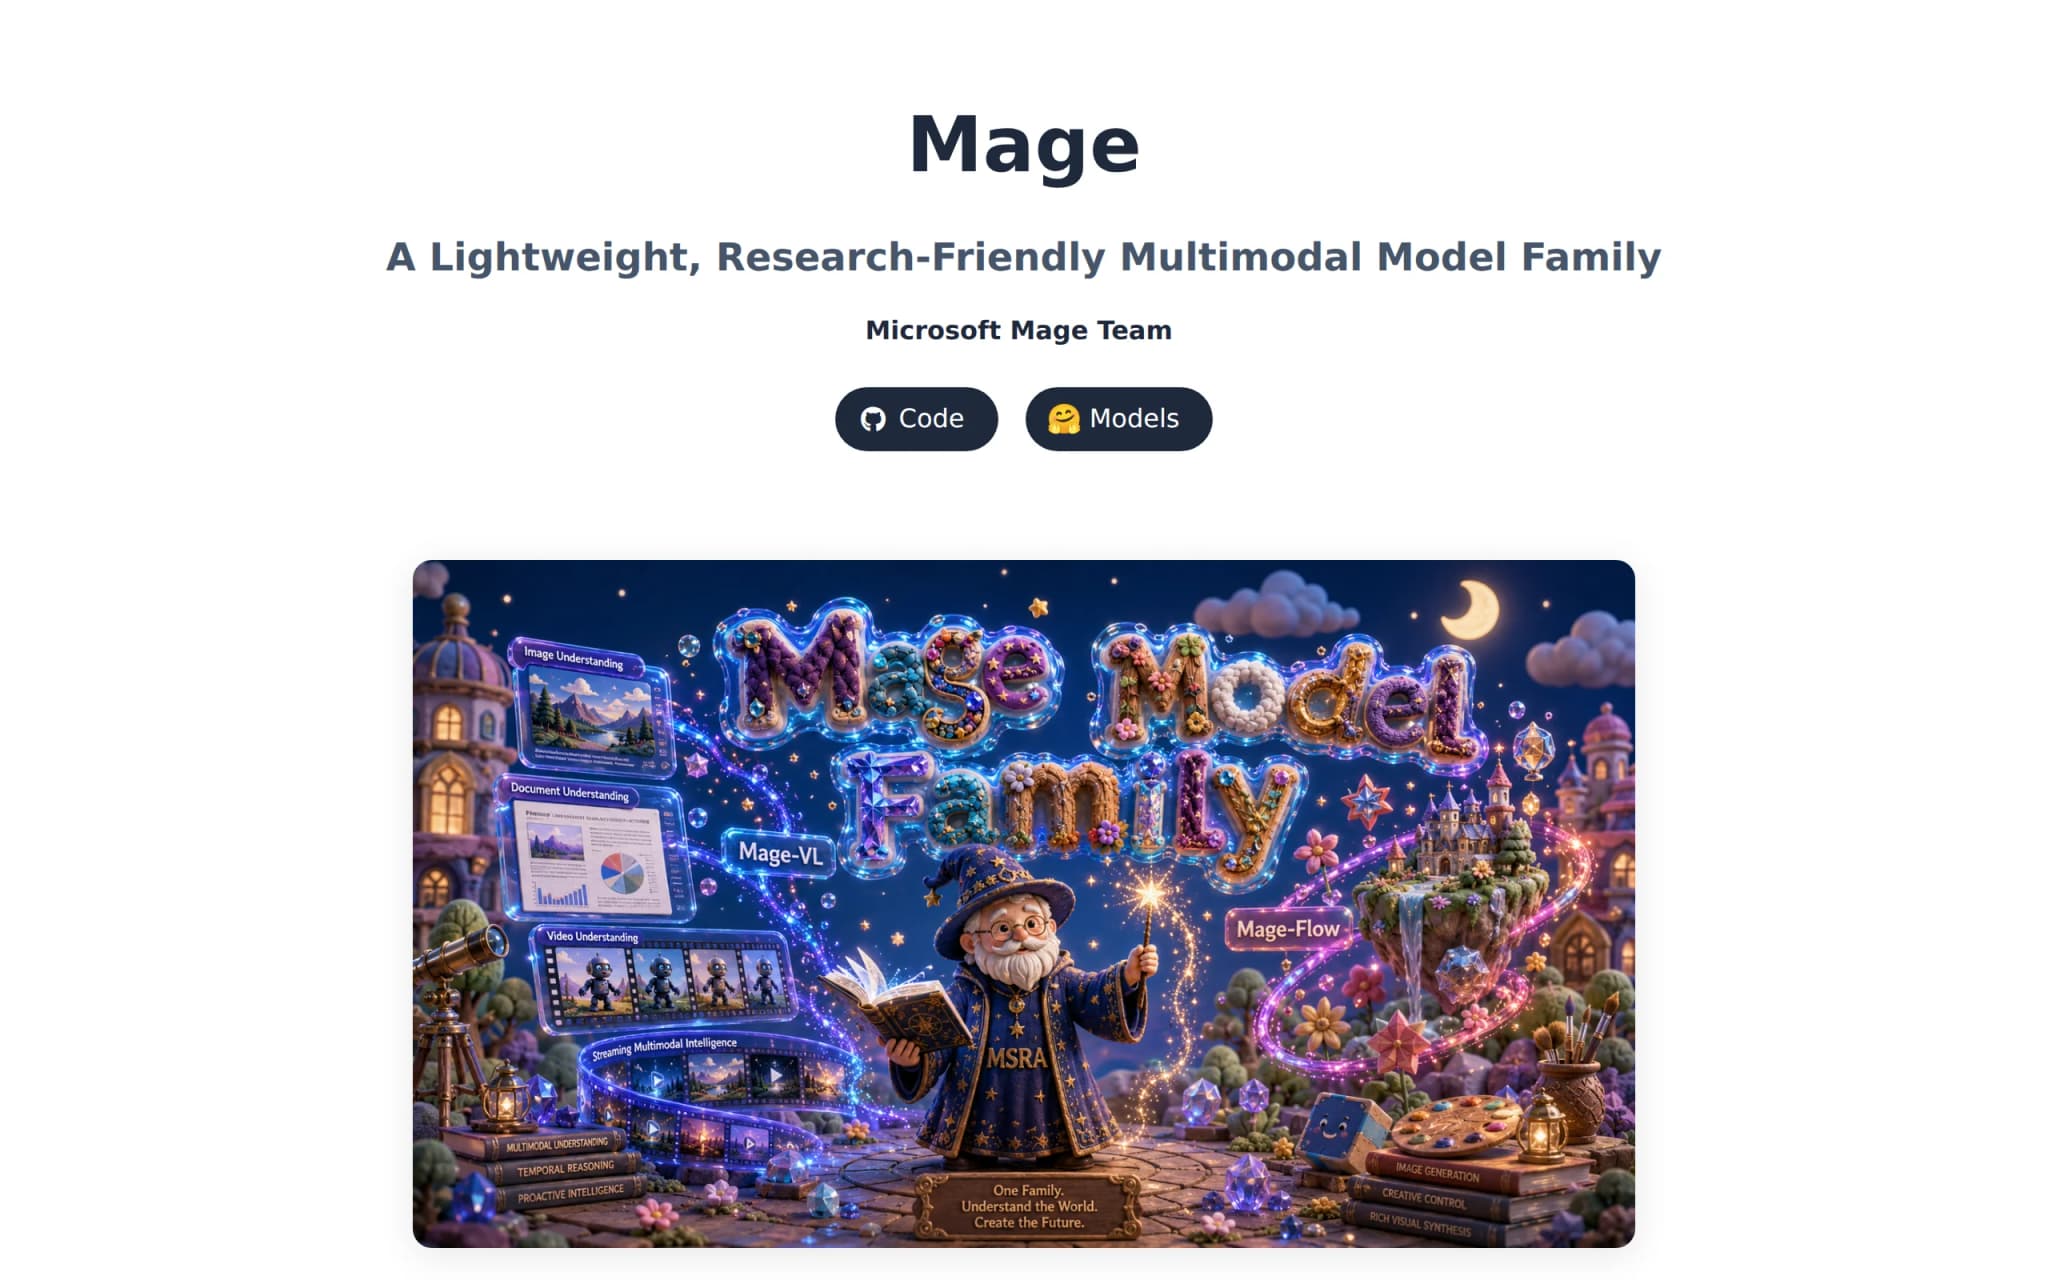
Mage – 微软开源的 4B 参数多模态模型家族
Mage是微软开源的4B参数多模态模型家族,由流式视频/图像理解模型Mage-VL与图像生成与编辑模型Mage-Flow组成。通过Codec-Native编码将视觉Token减少75%,推理提速3.5倍,支持实时视频理解;Mage-Flow支持原生分辨率生成与指令编辑,Turbo版4步采样,A100单卡0.6秒出图。该模型家族在4B参数规模下实现了生成与理解能力的统一,降低了多模态AI的部署门槛。
Luna-TTS – 宇生月伴推出的文本转语音大模型
Luna-TTS 是由上海交大系初创公司宇生月伴(VUI Labs)自主研发的文本转语音大模型。该模型摒弃了主流的自回归生成路线,采用 Masked Diffusion(掩码扩散)架构,基于 Qwen3-0.6B 语言模型进行训练,并配合自研的 Luna-Codec 编解码器,在中英日韩四种语言的 100 万小时语音数据上完成预训练。在 Hugging Face TTS Arena V2 盲听评测...
Palmier Pro – 开源 AI 视频编辑器,在剪辑中生成视频、图像
Palmier Pro 是一款为 AI 时代打造的 macOS 原生视频编辑器,采用 Swift 语言从零构建,开源且基础功能免费。其核心创新在于将生成式 AI 直接嵌入时间线,支持 Seedance、Kling 等模型在剪辑流程中生成视频、图像和音频。通过 MCP 协议与 Claude、Cursor、Codex 等 AI Agent 深度协作,实现人机共剪。用户可混合自有素材与 AI 内容,导出...
Wan-Animate-2 – 万相团队开源的新一代角色动画模型
Wan-Animate-2是万相团队开源的新一代角色动画模型,作为Wan-Animate的重大架构升级,采用端到端的双分支Diffusion Transformer(DiT)架构,直接从参考视频中捕捉运动先验,摒弃了显式姿态骨架和辅助姿态提取网络。该模型支持文本驱动的视角控制,提供可达24fps的实时流式变体,在动作保真与身份一致性方面实现了显著提升。
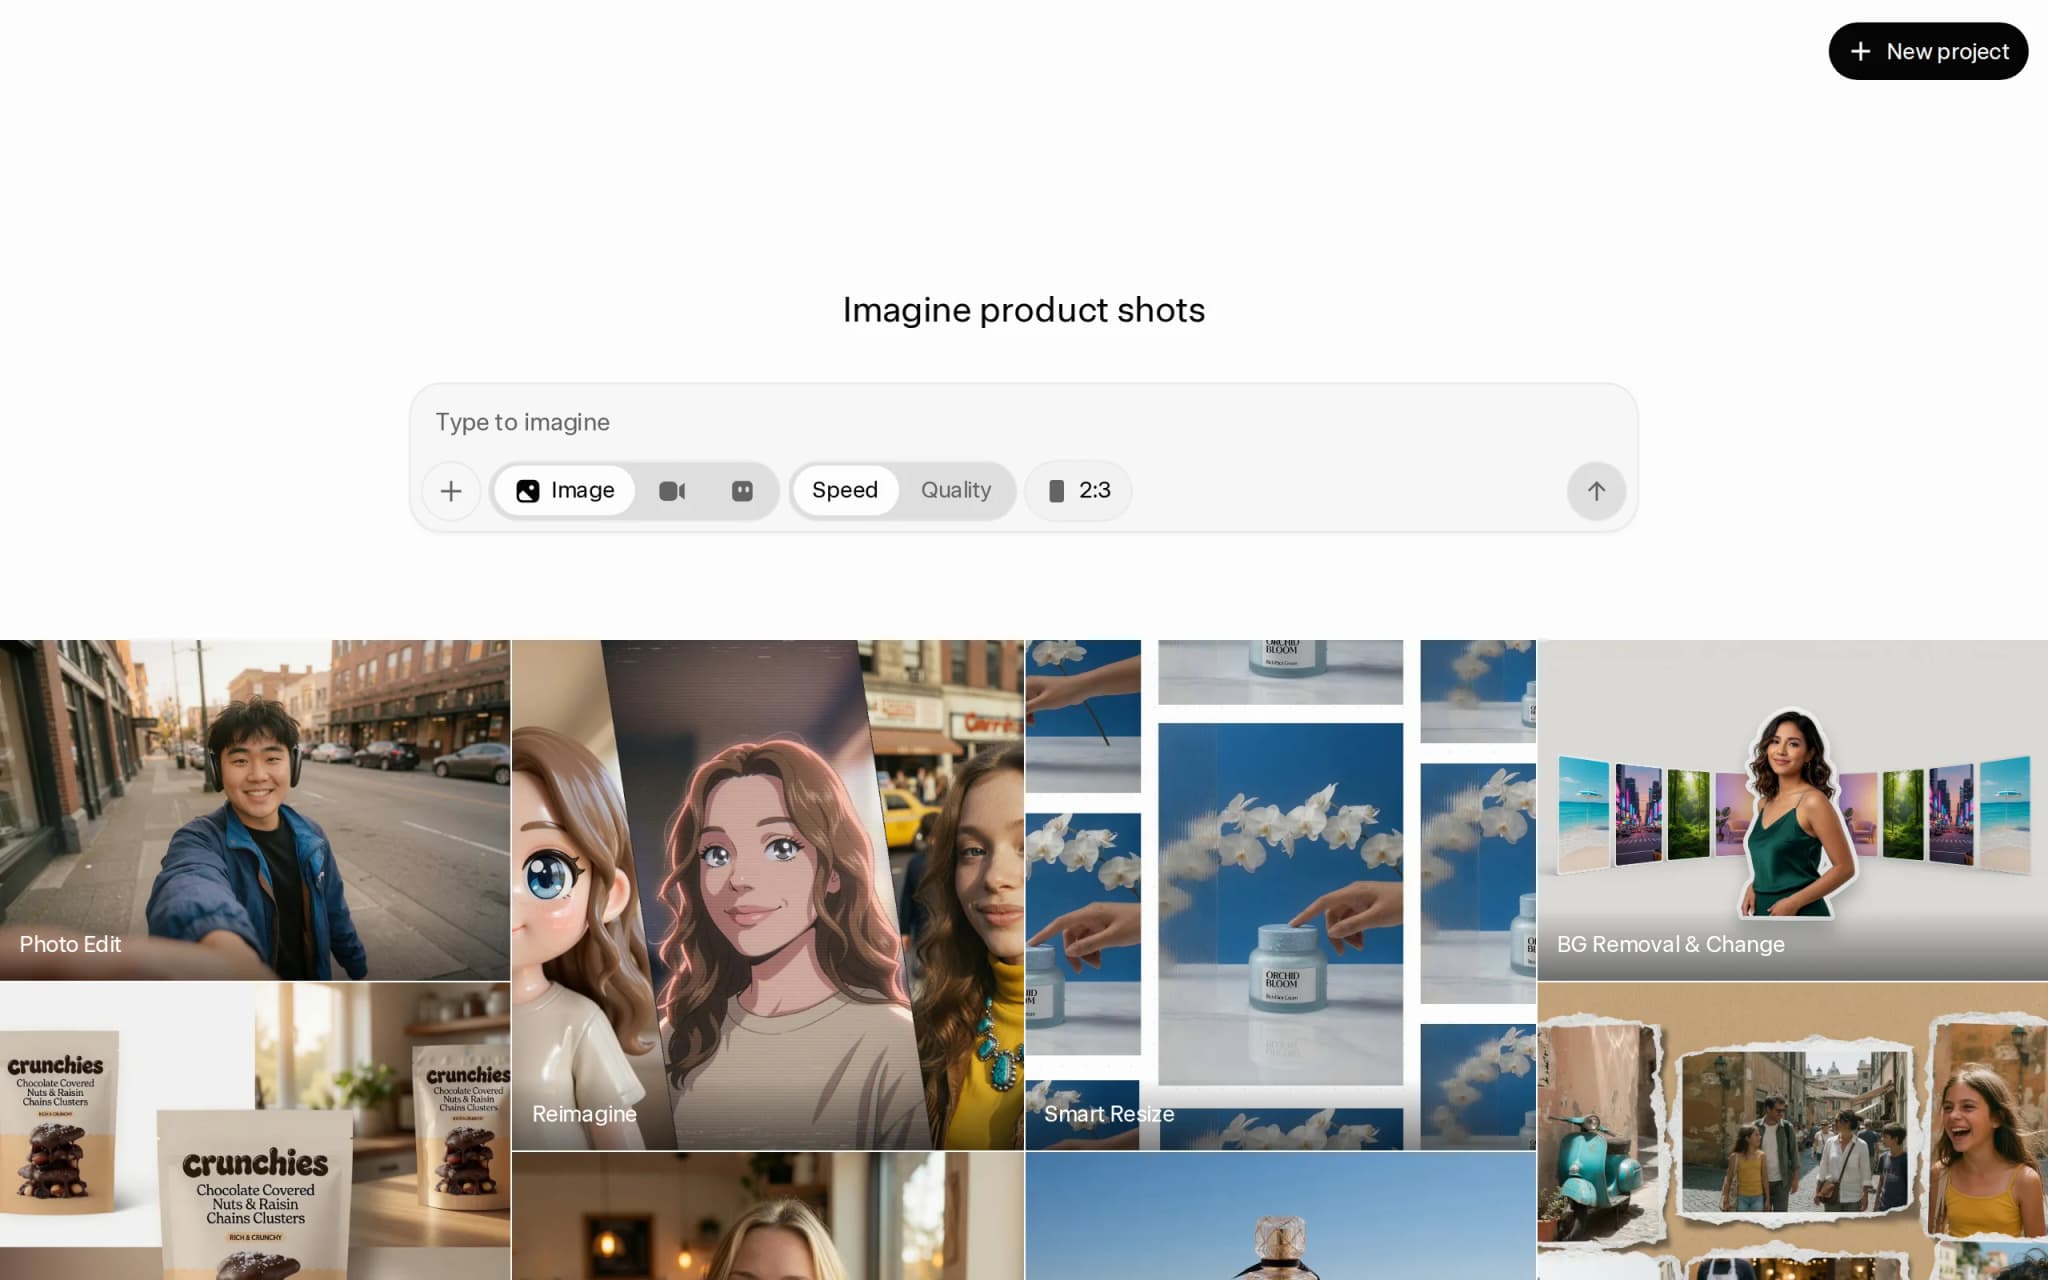
Grok Imagine Image 2.0 – SpaceXAI 推出的图像生成模型
Grok Imagine Image 2.0 是由 xAI(以 SpaceXAI 名义发布)推出的新一代图像生成与编辑模型,以“Quality Mode”形式集成在 Grok 网页端及 iOS、Android 应用中。该模型将编辑作为核心能力,提供魔棒局部修改、分割选区调色、一键背景移除、最多 5 张参考图融合以及 9 种画幅的智能扩图功能,同时具备设计师级的文字排版与多元素构图能力,能够在多轮编...
SenseNova U1.5-Lite-Preview – 商汤开源的轻量多模态模型
SenseNova U1.5-Lite-Preview 是商汤科技开源的轻量级原生统一多模态模型预览版,基于 NEO-Unify 架构迭代,仅 8B-MoT 参数即贯通视觉理解、推理、生成与编辑。模型原生支持 4K 图像生成,具备精细局部纹理、真实世界质感、中英文文字生成与复杂版式能力,优化对超长自然语言和结构化视觉指令的精准遵循,配套 Prompt Enhance Skill 降低复杂创作门槛。
Midjourney V8.2 – Midjourney推出的最AI图像生成模型
Midjourney V8.2是由Midjourney Inc.推出的最新AI图像生成模型版本,在提示词理解、风格参考逻辑和出图稳定性上实现全面升级。相比V8和V8.1,V8.2大幅提升了风格种子一致性、垫图融合自然度、复杂场景解析力及文字渲染精准度,尤其对东方古典意境表现更加细腻,一次出图成功率显著提高,成为当前AI图像生成领域综合能力突出的模型之一。
MAI-Image-2.5-Pro – 微软推出的高精度图像生成模型
MAI-Image-2.5-Pro是由微软AI团队推出的高精度图像生成模型,专注于高质量主视觉图、写实摄影及商业设计素材的生成。该模型在Arena文生图榜单中排名第三,尤其在写实摄影领域表现突出,同时支持图像内文字渲染与自然语言指令编辑。目前已深度集成至Bing Image Creator、PowerPoint和OneDrive等微软核心产品,相比GPT-Image-2可降低84%的GPU成本,兼...