AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
讯飞Spark-ASR-2.0深度评测:非自回归架构下的语音识别新范式
Spark-ASR-2.0是科大讯飞基于星火语音基座大模型Spark-Audio推出的最新一代语音识别大模型。该模型延续了Spark-ASR-1.0的非自回归并行解码范式,并创新性地引入LLM增强的自回归识别机制,通过"非自回归+LLM增强自回归"协同架构,在中英文混合、方言、专业术语、高噪声小音量等复杂场景下实现了识别效果的显著提升,同时推理成本相较上一代仅增加10%。模型已率先在讯飞输入法中上...
Qwen-Audio-3.1 – 阿里通义推出的语音大模型系列
Qwen-Audio-3.1是阿里通义千问推出的语音大模型系列,由ASR语音识别、ASR-Next音频理解、TTS语音合成、TTS-Next音频创作及Realtime实时交互五款模型构成,覆盖"理解—生成—交互—创作"完整语音链路。该系列支持30种语言和16种中文方言,具备分角色转写、情绪感知、音色迁移与全双工实时对话能力,并可调用外部工具完成任务,标志着语音AI从单一转写工具向全模态音频理解与生...
Qwen3.8-LiveTranslate评测:阿里通义推出的实时同声传译大模型
Qwen3.8-LiveTranslate是阿里通义千问团队推出的实时同声传译大模型,基于Interleave单流架构将音频与文本交织处理,字均延迟从2.8秒优化至2.3秒,支持60种语言识别与29种语言语音输出。模型采用Hybrid MoE的Thinker-Talker双模块设计,在翻译前完成说话人分离,并能够复刻原说话人音色生成译文语音,同时支持视频/图像输入辅助翻译消歧,实现原文与译文同帧同...
Spark-Audio-1.0-Preview – 科大讯飞推出的全国产语音基座大模型
Spark-Audio-1.0-Preview是科大讯飞推出的全国产语音基座大模型,采用0.65B音频编码器与30B-A3B MoE语言模型架构,基于1300万小时音频及大量文本数据在纯国产算力集群上训练完成。该模型能够直接解析语音中的语义、情绪与场景信息,支持99种语言和202种方言的识别,以及语音转写、翻译、说话人识别、情感分析、音频问答等多种任务,在高噪声、小音量等复杂场景中表现出领先优势,...
Gemini 3.8 Live – 谷歌推出的原生实时语音对话模型深度评测
Gemini 3.8 Live 是谷歌推出的原生实时语音对话模型系列,包含 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两个变体。该系列采用端到端语音对语音架构,摒弃了传统"语音识别→文本大模型→语音合成"的级联管道,直接在音频层面完成输入输出处理,显著降低交互延迟并保留语调、语速等声学细节。模型支持97种语言的自动检测与无缝切换,具备近...
Step Audio 3 – 阶跃星辰推出的语音大模型系列
Step Audio 3是阶跃星辰推出的新一代语音大模型系列,基于单一技术底座派生Realtime、ASR、TTS、Gen与Music五款专用模型,覆盖从实时语音交互、高精度转写、拟人化合成、多元素音频生成到完整音乐创作的全链路能力。其中,Realtime在Artificial Analysis榜单中以99.7%的语音推理准确率位列全球第一,ASR以1.7%的词错误率同样登顶全球榜首。该系列的核心...
HiDream-O1-Video-1.0 – 智象未来推出的全模态视频生成模型
HiDream-O1-Video-1.0(简称HD-V1)是智象未来(HiDream.ai)推出的原生全模态视频生成模型,支持文本、图片、视频等多模态输入,可一键直出5至20秒1080p高清视频。该模型在物理规律导向生成与音画原生一体化方面实现了架构级突破,在Artificial Analysis图生视频榜(With Audio)位列全球第四、Arena.ai盲测榜第八,标志着中国AI视频生成技术...
Xiaomi-CocktailASR-1:基于LLM端到端架构的目标说话人语音识别模型深度评测
Xiaomi-CocktailASR-1是小米开源的目标说话人语音识别(Target Speaker ASR,TS-ASR)大模型,基于LLM端到端架构设计,以参考语音作为声纹提示,无需语音分离即可从多人混合语音中精准转录目标说话人的内容。模型在多说话人基准上达到SOTA水平,同时兼容单说话人场景,具备负样本拒识与思维链可解释推理能力,采用Apache 2.0协议开源。
EchoWM – 京东开源的交互式视听世界模型
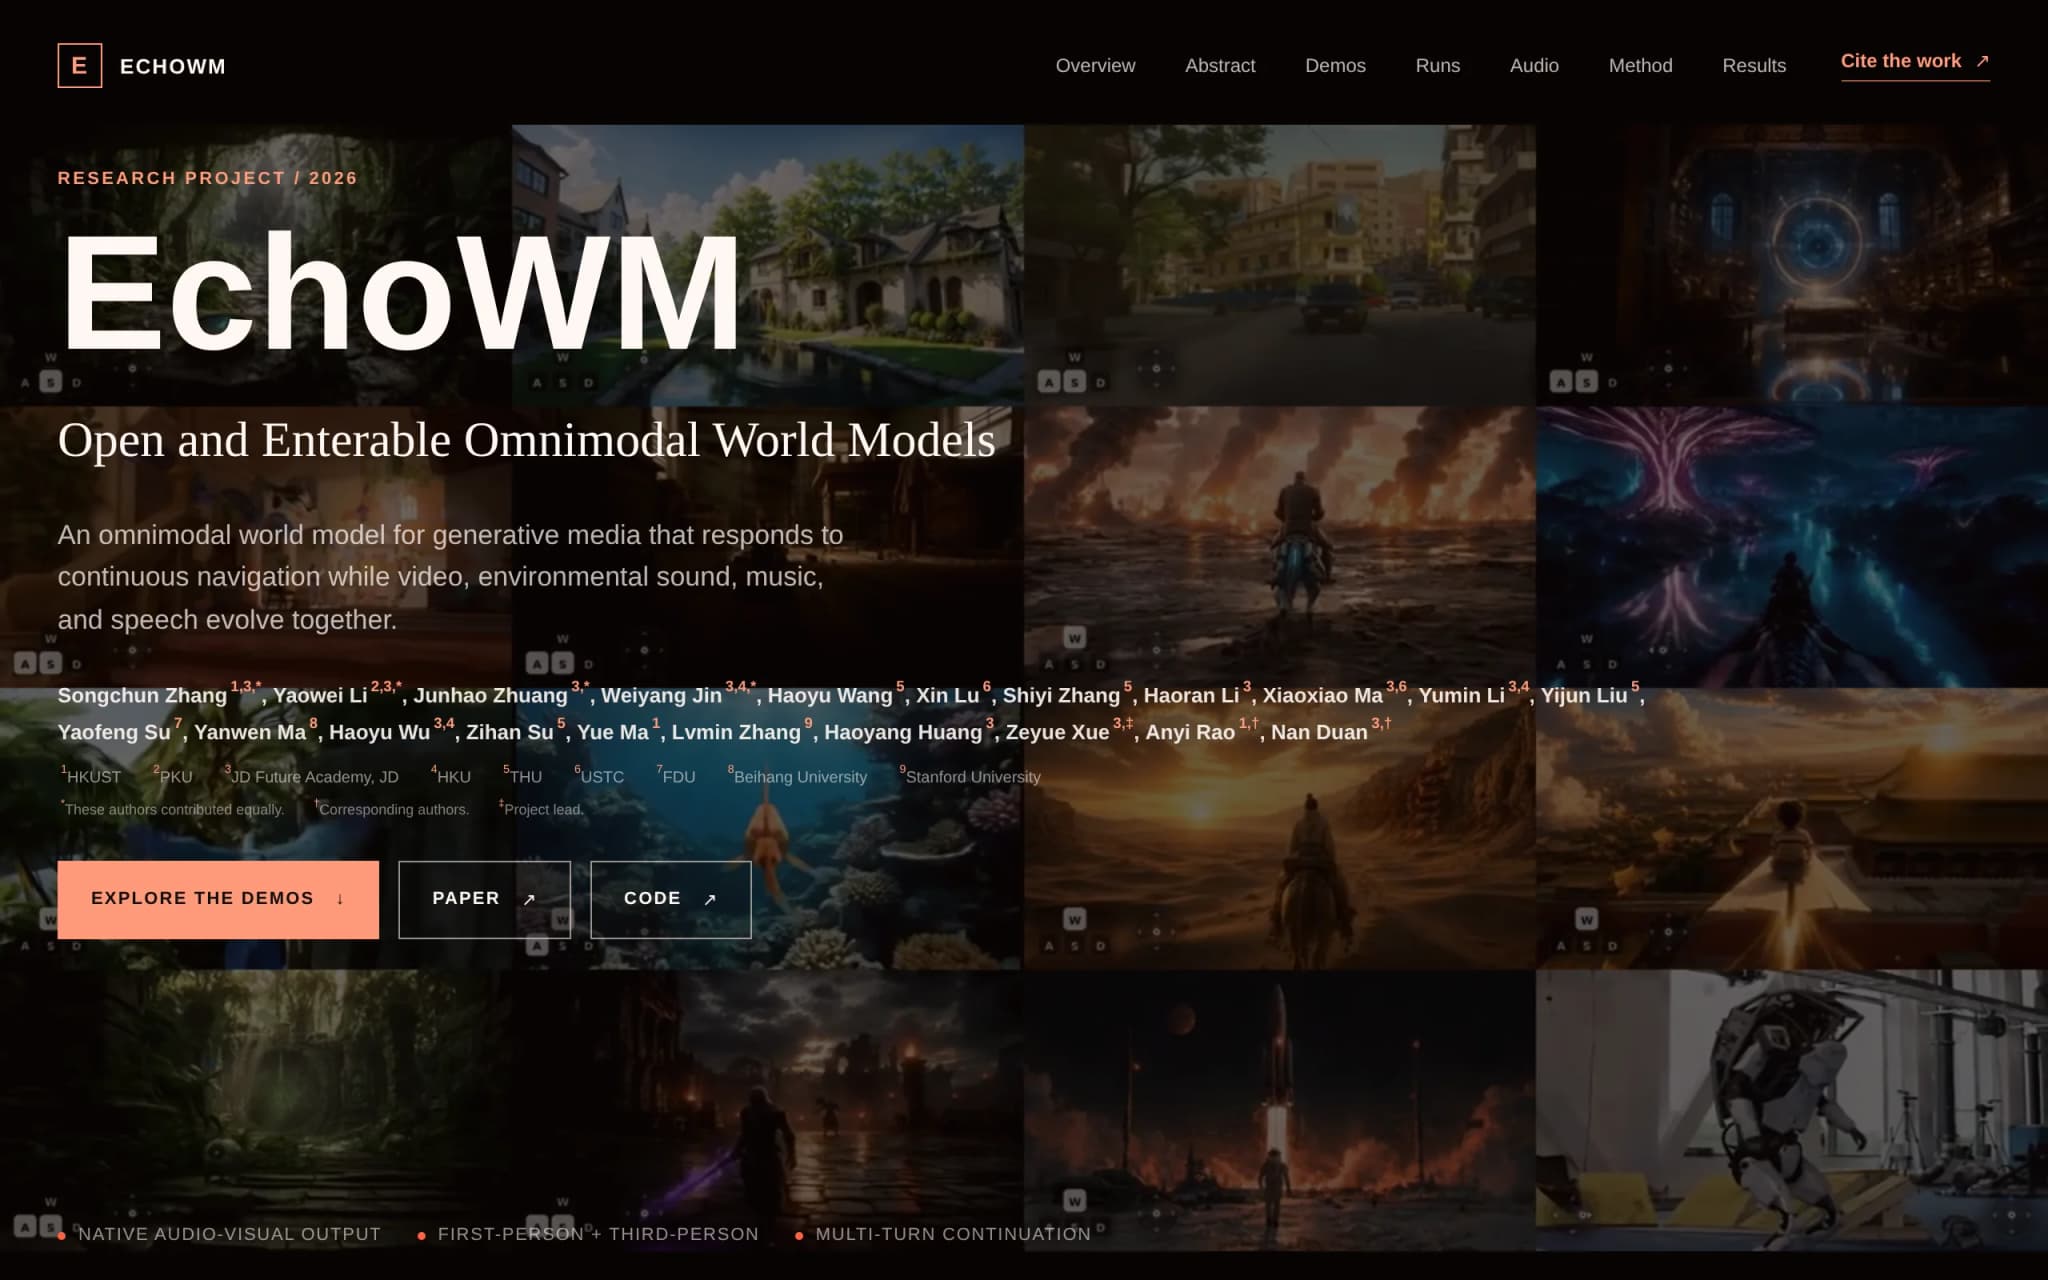
EchoWM是京东探索研究院开源的交互式视听世界模型,延续JoyAI-Echo的原生音视频生成能力,让用户以第一/第三人称视角在AI生成的世界中实时移动探索,画面、空间关系与环境音、语音持续同步且长时间不跑偏。模型采用统一相机意图接口与世界数据引擎训练,WBench导航评测平均分81.7位列第一。
AuK – 腾讯混元开源的语音生成与编辑基础模型
AuK是腾讯混元团队开源的一款15亿参数语音生成与编辑基础模型,采用流匹配扩散架构而非传统自回归方案。该模型通过统一的自然语言指令接口即可完成16种语音任务,覆盖零样本/指令式TTS、语音内容编辑、声学调节、副语言编辑、降噪及人声分离等多元场景。AuK的核心设计理念在于将语音编辑任务视为以原始音频隐表示为起点的去噪过程,从而在精准修改指定内容的同时,最大化保留原始音色、旋律和未编辑部分的完整性,并...