AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:视频AI
共 117 篇文章 · 清除标签
Qwen3.8-Omni-Flash – 阿里千问推出的原生全模态模型
Qwen3.8-Omni-Flash是阿里千问推出的原生全模态模型,在单一架构内联合建模文本、图像、音频与视频四种模态,支持1M token超长上下文,使数小时音视频内容得以原生输入而无需分段处理。该模型以“从理解到交付”为核心设计理念,不仅具备跨模态理解能力,更可通过内置Agent能力自主完成视频剪辑、MV创作、短剧翻译、电影解说、会议纪要执行等端到端工作流。相比上代模型平均能力提升超过25%,...
Hypit – 开源的 AI 视频生成工具,自动复刻爆款视频
Hypit 是一款开源的 AI 视频生成工具,以“给 Agent 一条爆款视频,自动复刻完整工作流”为核心方法论,将爆款视频拆解为结构化的 .svml 文件,实现改一句文本、音画字幕自动同步调整的文本驱动编辑能力。工具支持全片克隆、换主播、换内容、换语言,单条命令可批量产出上百个视频变体,并可在 Claude Code、Codex、豆包等编码 Agent 中直接调用,为短视频创作者提供了从克隆、编...
Vidu S2 – 生数科技推出的实时交互与编辑视频模型
Vidu S2是生数科技推出的实时视频生成与编辑模型,发布即开放体验。该模型包含两大核心组件:S2-Editing支持对正在播放的视频流实时修改风格、进行虚拟换装、更换角色与背景,依赖帧对齐稀疏注意力技术确保高速运动场景下画面不穿帮;S2-Avatar以720P、25-42FPS的规格实现数字人实时互动,支持随时插入参考图与换装操作,并具备全身动作跟随能力。模型引入独创的SRF训练技术以解决长时生...
LingBot-World 2.0 – 蚂蚁灵波科技开源的实时交互世界模型
LingBot-World 2.0是由蚂蚁集团灵波科技(Robbyant)开源的实时交互世界模型,其核心突破在于将视频生成从"单向观看"推进到"实时游玩"的交互范式。该模型支持移动、攻击、施法、跳跃等多样化角色操作,并能响应文本驱动的雨雪等环境事件,可在高配置硬件下实现720P/60FPS的实时画面输出与亚秒级交互延迟。同时,模型具备小时级连续生成不漂移的长期一致性能力,已开源14B及1.3B S...
Kimi K2.8 Preview 评测:月之暗面新一代主力模型深度解析
EchoWM – 京东开源的交互式视听世界模型
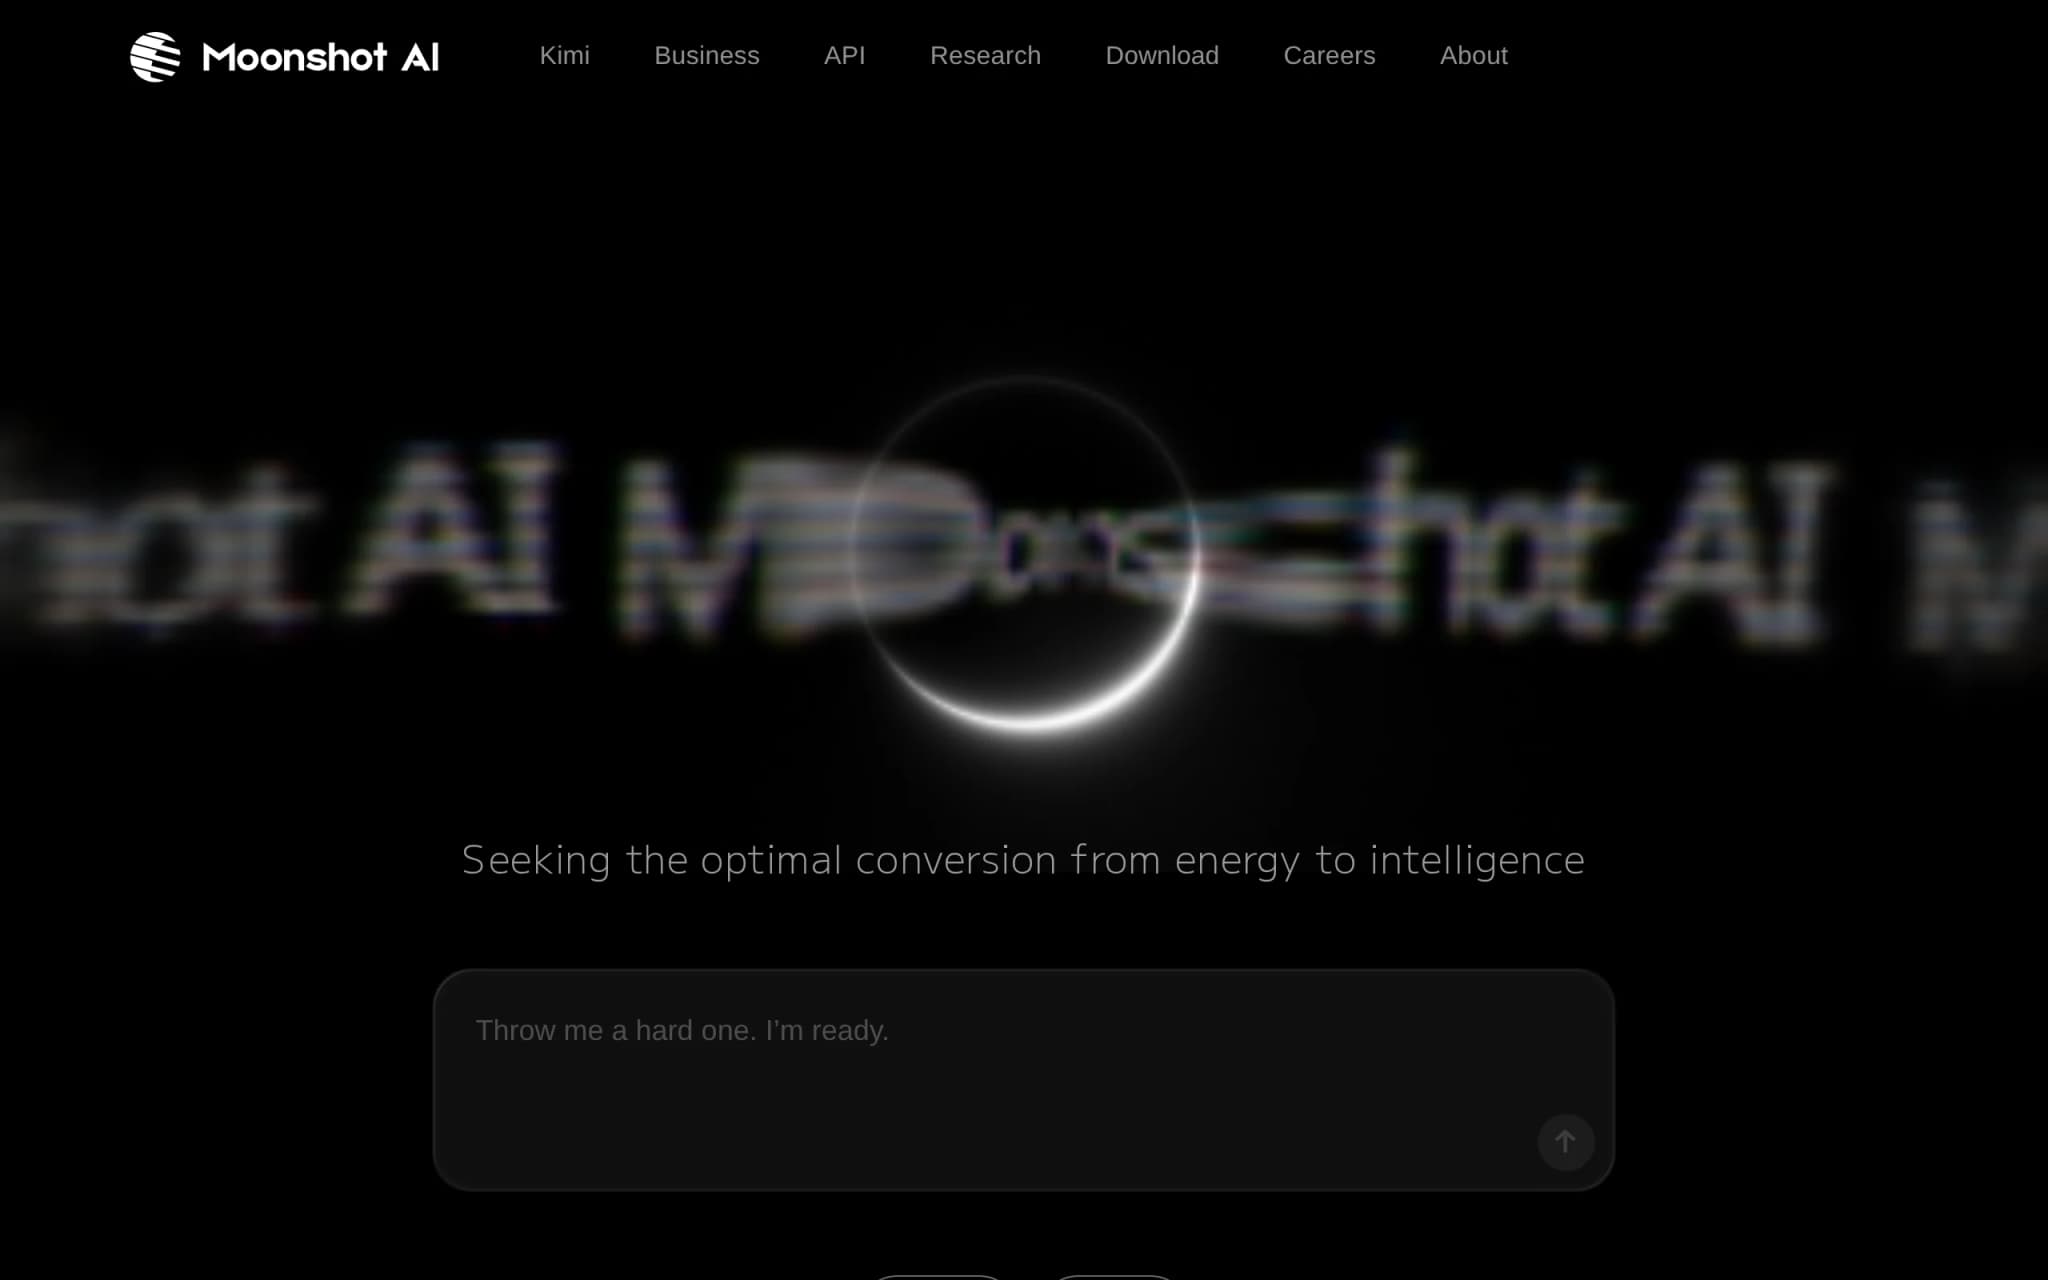
EchoWM是京东探索研究院开源的交互式视听世界模型,延续JoyAI-Echo的原生音视频生成能力,让用户以第一/第三人称视角在AI生成的世界中实时移动探索,画面、空间关系与环境音、语音持续同步且长时间不跑偏。模型采用统一相机意图接口与世界数据引擎训练,WBench导航评测平均分81.7位列第一。
VDN-MiniMax-H3 — OpenVDN 开源的高效视频生成加速方案
VDN-MiniMax-H3是OpenVDN团队开源的视频生成加速方案,基于MiniMax-H3模型进行架构改造与深度优化。该方案通过混合注意力架构将视频注意力拆分为局部滑动窗口Softmax分支与远距离线性注意力分支,并采用DMD2蒸馏技术将去噪步数从50步压缩至8步。在8张NVIDIA B200 GPU上,模型仅需11.23秒即可生成约14.4秒768p分辨率视频,画质与原始50步Dense ...
ffmpeg-skill:让编程 Agent 获得专业本地视频剪辑能力的开源工具包
ffmpeg-skill 是面向编程 Agent(如 Claude Code、Cursor、Codex)的开源 Agent Skill,其核心价值在于让 AI 能够像专业剪辑师一样调用本地 FFmpeg 完成视频处理任务。该工具内置 28 个结构化工具,覆盖视频探测、剪切、拼接、字幕、调色、响度标准化、多机位切换、批量导出等完整处理链路,并遵循"探测→编辑→检查→验证"的固定工作流。ffmpeg-...
Ling-3.0-flash-VL – 蚂蚁开源的原生多模态大模型
Ling-3.0-flash-VL 是蚂蚁集团 InclusionAI 百灵系列首个开源的原生多模态大模型,基于 Ling-3.0-flash 的 MoE 架构拓展而来,总参数量达 124B,但单次推理仅激活 5.5B 参数,原生支持图文与视频输入,上下文窗口扩展至 256K Token。该模型并非简单的文本模型加视觉模块,而是从架构层面将视觉、文本与视频在同一训练过程中联合优化,使模型具备边观察...
H3-World – 腾讯联合高校等开源的动作可控世界模型
H3-World是腾讯联合新加坡国立大学、香港理工大学推出的动作可控世界模型,基于33B参数的MiniMax-H3视频生成器进行轻量微调。该模型创新性地将键盘操作翻译为英文指令,通过复用预训练文本通路注入模型,并借助时间注意力路由将每条指令精确绑定到对应视频帧,实现动作与画面演进的时间对齐控制。仅使用8000条游戏视频和rank-32 LoRA微调0.199%的参数,H3-World即可让模型按实...