AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
PixRestore – 香港理工联合OPPO推出的统一图像修复模型深度评测
PixRestore 是由香港理工大学与 OPPO 研究院联合推出的统一图像修复模型,其核心创新在于直接在像素空间执行 Flow Matching,彻底摒弃了传统方案中 VAE 编码器带来的高频细节损失问题。该模型采用 DINO 驱动的自适应层特征路由机制,仅凭 53.7M 参数的轻量级架构即可高效处理超分辨率、去噪、去模糊、去雨、去雾、去雪、雨滴去除与低光照增强等 8 种退化任务,单步推理仅需 ...
AuK – 腾讯混元开源的语音生成与编辑基础模型
AuK是腾讯混元团队开源的一款15亿参数语音生成与编辑基础模型,采用流匹配扩散架构而非传统自回归方案。该模型通过统一的自然语言指令接口即可完成16种语音任务,覆盖零样本/指令式TTS、语音内容编辑、声学调节、副语言编辑、降噪及人声分离等多元场景。AuK的核心设计理念在于将语音编辑任务视为以原始音频隐表示为起点的去噪过程,从而在精准修改指定内容的同时,最大化保留原始音色、旋律和未编辑部分的完整性,并...
Ling-3.0-flash-VL – 蚂蚁开源的原生多模态大模型
Ling-3.0-flash-VL 是蚂蚁集团 InclusionAI 百灵系列首个开源的原生多模态大模型,基于 Ling-3.0-flash 的 MoE 架构拓展而来,总参数量达 124B,但单次推理仅激活 5.5B 参数,原生支持图文与视频输入,上下文窗口扩展至 256K Token。该模型并非简单的文本模型加视觉模块,而是从架构层面将视觉、文本与视频在同一训练过程中联合优化,使模型具备边观察...
ChatGPT Images 2.5 – OpenAI 推出的新一代图像生成模型
ChatGPT Images 2.5 是 OpenAI 于 2026 年 9 月推出的新一代图像生成模型,面向 ChatGPT、ChatGPT Work 及 Codex 全档位用户开放。相比上一代 GPT-Image-2,该模型在生成延迟上最高降低 50%,同时显著提升了精准局部编辑能力、多轮修改一致性以及参考照片的人物保真度。新增的 Sketch 手绘参考、创作模板、图片评论编辑与提示词分享功能...
DeepSeek V4.1 Flash – DeepSeek推出的中间内测版本模型
DeepSeek V4.1 Flash是深度求索(DeepSeek)推出的中间内测版本模型,采用全新模型架构,首次将多模态能力原生集成到基座模型之中。该模型定位为能力更强、速度更快、成本更低的轻量级高性能方案,社区实测输出速度普遍达到300~400 tokens/s,峰值可达507 tokens/s。模型调用方式极为便捷,base_url保持不变,仅需将模型名设置为deepseek-v4.1-fl...
LLaDA-Image – 蚂蚁集团开源的统一图像生成与编辑模型
LLaDA-Image 是蚂蚁集团 inclusionAI 实验室开源的 6B 参数统一图像生成与编辑模型。该模型采用先纯图预训练、后语言对齐的创新训练路线,通过全扩散架构(LLaDA2.0-mini 理解模块 + 6B DiT 生成模块)实现文生图、指令编辑和中英文字渲染三大核心能力。在 Qwen-Image-Bench 基准测试中,LLaDA-Image 中英文双赛道均取得开源模型第一的成绩,...
MiniMax H3 Max – MiniMax 推出的实时视频生成模型
MiniMax H3 Max是由MiniMax基于开源H3模型进行后训练与推理优化推出的实时视频生成模型。该模型支持文生视频与图生视频两种输入方式,在生成画面的同时同步输出匹配音频,5秒768p视频生成耗时不到3秒,吞吐量达到原生H3的约35倍,在Artificial Analysis和Design Arena图生视频排行榜中均位列第一。目前模型已接入MiniMax开放平台与MiniMax Des...
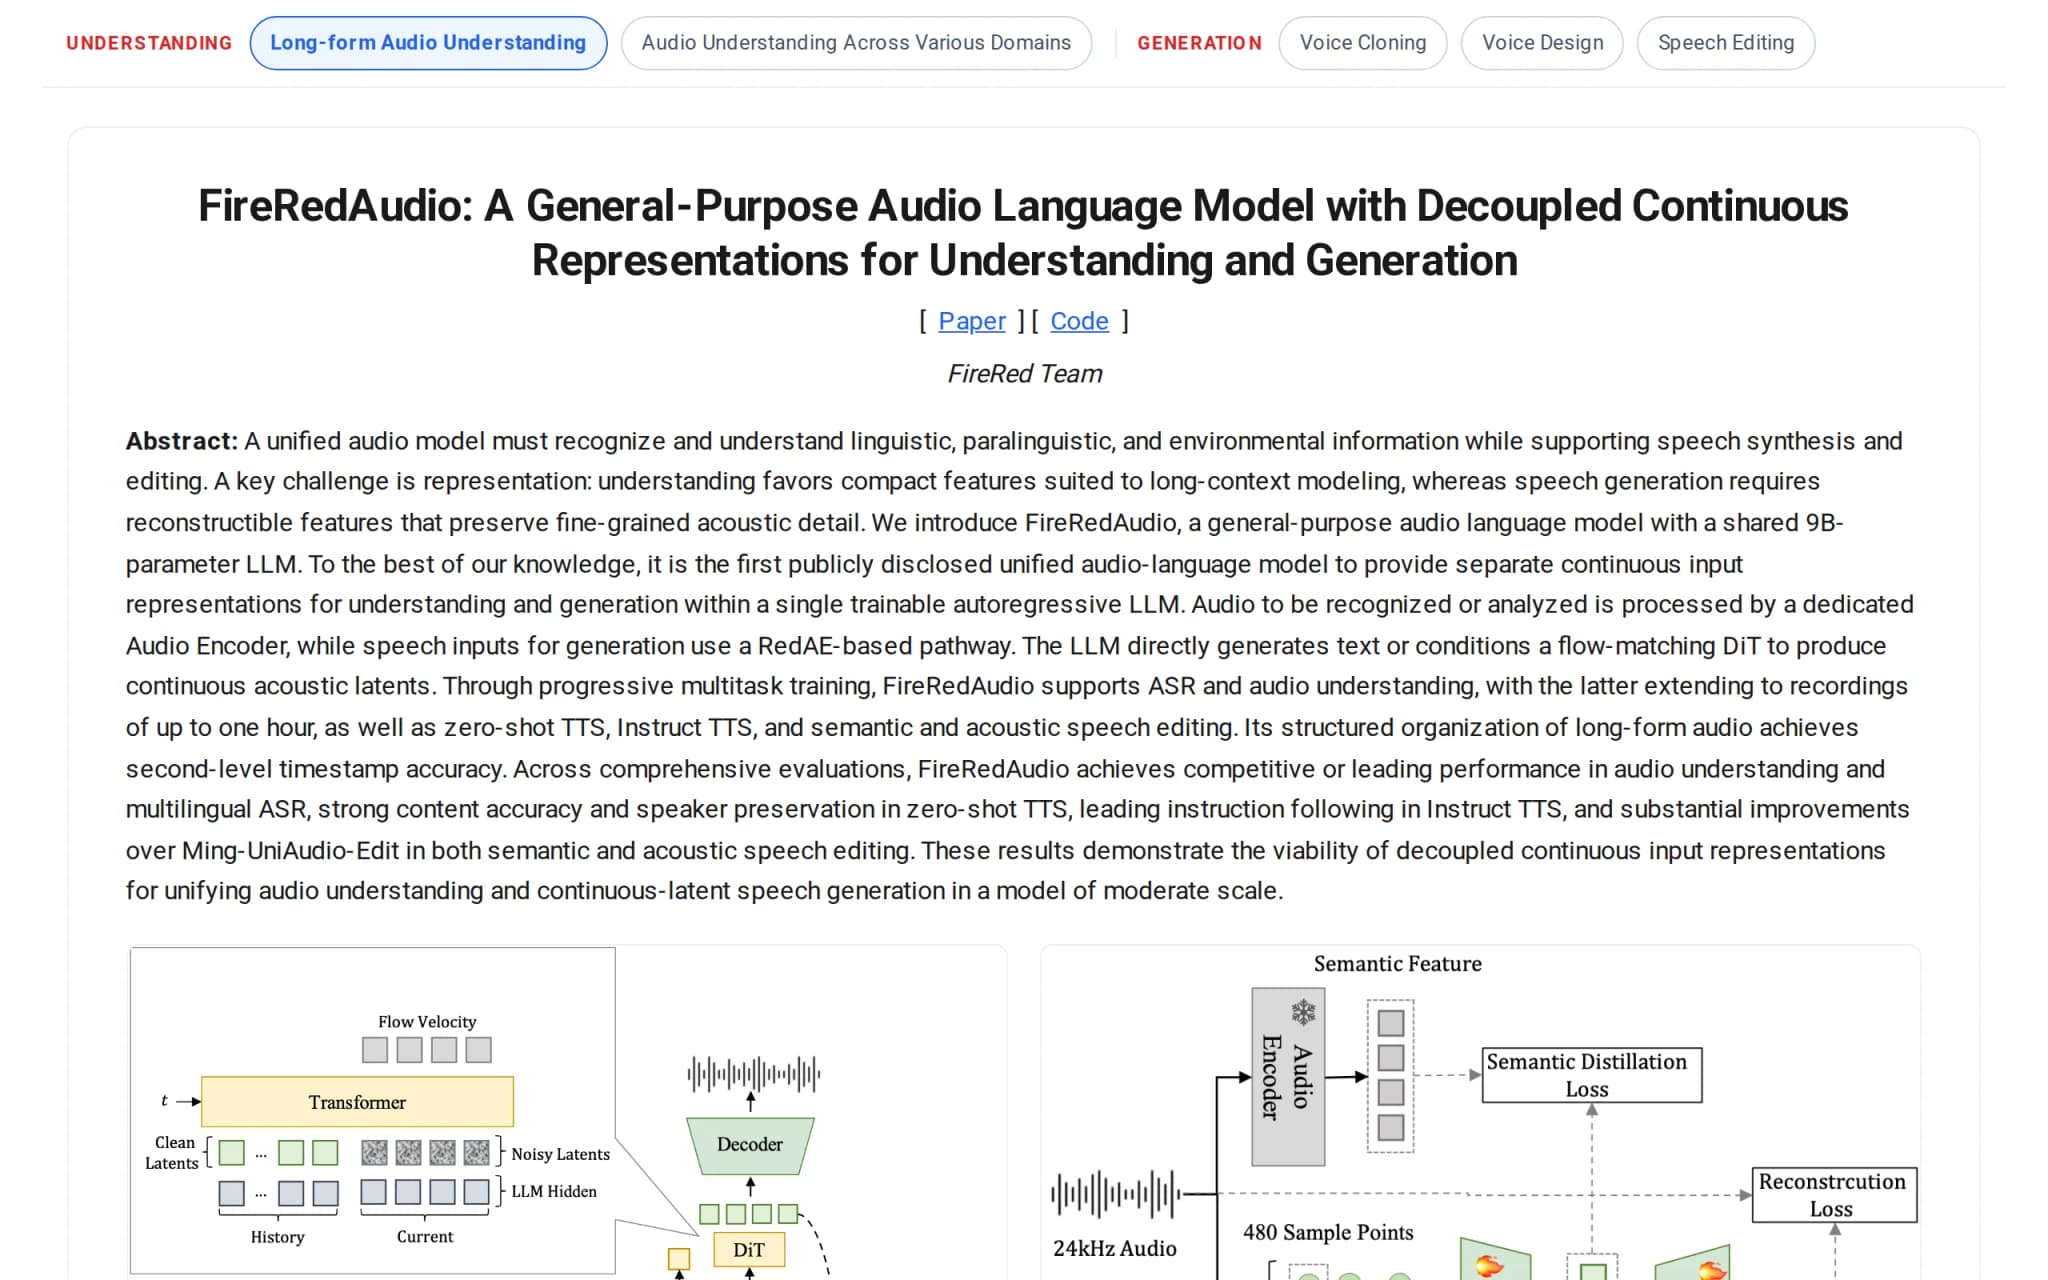
FireRedAudio – 小红书FireRed推出的通用音频语言模型深度评测
FireRedAudio是小红书FireRed团队于2026年8月开源的通用音频语言模型,基于9B参数Qwen3.5自回归大语言模型构建。该模型采用理解与生成解耦的连续表征架构,通过独立的Audio Encoder与RedAE通道分别提取语义特征与声学特征,再汇入共享LLM统一推理,同时支持语音识别、音频问答、1小时录音理解、Zero-shot TTS、指令TTS及语音编辑等六大任务,在MMAU、...
Atlas – World Labs 推出的全球首个多模态世界模型
Atlas是由李飞飞创办的World Labs推出的全球首个多模态世界模型。该模型原生理解文本、图像、视频与3D空间信息,通过空间上下文(Spatial Context)机制将画面锚定在三维坐标中,实现像素级精确的相机控制生成、稀疏照片3D重建及时空模拟。用户仅需提供几张普通照片,即可生成可任意运镜的长视频、重建真实场景,并为机器人搭建仿真训练环境。
Muse Voice Transcribe – Meta 推出的首个实时音频感知模型
Muse Voice Transcribe 是 Meta 推出的首个实时音频感知模型,集流式自动语音识别(ASR)、说话人分割与语音端点检测于一体。模型支持 70 多种语言及原生语码切换,可处理超过 1 小时的长音频与 20 人以上的同时对话场景,在流式转写和语音分割基准测试中均排名第一。基于强化学习的自适应延迟技术,使其能够动态权衡响应速度与识别准确率。目前 Muse Voice Transcr...