AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
dots3-note preview – 小红书开源的多模态MoE模型深度评测
dots3-note preview是由小红书dots模型实验室开源的多模态MoE模型,作为dots3系列的首个版本,与IMO 2026满分模型共享同源技术。模型采用280B总参数/16B激活参数的MoE架构,支持512K超长上下文与文本、视觉、语音多模态理解,针对复杂推理、智能体任务与多模态感知进行专项优化,专攻旅行规划、婚礼筹备等长程开放任务,在多项推理与智能体基准测试中可比肩数倍参数的大模型...
dots.tts – 小红书联合上海交大开源的语音合成基座模型
dots.tts 是小红书 dots 团队与上海交大 X-LANCE 实验室联合开源的 20 亿参数全连续自回归语音合成基座模型。模型直接在连续隐空间中逐块生成 48kHz 音频,在 Seed-TTS-Eval 等基准上取得领先的音色相似度与内容准确度,支持零样本克隆、流式输出及低延迟双工对话。项目全量开源代码与权重,并扩展了 dots.tts.edit 精确语音编辑能力。
IndexTTS-2.5:Bilibili 开源的工业级零样本语音克隆模型深度评测
IndexTTS-2.5 是由 Bilibili Index Speech 团队开源的工业级零样本语音克隆模型,参数量仅 0.8B。该模型支持中文、英语、日语、西班牙语和阿拉伯语五种语言的跨语种迁移,能够在保留源说话人音色的前提下,用不同语言进行语音合成。通过重构推理架构,模型实现了 2.28 倍的推理速度提升,并融入了精细化的情感控制、语速调节与发音干预机制,为内容创作、本地化配音等场景提供了高...
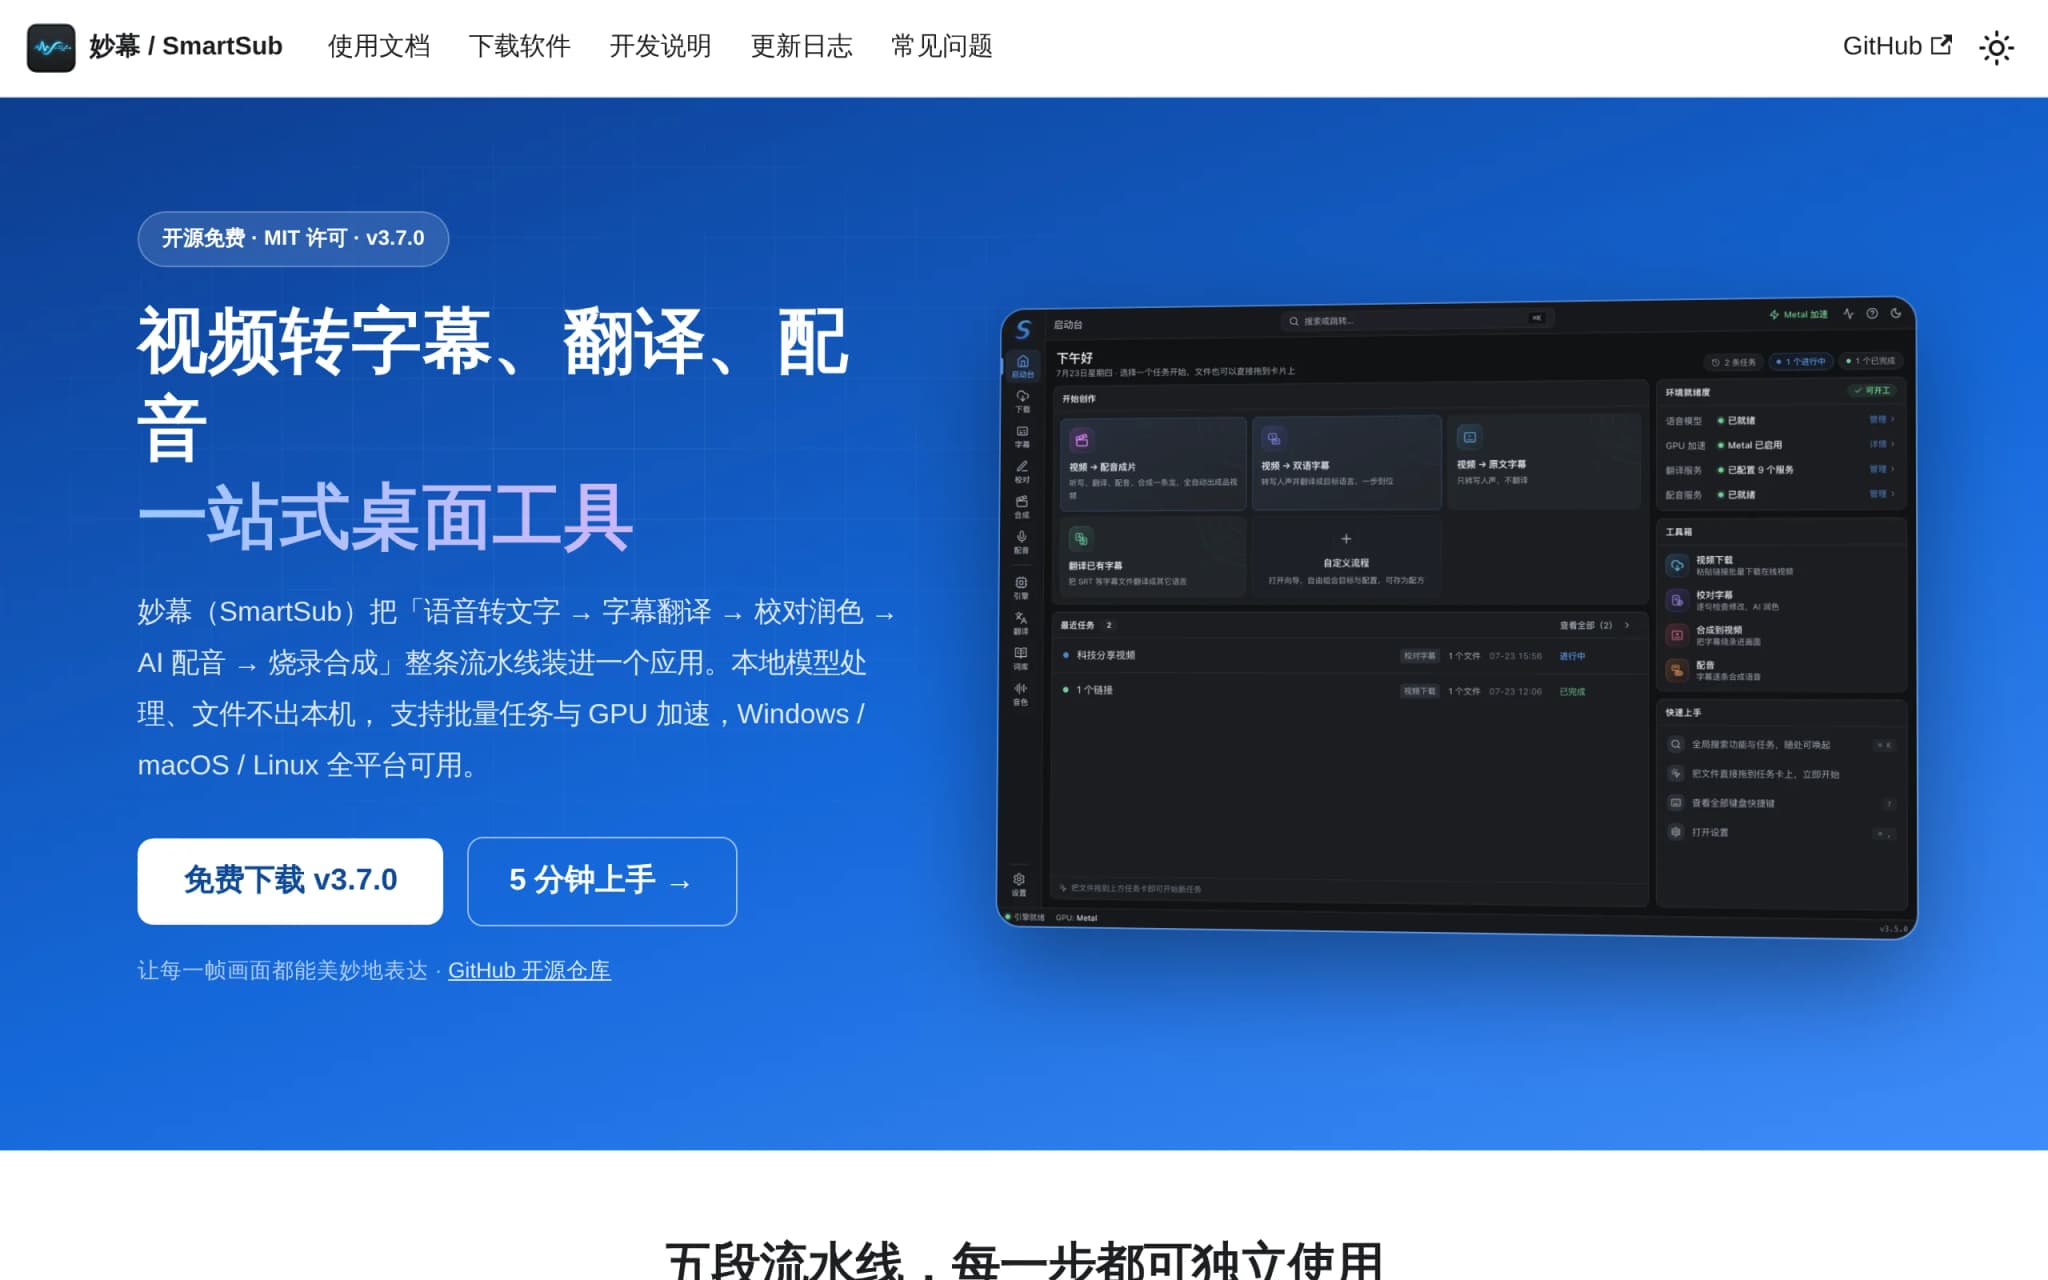
SmartSub – 开源的一站式音视频字幕处理桌面工具
SmartSub(妙幕)是由开发者Buxuku打造的开源一站式音视频字幕处理桌面工具。该工具整合了语音转写、字幕翻译、AI校对、TTS配音、字幕烧录及在线视频下载等全流程功能,基于Whisper、FunASR、Qwen3-ASR等本地模型实现离线语音识别,支持20余种翻译服务与多角色AI配音,并兼容NVIDIA CUDA、Apple Core ML等硬件加速。SmartSub旨在为用户提供从视频下...
SALMONN-2 – 清华等开源的通用音频大语言模型
SALMONN-2是由清华大学、上海人工智能实验室与剑桥大学联合开源的通用音频大语言模型。该模型采用字节跳动SPEAR统一自监督音频编码器与多层特征融合适配器,以Qwen3-8B为文本基座,仅使用约1.8万小时监督数据便在MMAU-Pro、MMAR、MMSU三大综合基准上取得同规模开源模型领先表现。SALMONN-2首次在通用音频大语言模型中系统实现了声音事件检测、音频伪造检测、语音质量评估与多模...
SeedRealtime – 字节跳动推出的原生音视频全双工大模型
SeedRealtime是字节跳动Seed团队推出的原生音视频全双工大模型,基于统一架构原生融合音频、视频与文本,实现边看、边听、边说的全模态实时交互。该模型具备音视频联合理解、主动交互与流畅对话节奏三大核心突破,端到端评测显示对话节奏问题较级联模型减少一半。目前已全量上线豆包App,成为业界首个规模化落地的音视频全双工AI产品。
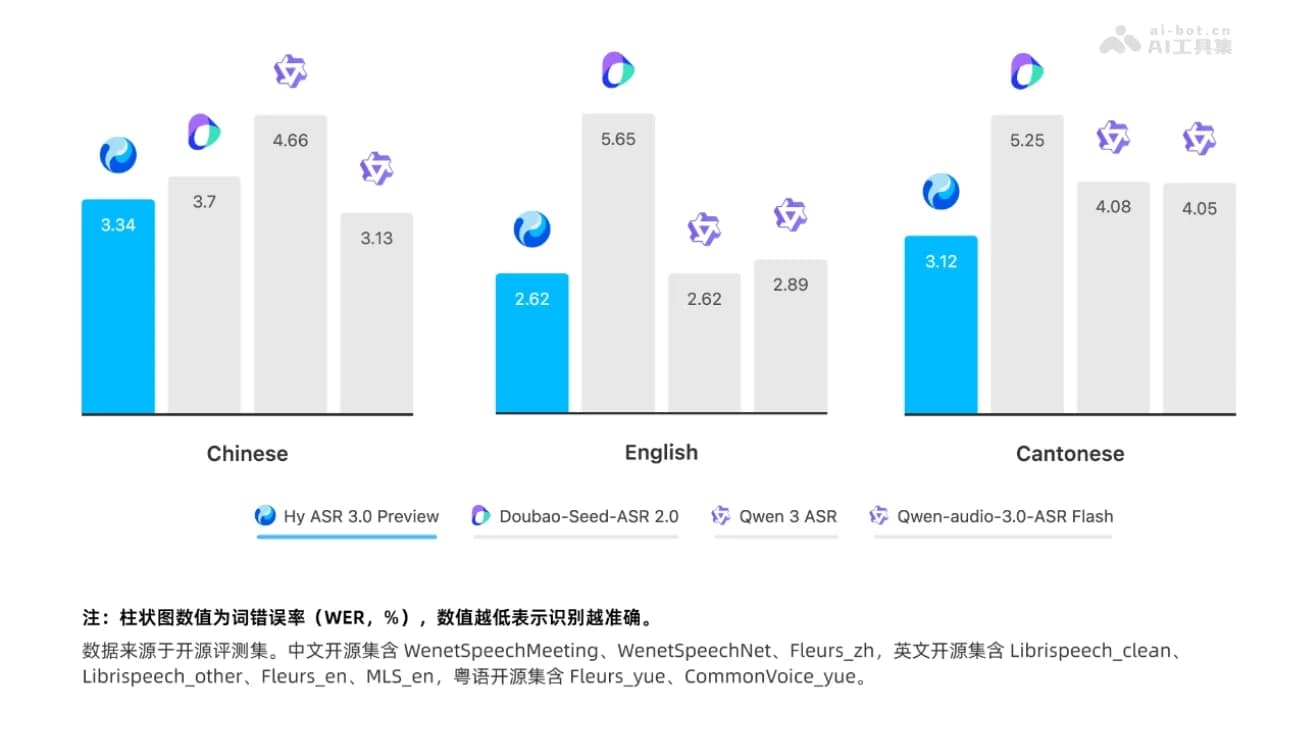
Hy ASR 3.0 preview – 腾讯混元推出的一代语音识别模型
Hy ASR 3.0 preview是腾讯混元推出的新一代语音识别模型,基于Hy3大语言模型,采用混合专家(MoE)架构,将高精度语音识别与深度语义理解融为一体。该模型支持中文普通话、英语、粤语及覆盖10大方言片区的方言识别,具备上下文智能纠错、热词注入以及在嘈杂环境下的稳定转写能力。在开源评测集上,其词错误率(WER)控制在3%左右,在自建的多维度评测集中全面领先于行业竞品。
Qwen-Audio-Agent – 阿里开源的实时语音 Agent 框架
Qwen-Audio-Agent是阿里语音AI团队推出的开源实时语音Agent框架,基于Qwen-Audio-3.0-Realtime模型构建。该框架作为统一的实时语音入口层,允许用户通过自然语音与OpenCode、OpenClaw、Codex等后台Agent进行全双工对话,支持边听边说、随时打断,并将复杂任务委派给后台执行后带回结果,从而在编码协作、项目管理等场景中实现接近真人对话的人机交互体验...
Lyria 3.5 – 谷歌 DeepMind 推出的 AI 音乐生成模型
Lyria 3.5 是 Google DeepMind 于 2026 年 7 月发布的新一代 AI 音乐生成模型,直接集成于 Google Flow Music 平台。该模型在旋律结构复杂度、歌词生成质量、人声表现力以及创作控制能力上实现四项关键升级,使 AI 音乐生成从实验性工具迈向可用的创作辅助。通过参数化调节节奏与时长,并基于授权音乐数据训练,Lyria 3.5 在音乐性与合规性之间取得平衡...
Grok Voice Think Fast 2.0 – SpaceXAI 推出的语音模型
Grok Voice Think Fast 2.0 是由 SpaceXAI(xAI)推出的新一代端到端语音到语音模型,采用原生统一架构,摒弃传统语音识别—语义推理—语音合成的级联流程,直接理解用户语音并生成回应。其核心创新在于“边听边推理”的流式处理机制,首次音频响应仅 0.70 秒,在 Artificial Analysis 语音到语音综合评测中以 82.9% 的质量指数领先 GPT‑Realt...