AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:视频AI
共 117 篇文章 · 清除标签
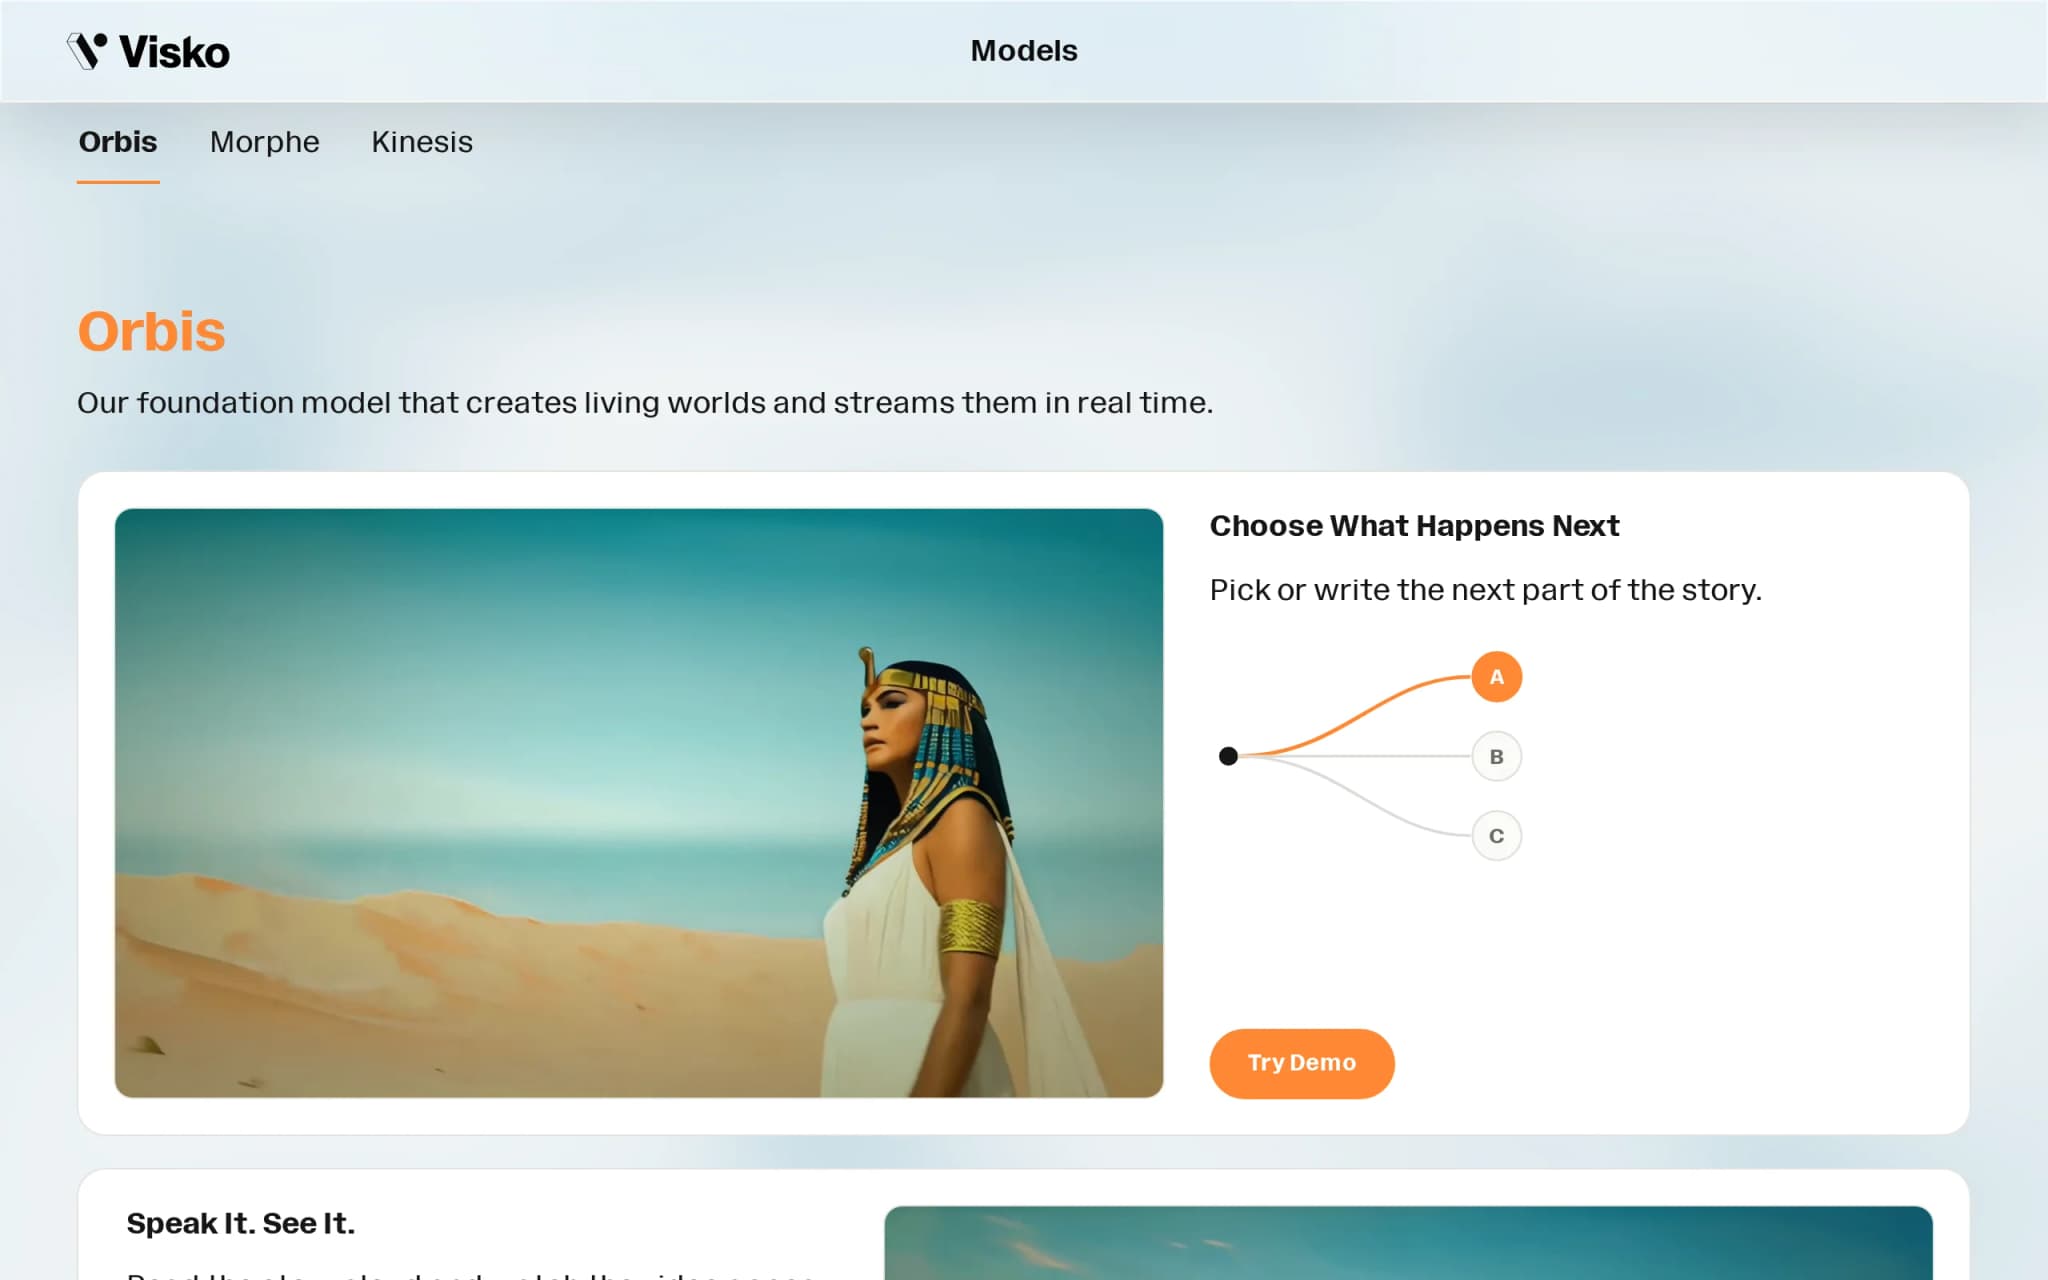
Orbis – Visko推出的实时世界模型,让AI视频像直播一样
Orbis是Visko推出的首个Live Model(实时世界模型),从根本上改变了AI视频的生成方式——不再需要等待数分钟甚至数十分钟的离线渲染,而是将视频生成转化为一种类似直播的持续流式输出。用户可以在生成过程中随时输入新的指令,画面会实时响应并改变走向,实现了真正意义上的"生成中交互"。该模型支持4K@24FPS的实时流式生成,通过多尺度记忆机制维持小时级的长时一致性,并基于因果时间分解与物...
MiniMax H3 Max – MiniMax 推出的实时视频生成模型
MiniMax H3 Max是由MiniMax基于开源H3模型进行后训练与推理优化推出的实时视频生成模型。该模型支持文生视频与图生视频两种输入方式,在生成画面的同时同步输出匹配音频,5秒768p视频生成耗时不到3秒,吞吐量达到原生H3的约35倍,在Artificial Analysis和Design Arena图生视频排行榜中均位列第一。目前模型已接入MiniMax开放平台与MiniMax Des...
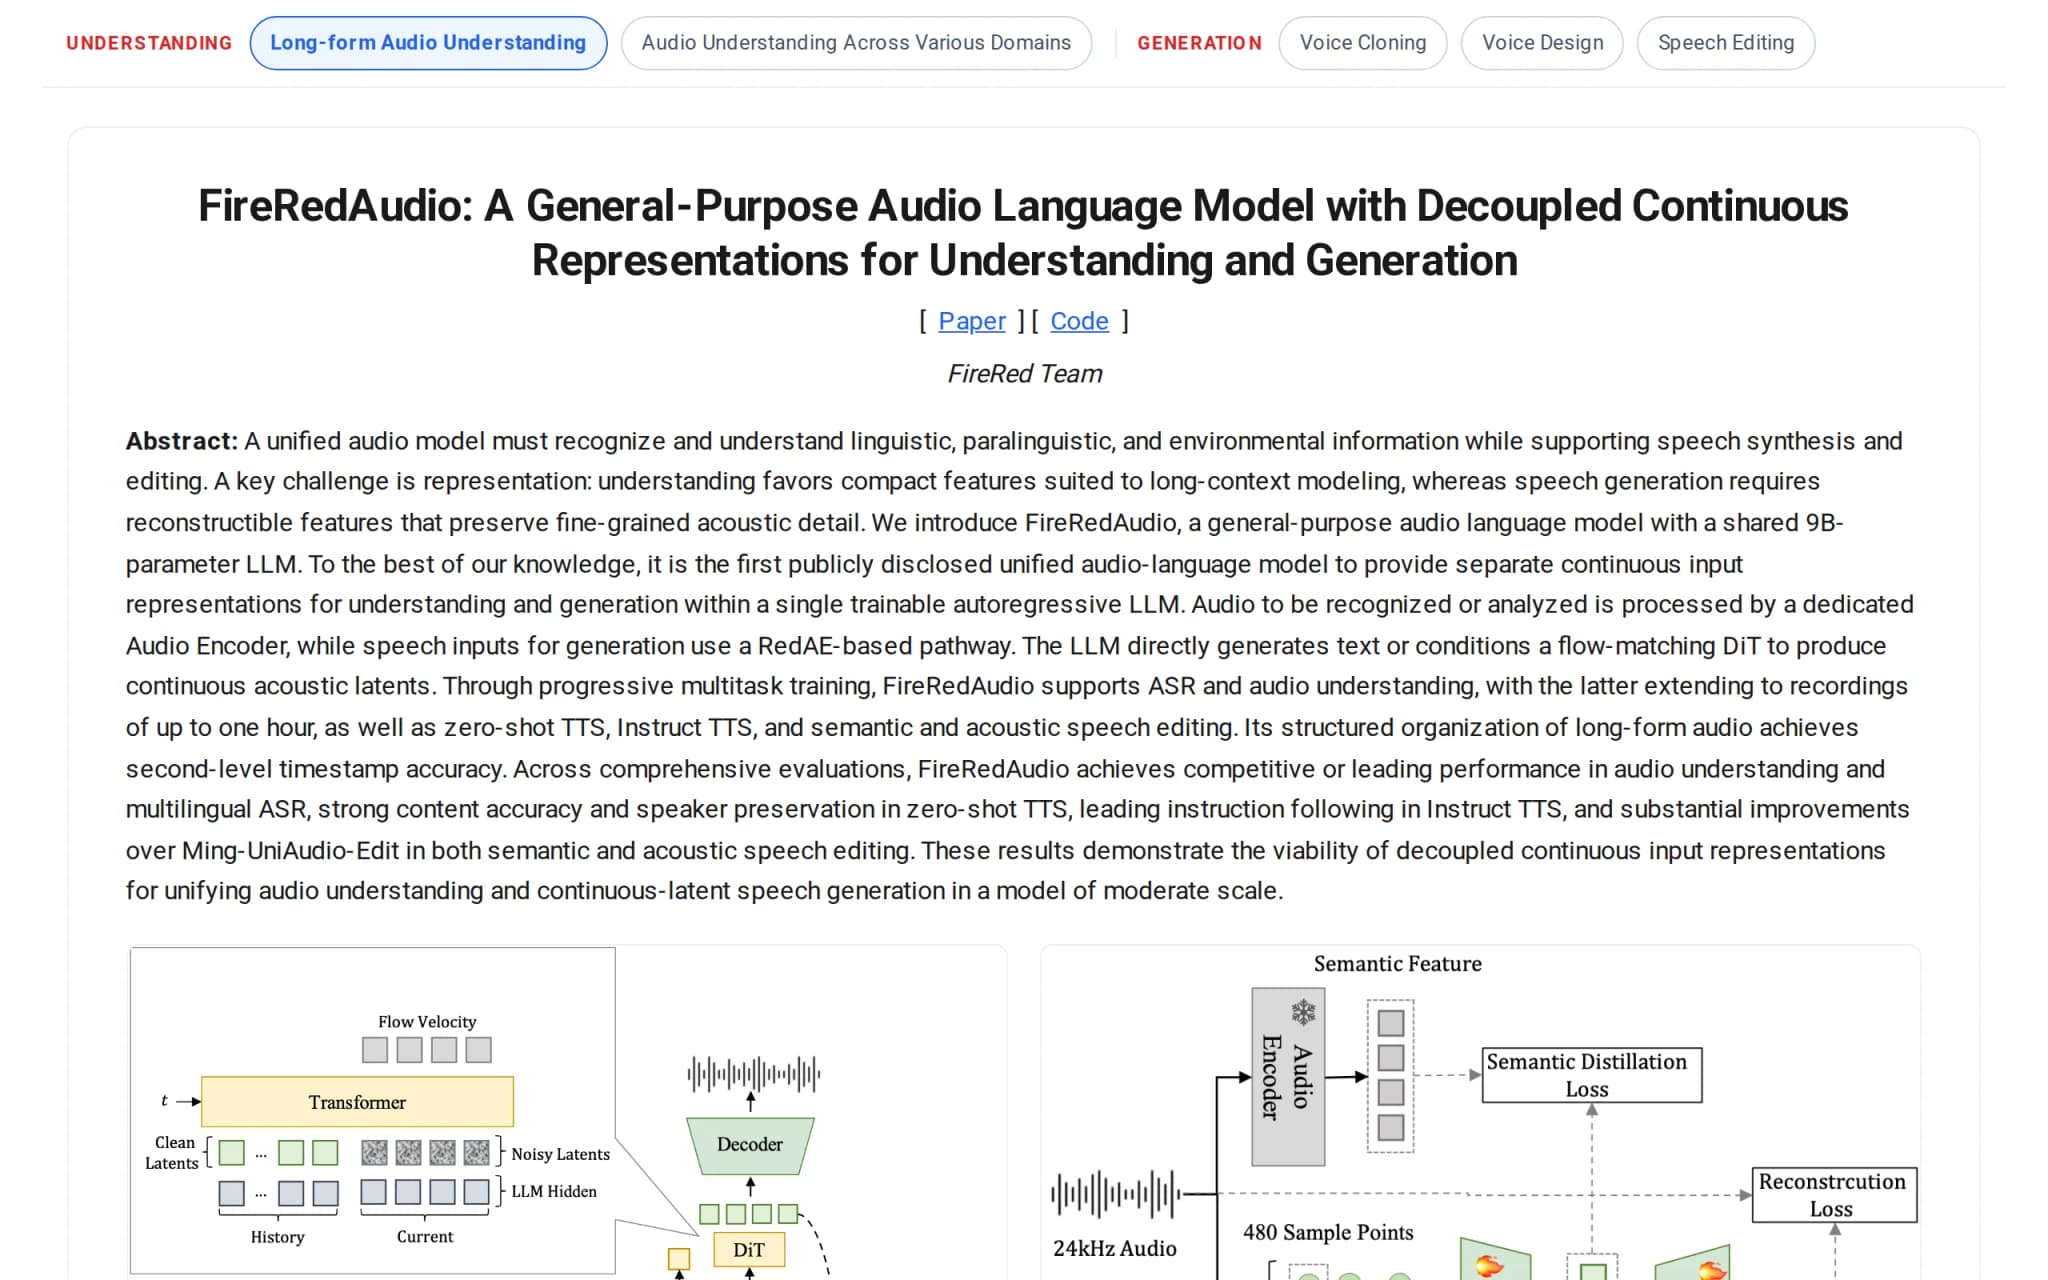
FireRedAudio – 小红书FireRed推出的通用音频语言模型深度评测
FireRedAudio是小红书FireRed团队于2026年8月开源的通用音频语言模型,基于9B参数Qwen3.5自回归大语言模型构建。该模型采用理解与生成解耦的连续表征架构,通过独立的Audio Encoder与RedAE通道分别提取语义特征与声学特征,再汇入共享LLM统一推理,同时支持语音识别、音频问答、1小时录音理解、Zero-shot TTS、指令TTS及语音编辑等六大任务,在MMAU、...
Atlas – World Labs 推出的全球首个多模态世界模型
Atlas是由李飞飞创办的World Labs推出的全球首个多模态世界模型。该模型原生理解文本、图像、视频与3D空间信息,通过空间上下文(Spatial Context)机制将画面锚定在三维坐标中,实现像素级精确的相机控制生成、稀疏照片3D重建及时空模拟。用户仅需提供几张普通照片,即可生成可任意运镜的长视频、重建真实场景,并为机器人搭建仿真训练环境。
MiniMax H3 Max:MiniMax 与 fal.ai 联合发布的实时视频生成模型
MiniMax H3 Max 是 MiniMax 与 fal.ai 联合发布的实时视频生成模型,核心卖点是速度:5 秒 768p 视频不到 3 秒出片,同时生成音频。直播团队和批量内容生产团队可以把它放进工作流;但 768p 上限和 15 秒时长意味着影视级制作不在射程内。
WeMM-Embedding:腾讯开源的通用多模态 Embedding 模型
腾讯微信视觉团队开源的 WeMM-Embedding,把文本、图像、视频统一编码进同一个向量空间。做内容检索、推荐召回或 Agent 记忆的团队可以直接用。它已经在微信视频号、公众号、朋友圈和电商里大规模部署,不是实验室项目。需要音频输入的场景目前不适合。
MiniMax H3 Max:fal 后训练的实时视频生成,快于实时,benchmark 缺失
H3 Max 已正式发布,是 MiniMax 与 fal.ai 联合推出的托管视频生成服务,其基座 H3 已开源。它适合要把视频生成接进内容生产流程的团队,以及想零门槛试用的个人用户;不适合把权重可控、评测可复现、本地部署当硬性要求的团队。
Zing-0.5 – Loopit 开源的实时交互视频世界模型
Zing-0.5是由Loopit团队开源的实时交互视频世界模型,参数量5B,基于Wan2.2-TI2V-5B基座训练,采用Apache 2.0协议。其核心能力是"联合控制":键盘空间操作与自然语言语义改写两条链路共同进入Causal DiT,用户可一边操控角色移动,一边用文字改写正在发生的世界,新指令进入当前世界而非重置场景。单卡RTX 5090可超24 FPS实时生成,一分钟流式推理成本约6分钱...
shuohao-skills – 开源AI短剧制作Skill集合,包含完整工作流
shuohao-skills是开源的AI短剧制作Skill集合,专为Claude Code、Codex等Agent设计。工具提供从小说改编大纲、角色设定、美术设定、剧本撰写到分镜切分的完整工作流,每个环节配有脚本化质量检查,确保角色不雷同、时长精准、风格一致。产出可直接对接TTS和视频生成管线,实现从文本到投产包的一站式AI短剧前期制作。

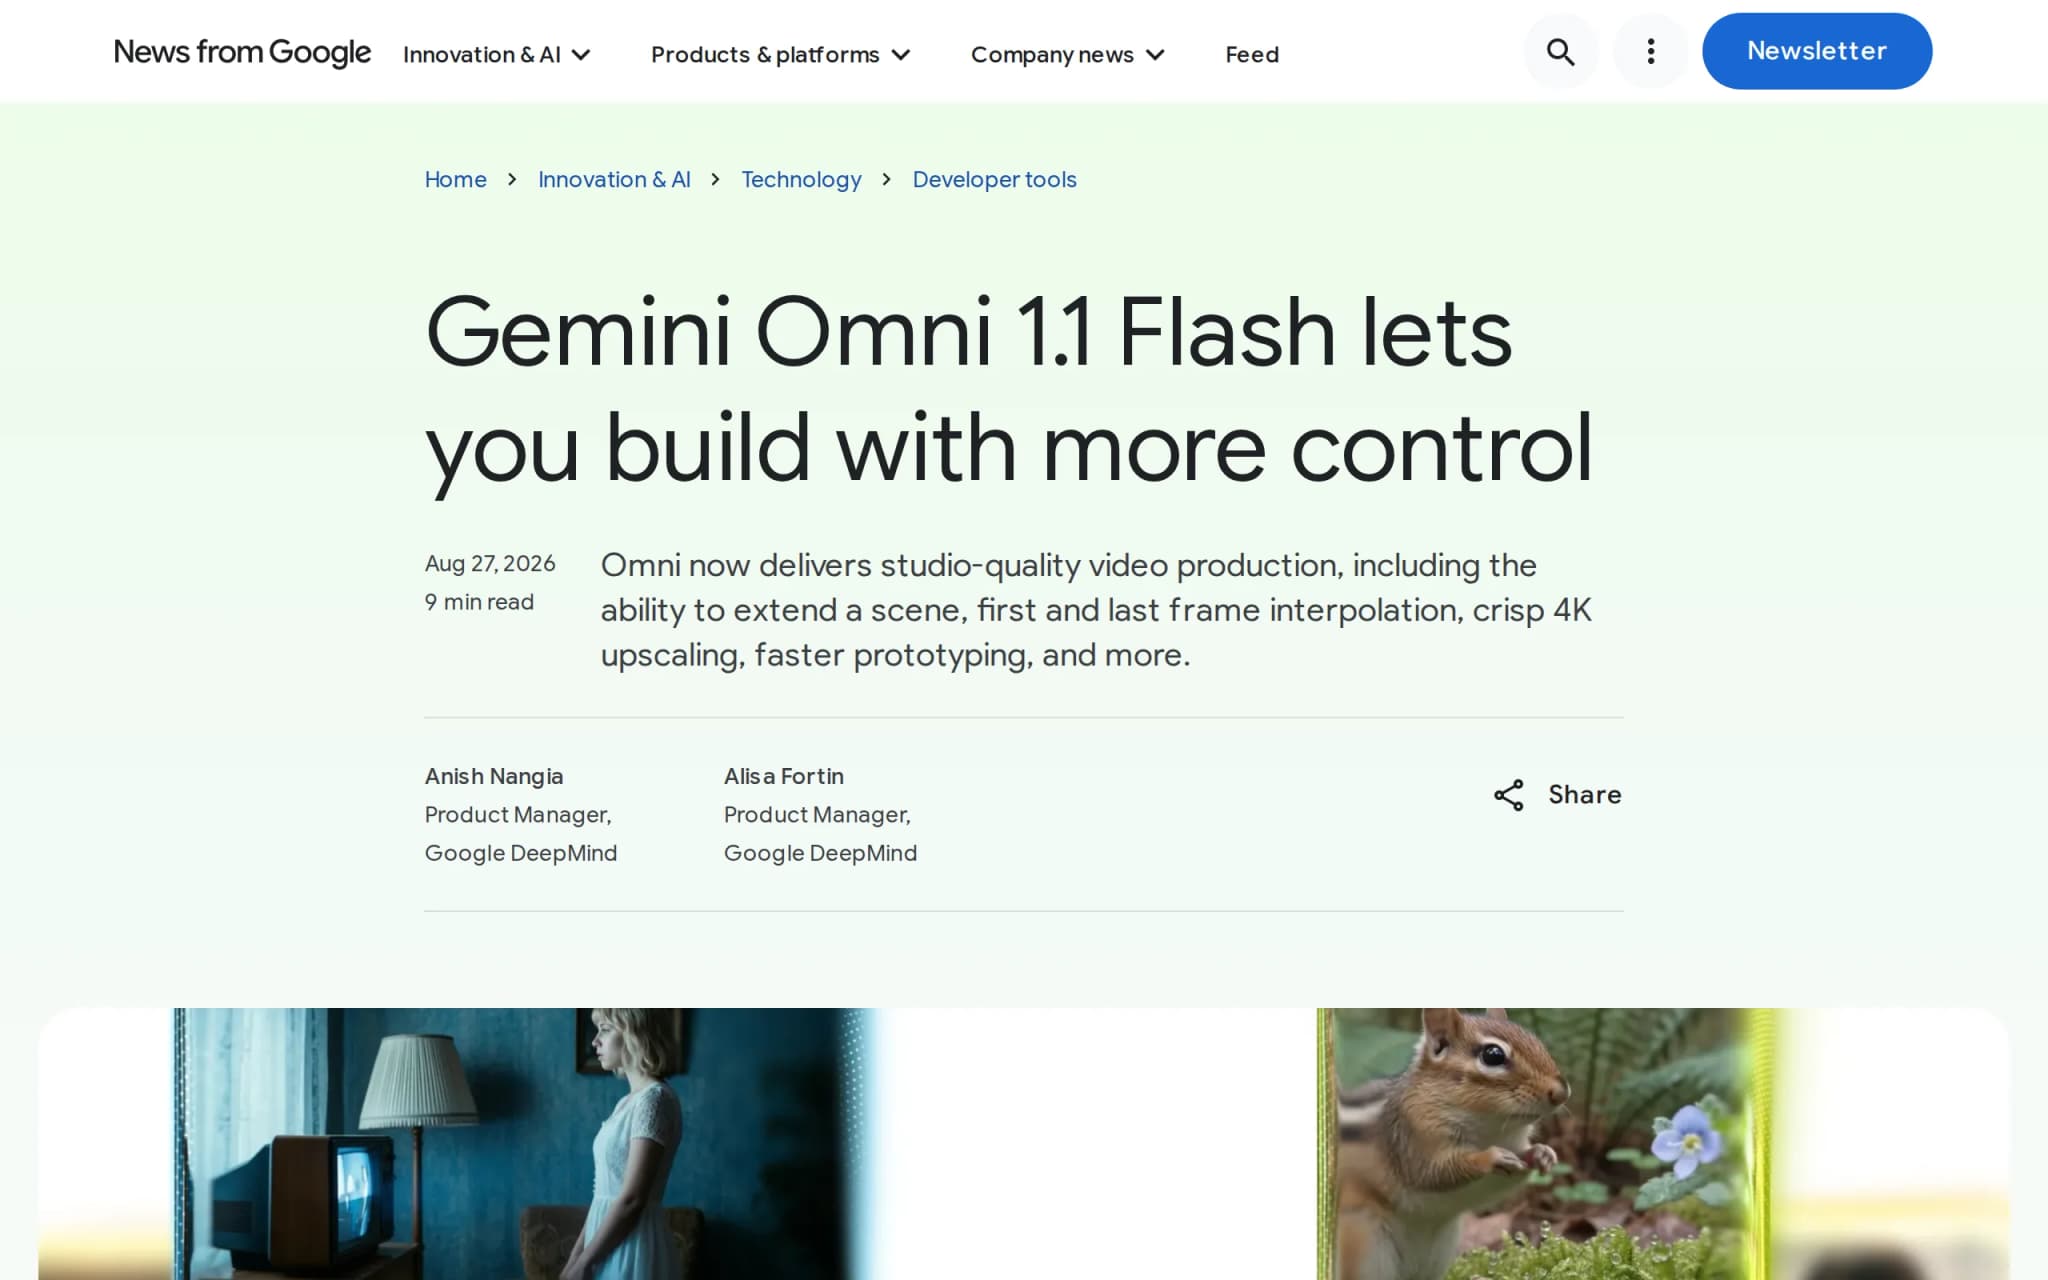
Gemini Omni 1.1 Flash — 谷歌面向专业创作者的多档位 AI 视频生成模型
Gemini Omni 1.1 Flash 是谷歌推出的 AI 视频生成模型,面向开发者和专业创作者,支持从 360p 快速预览到 4K 超高清的多档位输出。模型具备场景续写、首尾帧指定、视频参考等精细控制能力,可基于已有画面无缝扩展至 40 秒,通过引入最长 3 秒的参考片段保持角色与场景一致性。模型采用按秒计费模式,360p 约 0.2 元/秒,4K 约 2 元/秒。