AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:语音AI
共 99 篇文章 · 清除标签
Qwen-Audio-3.0-ASR-Flash – 阿里千问推出的语音识别大模型
Qwen-Audio-3.0-ASR-Flash是阿里千问团队推出的语音识别大模型,通过阿里云百炼平台提供Flash、Filetrans、Streaming三个版本的API服务。该模型具备长音频上下文记忆、行业词精准识别、热词即时定制和语音实时润色等核心能力,能够在识别过程中一步完成去口头禅、语义重组等文本优化,直接输出结构化书面文本。在Artificial Analysis评测中,该模型以1.7...
MAI-Voice-2-Flash – 微软推出的高速语音合成模型
MAI-Voice-2-Flash是微软AI团队针对高并发、低延迟场景推出的高速语音合成模型。在保持自然语调与高语音质量的前提下,其推理速度较前代MAI-Voice-2提升约2倍,成本降低32%。模型支持15种以上语言及细粒度情绪控制,已集成至Dynamics 365 Contact Center与Azure Voice Live,广泛应用于智能客服、语音助手等大规模语音服务场景。
OpenAI Presence – OpenAI 推出的企业级 AI Agent 平台
OpenAI Presence 是 OpenAI 于 2026 年 7 月 22 日正式推出的企业级 AI Agent 部署与治理平台,面向客服、销售与内部运营等高价值、高并发流程,帮助企业把智能体从演示阶段推进到可审计、可管控的生产环境。平台将模型推理与企业策略、权限边界、模拟评测和持续改进打包为托管交付方案,当前已用于 OpenAI 自有英语电话客服,据官方披露可自动处理约 75% 的进线问题
Step Edge – 阶跃星辰推出的端侧模型全家桶
Step Edge是阶跃星辰推出的端侧模型全家桶,包含基础模型、Audio、GUI、Gen四大成员,面向手机与汽车等终端打造。模型通过端云协同架构,让Agent在本地实现0.1秒级响应,同时保障全模态数据隐私,在29项核心评测中取得第一,并配套自研Step Inference NPU引擎优化终端推理。
StepAmoo – 阶跃星辰推出的一代个人智能体
StepAmoo是由阶跃星辰(StepFun)推出的新一代个人智能体,基于全球首个智能体原生操作系统Step AOS构建,具备操作系统级身份和系统级权限。它集感知、记忆、规划、连接、执行五大核心能力于一身,采用双域三步记忆结构,能够持续理解用户的习惯与偏好。通过端云协同路由机制,StepAmoo可跨应用调度原子化服务,完成复杂任务闭环,并在多设备间实现无缝接续,旨在从底层重构人机交互方式,成为真正...

Qwen-Audio-3.0-Realtime – 阿里推出的实时语音交互模型
Qwen-Audio-3.0-Realtime 是阿里云通义团队推出的新一代实时语音交互对话模型,提供 Plus 与 Flash 双版本,在毫秒级响应速度下保持高推理深度。模型基于 On-Policy Distillation 与多教师蒸馏技术,将文本大模型能力完整迁移至语音模态,支持无指令 Agent 工具自调用、动态情感语气调整与双工对话。该模型已上线阿里云百炼平台,适用于智能客服、教育培训、...
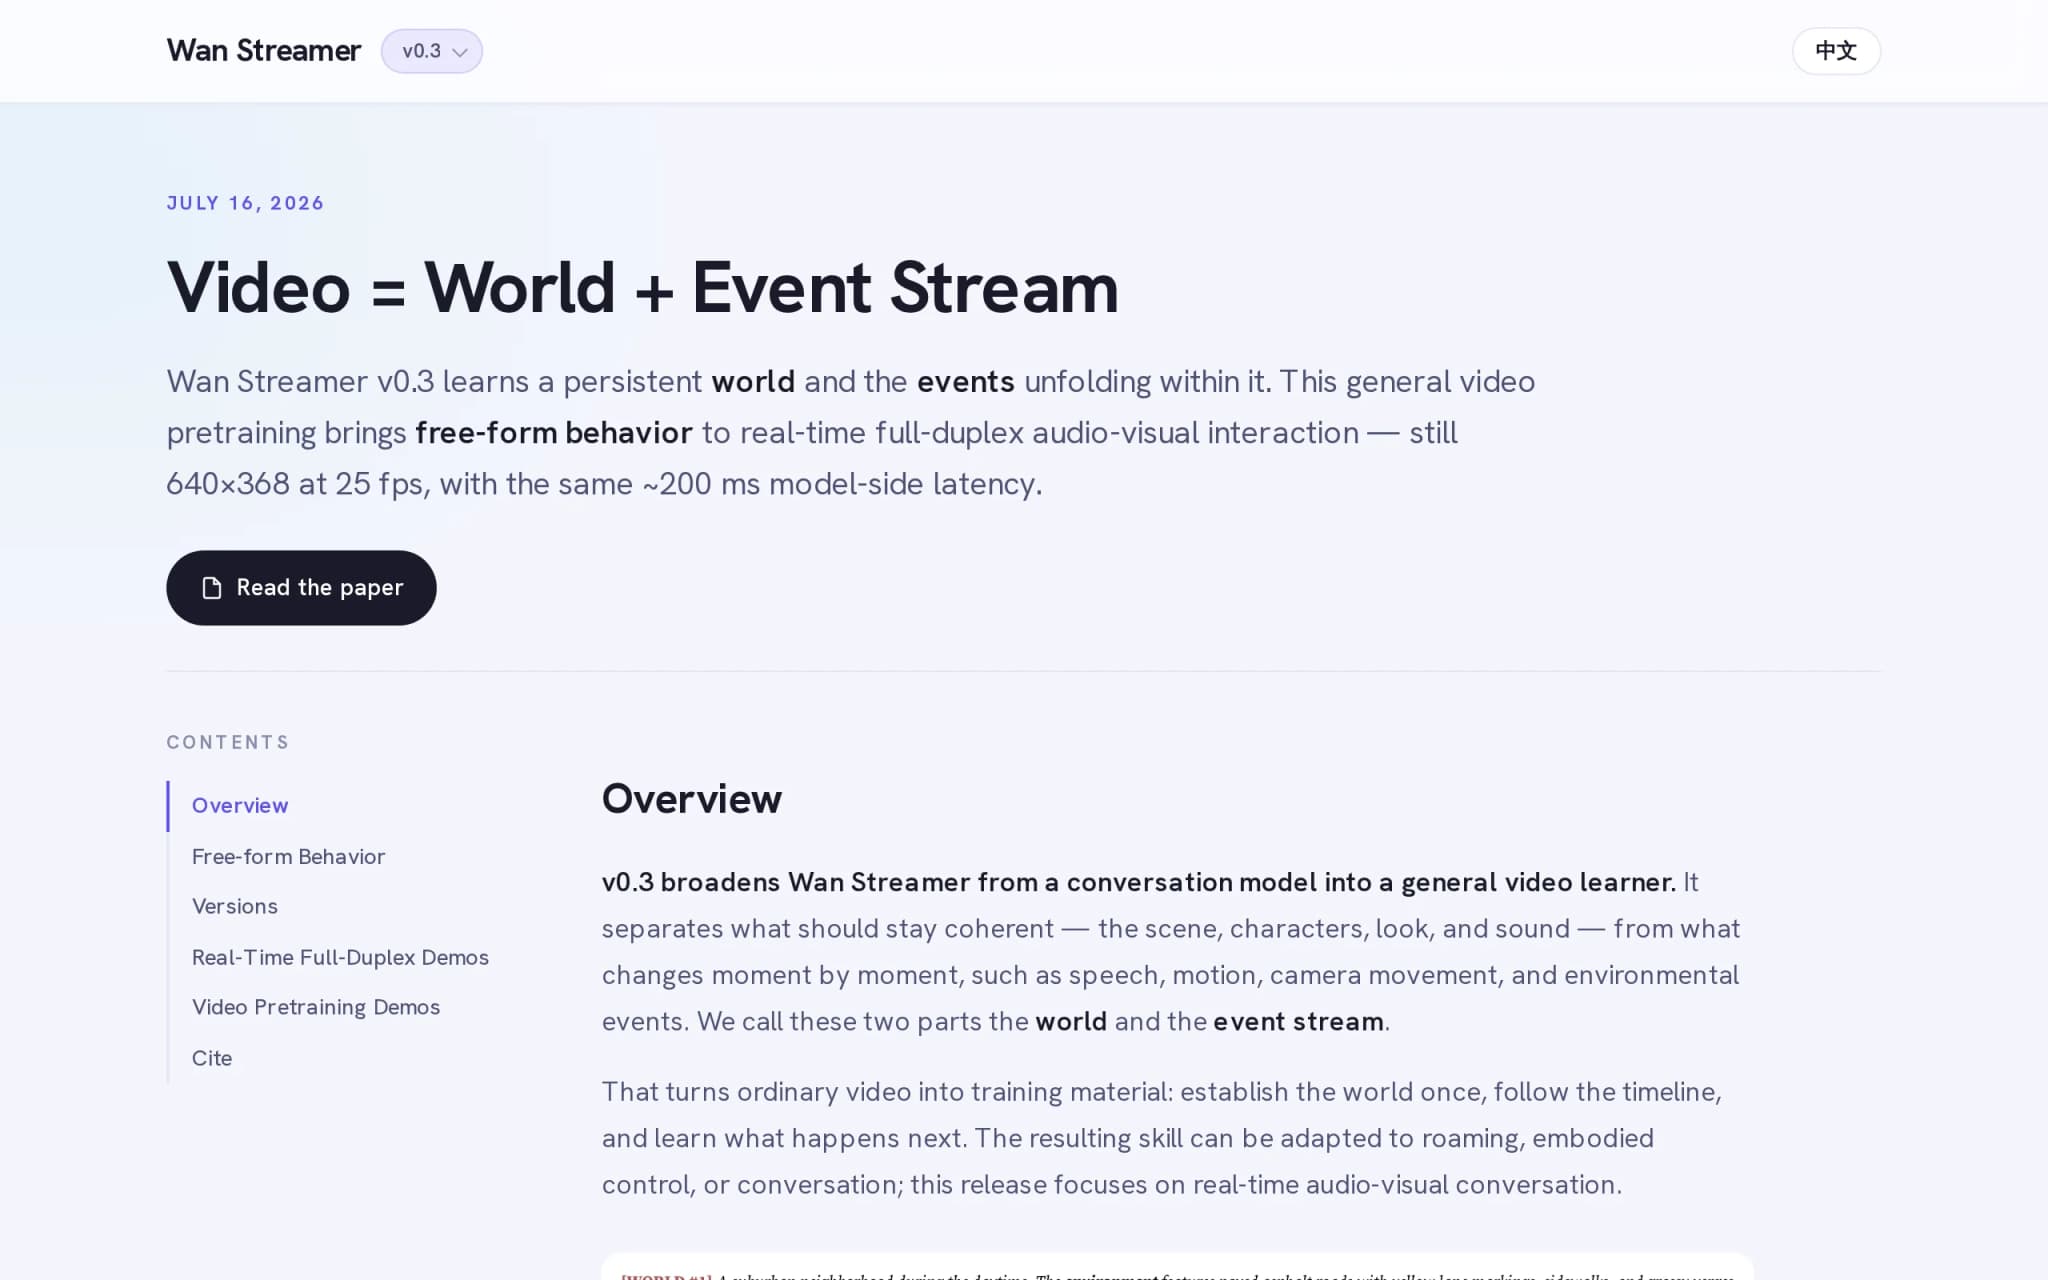
Wan-Streamer v0.2 – 阿里通义推出的全模态理解与生成模型
Wan-Streamer v0.2是阿里通义实验室推出的面向实时双工交互的端到端全模态理解与生成模型。该模型通过单个Transformer统一处理文本、音频、视频的实时理解与同步生成,端到端响应延迟仅550ms,视频输出分辨率640×368@25FPS,支持边说边听边回应的全双工交互,使AI能够像真人一样进行面对面的视频交流,显著提升了人机交互的自然度和实时性。
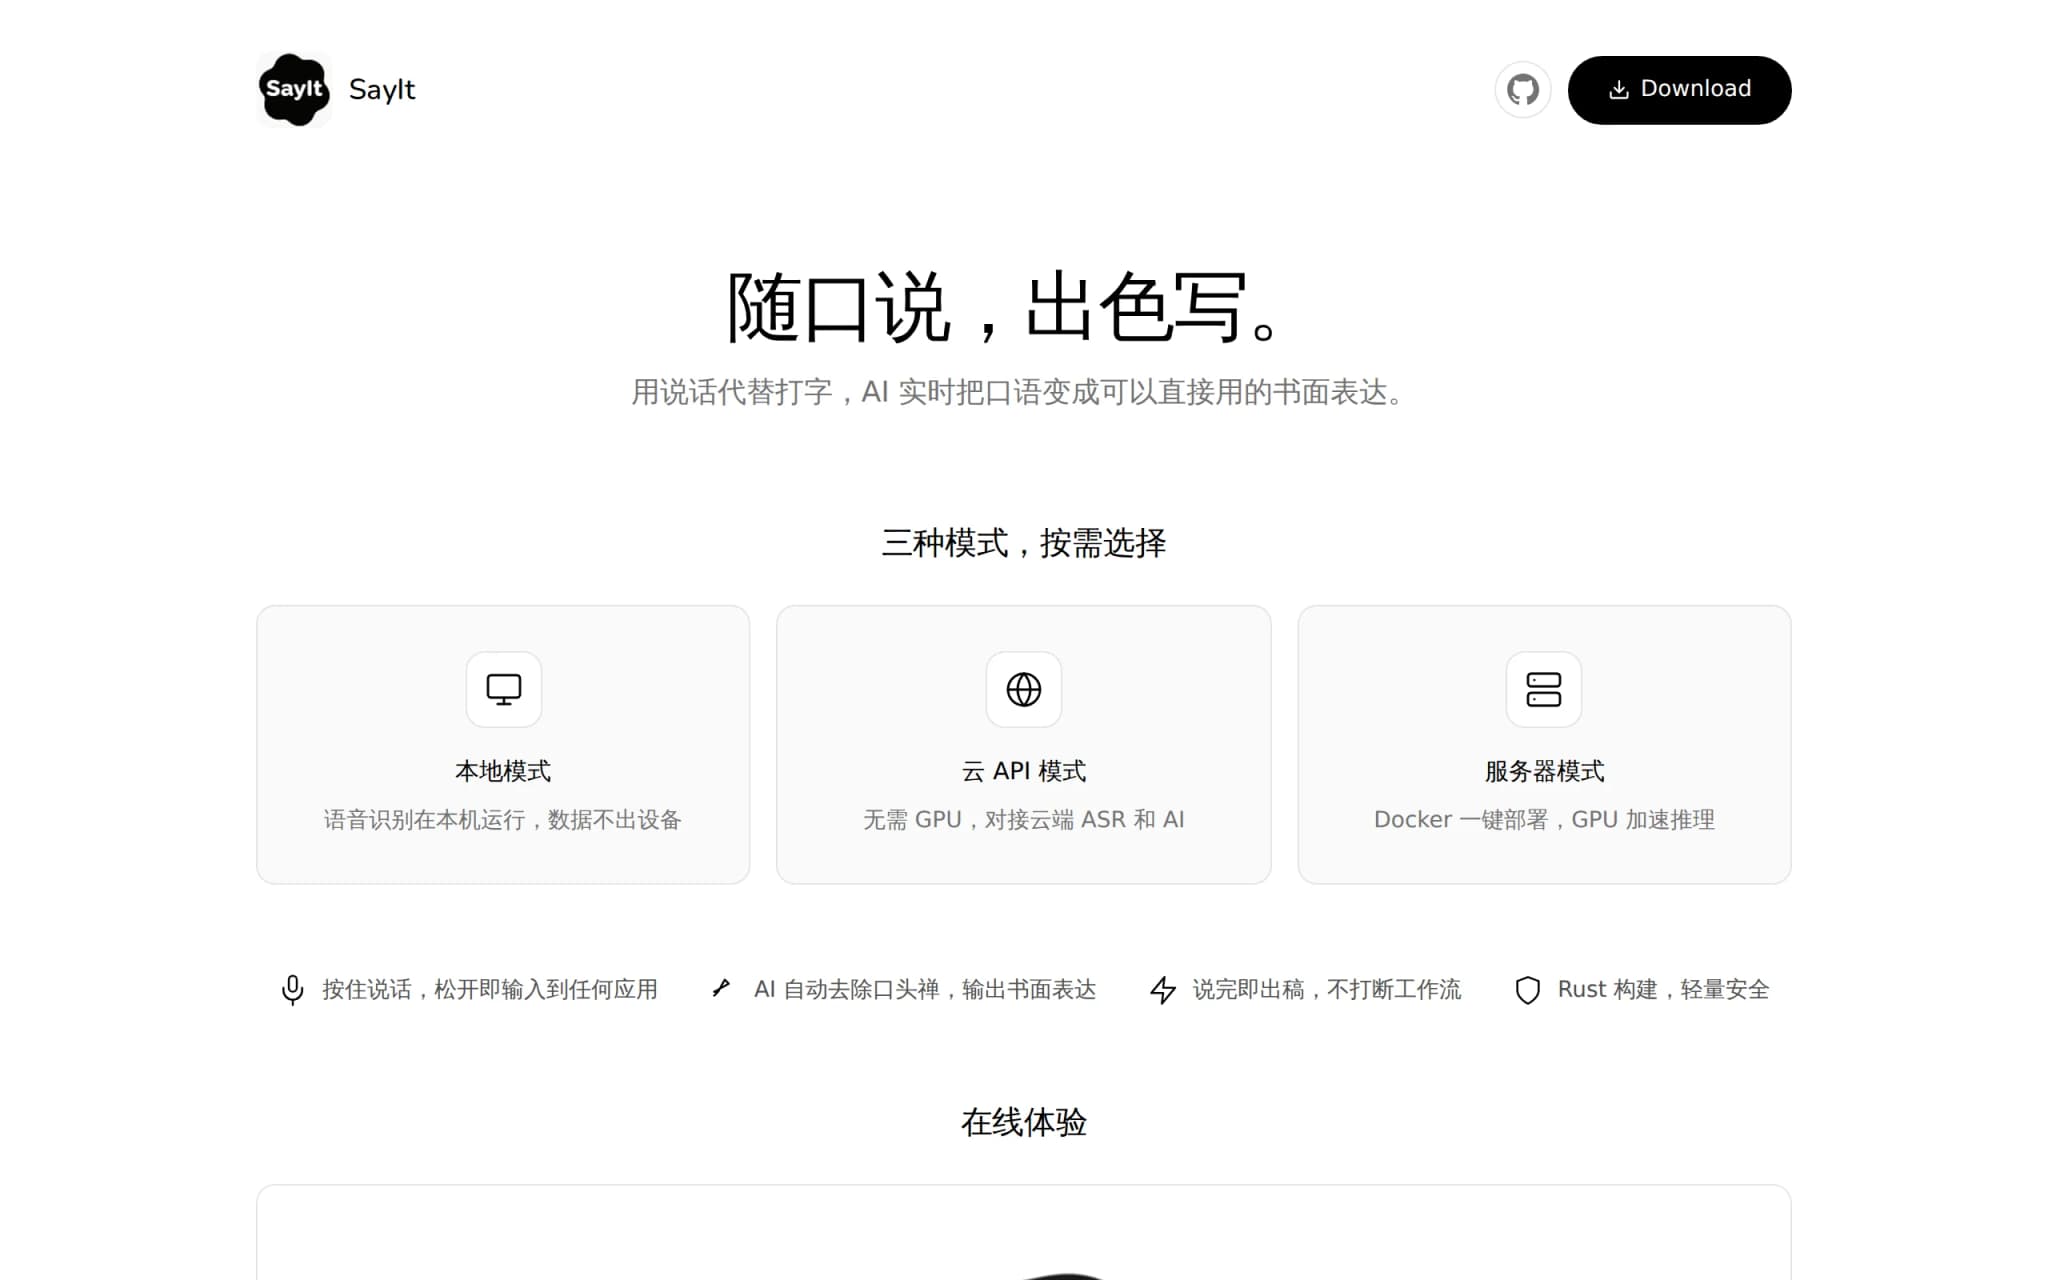
SayIt – 开源 AI 语音输入法,自动将口语转为书面表达
SayIt 是一款开源的 AI 语音输入法,基于 Rust 语言构建,专注于 Windows 桌面端。用户只需按住快捷键说话,即可将口语实时转化为可直接使用的书面文字。该产品提供本地、云 API 和自托管服务器三种语音识别模式,内置 AI 整理引擎,能够自动去除口头禅、修正错字、整理语序并支持中英互译。此外,SayIt 支持按应用自动匹配 Prompt 规则,在兼顾效率的同时,充分保障用户隐私。
GPT-Realtime-2.1 – OpenAI推出的一代实时语音模型
GPT-Realtime-2.1是OpenAI于2025年推出的新一代实时语音模型系列,包含旗舰版GPT-Realtime-2.1和高性价比版GPT-Realtime-2.1-mini。该系列采用端到端原生音频建模架构,直接处理音频Token,避免了传统语音转文字再转语音的级联方案所带来的信息损失与延迟。相较于前代,2.1版本在字母数字识别、静音/噪音处理及对话中断响应方面实现了显著提升,同时支持...
Fun-ASR-Realtime – 阿里千问推出的流式实时语音识别模型
Fun-ASR-Realtime 是阿里千问推出的流式实时语音识别大模型,专为低延迟、高精度的语音转文本场景设计。该模型通过 WebSocket 流式协议实现“边说边出字”,将首字延迟压缩至百毫秒级,同时保持接近离线模型的识别准确率。在方言识别方面,其覆盖 16 种中文方言和 30 种语言,并在 12 类方言测试中领先火山与腾讯的同类产品。模型还具备上下文理解、热词定制、情感识别和时间戳输出等高级...