AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:多模态
共 194 篇文章 · 清除标签
GLM-5.3-Flash深度评测:开源原生多模态架构的性价比实践
GLM-5.3-Flash是智谱AI推出的开源大模型,总参数320B,激活参数仅18B,为GLM-5系列首个原生多模态模型。模型综合智能指数达57分,与Claude Opus 4.8持平,定价仅为其四十分之一。采用稀疏与线性注意力混合架构及流形约束超连接技术,支持视觉编码、代码生成和专业文档处理,首次实现国产芯片集群大规模高效部署,端到端性能提升三倍。
EgoSuite-Open100K – 光轮智能开源的全模态人类行为数据集
EgoSuite-Open100K是光轮智能推出的全球首个10万小时级全模态人类行为开源数据集,面向物理AI与具身智能领域。数据集包含15,000+真实场景的第一人称视频,覆盖家居、工业等7大类环境,采用头部与腕部双视角同步采集,配备手部21关节位姿、身体姿态及事件语义三层精细标注。数据已在Hugging Face和AtomGit平台免费开放,学术研究与商业训练均可直接使用,旨在解决机器人训练中高...
PixVerse R2 – 爱诗科技推出的实时全模态世界模型
PixVerse R2是爱诗科技推出的实时全模态世界模型,为PixVerse R1的升级版本。模型支持文字、图像、音频及动作信号等多模态输入,能在运行中持续接收用户控制、实时更新世界状态并连续输出同步音视频。基于Omni Causal AR架构与实时加速技术,PixVerse R2在保持长程一致性的同时实现低延迟交互,让视频生成从固定片段进化为可持续演化的动态世界。
ScienceClaw深度评测:从“做任务”到“做项目”的科研智能体新范式
ScienceClaw是中科紫东太初(中科院自动化所孵化)推出的科研原生智能体平台,依托紫东太初4.0多模态大模型,覆盖生命科学、材料、化学、物理、天文等领域。最新升级的AutoProject引擎将AI从执行单个科研任务推向自主承接完整科研项目,可自主完成项目规划、任务拆解、长程执行、证据验证与容错修复,最终沉淀论文、数据、模型、代码等可复用科研资产,支持人机协同介入。该平台的核心价值在于将科研工...
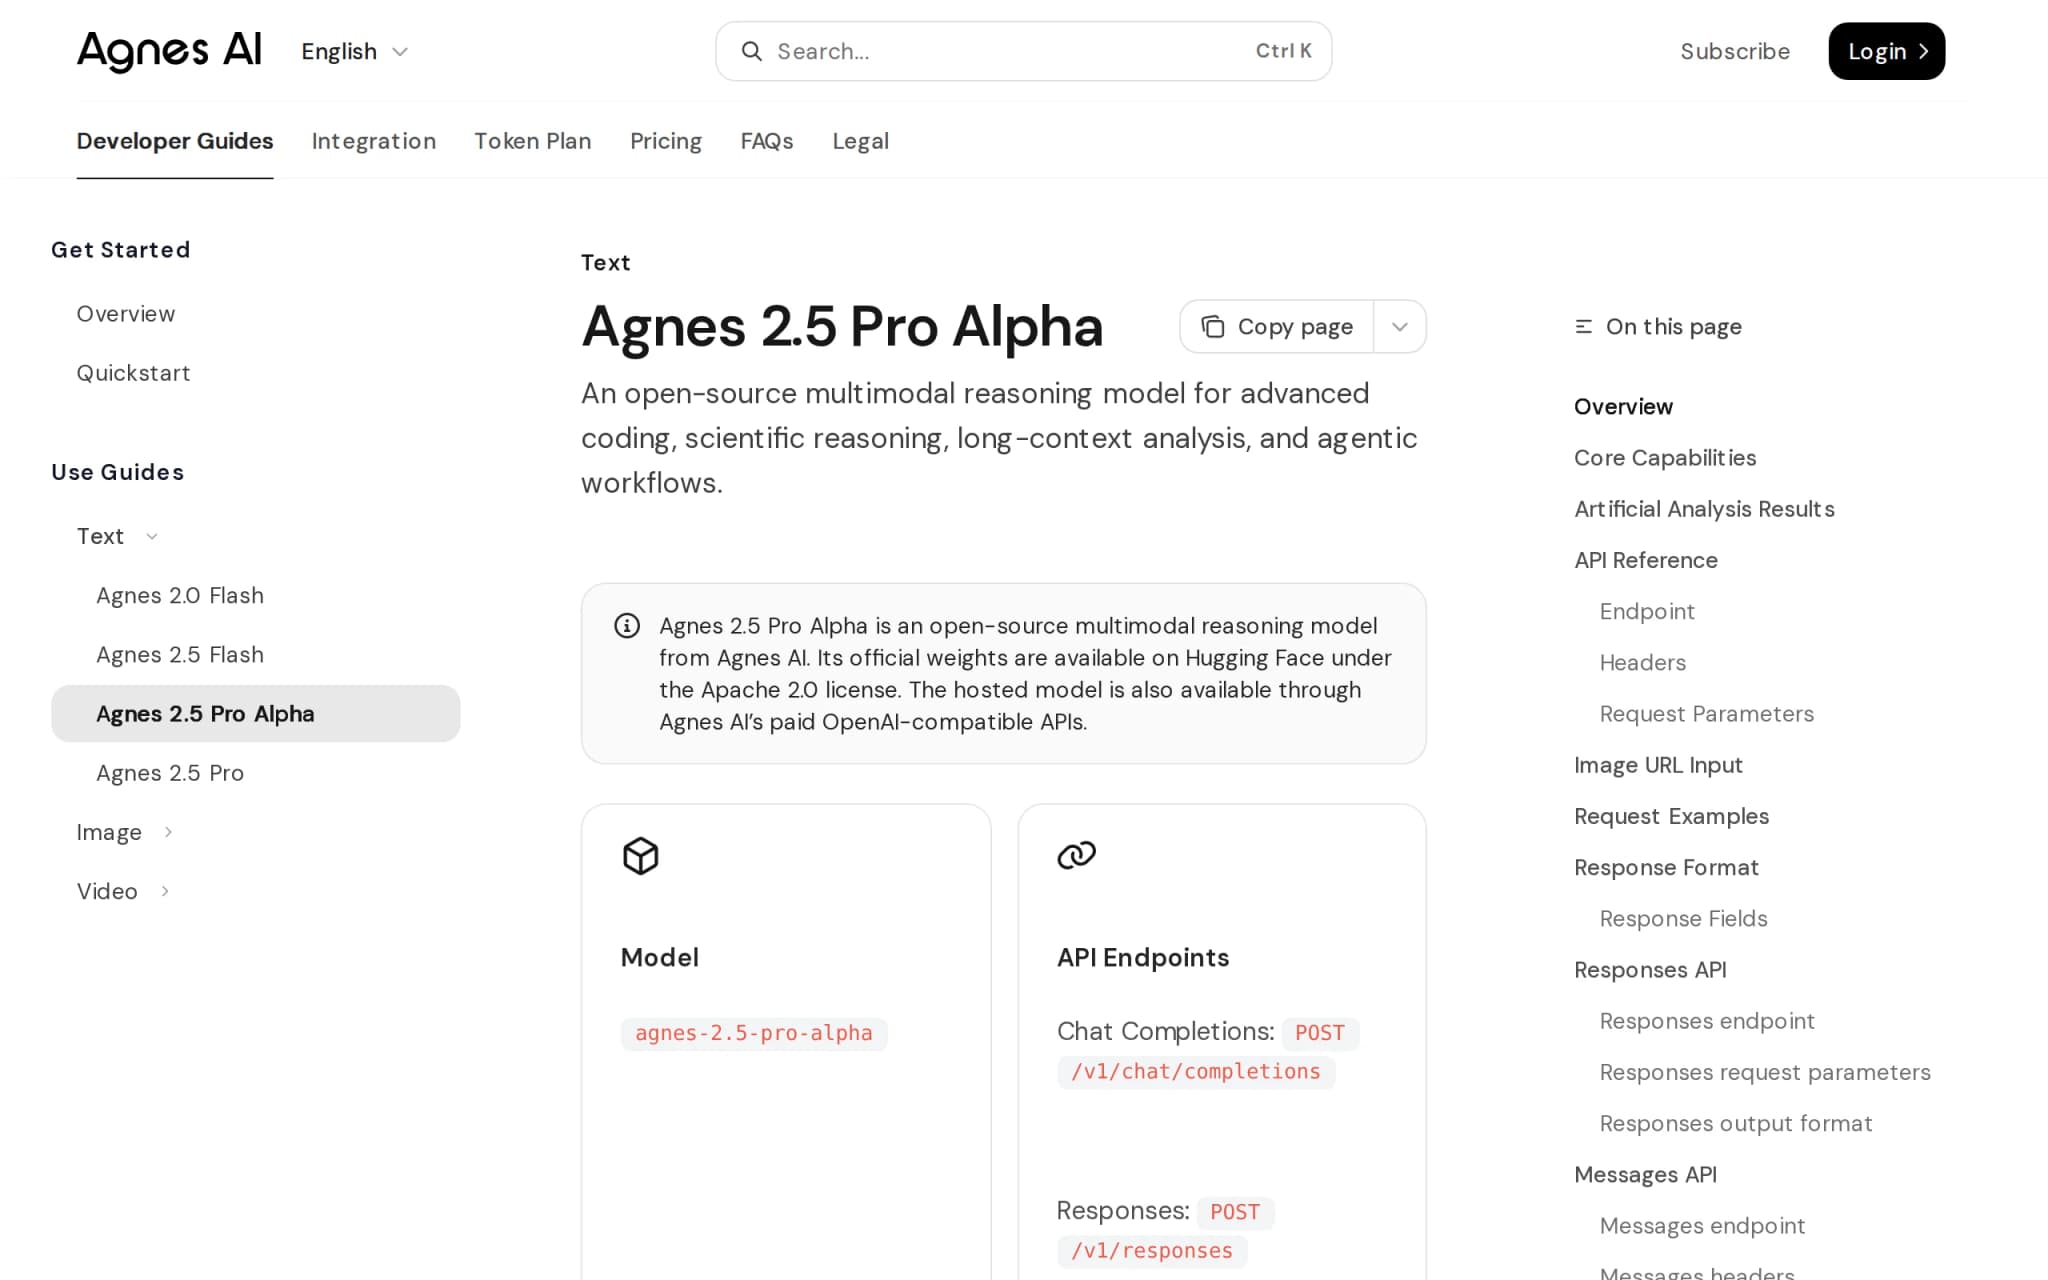
Agnes 2.5 Pro Alpha:Apache 2.0 开源的多模态推理模型深度评测
Agnes 2.5 Pro Alpha 是由 Agnes AI 团队开源的多模态推理模型,采用 Apache 2.0 协议发布,模型权重托管于 Hugging Face 平台。该模型支持文本与图像 URL 双模态输入,上下文窗口达 1M tokens,在复杂代码生成、科学推理、长文档分析与 Agent 工作流等场景中展现出较强的综合能力。模型同时兼容 OpenAI 与 Anthropic 主流 A...
SenseNova U1.5 Lite – 商汤科技开源的原生统一多模态大模型
SenseNova U1.5 Lite是商汤科技开源的轻量级原生统一多模态大模型,专为真实视觉创作流程设计。该模型在8B参数量级下实现原生多模态架构,支持3-4k字符超长指令遵循,具备高质量视觉生成、可靠图像编辑、精准文字排版、精细视觉控制及原生4K输出能力,可稳定完成海报、信息图等复杂视觉交付任务,面向全球开发者与创作者开源。
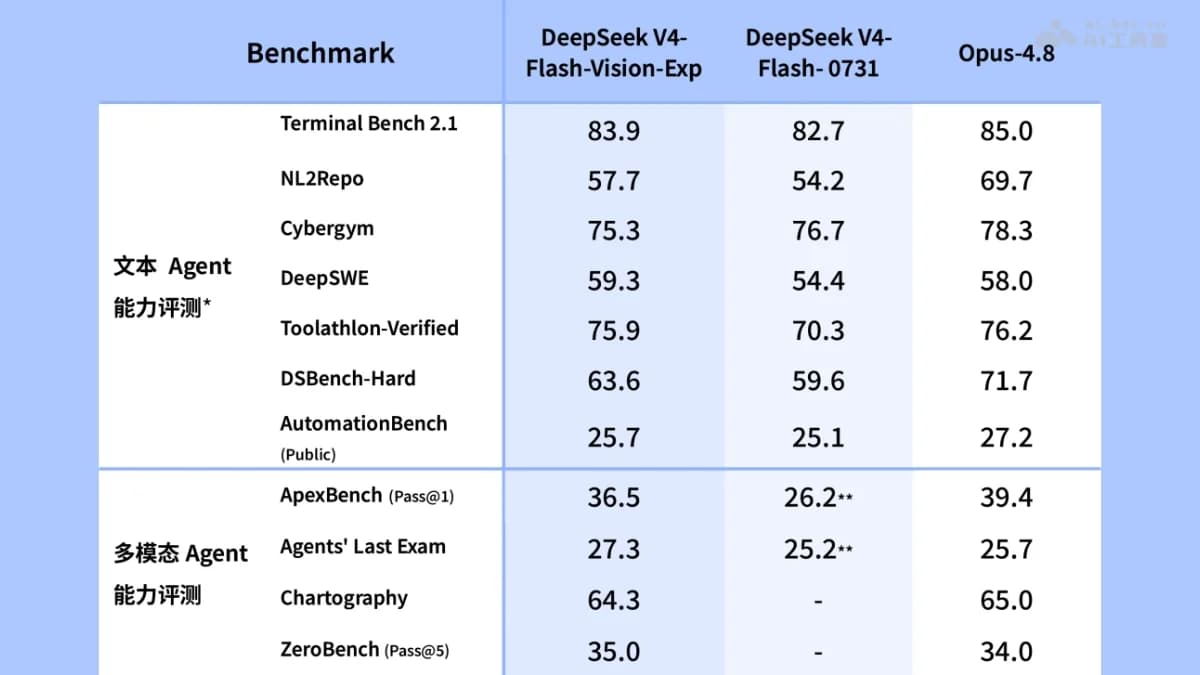
DeepSeek-V4-Flash-Vision-Exp – DeepSeek 推出的多模态视觉理解模型
DeepSeek-V4-Flash-Vision-Exp是DeepSeek推出的实验性多模态视觉理解模型。该模型在完整保留DeepSeek-V4-Flash文本能力的基础上新增视觉输入通道,多模态Agent表现接近Anthropic Opus-4.8。模型支持Chat Completions、Messages、Responses三种API格式,图片按token计费且单张上限384 tokens,价...
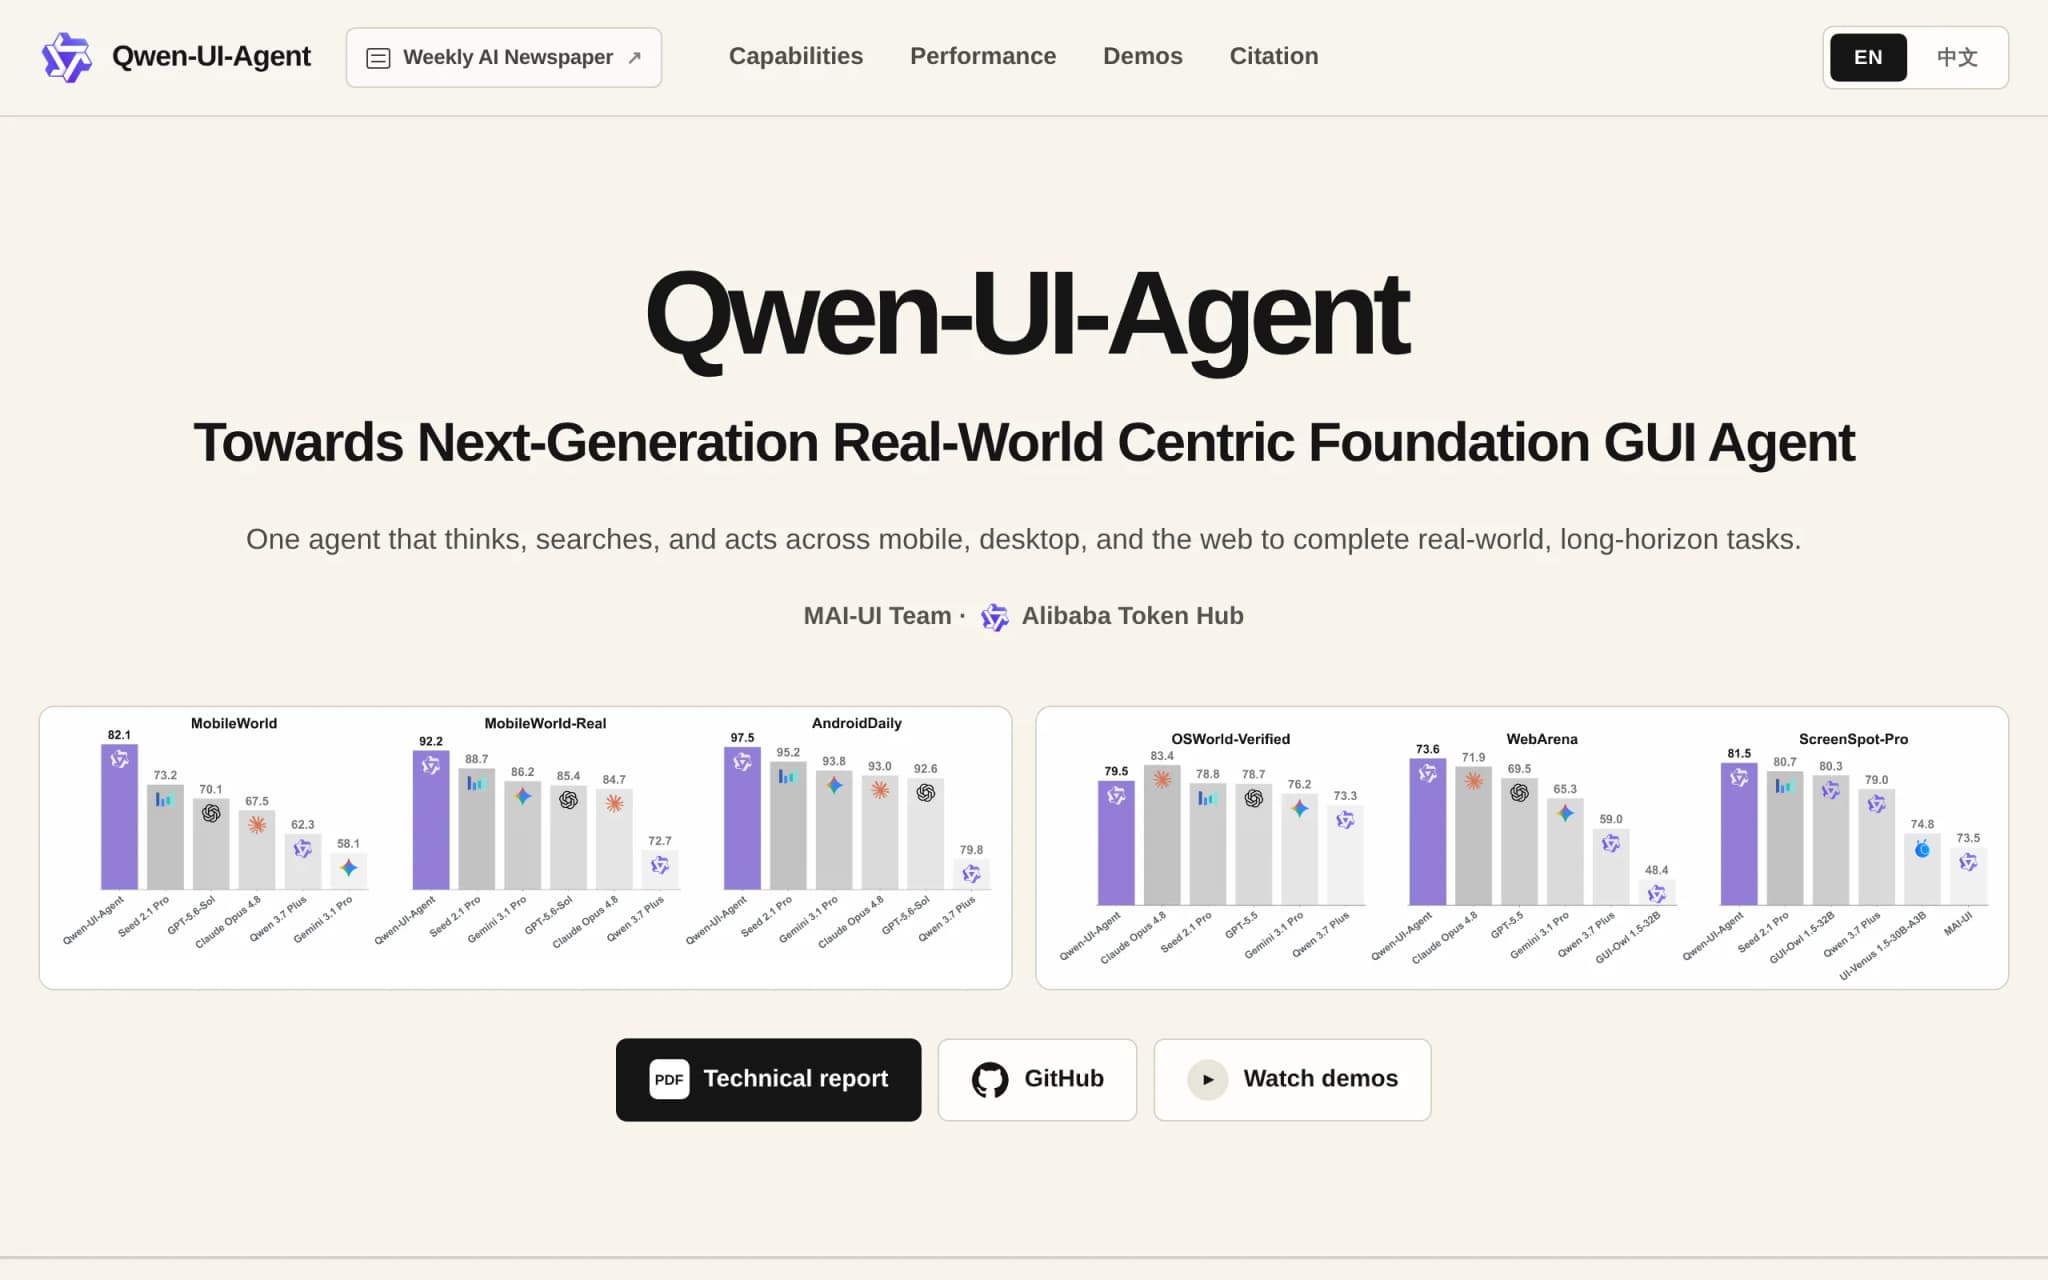
Qwen-UI-Agent – 阿里通义推出的 GUI 智能体基座模型
Qwen-UI-Agent 是阿里巴巴通义团队推出的 GUI 智能体基座模型,能够在手机、电脑和网页端像真人一样操作界面。该模型基于 100 余台真实设备和 150 多个应用的真机集群训练,支持图形界面与命令行混合执行,可完成跨应用的复杂长程任务。内置分层安全机制,对危险请求直接拒绝,对支付、删除等敏感操作主动交还用户确认。在 MobileWorld、WebArena 等多项权威基准上,其性能表现...
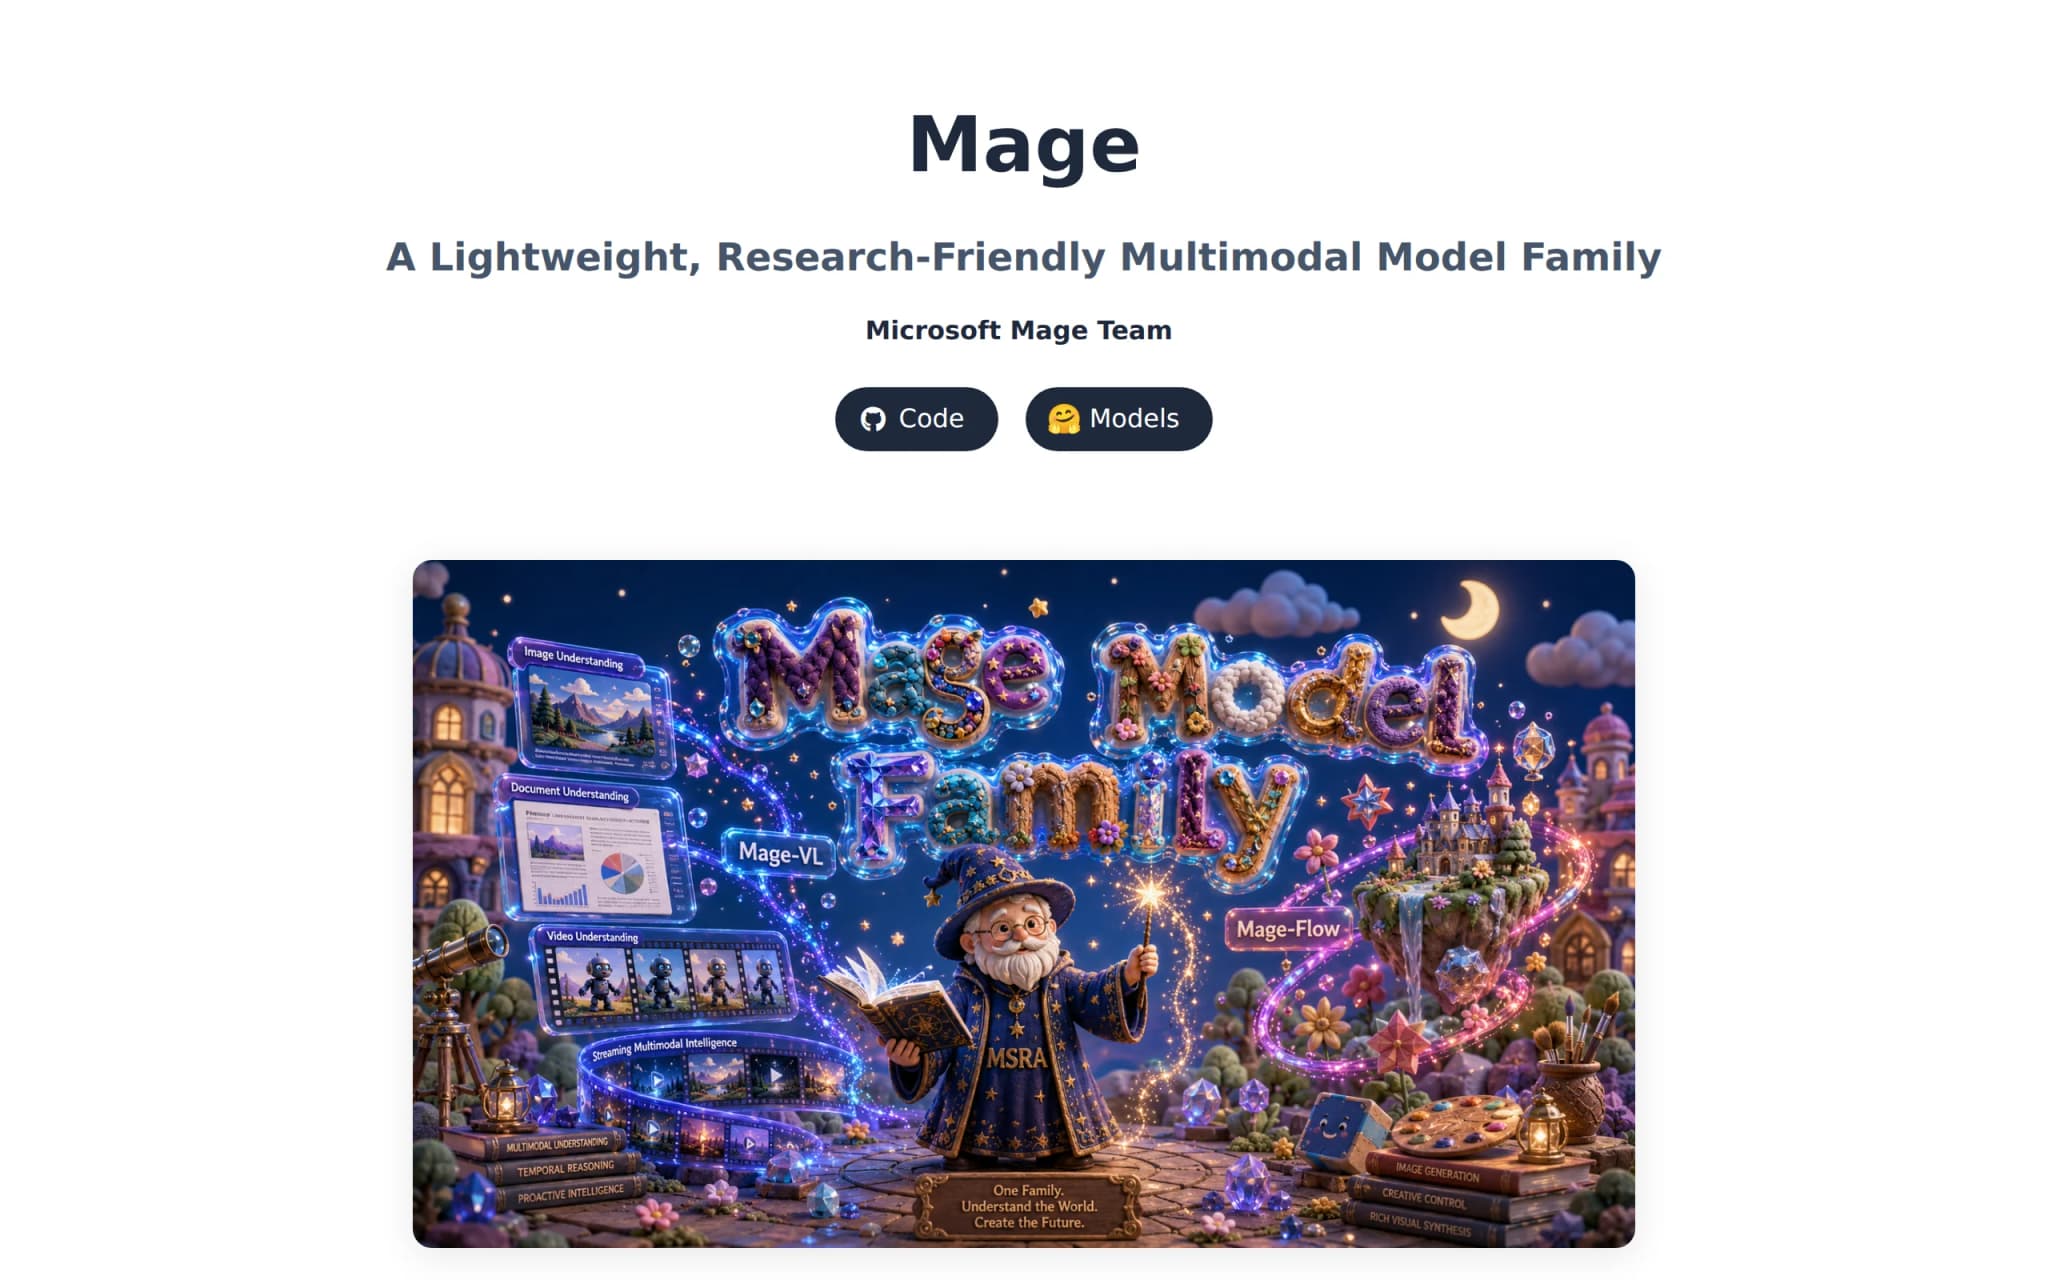
Mage – 微软开源的 4B 参数多模态模型家族
Mage是微软开源的4B参数多模态模型家族,由流式视频/图像理解模型Mage-VL与图像生成与编辑模型Mage-Flow组成。通过Codec-Native编码将视觉Token减少75%,推理提速3.5倍,支持实时视频理解;Mage-Flow支持原生分辨率生成与指令编辑,Turbo版4步采样,A100单卡0.6秒出图。该模型家族在4B参数规模下实现了生成与理解能力的统一,降低了多模态AI的部署门槛。
HiDream-O1-World – 智象未来推出的全模态交互式世界模型
HiDream-O1-World是由智象未来(HiDream.ai)推出的原生全模态交互式世界模型,基于自研UiT架构打造。该模型支持文本、图像、交互操控等多模态输入,具备漫游、编辑、交互三大核心能力,能够一键生成时空一致、符合物理规律、可长时推演的完整世界。其核心突破在于“3D先验注入Memory上下文+Test-Time Training在线适应”的协同设计,有效解决了长时交互中的物体漂移、场...