AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:视频AI
共 117 篇文章 · 清除标签
UniWorld-View – 兔展智能联合北大等开源的世界模型
UniWorld-View是兔展智能联合北京大学、鹏城实验室推出的开源世界模型,登顶李飞飞团队WorldScore世界模型评测榜单。该模型基于单张图片或一段视频,能够按照指定相机轨迹生成新视角画面,实现单图3D生成与视频4D生成的统一架构。模型已完成国产昇腾算力适配,代码与权重均开源,为世界模型的研究与应用提供了高效、可控的解决方案。

MiniMax H3 – 稀宇科技推出的通用全模态生成模型
MiniMax H3是稀宇科技(MiniMax)于2026年7月31日正式发布的通用全模态生成模型。该模型打破了传统任务与模态之间的边界,首次实现对文本、图像、视频、音频的统一理解与原生生成,无需任何后期拼接或合成。H3可直接输出原生双声道音视频内容,最高支持15秒2K分辨率,在指令遵循、品牌信息呈现、视频到视频动作迁移等商用场景中展现出显著优势。其自研的Contextual Omni Repre...
FLUX 3 – Black Forest Labs 推出的多模态基础模型
FLUX 3是由Black Forest Labs推出的多模态基础模型,首次在统一架构下联合学习图像、视频与音频。基于Self-Flow技术,模型将生成与理解对齐于同一框架,能够单次生成长达20秒带原生音频的视频,支持文生视频、图生视频、视频生视频及关键帧转视频。通过模态间的物理约束学习世界表征,FLUX 3在机器人操控等具身智能任务上表现优异。
DramaClaw – 工业级 AI 视频制作工具,提供一站式流水线
DramaClaw是一款面向AI短剧、漫剧、小说推文等场景的工业级AIGC视频制作工具。它基于自研的灵山AI编导大模型,提供从剧本导入到成片输出的一站式流水线。通过构建虚拟三维导演世界,DramaClaw实现了角色、场景和叙事风格在长篇幅中的高度一致性,有效解决了传统AI视频生成中的随机性和不一致问题。该工具以确定性生产为核心,大幅降低制作成本,并将核心代码开源,支持二次开发与本地部署。
PixVerse Game – 爱诗科技推出的首个实时视频游戏引擎
PixVerse Game 是爱诗科技基于其自研的 PixVerse R1 实时世界模型,推出的业界首个实时视频游戏引擎。该引擎将完整的游戏体验构建在一条持续生成的实时互动视频流之上,彻底颠覆了传统游戏开发中依赖预置资产、建模与动画管线的范式。创作者无需掌握编程或美术技能,仅通过定义规则与世界观,即可实时生成并运行一个交互式游戏世界。其核心在于将游戏逻辑、视觉表现与玩家输入实时耦合,实现从“创作”...
Wan-Dancer – 阿里通义开源的人像舞蹈视频生成模型
Wan-Dancer 是阿里通义万相开源的音乐驱动人像舞蹈视频生成模型,用户仅需提供一张单人正面照片和一段音乐,即可自动生成节奏精准、动作流畅且风格鲜明的舞蹈视频。该模型首次突破分钟级时序生成瓶颈,支持输出 15 秒至 3 分钟的 720p/30fps 超长连贯视频,覆盖中国古典舞、韩舞、街舞、踢踏舞和拉丁舞五种舞种,并允许通过 LoRA 技术进行个性化舞蹈风格定制。Wan-Dancer 在长序列...
ABot-World Studio – 高德推出的通用世界模型工坊
ABot-World Studio是由高德地图推出的通用世界模型工坊,创新性地将交互式视频生成与3DGS(3D Gaussian Splatting)场景生成统一于同一产品体系。用户通过输入文字或图片,即可生成可实时交互的AI世界,支持单张NVIDIA RTX 5090消费级显卡本地部署,单次连续推理时长可超过1小时,并内置“时空任意门”机制实现无界世界跃迁。该工坊旨在降低高质量3D世界内容的生产...
MOSS-VL-Realtime – OpenMOSS 开源的视觉语言模型
MOSS-VL-Realtime 是 OpenMOSS 开源的 11B 参数流式视觉语言模型,专为实时视频理解设计。模型支持边看边答、即时修正与主动沉默,将视频理解从看录像升级为看直播。模型通过双通道交叉注意力架构与绝对时间戳编码,实现感知与生成并行,让 AI 与物理世界保持时间同步,在多个流式基准测试中达到开源领先水平。
Xiaomi-Robotics-U0 – 小米推出的统一具身合成模型
Xiaomi-Robotics-U0 是小米推出的 380 亿参数统一具身合成模型,基于世界基础模型持续训练,联合优化文生图、图像编辑、具身场景生成、具身迁移及具身视频生成五大任务。该模型是首个支持跨多种机器人形态的高质量多视角场景生成模型,在具身场景生成与迁移的人工评估中超越 GPT-Image-2.0,在 World Arena 具身视频生成榜单排名第一,并将 π0.5 在真实世界操控任务的分...
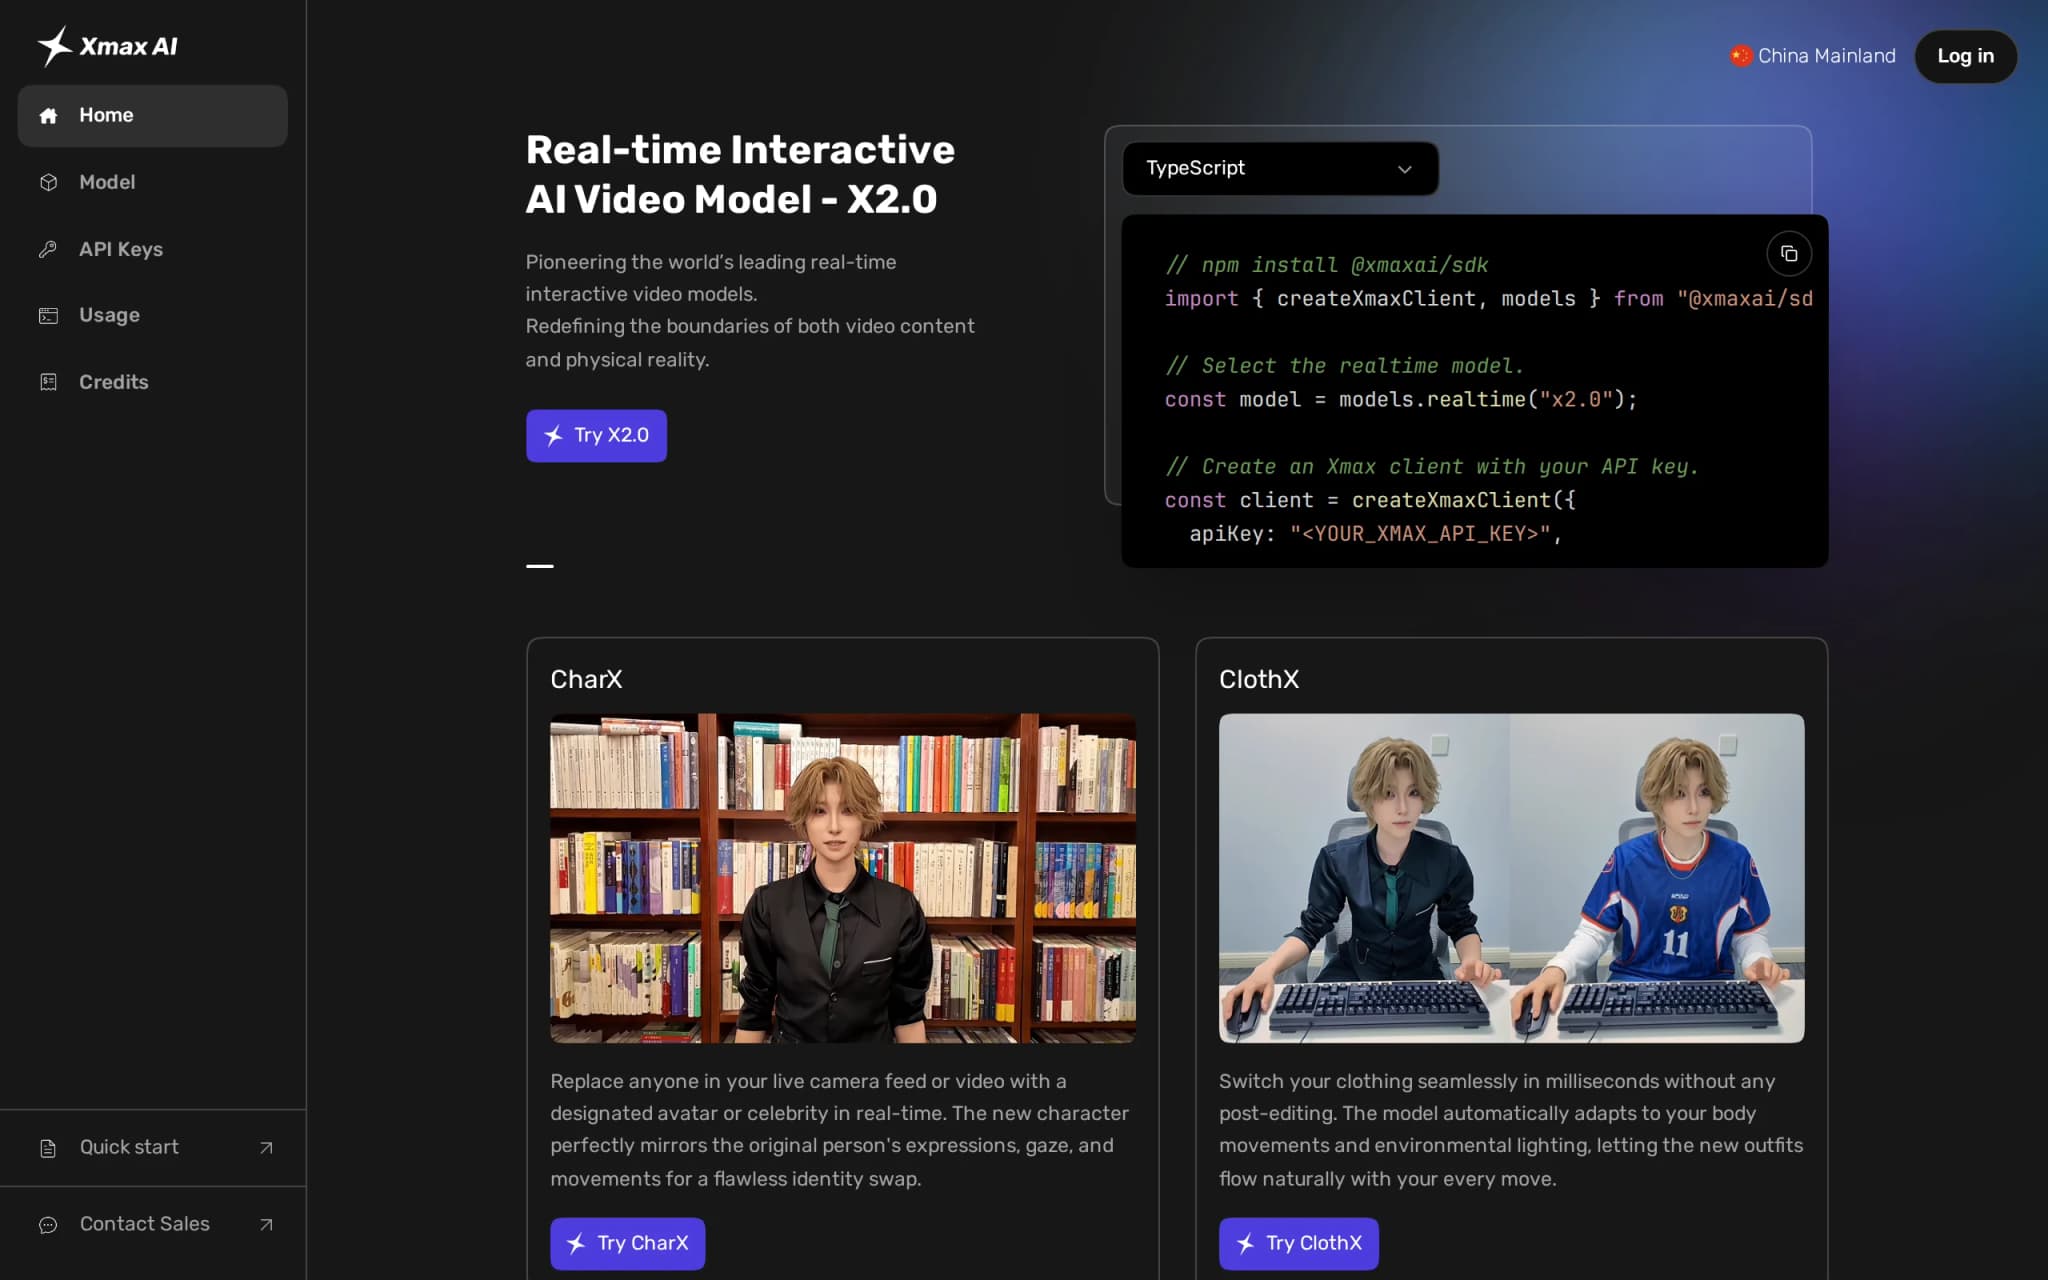
X2.0 – Xmax AI 推出的全球首个实时交互视频生成模型
X2.0是Xmax AI推出的全球首个实时交互视频生成模型,支持毫秒级流式生成。用户通过摄像头可实时替换角色服装、召唤虚拟物体、触屏操控画面,实现可玩的视频体验。模型采用逐帧自回归架构与多阶段蒸馏,单卡可满血运行960p@24fps,首发iPhone端侧384p@16fps实时部署。