AI 模型库:大模型、Agent 与开发工具
收录并解读主流 AI 模型、Agent 与开发工具的能力、场景与选型对比。
标签:AI科学
共 34 篇文章 · 清除标签
MiniCPM-OCR – 面壁智能开源的 OCR 系列模型
MiniCPM-OCR 是面壁智能发布并开源的全新 OCR 系列模型,包含文档解析专用模型 MiniCPM-OCR 1.0(1.3B)与业内首个解析结果判别模型 MiniCPM-OCR Jev(2B)。前者在 Real5-OmniDocBench 与 OCRBench v2 两项权威基准上取得 SOTA 成绩,后者通过输出 0–1 质量评分实现 OCR 结果的可信度量化。该系列模型面向金融、财税、...

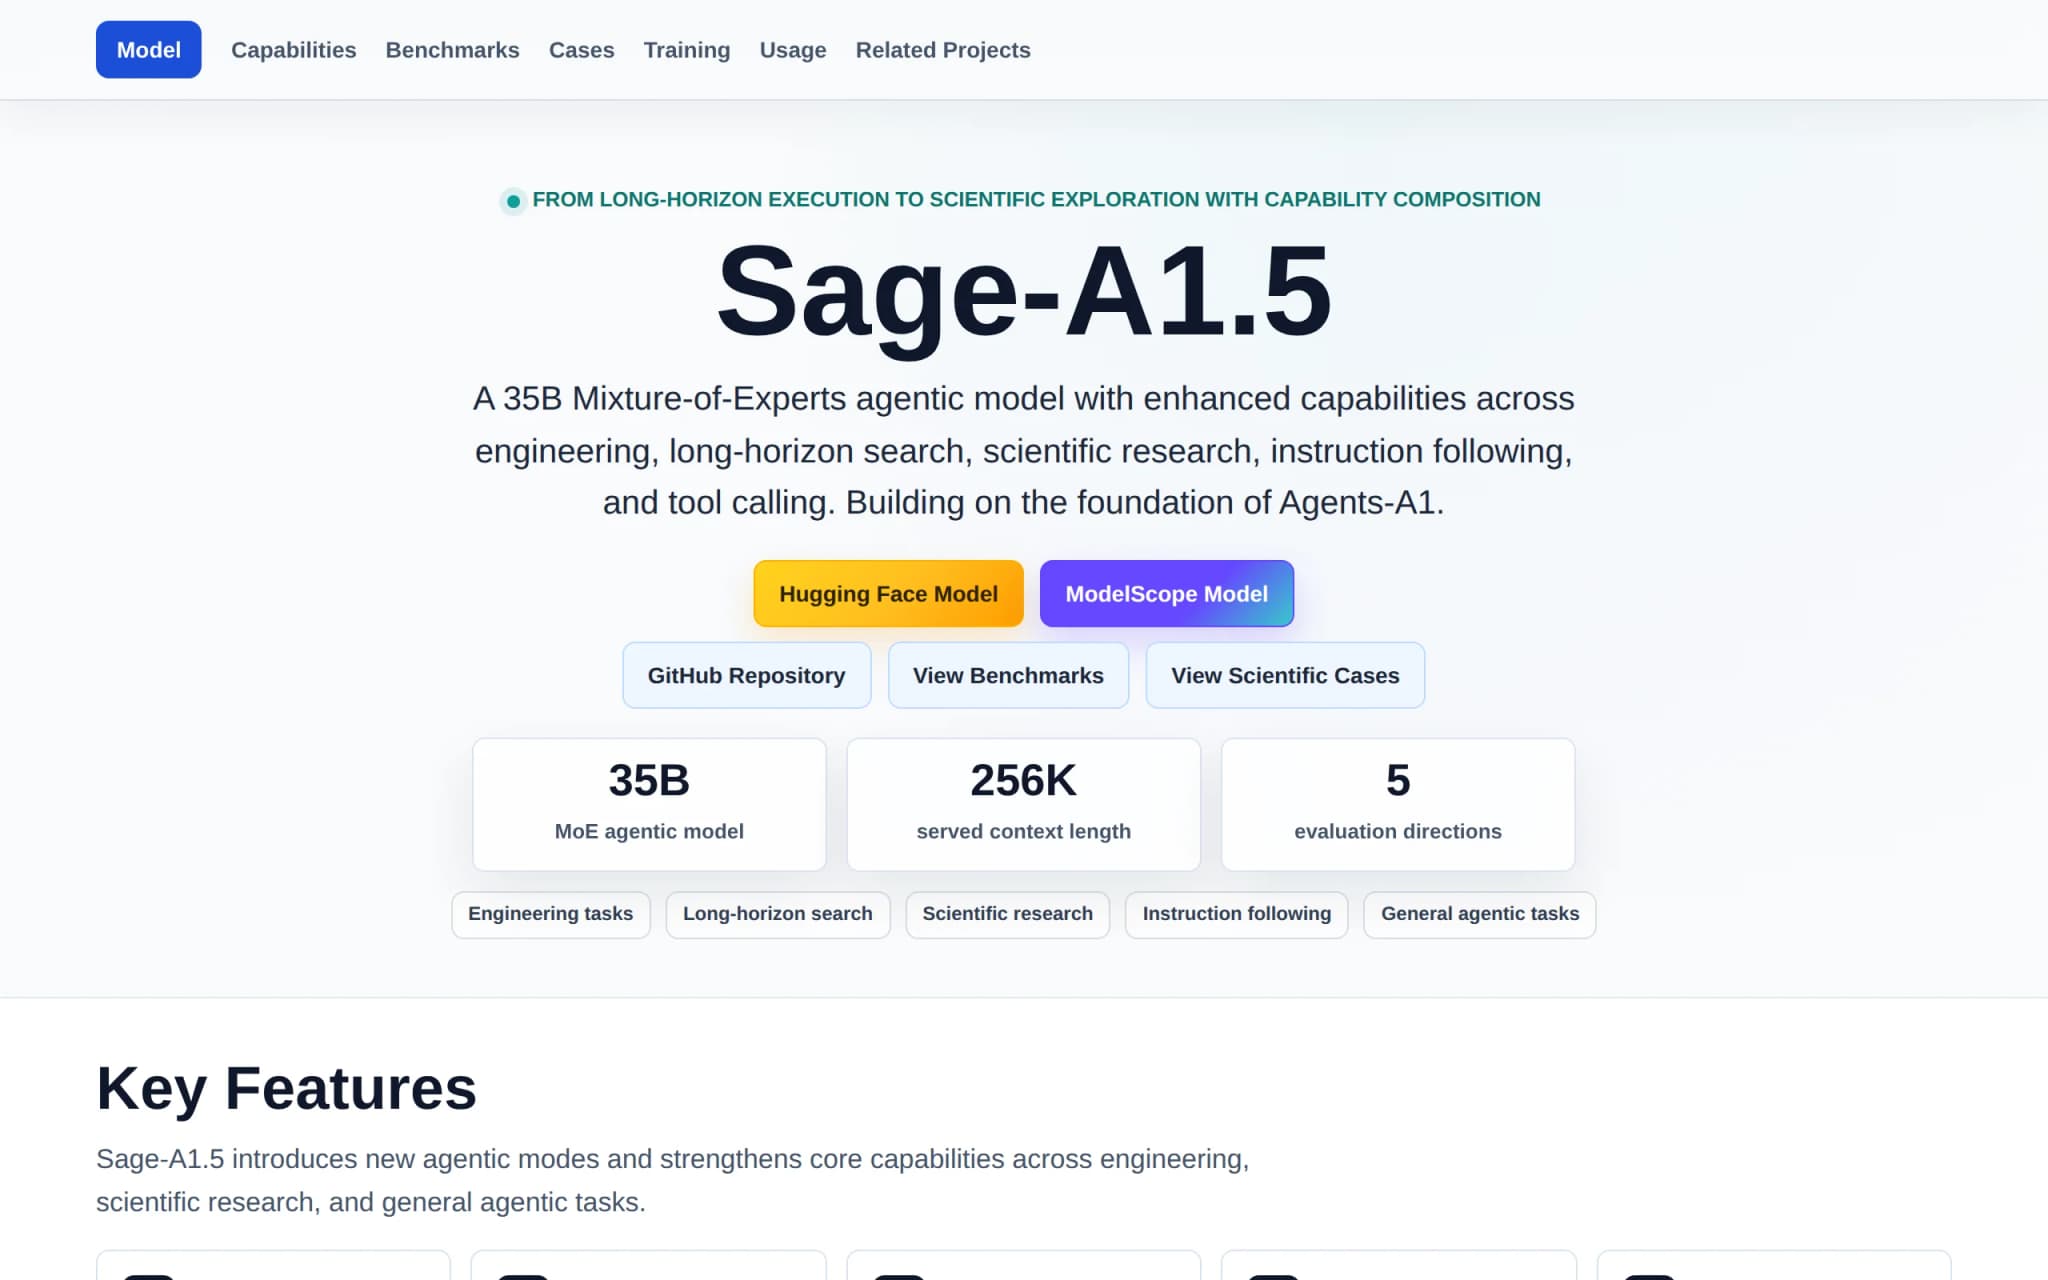
书生-A1.5 – 上海 AI Lab 开源的通专融合科学智能体
书生-A1.5(Sage-A1.5)是上海人工智能实验室推出的 35B 规模通专融合科学智能体,基于 Agents-A1 长程任务能力与书生·端砚科学发现平台构建,面向真实科研场景验证 RSI(Researcher-Scientist-Investigator)闭环。该模型能够自主拆解复杂科研任务、编排多个子智能体并行调研,并触发校验机制识别证据缺口、修正研究假设。书生-A1.5 已覆盖脑科学、电...
WorkForge – 腾讯联合复旦推出的智能体训练环境构建框架深度评测
WorkForge是腾讯混元与复旦大学联合推出的智能体训练环境构建框架,旨在解决当前智能体训练中高质量长程任务数据稀缺的核心瓶颈。该框架从专家工作流蓝图出发,通过获取智能体自动检索真实世界资源搭建工作区,基于工作区中的事实锚点生成任务指令与双重验证标准,让智能体在执行过程中产出可追溯的轨迹数据。目前WorkForge已建成16.7K个可验证环境,横跨40个专业领域,可将35B模型的GDPval得分...
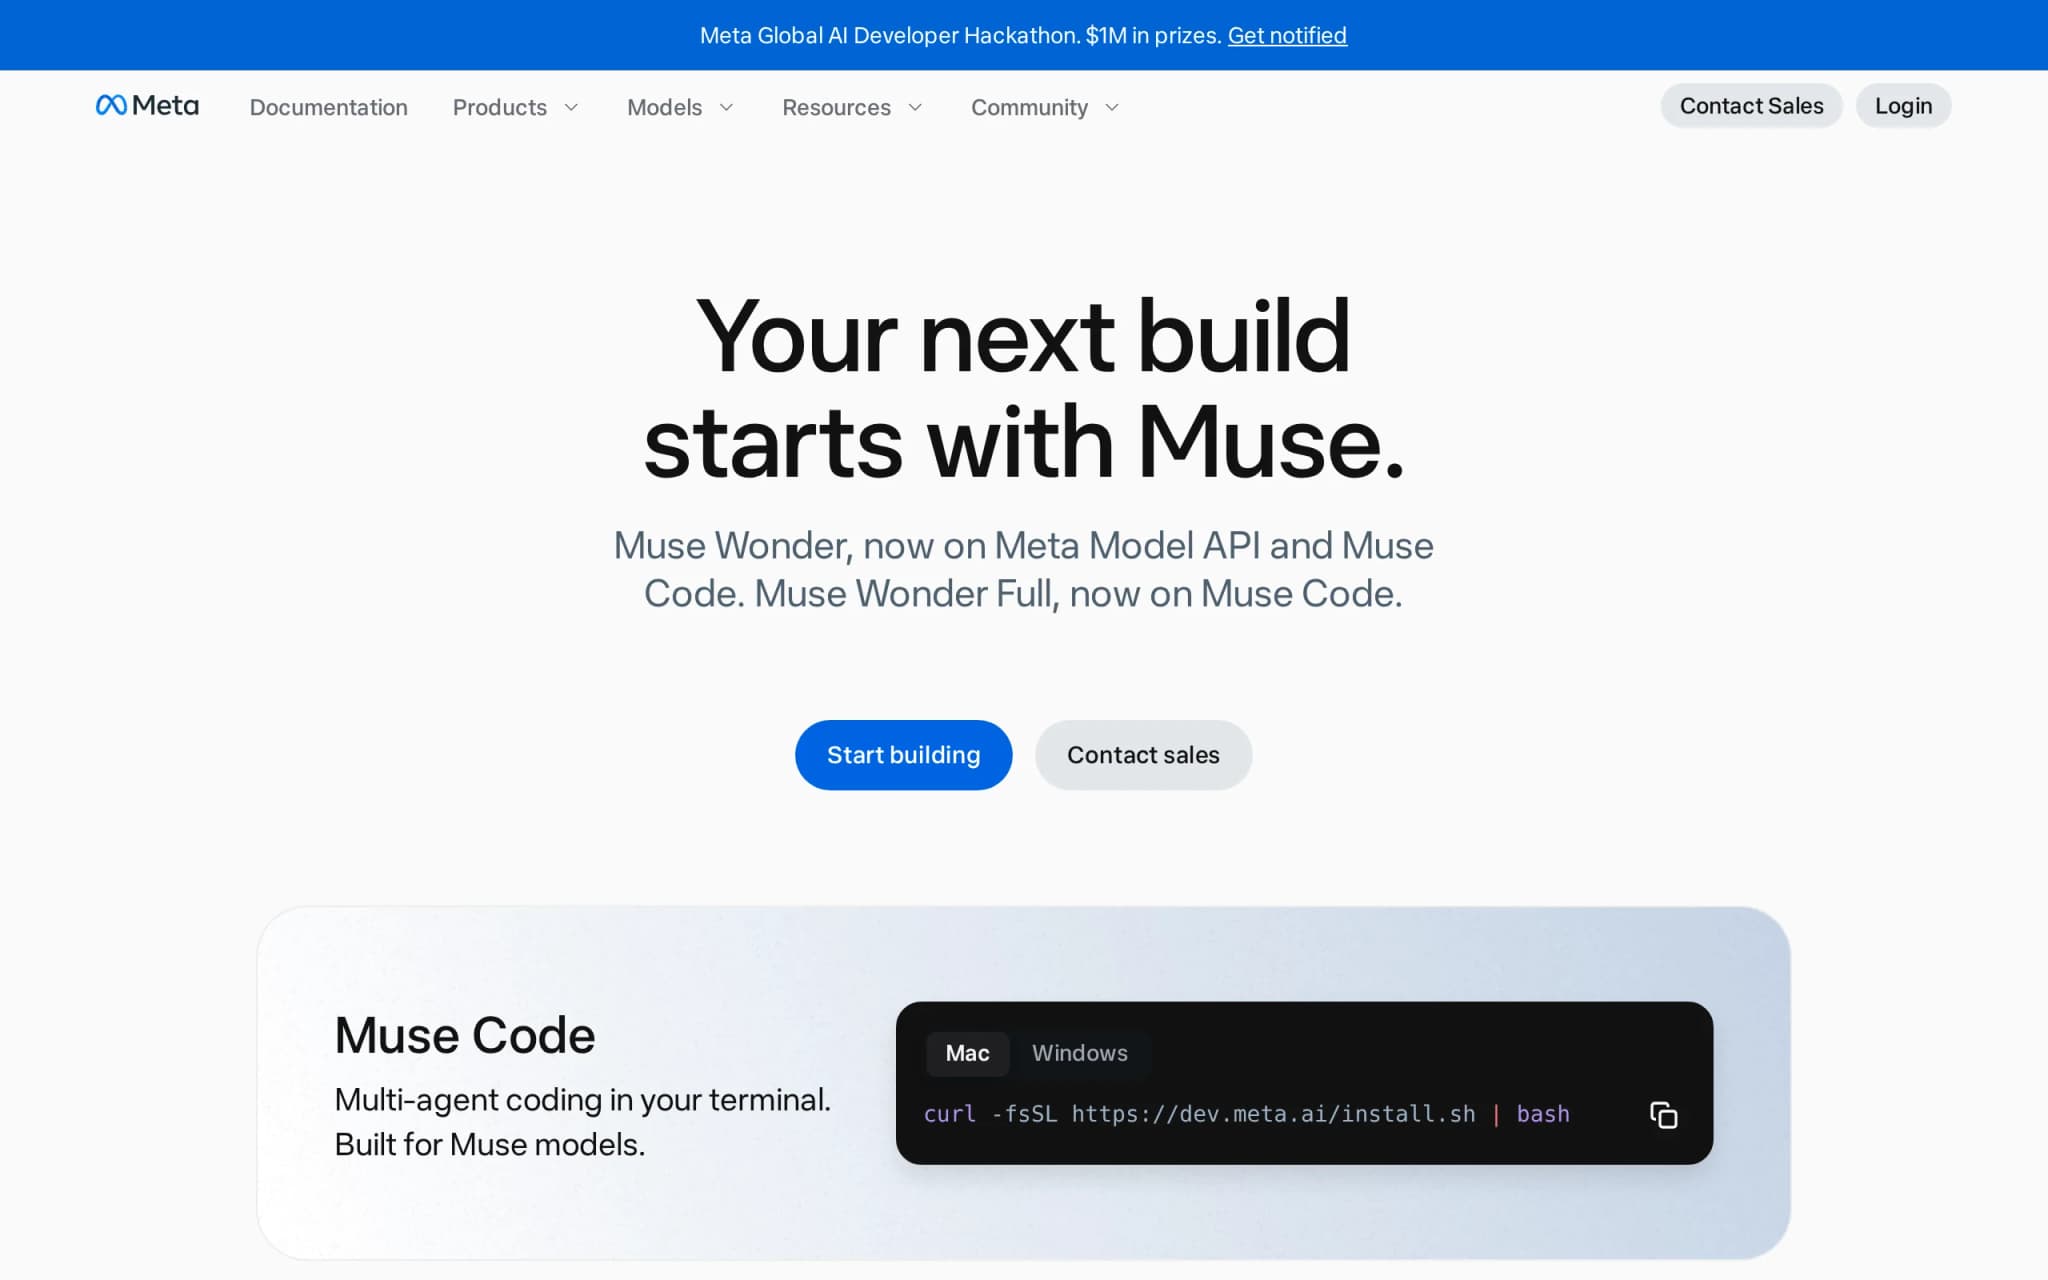
Muse Wonder – Meta 超级智能实验室推出的前沿模型系列
Muse Wonder 是 Meta 超级智能实验室推出的前沿模型系列,建立在 Muse Spark 基础之上,具备跨对话长期记忆与自主坚持长任务的能力。该模型在遇到执行障碍时会主动更换方案,并在重要操作前先与用户确认,覆盖保险理赔、法律金融等专家场景及编程任务。模型分为标准版与完整版两个版本,标准版通过 Meta API 和 Muse Code 开放,完整版仅面向 Muse Code 订阅用户。...
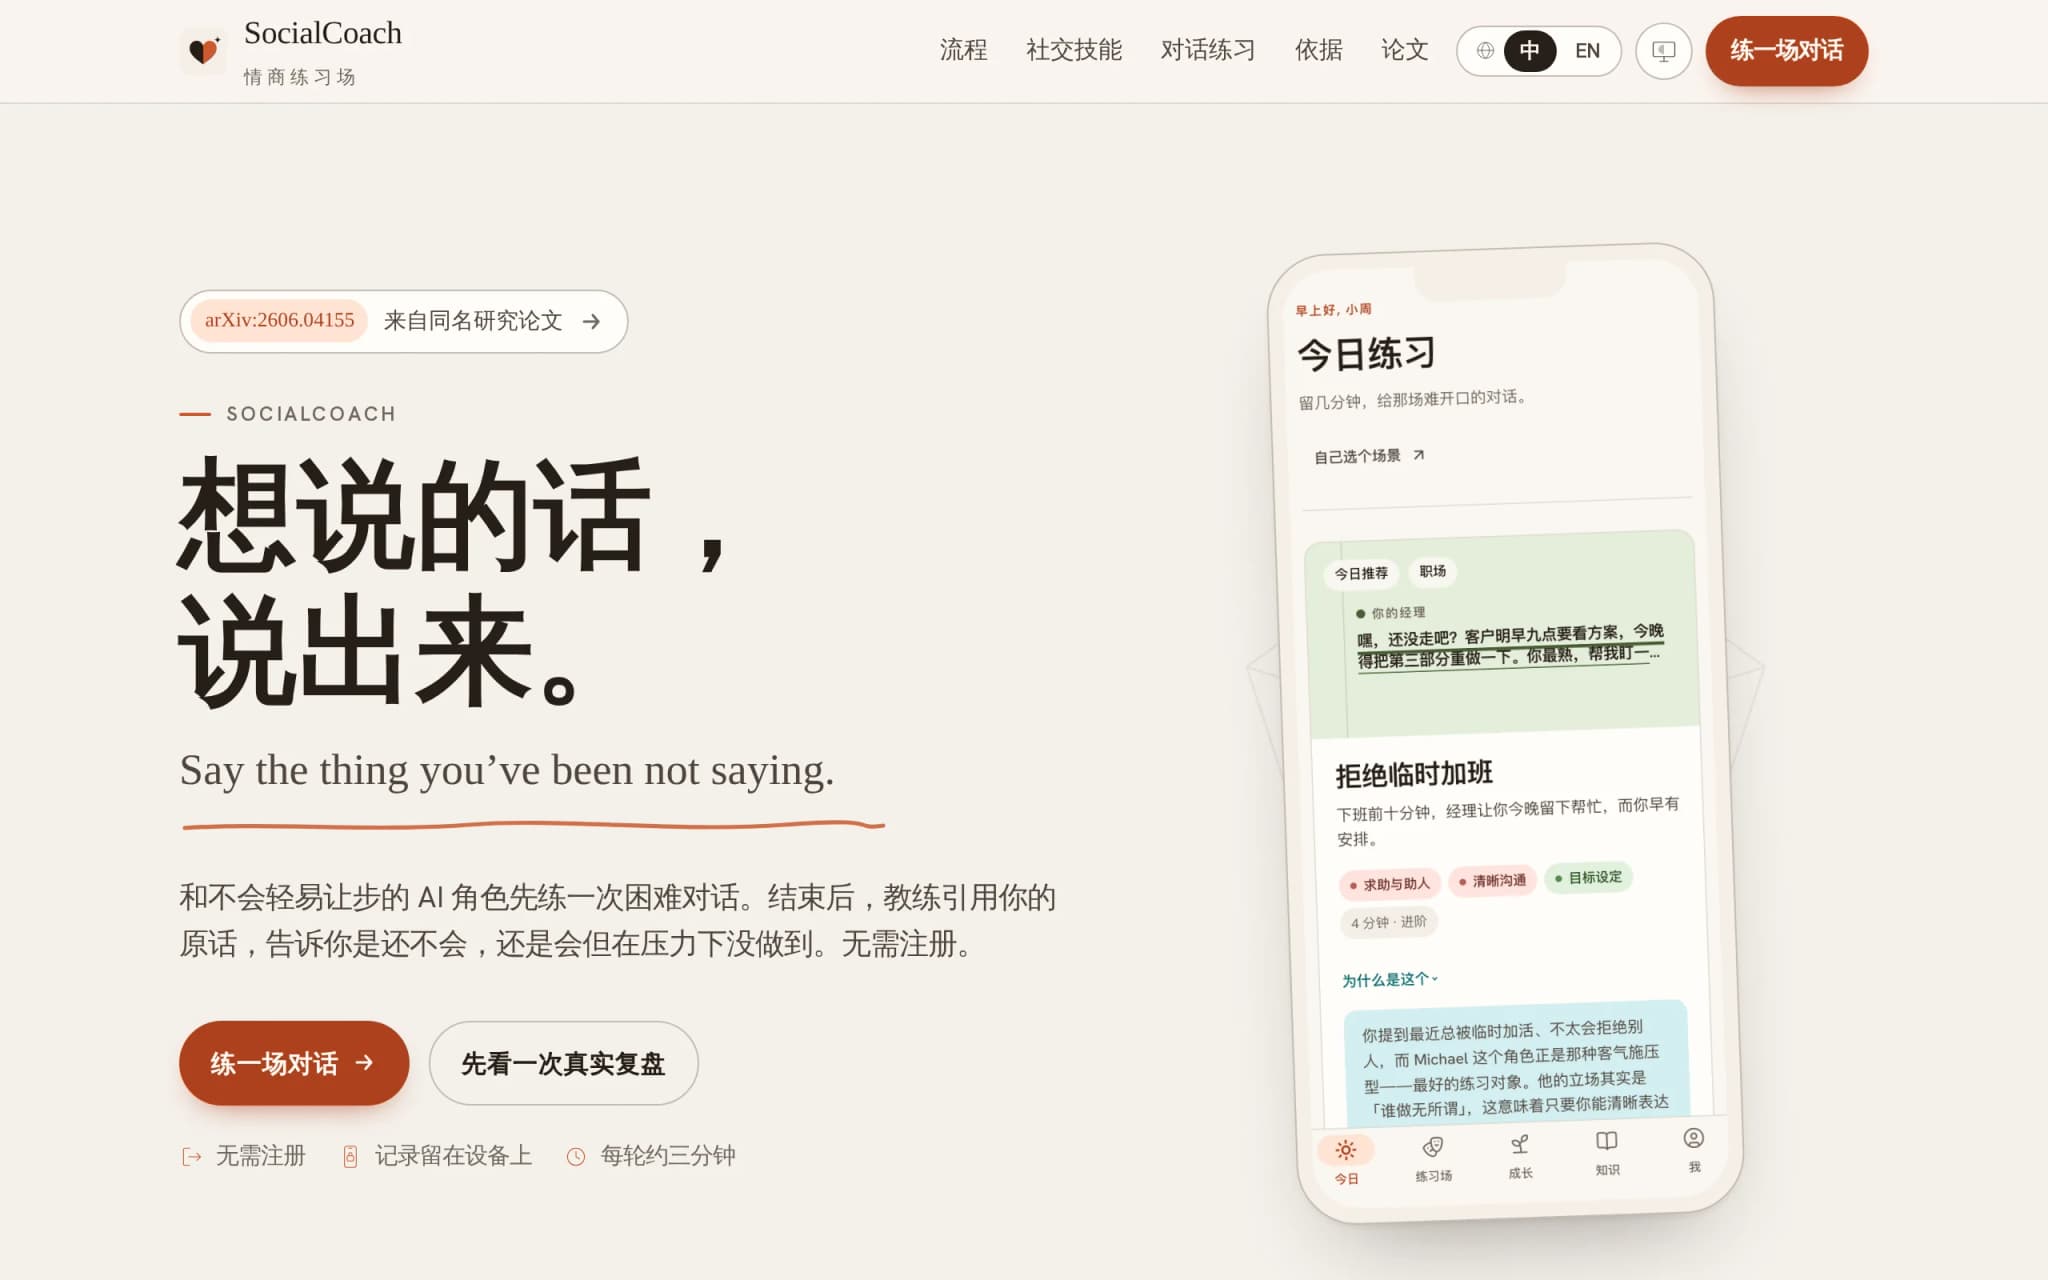
SocialCoach – 港科大联合微软研究院开源的 AI 情商教练
SocialCoach是由香港科技大学(广州)与微软亚洲研究院联合开源的一站式AI社交沟通训练工具,专注于解决人们在提加薪、催还钱、拒绝不合理请求等“难开口”对话场景中的沟通焦虑与技巧不足。该项目基于CASEL社会情感学习框架,内置46个覆盖职场、人际、家庭等7大领域的预设训练场景,并采用强化学习算法针对用户的34项社交技能熟练度进行个性化练习调度。训练过程中,用户会与带有明确目标和情绪底线的AI...
TeleOCR – 中国电信星辰实验室开源的文档解析模型深度评测
TeleOCR 是中国电信星辰实验室开源的文档解析模型,采用约 1.2B 参数的轻量级视觉语言架构,在单一框架内统一处理数字文档与相机拍摄文档,可将文字、版面、表格、公式和科学图表解析为 Markdown、JSON 等结构化结果。该模型在 OmniDocBench v1.6 榜单中登顶,同时获得 PureDocBench 榜首和 ICDAR-2026 科学图解析挑战赛冠军,支持本地 GPU 部署,...
Grok 4.7 深度评测:SpaceXAI 旗舰级编码与知识工作模型全面解析
Grok 4.7 是 SpaceXAI 于 2026 年推出的最新旗舰级大语言模型,定位为最强的编码与知识工作专用模型,旨在解决长时程复杂任务中模型易跑偏、上下文管理困难等核心痛点。相较前代 Grok 4.6,该版本换用了更大的基座模型,并引入自我验证机制、Harness 原生理解与新一代安全护栏,在 CursorBench、Terminal-Bench、法律及电气工程等专业基准测试中均有显著提升...
Spark-Audio-1.0-Preview – 科大讯飞推出的全国产语音基座大模型
Spark-Audio-1.0-Preview是科大讯飞推出的全国产语音基座大模型,采用0.65B音频编码器与30B-A3B MoE语言模型架构,基于1300万小时音频及大量文本数据在纯国产算力集群上训练完成。该模型能够直接解析语音中的语义、情绪与场景信息,支持99种语言和202种方言的识别,以及语音转写、翻译、说话人识别、情感分析、音频问答等多种任务,在高噪声、小音量等复杂场景中表现出领先优势,...
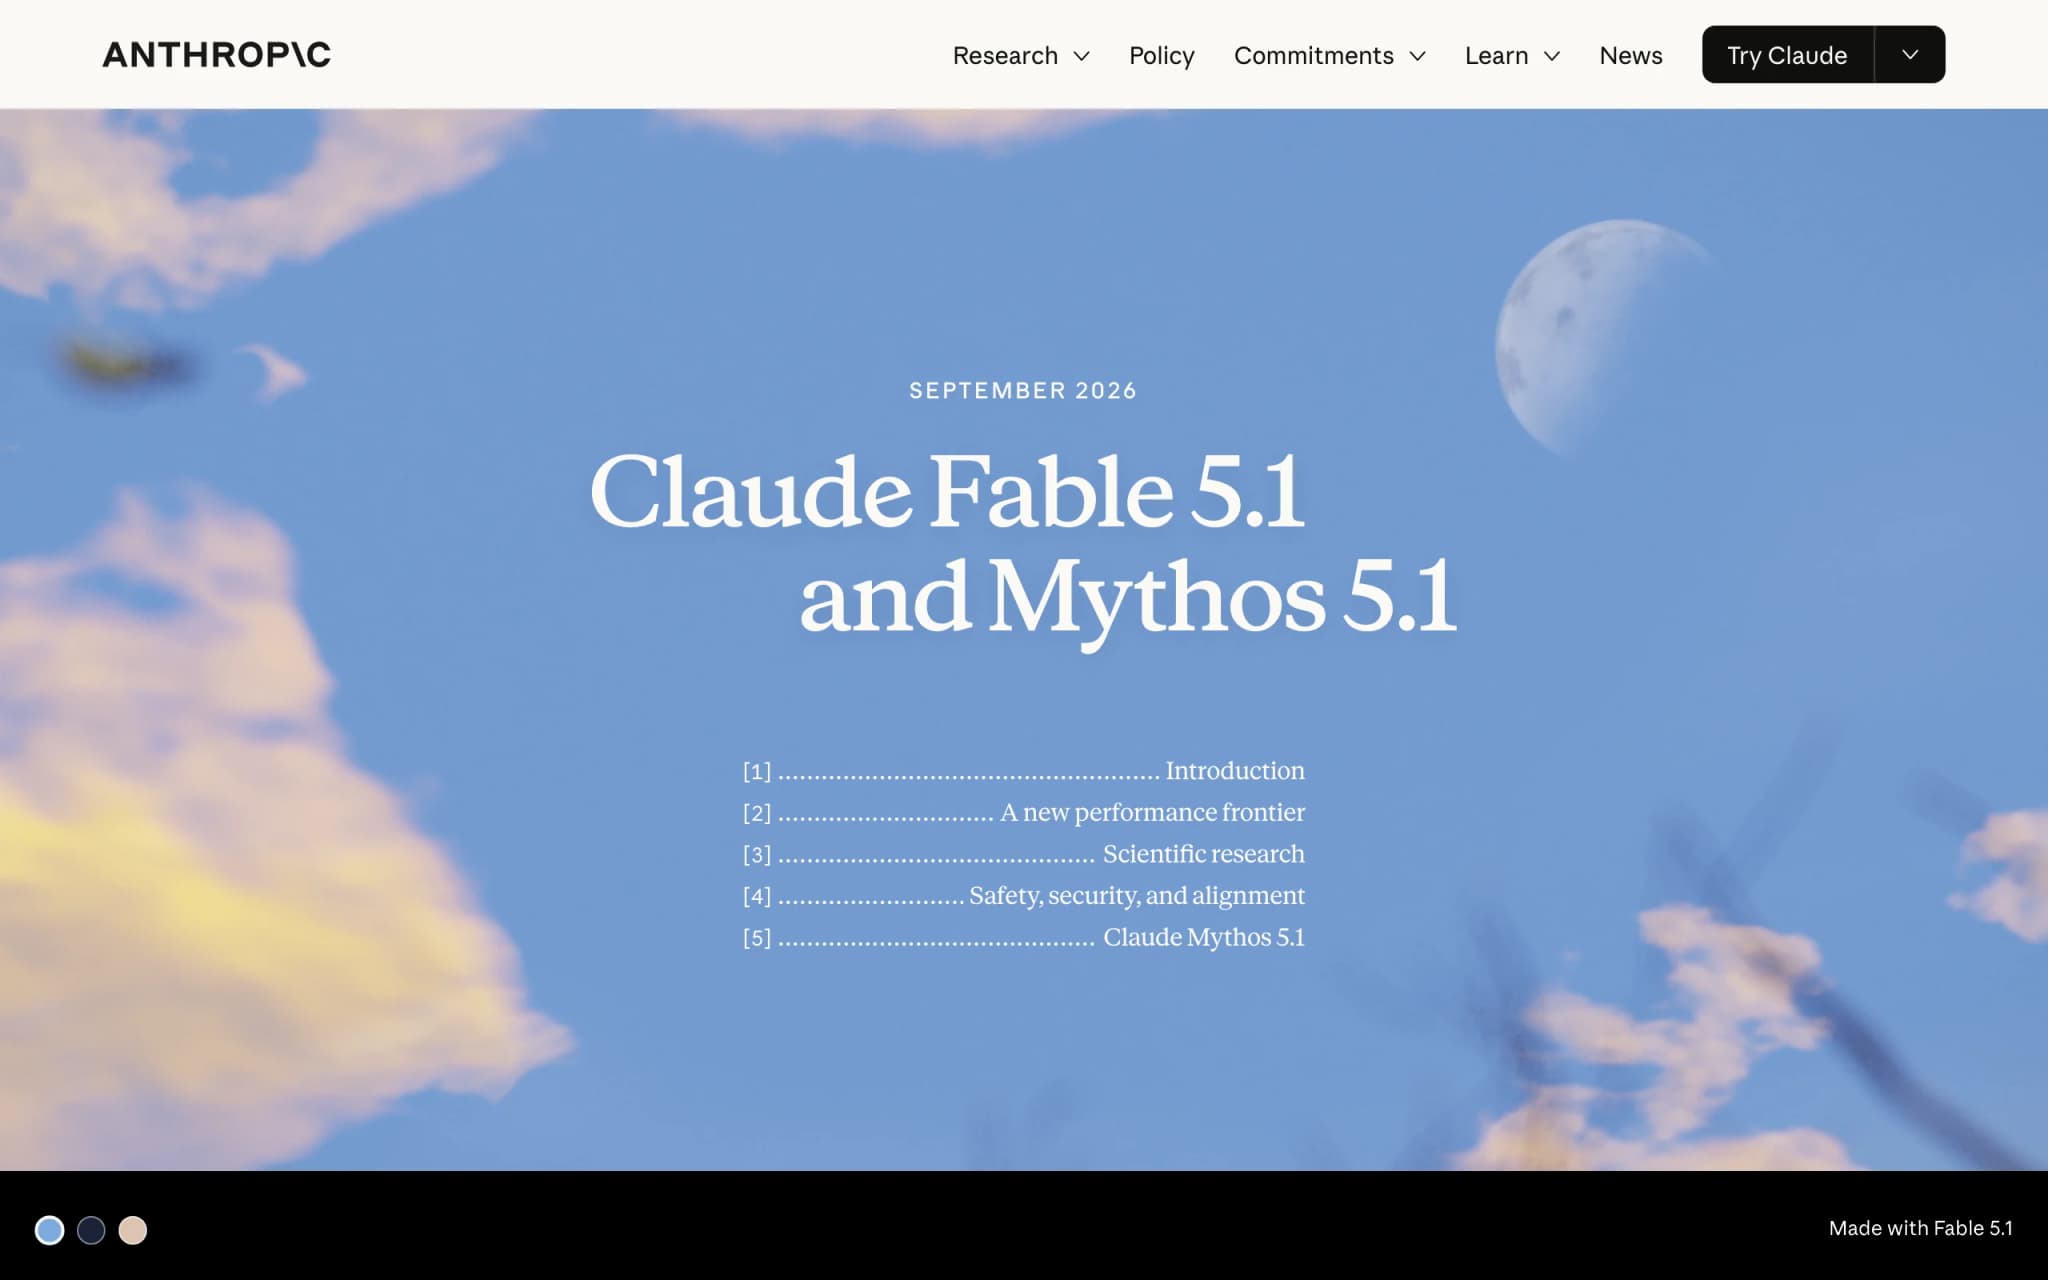
Claude Fable 5.1 – Anthropic 推出的旗舰大模型深度评测
Claude Fable 5.1 是 Anthropic 推出的旗舰大模型,定位为公开可用的高性能 AI 系统之一。模型专为复杂推理、长周期 Agent 任务和知识工作设计,在科学研究、编码、计算机操作等 8 项基准测试中全面领先上一代,且低推理档位即可达到前代高档位性能。同时缓存读取成本降低 75%,典型工作负载成本下降约 25%,高度 Agent 化任务最高省 45%,实现更强性能与更高性价比...
Claude Mythos 5.1 – Anthropic 推出的 Claude 系列旗舰模型
Claude Mythos 5.1 是 Anthropic 推出的 Claude 5.1 系列旗舰模型,与同系列公开版 Claude Fable 5.1 共享完全相同的底层模型权重与推理能力,仅通过上层安全围栏策略实现能力释放程度的差异化控制。该模型专为网络安全与生命科学两大高风险专业领域设计,仅面向通过背景审查的科研机构开放,支持漏洞防御、蛋白质分子设计等前沿研究,用户须通过 Cyber Ver...