
AI 资讯速递 (2026/7/31): 腾讯混元团队开源 AngelSpec:端到端推测解码训练框架
导读摘要:
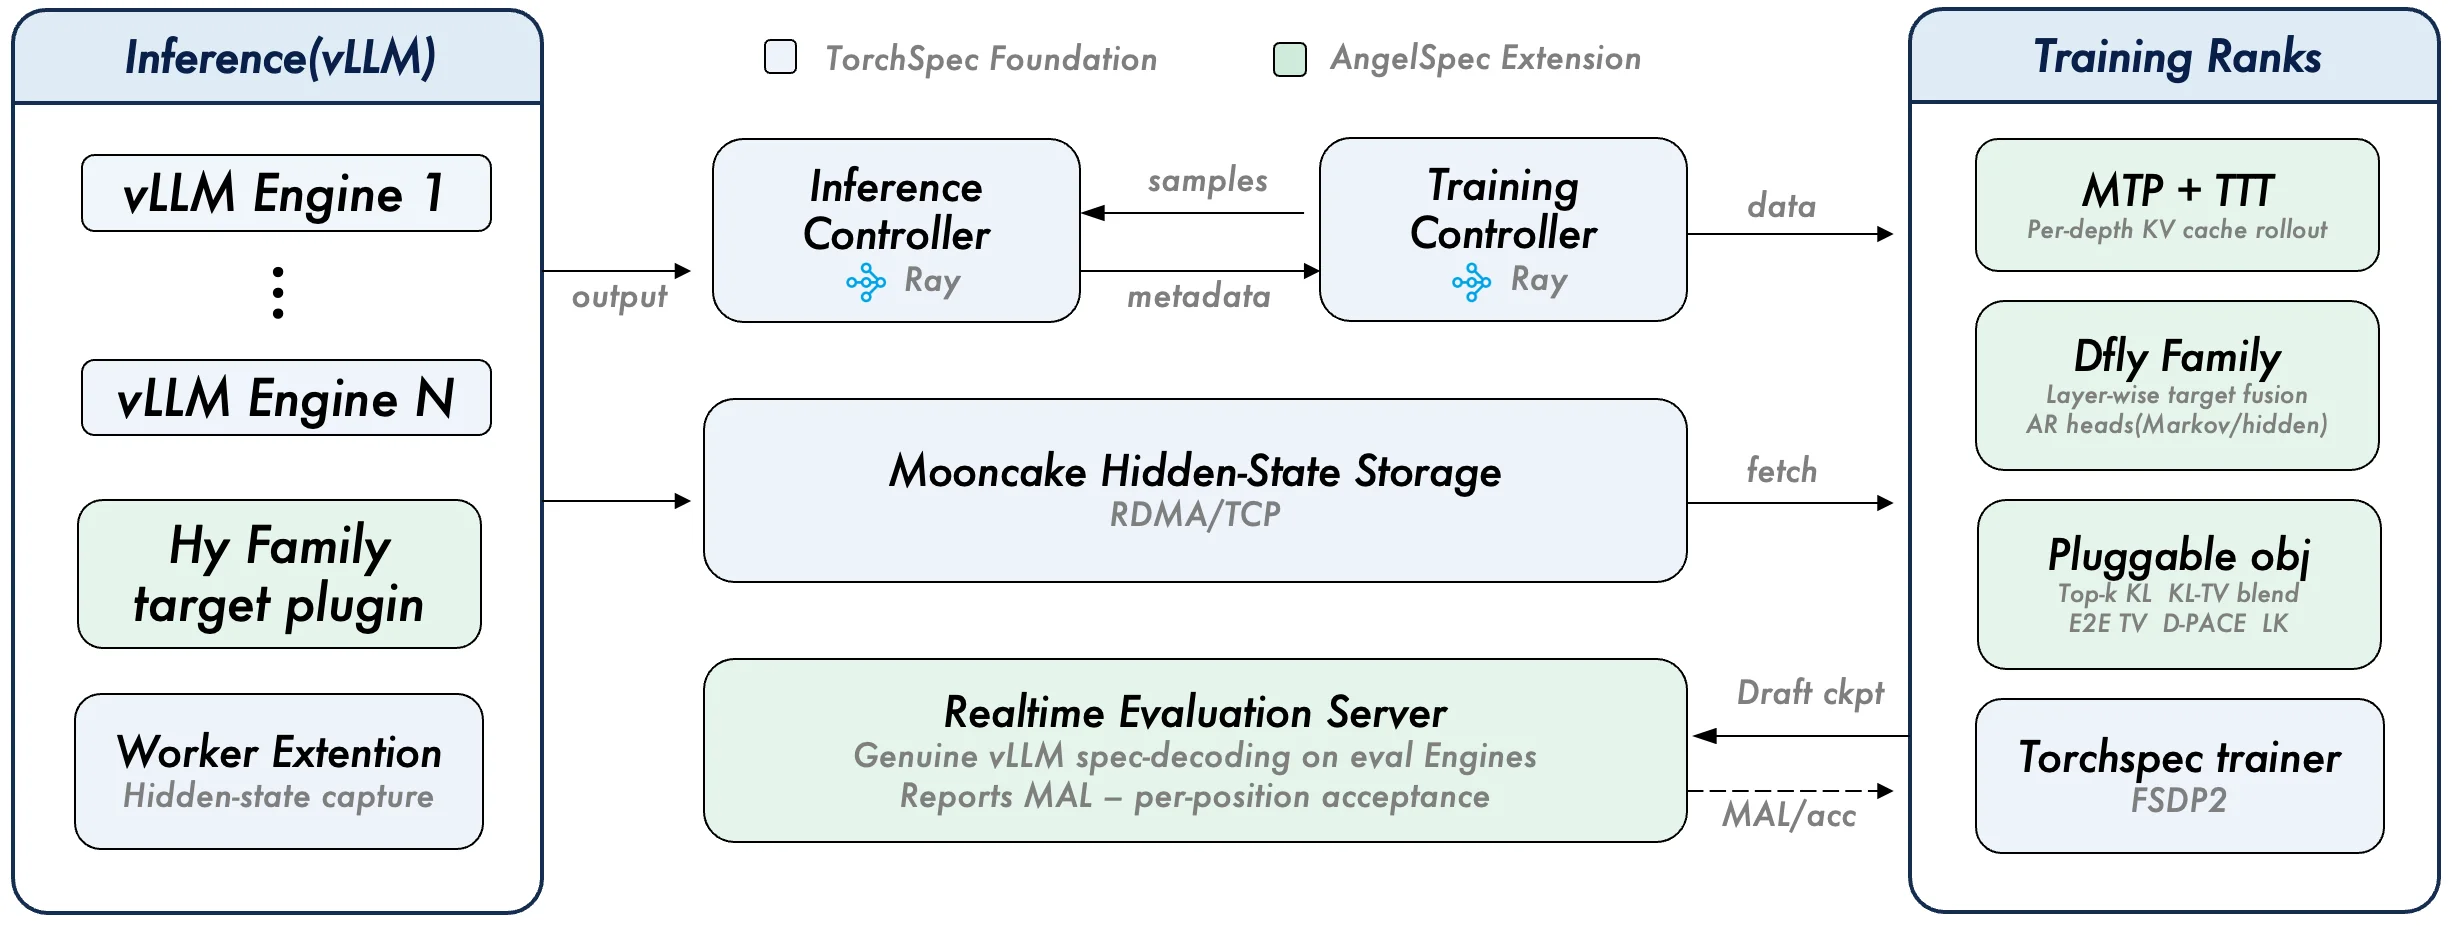
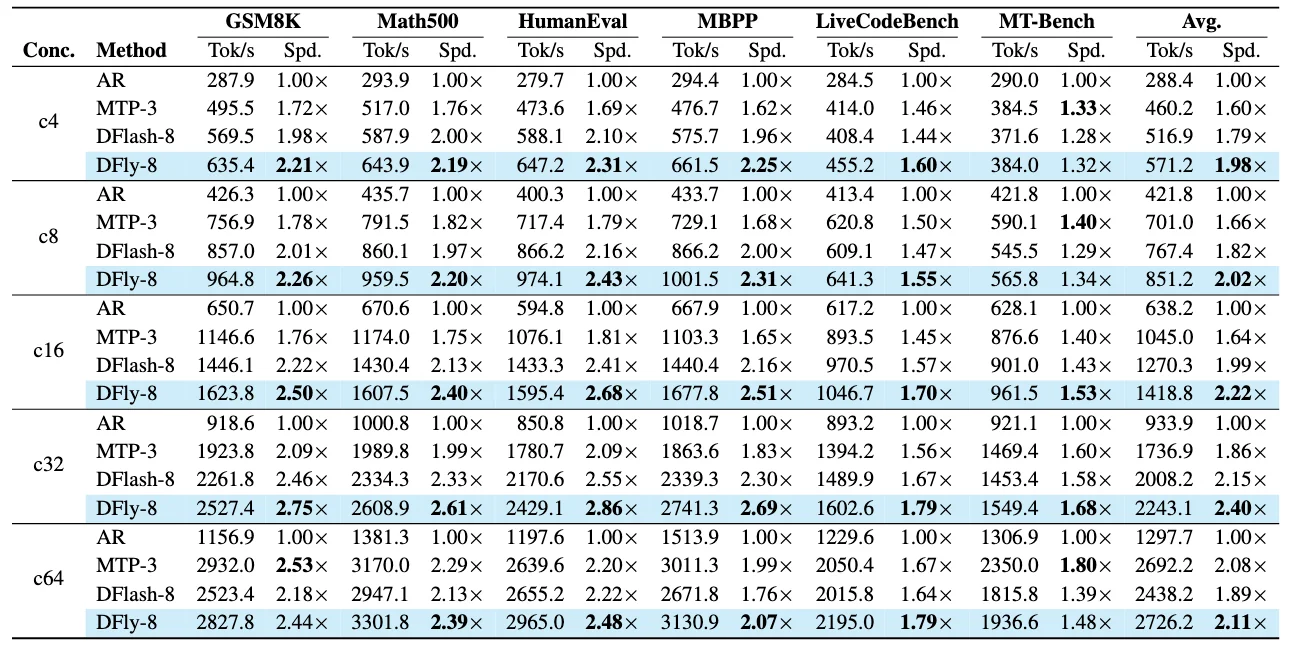
腾讯混元团队近日开源了 AngelSpec,一个基于 TorchSpec 构建的端到端推测解码训练框架。该框架将推理与训练解耦,推理引擎通过 Mooncake/RDMA 向训练工作器流式传输隐藏状态,支持 MTP 自回归与 DFly 块并行共 6 种草稿架构的统一训练。据 arXiv 预印本披露,在 Hy3-A21B 模型上,DFly 草稿实现了 1.98–2.40 倍的端到端加速,吞吐量较 DFlash 提升 10.5–11.8%。项目已同步释放框架代码、Hy3-A21B 与 Qwen3-8B 的 MTP 及 DFly 草稿权重、训练配置与技术报告。
发布概述
腾讯混元团队近日开源了 AngelSpec,一个基于 TorchSpec 构建的端到端推测解码训练框架。该框架将推理与训练解耦,推理引擎通过 Mooncake/RDMA 向训练工作器流式传输隐藏状态,支持 MTP 自回归与 DFly 块并行共 6 种草稿架构的统一训练。据 arXiv 预印本披露,在 Hy3-A21B 模型上,DFly 草稿实现了 1.98–2.40 倍的端到端加速,吞吐量较 DFlash 提升 10.5–11.8%。项目已同步释放框架代码、Hy3-A21B 与 Qwen3-8B 的 MTP 及 DFly 草稿权重、训练配置与技术报告。
图片来源为官方文章
核心特性
AngelSpec 将六种推测解码草稿架构——DFly、DFlash、DFlare、Eagle3、DSpark 和 MTP——纳入同一训练流水线,切换仅需修改配置。其中 MTP 草稿器采用共享参数的多深度自回归展开训练,内存开销接近单次因果前向,并通过 Ulysses 序列并行支持最长 128k 上下文。
图片来源为官方文章
在训练优化方面,框架提供了丰富的接受率对齐目标函数,包括 CE、top-k KL、LK Loss、D-PACE 加权及端到端 TV 损失,可通过配置自由组合。同时实现了文档感知序列打包,采用 Megatron 风格固定长度打包并严格跨文档隔离,覆盖 DFlash 与 MTP 路径。
AngelSpec 还内置了在线真实评估机制:训练期间通过 vLLM 等推理引擎执行真实的推测解码,实时报告平均接受长度与逐位接受率。推理后端兼容 vLLM、SGLang、HuggingFace 等主流引擎。
快速上手
AngelSpec 已开源至 GitHub,并提供了完整的安装与使用指南。环境安装执行 pip install -e ".[vllm]" 与 pip install mooncake-transfer-engine。单节点快速启动示例:将 8 张 GPU 划分为 4 张推理 + 4 张训练,运行 ./examples/qwen3-8b-dfly/run.sh 即可启动完整流水线。配置可通过 CLI 直接覆盖 YAML 项,例如 training.learning_rate=5e-5 training.num_train_steps=500。Conda 环境可通过 ./tools/build_conda.sh 1 vllm 一键构建。多节点部署则通过 Inference Controller 与 Training Controller 经 Ray 调度,结合 Mooncake 隐藏状态存储实现跨节点解耦训练。开源许可证类型、训练所需 GPU 具体型号等细节尚未公布。
资料来源与项目地址
- 项目官网:https://angelspec.readthedocs.io/
- GitHub 仓库:https://github.com/Tencent/AngelSpec
- HuggingFace 模型库:https://huggingface.co/collections/AngelSlim/angelspec
- arXiv 技术论文:https://arxiv.org/pdf/2607.25852
