
AI Model Library: LLMs, Agents & Dev Tools
Curated reviews of mainstream AI models, agents, and dev tools — capabilities, use cases, and how they compare.
Tag: Multimodal
194 article(s) found · Clear tag
豆包音频生成模型1.0 – 火山引擎推出的端到端音频创作模型
豆包音频生成模型1.0(Seed-Audio 1.0)是火山引擎推出的端到端音频创作模型,支持文本或音频作为参考输入生成目标音频。模型单条Prompt可编排多角色对白、情绪语气、背景音乐与环境氛围,直接产出具备叙事张力的完整音频作品,无需后期多轨混音。模型在长时生成中保持音色高度一致,支持音色与风格解耦控制,覆盖有声剧、播客、品牌音频等场景。
JoyAI-VL-Interaction – 京东开源的实时视频视觉语言交互模型
JoyAI-VL-Interaction是由京东Joy Future Academy开源的实时视频视觉语言交互模型,是全球首个全栈开源的interaction模型系统。该模型突破了传统AI助手的轮询问答范式,实现了“边看边说”的主动交互能力——可持续观察视频流、自主判断何时发声、实时响应画面变化,并支持将复杂任务委托给后台Agent处理。在58项真人盲评中,对比豆包视频通话助手胜率77.6%,对比...
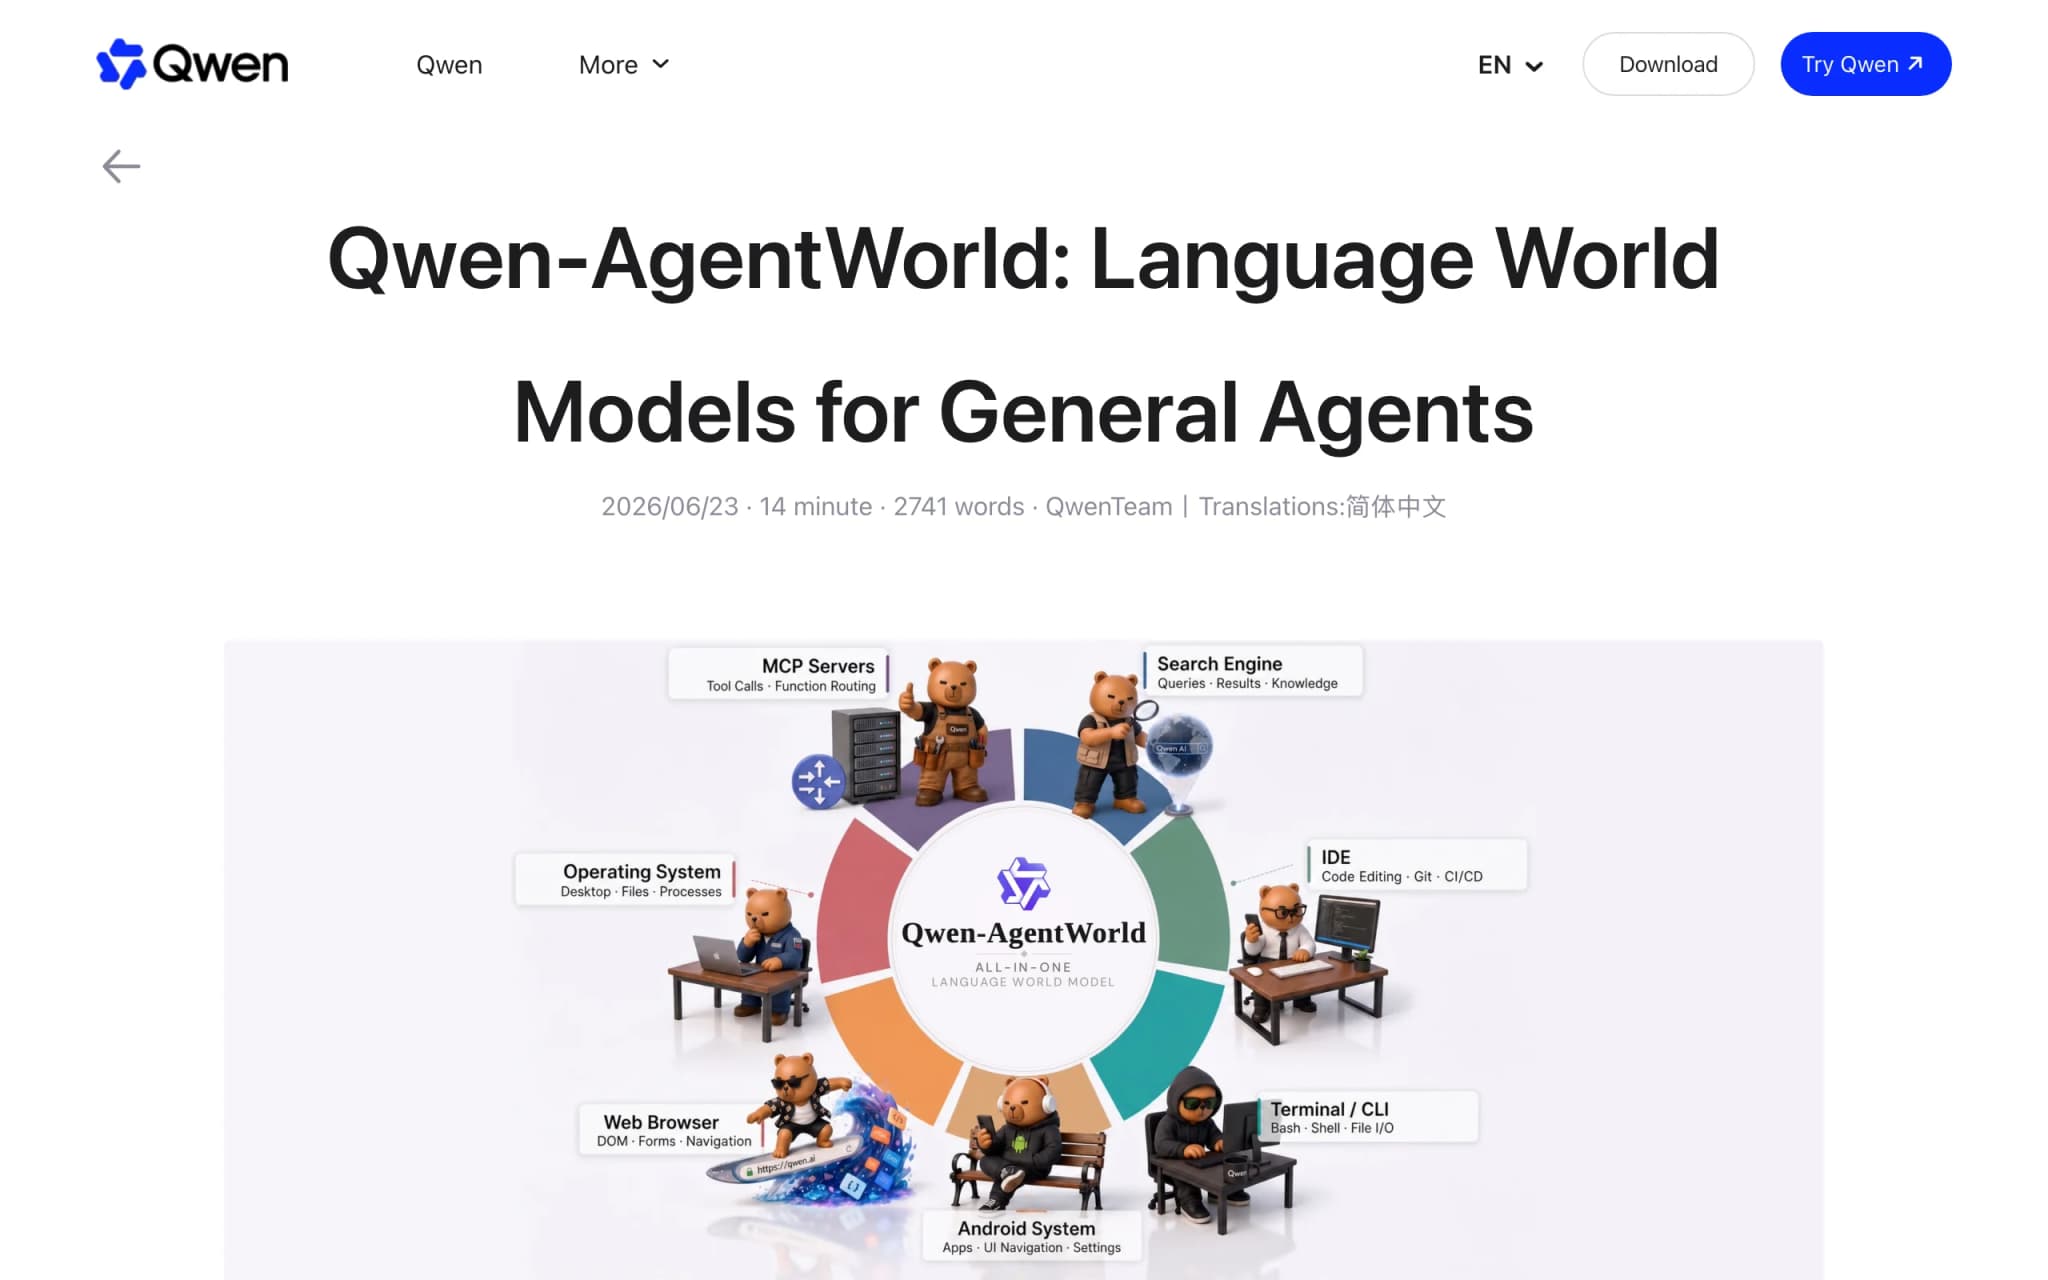
Qwen-AgentWorld – 通义千问推出的原生语言世界模型
Qwen-AgentWorld是通义千问团队推出的首个原生语言世界模型(Language World Model, LWM),旨在通过纯文本推理模拟多种智能体交互环境。该模型能够模拟MCP工具调用、搜索引擎、Linux终端、软件工程、Android GUI、Web浏览器和操作系统共7大智能体环境,为AI Agent的训练与评估提供高度可控、可扩展的虚拟环境。模型基于1000万以上的真实交互轨迹,采...
MMSkills – 上海交大与小红书联合推出的多模态技能框架
MMSkills是由上海交通大学与小红书联合研发的多模态技能框架,专为通用视觉Agent设计。该框架将传统纯文本技能扩展为包含文本流程、运行时状态卡片和多视角关键帧的多模态程序性知识单元,并通过Branch Loading机制在运行时高效调用视觉证据,避免一次性注入完整上下文造成决策污染。在OSWorld、macOSWorld、VAB-Minecraft等GUI与游戏任务上,MMSkills为Ge...
PhoneBuddy – 腾讯混元开源的 4B 参数手机 Agent 模型
PhoneBuddy 是由腾讯混元团队开源的一款 4B 参数手机 Agent 模型,核心研究如何在真实手机场景中训练可用的 AI Agent。该模型采用“真实 App + Mock App 混合强化学习(RL)”训练方案,在 150 个真机评测任务中,单 App 和微信小程序任务成功率均超过 GPT-5.4,AndroidWorld 基准测试达到 83.2%,证明小参数模型通过环境设计优化可具备与...
MaineCoon – AI 实时音视频世界模型,专为社交互动场景
MaineCoon是全球首个专为社交互动场景优化的实时音视频自回归世界模型,拥有220亿参数,能在单GPU上实现47.5 FPS的实时流式生成,支持亚秒级交互响应与千秒级连续音视频生成。不同于传统聚焦于物理环境模拟或游戏探索的世界模型,MaineCoon首次将世界模型的视角转向以人为中心的社交动态场景,通过自重采样、跨模态表示对齐、领域感知偏好优化等创新技术,为下一代AI原生社交平台的构建奠定了关...
EchoBird – 开源 AI Agent 桌面管理工具
EchoBird 是一款开源的 AI Agent 桌面管理工具,采用 Tauri + Rust 架构开发,旨在将命令行驱动的 AI 编程智能体(如 Claude Code、Codex、OpenClaw 等 12 款以上工具)的安装、配置与运行过程,通过图形化界面进行统一管理。该工具通过其核心组件 Model Nexus 模型中心,实现了 API Key、Base URL 等模型参数的统一配置和共享...
LOGOS – 阿里开源的首个统一科学大模型
LOGOS(Language Of Generative Objects in Science)是阿里 ATH-Token Foundry 联合中国人民大学高瓴人工智能学院开源的首个统一科学语法多领域科学生成基础模型。该模型创新性地将蛋白质、小分子、材料、抗体等异构科学对象编码为统一的 Token 序列,基于纯序列建模范式,在口袋配体生成、逆合成预测、蛋白质编辑、材料生成等六大科学任务上一致性匹配...
Grok Imagine Video 1.5 – xAI 推出的图生视频模型
Grok Imagine Video 1.5 是由 xAI 推出的新一代图生视频模型,基于自研 Aurora 自回归引擎构建。该模型支持用户上传单张静态图片,通过自然语言提示一键生成带原生同步音频的短视频,最高支持 720p 分辨率。在 Fast 模式下,生成一段 6 秒 720p 视频仅需约 25 秒,显著提升了内容创作效率。模型在 Arena.ai 图生视频榜单中排名第一,Elo 评分约 13...
ACE-Ego – 大晓机器人联合港中文开源的具身操作 VLA 模型
ACE-Ego是由大晓机器人联合香港中文大学MMLab共同开发的开源一脑多型具身操作VLA模型。该模型以6.0K+小时人类第一视角视频为核心进行预训练,通过相机空间动作与形态条件编码,使同一模型可适配不同机器人本体。在RoboCasa GR1 TableTop基准上以72.8%刷新SOTA,能稳定完成塑料袋打包、鞋盒装鞋等复杂零售操作,大幅降低多本体部署成本。
Subscribe to AI Model Reviews
Get in-depth reviews the moment a new AI model drops. Know its capabilities and use cases.
We never share your email. Unsubscribe anytime.