
AI Model Library: LLMs, Agents & Dev Tools
Curated reviews of mainstream AI models, agents, and dev tools — capabilities, use cases, and how they compare.
Tag: Multimodal
194 article(s) found · Clear tag
Keye-VL-2.0-30B-A3B – 快手开源的自研多模态大模型
Keye-VL-2.0-30B-A3B是快手自主研发并完全开源的多模态大语言模型,基于30B参数规模(采用MoE架构,实际激活参数约3B),首次将DeepSeek Sparse Attention(DSA)稀疏注意力机制引入多模态理解领域。模型支持256K超长上下文窗口,能够对小时级视频进行几乎无损的端到端时序推理,在TimeLens基准测试的多项视频理解指标上超越Gemini-2.5-Pro和G...
AgentScope 2.0 – 通义实验室开源的多智能体开发框架
AgentScope 2.0是由阿里云通义实验室推出的开源多智能体开发框架,专注于解决智能体从实验性Demo向稳定生产环境迁移的工程难题。该框架在设计上采用了Agent-Oriented Programming(面向智能体编程)的哲学,强调智能体的自主性与组织架构,而非简单的对话编排。与市面上多数仅停留在原型验证阶段的多智能体框架不同,AgentScope 2.0通过引入模型容错机制、系统化权限控...
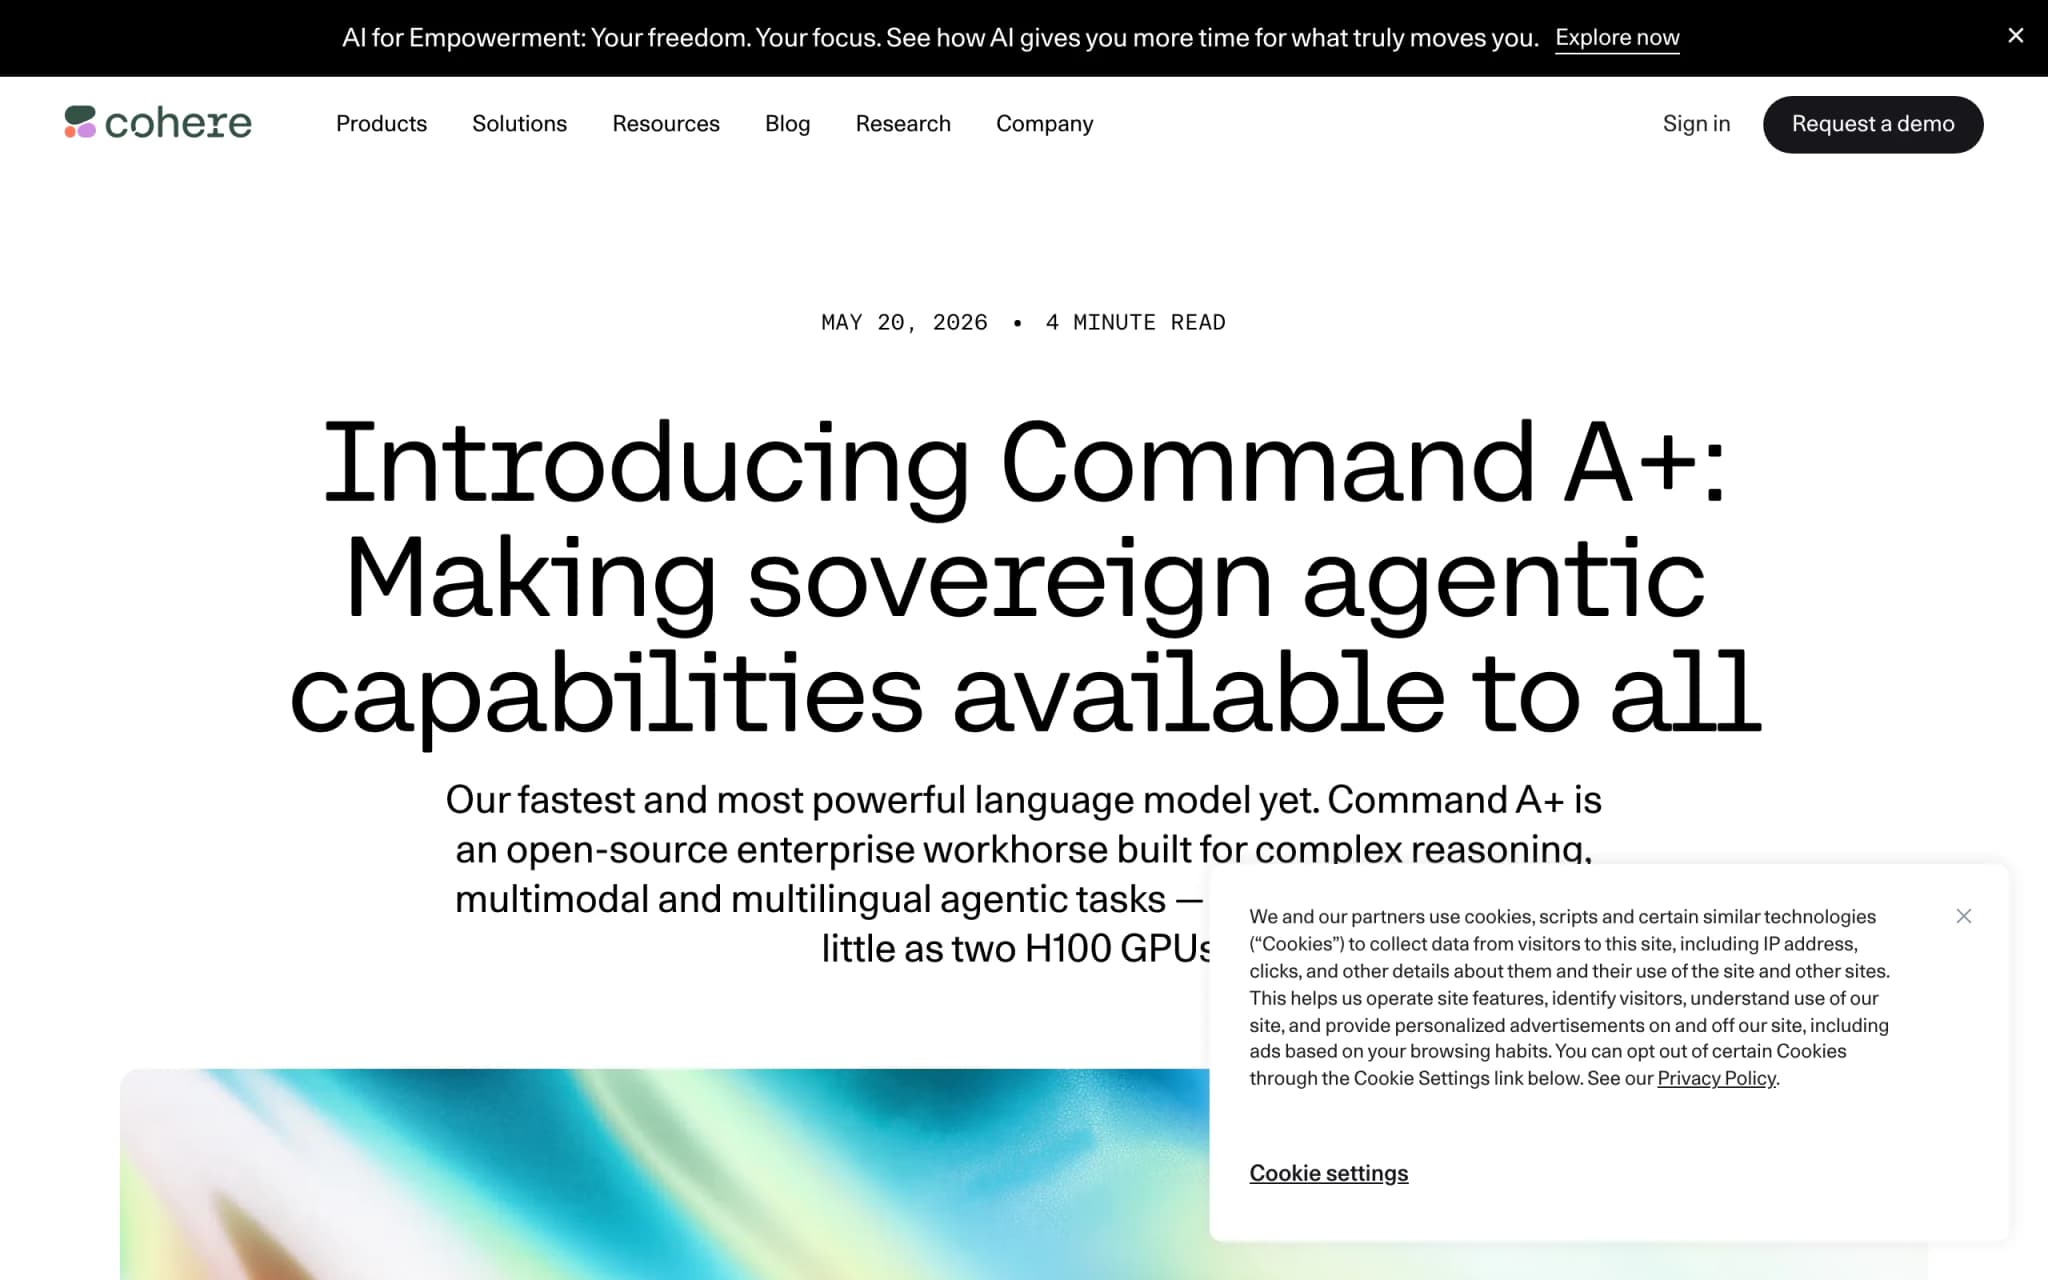
Command A+ – Cohere Labs 开源的多模态大模型
Command A+ 是 Cohere Labs 推出的开源多模态大模型,采用混合专家(MoE)架构,总参数量达 218B,但激活参数仅 25B,在保持强大性能的同时实现了极高的推理效率。该模型原生支持 128K 超长上下文窗口与 48 种语言处理,深度融合了视觉理解、智能体任务执行、复杂推理与机器翻译能力。通过提供三档量化版本(BF16、FP8、W4A4),最低仅需 1 张 B200 或 2 张...
SenseNova-Skills – 商汤团队开源的模块化 AI 办公技能库
SenseNova-Skills 是由 OpenSenseNova(商汤科技)团队开源的一款模块化 AI 办公技能库,专为 Agent 运行时设计,旨在将信息图生成、PPT 制作、Excel 数据分析与深度研究四大核心办公能力拆解为独立、可复用的技能模块。该工具可直接集成到 OpenClaw、hermes-agent 等主流 Agent 框架中,赋予 AI 助手端到端的专业办公执行力,无需在多个 ...
Confucius4 – 网易有道开源的多模态推理模型
Confucius4是网易有道AI团队基于Qwen3.5-27B架构推出的开源多模态大模型,专为高级数学推理场景设计。该模型通过创新的迭代SFT+RL训练范式、纯文本推理数据增强及精细化思维链优化,在同等规模模型中达到SOTA性能,同时实现推理链长度降低43.2%。模型针对中文用户定向优化,输出更符合中文语言习惯与文化背景,支持免费商用。
LongCat-Video-Avatar 1.5 – 美团开源的数字人视频生成模型
LongCat-Video-Avatar 1.5 是美团 LongCat 团队开源的音频驱动数字人视频生成框架,基于 13.6B 参数的基础视频生成模型 LongCat-Video 构建,通过将音频编码器从 Wav2Vec2 升级为 Whisper-Large-v3 实现口型同步精度质的飞跃,并采用 Step Distillation 技术将推理步数压缩至 8 步,支持 480P/720P 分辨率...

HyperEyes – 小红书联合剑桥推出的并行多模态搜索智能体
HyperEyes是小程序与剑桥大学联合推出的并行多模态搜索智能体,它开创性地提出了UGS(Unified Grounded Search)范式,将视觉定位与检索融合为单一原子动作,实现了单轮多实体并发搜索。该模型采用双粒度效率感知强化学习框架(TRACE + OPD),在6个基准测试中,30B版本准确率超越最强开源同规模模型9.9%,工具调用轮次减少5.3倍,实现了准确率与效率的帕累托最优。Hy...
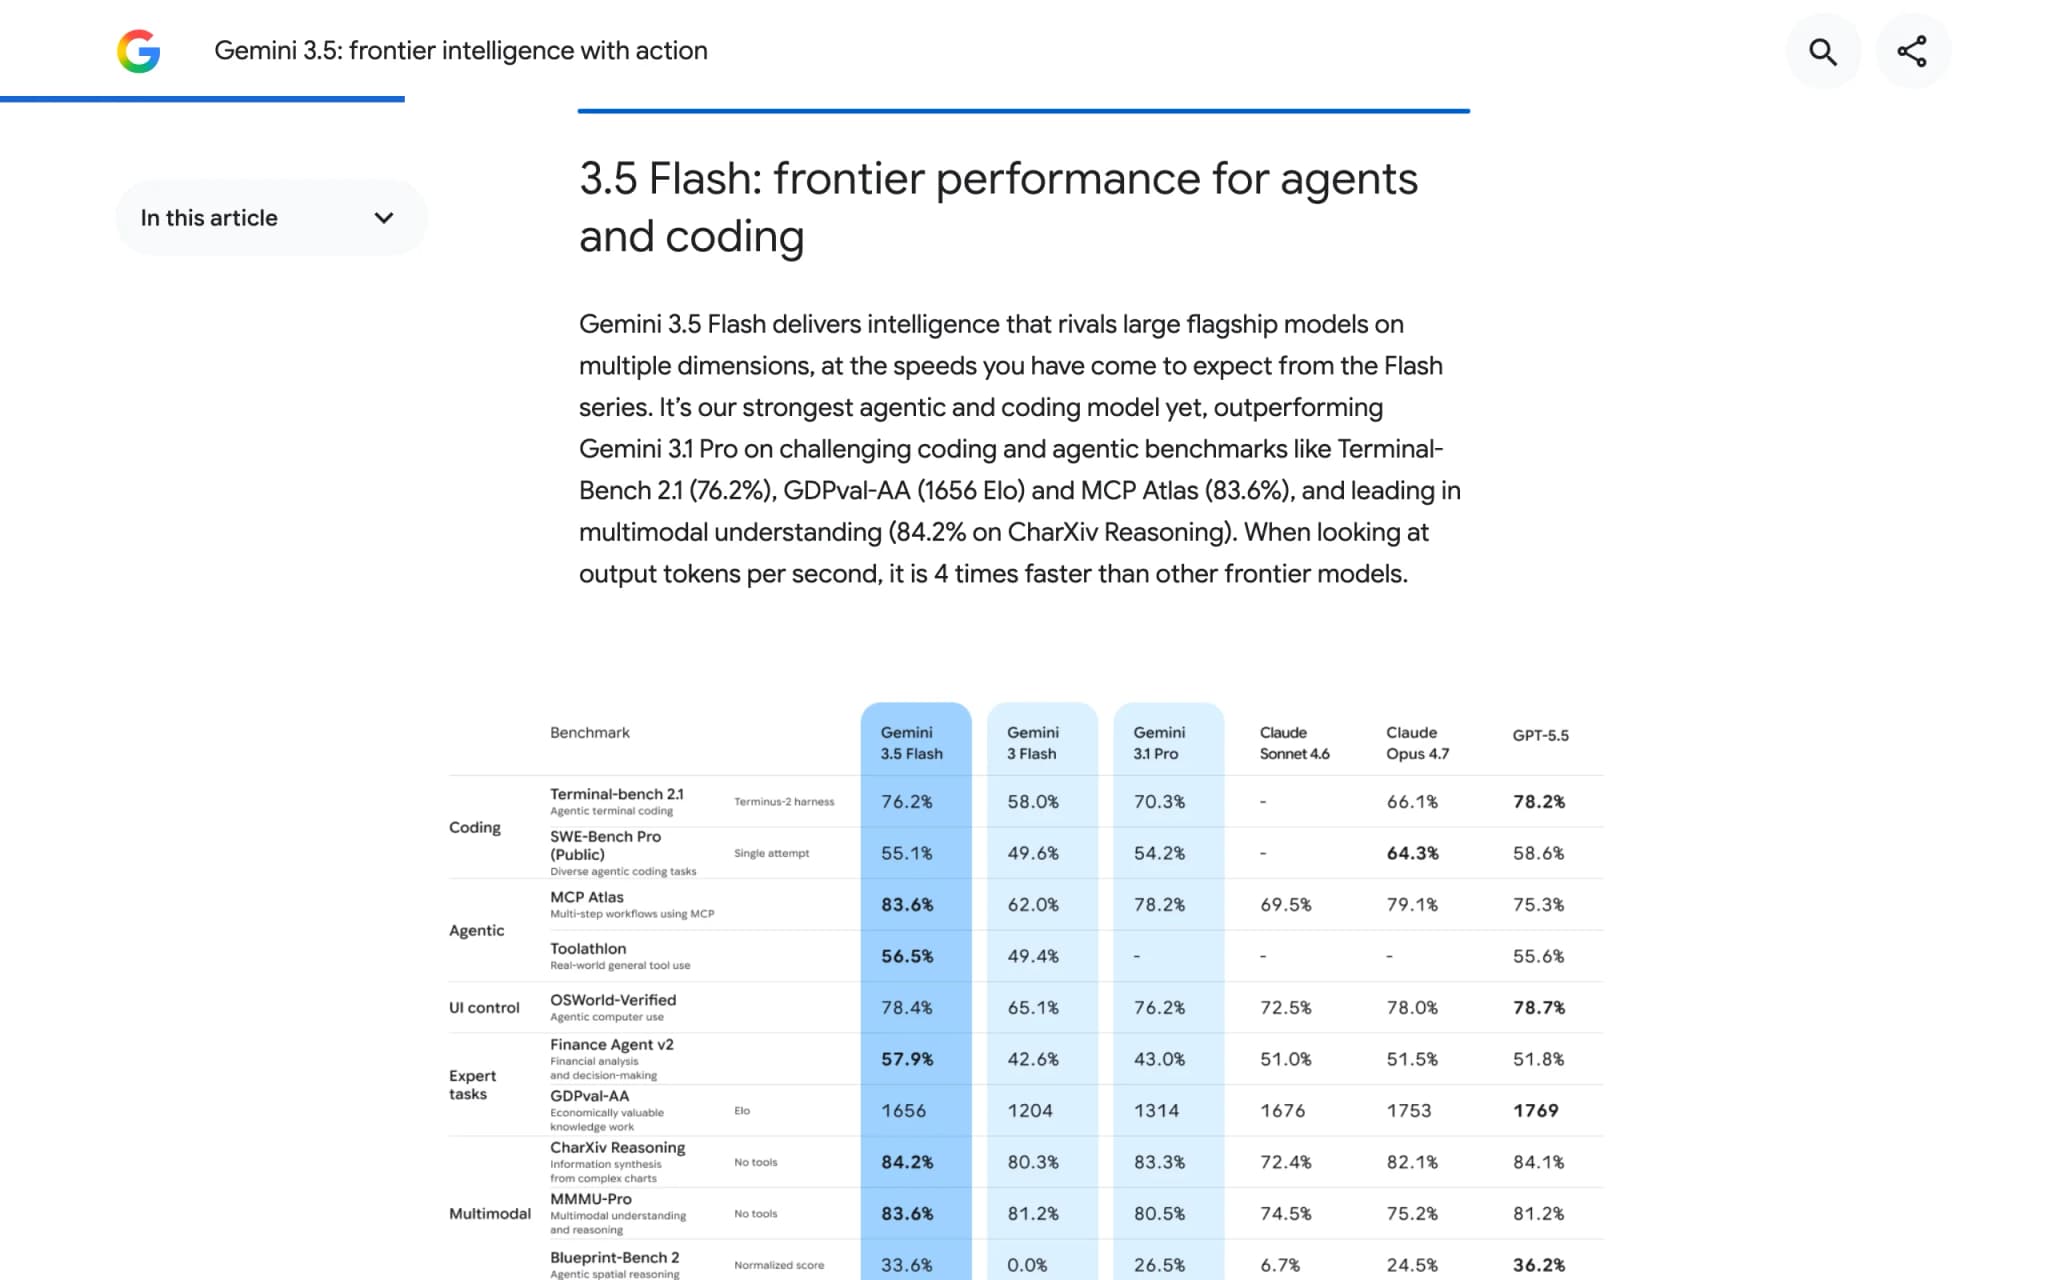
Gemini 3.5 Flash – Google 推出的一代 AI 大模型
Gemini 3.5 Flash 是 Google 推出的新一代 AI 大模型,以“前沿智能+行动能力”为核心定位,标志着 Google 在高效推理与 Agent 能力融合上的重大突破。该模型在 Terminal-Bench 2.1 编码基准上取得 76.2% 的得分,在 GDPval-AA 代理任务中达到 1656 Elo,在 MCP Atlas 上获得 83.6%,三项关键指标均超越前代旗舰 ...
HiDream-O1-Image-Pro – 智象未来推出的旗舰级图像模型
HiDream-O1-Image-Pro是智象未来(HiDream.ai)推出的基于原生全模态架构UiT(Unified Transformer)的旗舰级图像生成模型,参数规模超过200B,在文生图、高保真文字渲染、指令图像编辑和多主体个性化等核心任务上全面刷新了SOTA(State-of-the-Art)水平。该模型将原始图像像素、离散文本标记与多任务条件统一映射到连续共享标记空间,实现了底层表...
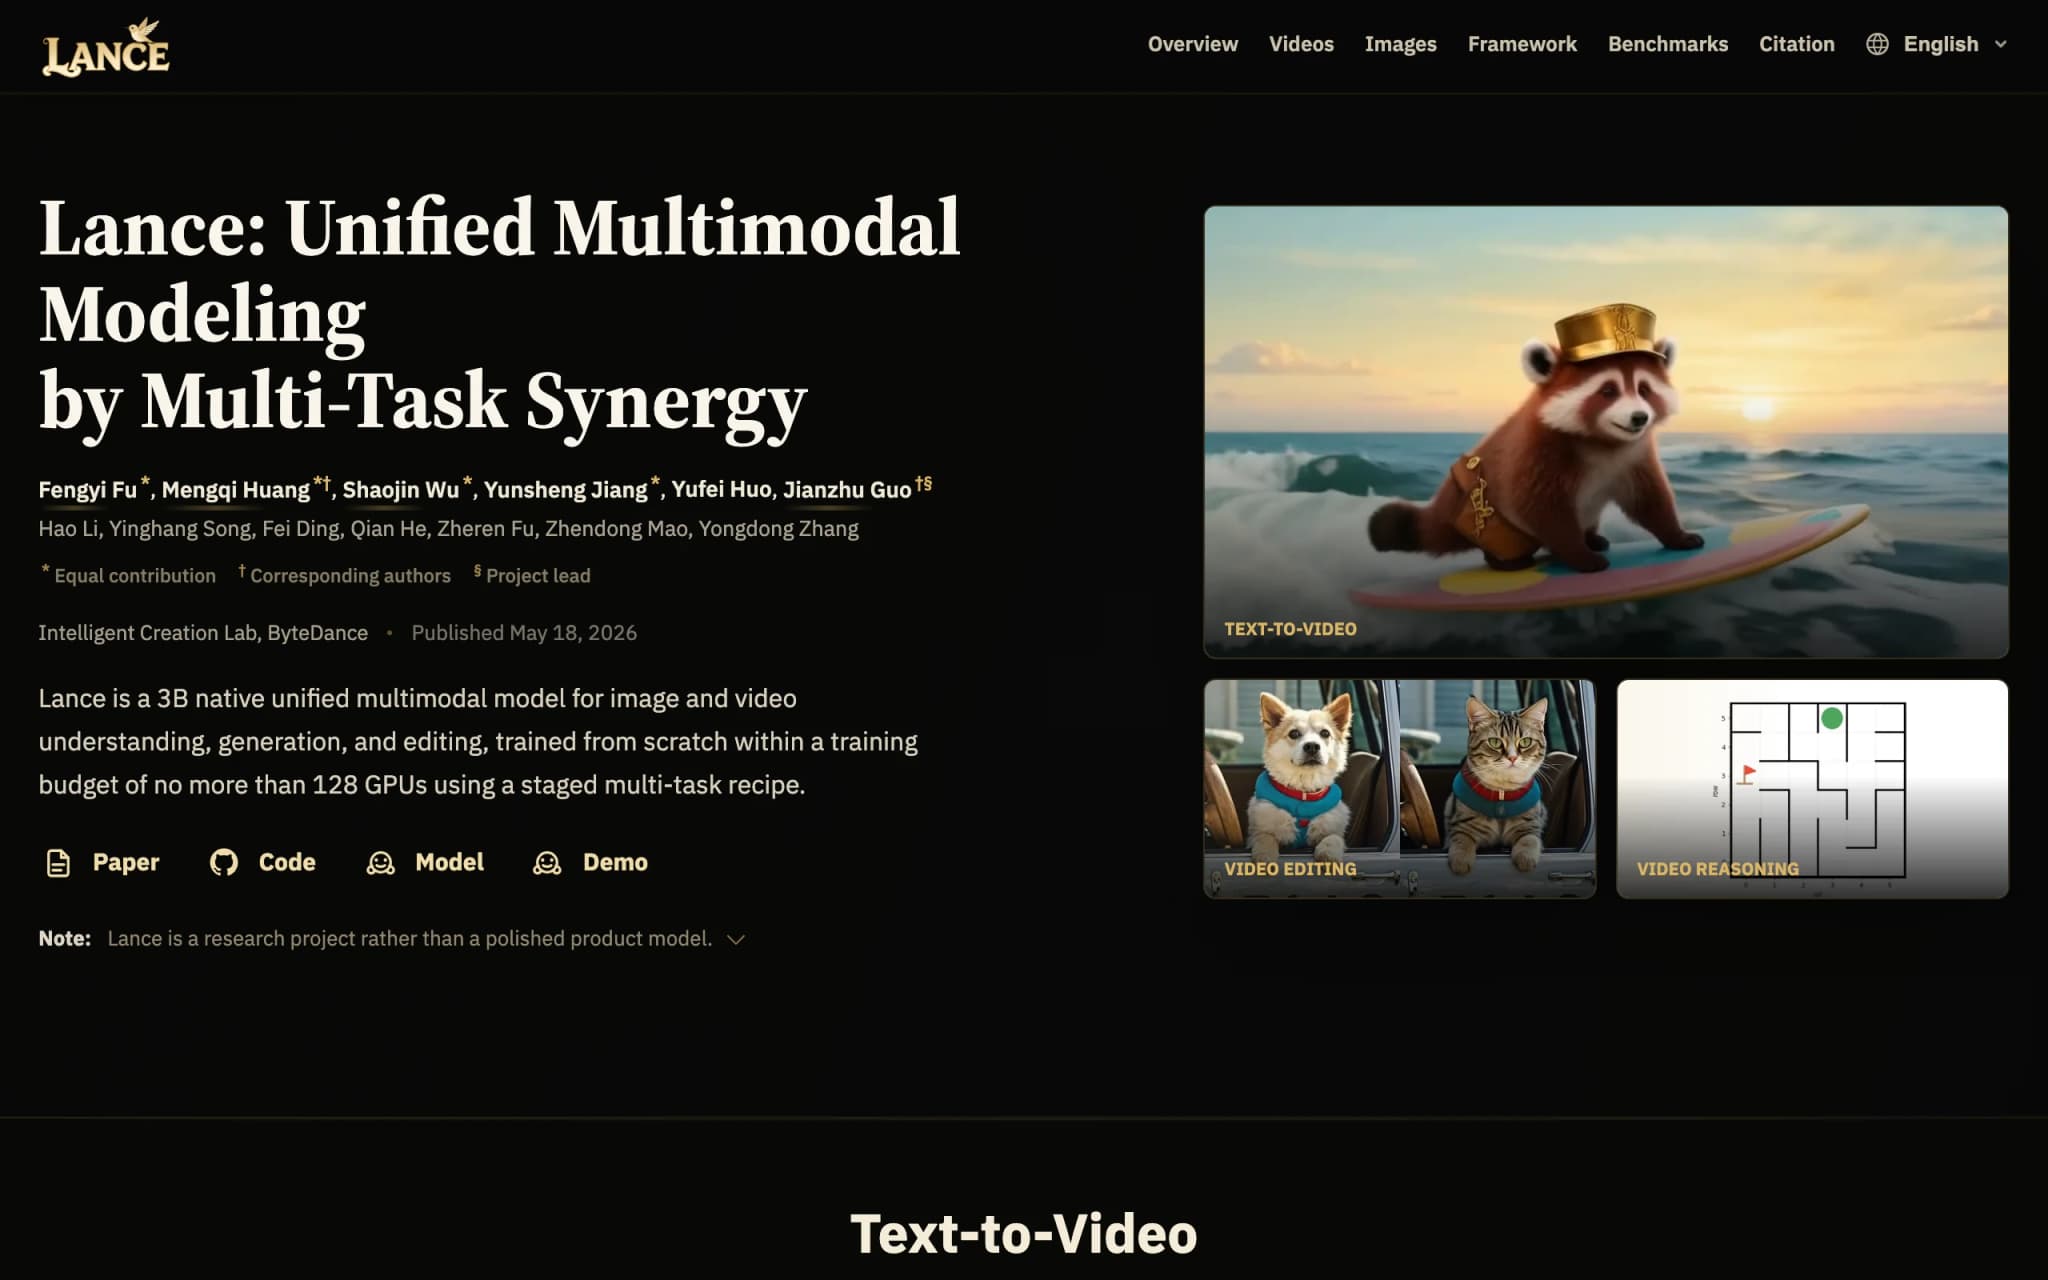
Lance – 字节跳动开源的轻量级原生统一多模态模型
Lance是字节跳动智能创作团队开源的一款轻量级原生统一多模态模型,仅需3B激活参数即可在单一框架内同时支持图像与视频的理解、生成与编辑全链路任务。该模型采用分阶段多任务方案从零训练,整个训练周期仅消耗128张A100 GPU,显著降低了大规模多模态模型的研发门槛。在GenEval、VBench等多项权威基准测试中,Lance的表现优于或持平于参数量数倍于己的开源模型,并遵循Apache-2.0开...
Subscribe to AI Model Reviews
Get in-depth reviews the moment a new AI model drops. Know its capabilities and use cases.
We never share your email. Unsubscribe anytime.