
AI Model Library: LLMs, Agents & Dev Tools
Curated reviews of mainstream AI models, agents, and dev tools — capabilities, use cases, and how they compare.
Tag: Multimodal
194 article(s) found · Clear tag
Gemini Omni Flash – 谷歌推出的多模态视频生成模型
Gemini Omni Flash 是谷歌在 I/O 大会上推出的统一多模态世界生成模型,其核心定位是打破传统生成模型的模态壁垒,实现从任意输入到任意输出的全链路内容生成。该模型将 Gemini 强大的推理引擎与 Veo 视频生成、Nano Banana 图像生成、Genie 交互模拟能力深度融合,构建了一个能够理解并模拟物理世界规则的多模态生成框架。其独特之处在于不仅支持文本、图像、视频、音频的...
Qwen3.5-LiveTranslate – 阿里通义推出的实时同声传译模型
Qwen3.5-LiveTranslate是阿里通义团队推出的新一代实时同声传译大模型,它打破了传统级联式翻译系统的延迟天花板。通过创新的“流式可读单元”架构,该模型将端到端字均延迟压缩至惊人的2.8秒,接近人类专业同传水平。它并非简单的翻译工具,而是一个集语音识别、机器翻译与语音合成于一体的端到端多模态AI系统,支持60种语种输入、29种语种输出,并拥有超过3500种翻译组合,专为跨境会议、直播...
Chronicles-OCR – 腾讯联合高校等推出的视觉感知评测基准
Chronicles-OCR 是腾讯混元联合中国科学院信息工程研究所、安阳师范学院、南开大学及故宫博物院共同推出的业界首个覆盖中国汉字“七体之变”完整演化轨迹的跨时间视觉感知评测基准。该基准包含 2,800 张高质量图像,系统涵盖甲骨文、金文、篆书、隶书、楷书、行书、草书七大字体,通过阶段自适应标注范式与四大评测任务,系统评估视觉大语言模型在面对数千年汉字形态持续演变时的感知鲁棒性与泛化能力。
Qwen3.7 Preview – 阿里通义推出的下一代旗舰大模型预览版
Qwen3.7 Preview 是阿里通义千问团队推出的下一代旗舰大模型预览版,包含 Qwen3.7-Max-Preview 和 Qwen3.7-Plus-Preview 两个版本,分别瞄准极致复杂推理与均衡体验两大方向。该模型在智能体编程、世界知识和指令遵循方面实现显著提升,在 LMSYS Chatbot Arena 榜单中助力阿里跃升至文本领域第 6、视觉领域第 5,标志着国产大模型在国际主流...
Higgs Avatar v1 – 面向语音智能体的实时 AI 数字人模型
Higgs Avatar v1 是由 BosonAI(李沐创办)推出的面向语音智能体的实时 AI 数字人模型,仅需一张静态照片即可生成具备口型同步、面部表情与头部动作的实时交互数字人。模型单帧渲染仅需 16 毫秒,远低于 62.5 毫秒的实时对话阈值,单张 H100 GPU 可并发支持 8 路独立实时对话,与自研 Higgs Audio 语音模型实现端到端协同,适用于客服、销售、培训等企业级交互场...
StepAudio 2.5 Realtime – 阶跃星辰推出的实时语音大模型
StepAudio 2.5 Realtime 是由阶跃星辰(StepFun)推出的端到端实时语音大模型,其核心定位是提供具备“真人级”体验的AI语音对话。该模型不仅突破了传统TTS的机械感,更在内容理解的深度和情感表达的细腻度上达到了行业领先水平。它能够精准捕捉语调、语速、停顿等副语言信息,并支持千万级别的个性化人设定制,旨在创造一个“有温度、有灵魂、有态度”的AI聊天搭子,而非仅仅是语音问答工具...
Ring-2.6-1T – 蚂蚁百灵推出的万亿深度推理模型
Ring-2.6-1T是蚂蚁集团百灵团队推出的万亿参数级深度推理大模型,隶属于Ring系列,专注于数学竞赛、代码生成等复杂认知任务的“慢思考”能力。模型采用MoE混合专家架构,总参数量达万亿级别,但推理时仅激活部分专家网络,在大规模知识覆盖与高效计算之间取得平衡。在AIME、IMO等高难度数学推理基准测试中,Ring-2.6-1T达到开源模型领先水平,成为当前开源社区中深度推理能力最强的模型之一。...
OpenAI CLI – OpenAI 推出的命令行界面工具
OpenAI CLI 是 OpenAI 官方推出的命令行界面工具,由 Codex 团队开发者体验工程师 Jason Liu 主导开发。该工具旨在让开发者无需编写 Python 或 Node.js SDK 脚本,直接在终端通过一行命令调用 OpenAI 最新模型能力。它支持 Responses API、多模态任务、项目管理及 Unix 管道风格输出,为开发者提供了一种轻量、高效的 API 交互方式。...
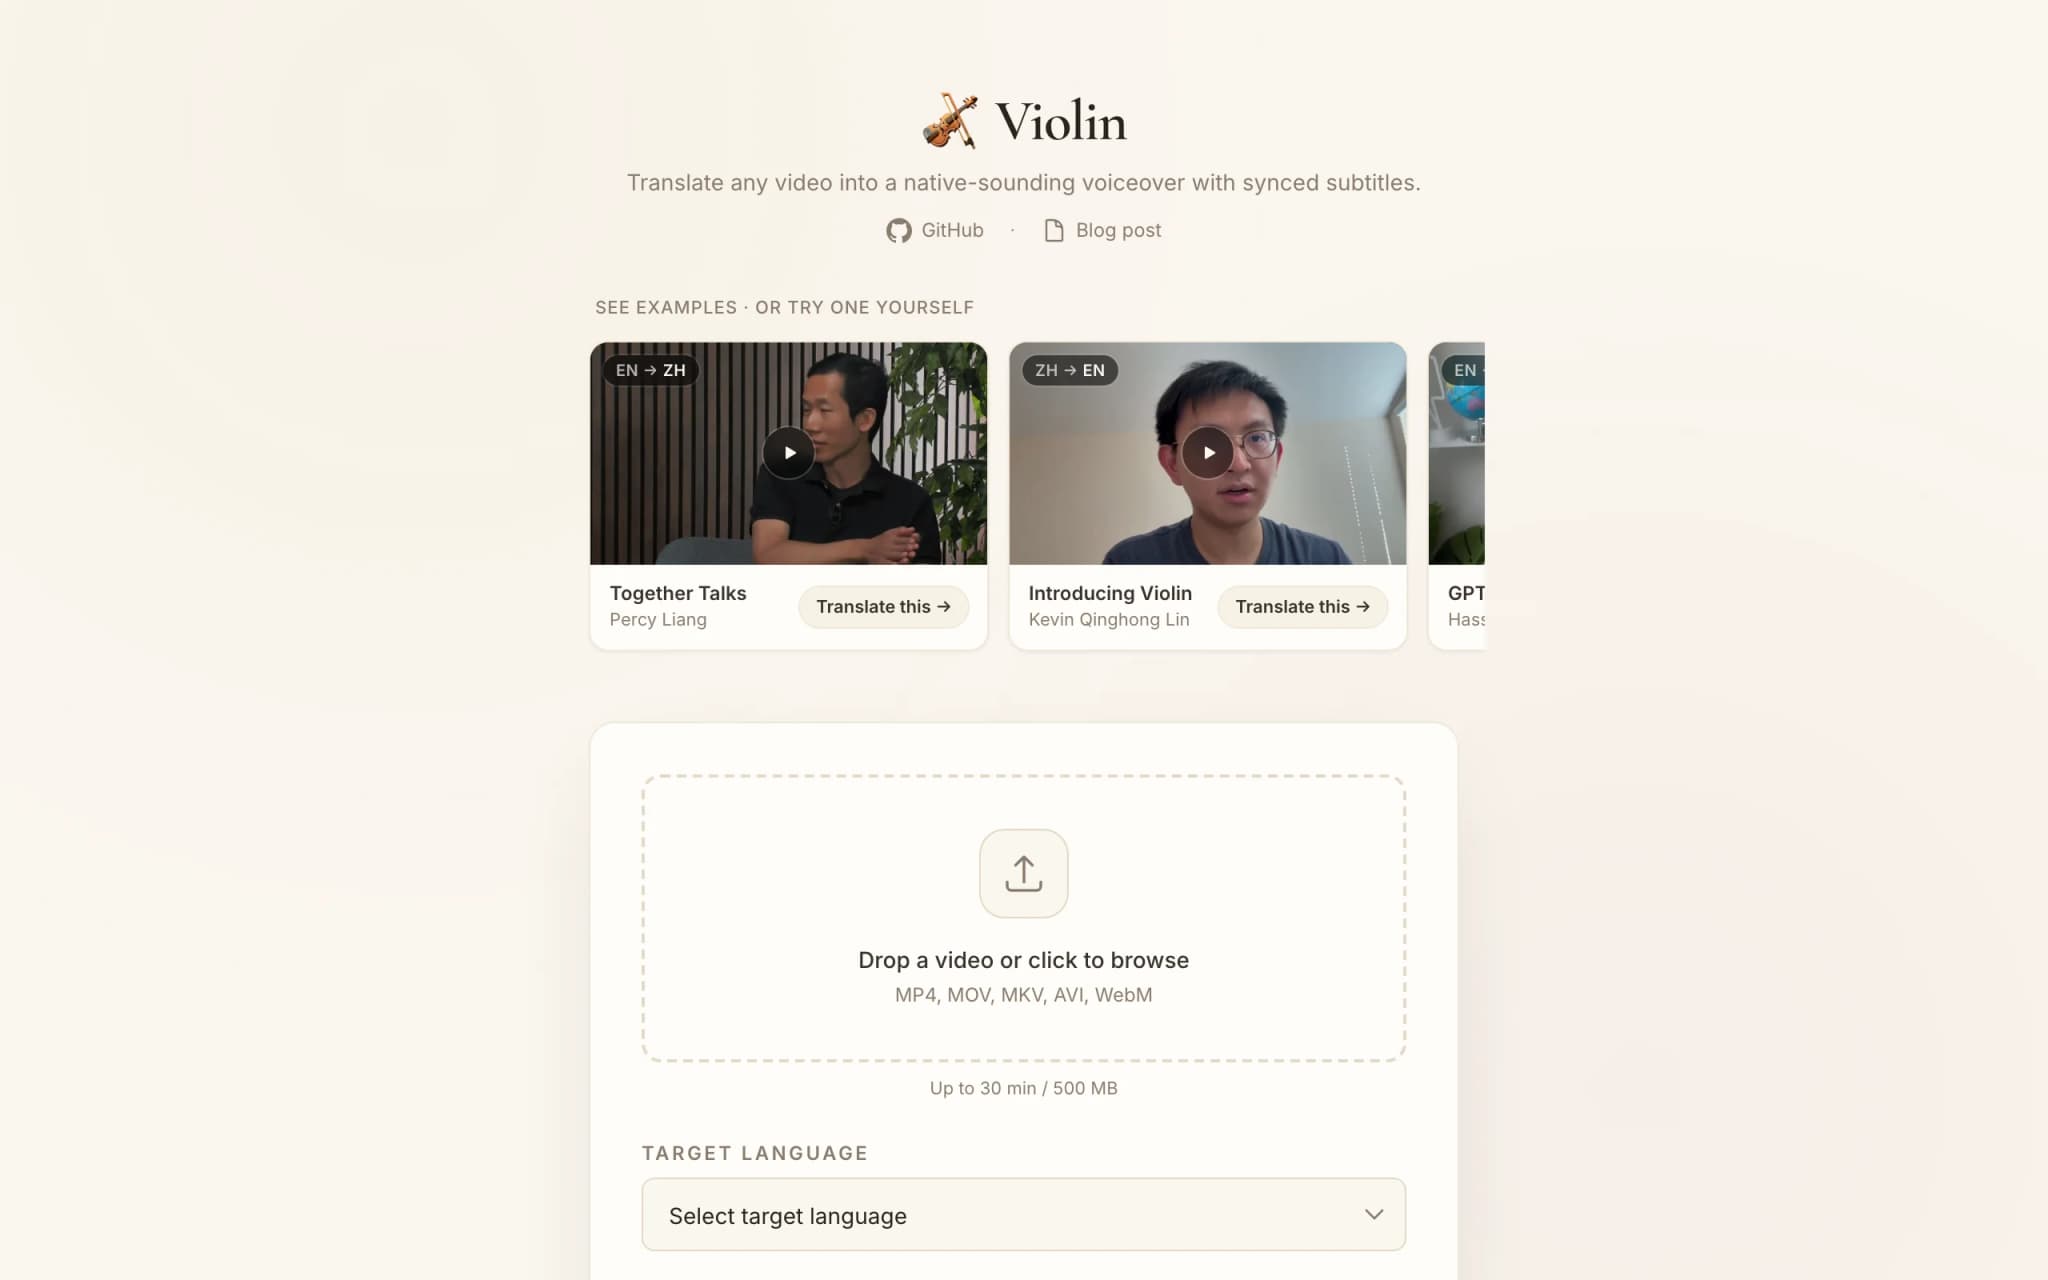
Violin – 牛津大学 Kevin Lin 开源的端到端 AI 视频翻译工具
Violin 是由牛津大学博士后研究员 Kevin Lin 主导开发的开源端到端 AI 视频翻译工具,旨在打破高质量视频内容的语言壁垒。该项目巧妙整合了 OpenAI Whisper 语音识别、大语言模型(LLM)驱动的智能翻译以及 TTS 语音合成三大核心技术,能够将任意语言的视频自动翻译并配音为 33 种目标语言,且输出音频与原始画面口型节奏高度对齐。Violin 采用 MIT 开源协议,支持...
HiDream-O1-Image – 智象未来开源的原生统一图像生成模型
HiDream-O1-Image是由智象未来(HiDream.ai)团队研发并开源的8B参数像素级原生统一图像生成模型,采用全球首创的UiT(Unified Transformer)架构,彻底颠覆了传统扩散模型中依赖VAE和独立文本编码器的三段式管线。该模型在单一共享token空间内直接生成2048×2048高清图像,无需任何超分后处理,在GenEval、HPSv3、DPG-Bench等六项权威基...
Subscribe to AI Model Reviews
Get in-depth reviews the moment a new AI model drops. Know its capabilities and use cases.
We never share your email. Unsubscribe anytime.