
APUS-OpenJev-v1:APUS AI Lab 开源的端侧决策大模型深度评测
导读摘要:
APUS-OpenJev-v1 是 APUS AI Lab 开源的端侧 System 1 决策大模型系列,与 TypeSafe AI 的闭源 Jev 模型定位同类,提供 4B、9B 和 35B-A3B 三种权重规格,可在浏览器自动化、表单填写、流程路由等任务中快速选择下一步操作。模型首创 effort="low/high" 动态计算深度机制:low 模式仅运行 16 层并结合候选感知投影,速度...
1. APUS-OpenJev-v1是什么
APUS-OpenJev-v1 是 APUS AI Lab 开源的端侧 System 1 决策大模型系列,与 TypeSafe AI 的闭源 Jev 模型定位同类,提供 4B、9B 和 35B-A3B 三种权重规格,可在浏览器自动化、表单填写、流程路由等任务中快速选择下一步操作。模型首创 effort="low/high" 动态计算深度机制:low 模式仅运行 16 层并结合候选感知投影,速度快、成本低;high 模式使用完整深度,准确率更高。该模型通过语言原生决策接口,将任务目标、上下文和候选操作描述作为自然语言输入,为候选动作绑定紧凑 Token,显著降低推理开销的同时保持决策质量。
技术定位与领域: 属于自然语言处理与智能决策交叉领域,专注于 System 1 快速决策场景,区别于传统大模型的生成式任务,强调在浏览器自动化、业务规则路由等场景下的即时动作选择能力。该模型在端侧部署和低延迟推理方面具有明确的技术定位,填补了开源社区在结构化决策大模型领域的空白。
研发背景: 由 APUS AI Lab 研发并开源,APUS 在人工智能应用领域有深厚积累。团队观察到现有大模型在处理结构化决策任务时存在输出格式不稳定、推理开销大等问题,因此借鉴 TypeSafe AI 闭源 Jev 的设计思路,开发了这套完全开源的决策模型,旨在推动决策智能在端侧场景的普及。
核心价值: 解决了传统大模型在决策场景中的三大痛点:一是输出格式幻觉问题,通过语言原生决策接口将输出约束在候选集合内;二是推理成本过高问题,通过 effort="low/high" 机制实现计算资源的按需分配;三是数据隐私问题,支持完全本地化部署,数据无需离开企业环境。
技术特点: 采用跨深度联合后训练与自蒸馏技术,使浅层出口在减少一半计算量的情况下仍保持可靠判断力;候选感知输出投影将输出矩阵计算从全词表缩小到 K 个候选,显著降低计算量和显存访问开销;支持多模型规格选择,适配从轻量端侧到高性能生产的多样化需求。
2. 主要功能
候选动作决策: 模型根据任务目标、页面上下文和候选操作描述,输出下一步业务动作。通过为候选动作绑定 A、B、C 等紧凑 Token,模型只需计算合法候选 Token 的概率即可完成决策,避免了传统大模型在开放式生成中可能出现的格式错误和无效输出。
浏览器自动化: 能够识别网页中的按钮、输入框、导航元素等 DOM 信息,辅助 Agent 完成点击、滚动、跳转等网页操作。该功能基于对 DOM 结构的语义理解,将浏览器操作转化为结构化的动作序列,适用于网页测试、数据采集、自动化流程执行等场景。
业务规则路由: 适用于客服工单分流、流程审批、表单提交等业务决策场景。模型能够理解业务规则和上下文信息,自动选择正确的处理路径,减少人工干预。例如在客服系统中,可根据用户问题自动判断最合适的处理部门或响应策略。
动态计算控制: 通过
effort="low/high"参数在高吞吐和高质量之间灵活切换。low 模式仅运行 16 层 Transformer 并结合候选感知输出投影,适合滚动、点击下一步等高频常规动作;high 模式执行完整 32 层推理,适合支付、权限确认等高风险操作,实现计算资源的最优分配。表单文本生成: 除选择题式决策外,模型还能生成搜索关键词、输入文本等开放式内容。通过
generate_text()接口,模型可以针对需要填写搜索词或表单内容的场景生成具体的文本输入,扩展了模型的应用边界,使其不仅限于结构化决策。本地毫秒级部署: 支持单卡 GPU 和 vLLM 服务化部署,降低云端 API 延迟与调用成本。在指定本地 vLLM 部署路径下,9B 版本的 P50 延迟低至 25.58ms,4B 版本仅为 18ms,能够满足实时决策场景的严苛延迟要求。
多模型规格选择: 提供 4B、9B 和 35B-A3B 三种版本,分别面向轻量端侧、生产通用和高性能需求。4B 模型适合资源受限的边缘设备,9B 模型在准确率和性能之间取得平衡,35B-A3B 则采用 MoE 架构,为复杂决策任务提供更强的模型能力。
3. 如何使用
准备环境: 安装支持 CUDA 的 PyTorch、Transformers 和
huggingface_hub库,并确保本地或服务器拥有足够的 GPU 显存。建议使用 NVIDIA GPU,显存至少 8GB 以上以流畅运行 4B 模型,运行 9B 模型建议 16GB 以上显存。下载模型: 执行
hf download apus-ailab/APUS-OpenJev-v1 --include "9B-3000/**" --local-dir ./APUS-OpenJev-v1下载所需模型目录。用户可根据需求选择下载 4B、9B 或 35B-A3B 对应的目录,避免不必要的存储开销。进入模型目录: 切换到下载好的模型子目录,即可直接使用其中自带的
openjet_runtime推理组件。该运行时组件封装了模型加载、推理和输出映射等核心逻辑,简化了部署流程。加载模型: 使用
OpenJet.from_pretrained(".", device="cuda:0")将模型加载到指定显卡上。此处可指定不同的 GPU 设备编号,支持多卡环境下的灵活配置。构造决策请求: 按照
instructions、state和candidates三个字段输入任务目标、当前上下文及候选操作。instructions描述任务指令,state提供当前环境状态,candidates列出所有可能的候选动作。执行快速决策: 调用
model.decide(request_data, effort="low"),以较低计算成本获得高频常规动作。该模式适合对延迟敏感且风险较低的决策场景,如页面滚动、点击"下一步"等操作。执行深度决策: 调用
model.decide(request_data, effort="high"),获得适合支付、提交等关键动作的完整推理结果。该模式利用完整网络深度,提供更高的决策准确率,适用于高风险操作场景。生成工作流文本: 对需要填写搜索词或表单内容的场景,调用
model.generate_text()生成具体文本。该接口支持开放式文本生成,弥补了纯决策接口的局限性。部署生产服务: 运行
python deployment/serve_vllm.py --port 8000,通过 vLLM 启动 OpenAI 兼容接口。该接口支持标准的 RESTful API 调用,便于集成到现有业务系统中,实现规模化部署。
4. 优缺点分析
| 优点 |
|---|
| 决策准确率高: 在官方 80 题冻结基准中,9B 版本达到 85% 的准确率,高于 Jev 商业 API 的 82.5%,展现了开源模型在决策任务上的技术优势。 |
| 响应速度极快: 在指定本地 vLLM 部署路径下,9B 版本的 P50 延迟低至 25.58ms,4B 版本仅为 18ms,满足实时决策场景的严苛要求。 |
计算资源动态可调: 首创 effort="low/high" 模式,可根据动作风险在速度和准确率之间自由切换,实现计算资源的最优分配。 |
| 避免输出格式错误: 采用语言原生决策接口,将输出约束在预定义候选集合内,消除 JSON 格式幻觉,提升系统稳定性。 |
| 业务迁移能力强: 同一模型可通过自然语言描述适配浏览器操作、客服分流、规则审核等不同任务,无需针对每个场景单独训练。 |
| 隐私与数据控制: 数据可完全留在本地或企业私有环境,满足金融、政务等对数据安全要求严格的行业合规需求。 |
5. 同类工具对比
| 对比维度 | APUS-OpenJev-v1 | Jev | SemIf |
|---|---|---|---|
| 产品性质 | APUS AI Lab 开源的 System 1 决策大模型 | TypeSafe AI 推出的商业闭源决策 API | 开源 AI 决策模型,复现 Jev 语义决策模式 |
| 开放程度 | 模型权重、运行时、部署脚本及技术报告全部开放 | 仅以云端 API 提供服务,核心模型不开源 | 开源模型权重,社区可自由使用和修改 |
| 模型规格 | 提供 4B、9B 及 35B-A3B 三种版本 | 官方未公开完整模型规模和版本细节 | 模型规模较小,专注于语义决策任务 |
| 决策准确率 | 9B 在官方 80 题冻结基准中达到 85.00% | 官方 API 同基准结果为 82.50% | 基准测试表现接近 Jev,具体数据待公布 |
| 响应延迟 | 指定本地部署路径下,9B P50 为 25.58ms | 公网 API 实测 P50 为 280.80ms | 本地部署延迟较低,具体数据待公布 |
| 计算模式 | 原生支持 effort="low/high" 动态计算深度 |
未公开类似的可调节计算深度机制 | 未公开类似机制 |
| 部署方式 | 支持本地、私有算力及 vLLM 服务化部署 | 主要依赖云端 API 调用 | 支持本地部署和开源社区集成 |
| 输出方式 | 可输出候选动作,也能生成表单和搜索文本 | 主要面向结构化动作决策,公开信息未明确文本生成能力 | 专注于语义决策输出 |
| 隐私与数据控制 | 数据可完全留在本地或企业私有环境 | 请求需发送至云端,数据控制依赖服务商方案 | 支持本地化部署,数据可控 |
| 成本模式 | 自部署后主要承担硬件和推理成本 | 按商业 API 调用计费,并产生持续订阅或流量成本 | 开源免费,仅需承担硬件成本 |
选型建议: 对于对数据隐私和成本敏感的企业,APUS-OpenJev-v1 是理想选择,其本地化部署能力确保数据不出企业环境,同时 effort="low/high" 机制能够有效控制推理成本。对于需要快速上线且技术团队资源有限的团队,Jev 的商业 API 提供了便捷的接入方式,但需权衡数据外传和持续成本问题。
对于技术实力较强、希望深度定制决策逻辑的团队,APUS-OpenJev-v1 的开源特性提供了最大的灵活性。SemIf 作为同类开源替代品,适合对模型透明度要求极高的场景。而传统通用大模型更适合那些需要同时处理决策和生成任务的综合场景,但需额外投入提示工程和输出约束的开发成本。
6. 编辑总结
APUS-OpenJev-v1 的发布标志着端侧决策大模型从闭源商业产品走向开源社区的重要转折。从技术创新角度看,该模型首创的 effort="low/high" 动态计算深度机制具有重要的工程实践价值,它打破了传统大模型"一次推理、固定成本"的范式,允许 Agent 系统根据动作重要性和把握程度动态分配计算资源。跨深度联合后训练与自蒸馏技术确保浅层出口在减少一半计算量的情况下仍保持可靠判断力,这种"分档计算"的设计理念值得行业借鉴。候选感知输出投影技术则从工程层面优化了推理效率,将输出矩阵计算从全词表缩小到 K 个候选,为端侧部署提供了技术支撑。
从实用价值角度,该模型在官方 80 题冻结基准中 9B 版本达到 85% 的准确率,超过商业闭源产品 Jev 的 82.5%,展示了开源模型在特定任务上的竞争力。25.58ms 的 P50 延迟满足实时决策场景的严苛要求,本地化部署能力则回应了金融、政务等行业对数据安全的刚性需求。模型提供 4B、9B 和 35B-A3B 三种规格,覆盖从轻量端侧到高性能生产的完整需求谱系,降低了不同规模企业的采用门槛。
该模型主要面向需要快速决策能力的开发者、AI Agent 应用构建者、企业自动化流程设计者,以及关注数据隐私和成本控制的技术决策者。对于浏览器自动化、智能客服、流程审批等场景,APUS-OpenJev-v1 提供了开箱即用的解决方案。随着开源社区的持续贡献和生态的不断完善,这类端侧决策模型有望在更多垂直领域落地,推动 AI 从"生成内容"向"做出决策"的范式演进。
7. 应用场景
浏览器自动化: 模型根据网页 DOM、按钮和输入框信息,快速决定点击、滚动或跳转等下一步操作。在网页测试、数据采集、RPA 流程自动化等场景中,模型能够理解页面结构并做出精准的操作决策,显著提升自动化流程的执行效率和稳定性。
企业流程路由: 在审批、工单处理或表单流转中,根据业务规则自动选择提交、退回、转交等处理路径。模型能够理解复杂的业务规则和上下文信息,减少人工判断和干预,提升流程处理效率和一致性,适用于 OA 系统、ERP 系统等企业级应用。
客服工单分配: 结合用户问题、历史信息和候选处理部门,实时判断最合适的客服团队或处理动作。模型能够快速分析用户意图和问题类型,实现智能化的工单路由,缩短响应时间,提升客户满意度,适用于客服中心、技术支持等场景。
金融与合规审核: 对高风险操作使用
effort="high"深度判断,识别异常交易、权限风险或违规数据流向。模型在高风险场景下利用完整网络深度确保决策准确性,同时支持完全本地化部署,满足金融行业严格的数据安全和合规要求。端侧智能助手: 将轻量模型部署在本地设备或私有服务器上,为高频 Agent 任务提供低延迟、保护隐私的决策能力。4B 模型可在资源受限的设备上运行,为移动应用、智能硬件等场景提供实时的智能决策支持,同时确保用户数据不出设备。
8. 常见问题FAQ
Q:APUS-OpenJev-v1 与通用大语言模型有什么区别?
A:APUS-OpenJev-v1 专注于 System 1 快速决策任务,采用语言原生决策接口,将输出约束在预定义候选集合内,避免格式幻觉。而通用大语言模型擅长开放式文本生成,在结构化决策场景中需要额外的提示工程和输出约束,且推理开销通常更高。
Q:effort="low" 和 effort="high" 模式如何选择?
A:effort="low" 模式仅运行 16 层 Transformer,适合滚动、点击下一步等高频常规动作,计算成本低、响应速度快。effort="high" 模式执行完整 32 层推理,适合支付确认、权限审批等高风险操作,准确率更高。建议根据动作的重要性和风险等级动态选择。
Q:模型支持哪些部署方式?
A:模型支持单卡 GPU 本地部署和 vLLM 服务化部署。本地部署可运行 openjet_runtime 推理组件,服务化部署可运行 python deployment/serve_vllm.py --port 8000 启动 OpenAI 兼容接口,方便集成到现有业务系统。
Q:如何选择 4B、9B 和 35B-A3B 版本?
A:4B 版本适合资源受限的边缘设备和轻量端侧场景;9B 版本在准确率和性能之间取得平衡,适合生产环境通用场景;35B-A3B 采用 MoE 架构,为复杂决策任务提供更强的模型能力,适合对准确率要求极高的场景。
Q:模型能否处理中文业务场景?
A:模型的训练数据和基准测试以英文为主,但基于语言原生决策接口的设计,理论上可以通过自然语言描述适配中文场景。建议在中文业务场景中先进行小规模测试,评估模型表现后再进行大规模部署。
Q:部署模型需要什么硬件配置?
A:建议使用支持 CUDA 的 NVIDIA GPU,4B 模型至少 8GB 显存,9B 模型建议 16GB 以上显存,35B-A3B 模型则需要更高配置。具体显存需求还取决于推理批次大小和序列长度。
Q:模型的开源协议是什么?
A:APUS-OpenJev-v1 的模型权重、运行时、部署脚本及技术报告全部开放,具体开源协议请参考 HuggingFace 模型页面和官方技术文档。用户可自由使用、修改和商用,但需遵守相应的开源许可条款。
9. 项目地址
- HuggingFace 模型库: https://huggingface.co/apus-ailab/APUS-OpenJev-v1
相关 AI 模型文章
Nano Banana 2.1:Google DeepMind 图像生成与对话式编辑模型深度评测
Nano Banana 2.1(模型 ID:gemini-nano-banana-2.1)是 Google DeepMind 于 2026 年 10 月 6 日正式发布的第二代图像生成与对话式编辑模型,隶属于 Gemini 3 系列,底层架构基于 Gemini 3.6 Flash。该模型深度融合了原生多模态推理、1M token 长上下文与知识 grounding 能力,支持 1K/2K/4K 分...
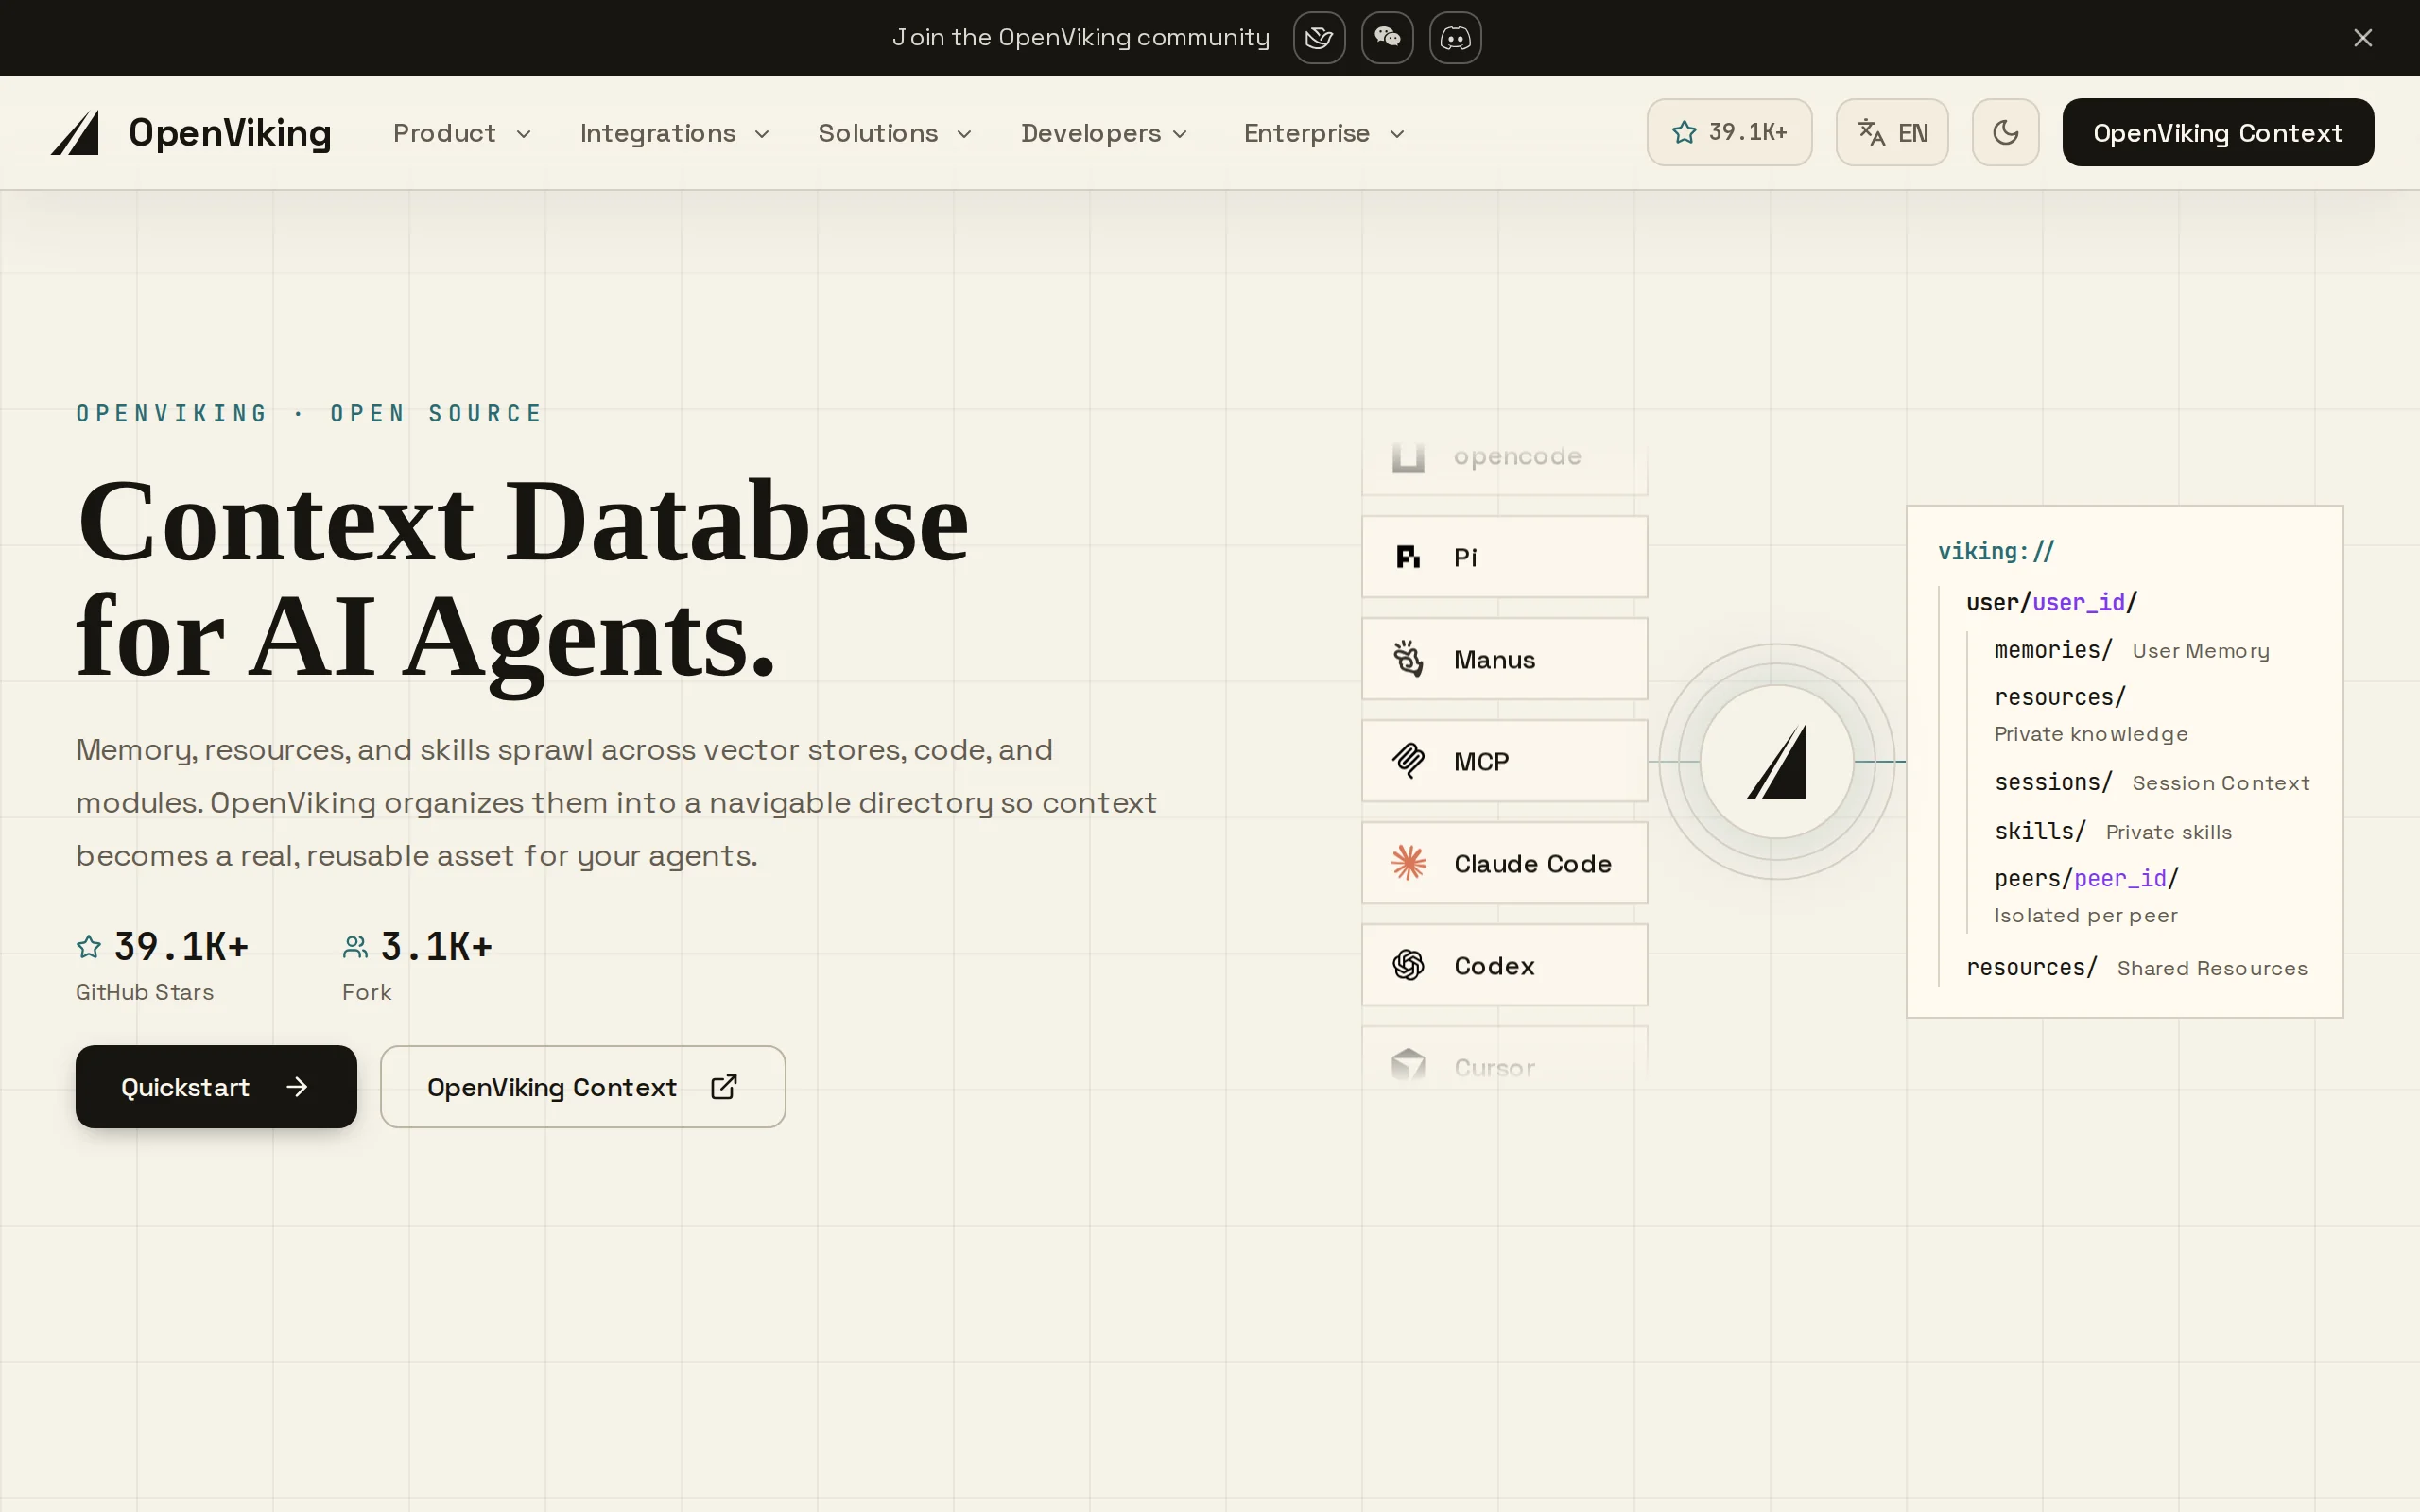
OpenViking – 字节开源的 AI Agent 上下文数据库
OpenViking是由字节跳动火山引擎开源的一款AI Agent上下文数据库,其核心思路是将Agent的记忆、知识RAG和技能统一组织在自定义的`viking://`虚拟文件系统中。Agent可以通过`ls`、`tree`、`find`、`grep`等命令像操作文件一样浏览和检索上下文,告别传统“text in, embeddings out”的黑盒模式。借助L0摘要、L1概览、L2详情三层渐进...
讯飞Spark-ASR-2.0深度评测:非自回归架构下的语音识别新范式
Spark-ASR-2.0是科大讯飞基于星火语音基座大模型Spark-Audio推出的最新一代语音识别大模型。该模型延续了Spark-ASR-1.0的非自回归并行解码范式,并创新性地引入LLM增强的自回归识别机制,通过"非自回归+LLM增强自回归"协同架构,在中英文混合、方言、专业术语、高噪声小音量等复杂场景下实现了识别效果的显著提升,同时推理成本相较上一代仅增加10%。模型已率先在讯飞输入法中上...
HappyOyster 1.0 — 阿里推出的实时生成式开放世界模型深度评测
HappyOyster 1.0是阿里巴巴ATH创新事业部推出的实时生成式开放世界模型系列,定位为世界模拟器范式下的新一代交互式生成模型。该系列包含Adventure与Directing两款模型,前者可基于文本或图像输入实时生成可自由探索的开放世界,支持实时移动、镜头控制与持续交互;后者可通过文本指令实时驱动角色、剧情与镜头演绎。模型已上架阿里云百炼平台,开发者无需邀测即可通过API直接调用,单次世...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。