
SemIf – 开源的 AI 决策模型,复现 Jev 语义决策模式
导读摘要:
SemIf(原 OpenJev)是一个开源的 AI 决策模型,旨在通过开源手段复现 TypeSafe 闭源服务 Jev 的语义决策接口模式。该模型采用单次前向传播机制,直接读取候选选项对应的 logits 进行打分,由服务端构造结构化结果,从而规避了传统自回归生成后再解析文本的复杂流程。在多个问题共享相同状态时,SemIf 还可复用前缀计算,吞吐量提升近一个数量级。该模型在单张 RTX 3090 ...
1. SemIf是什么
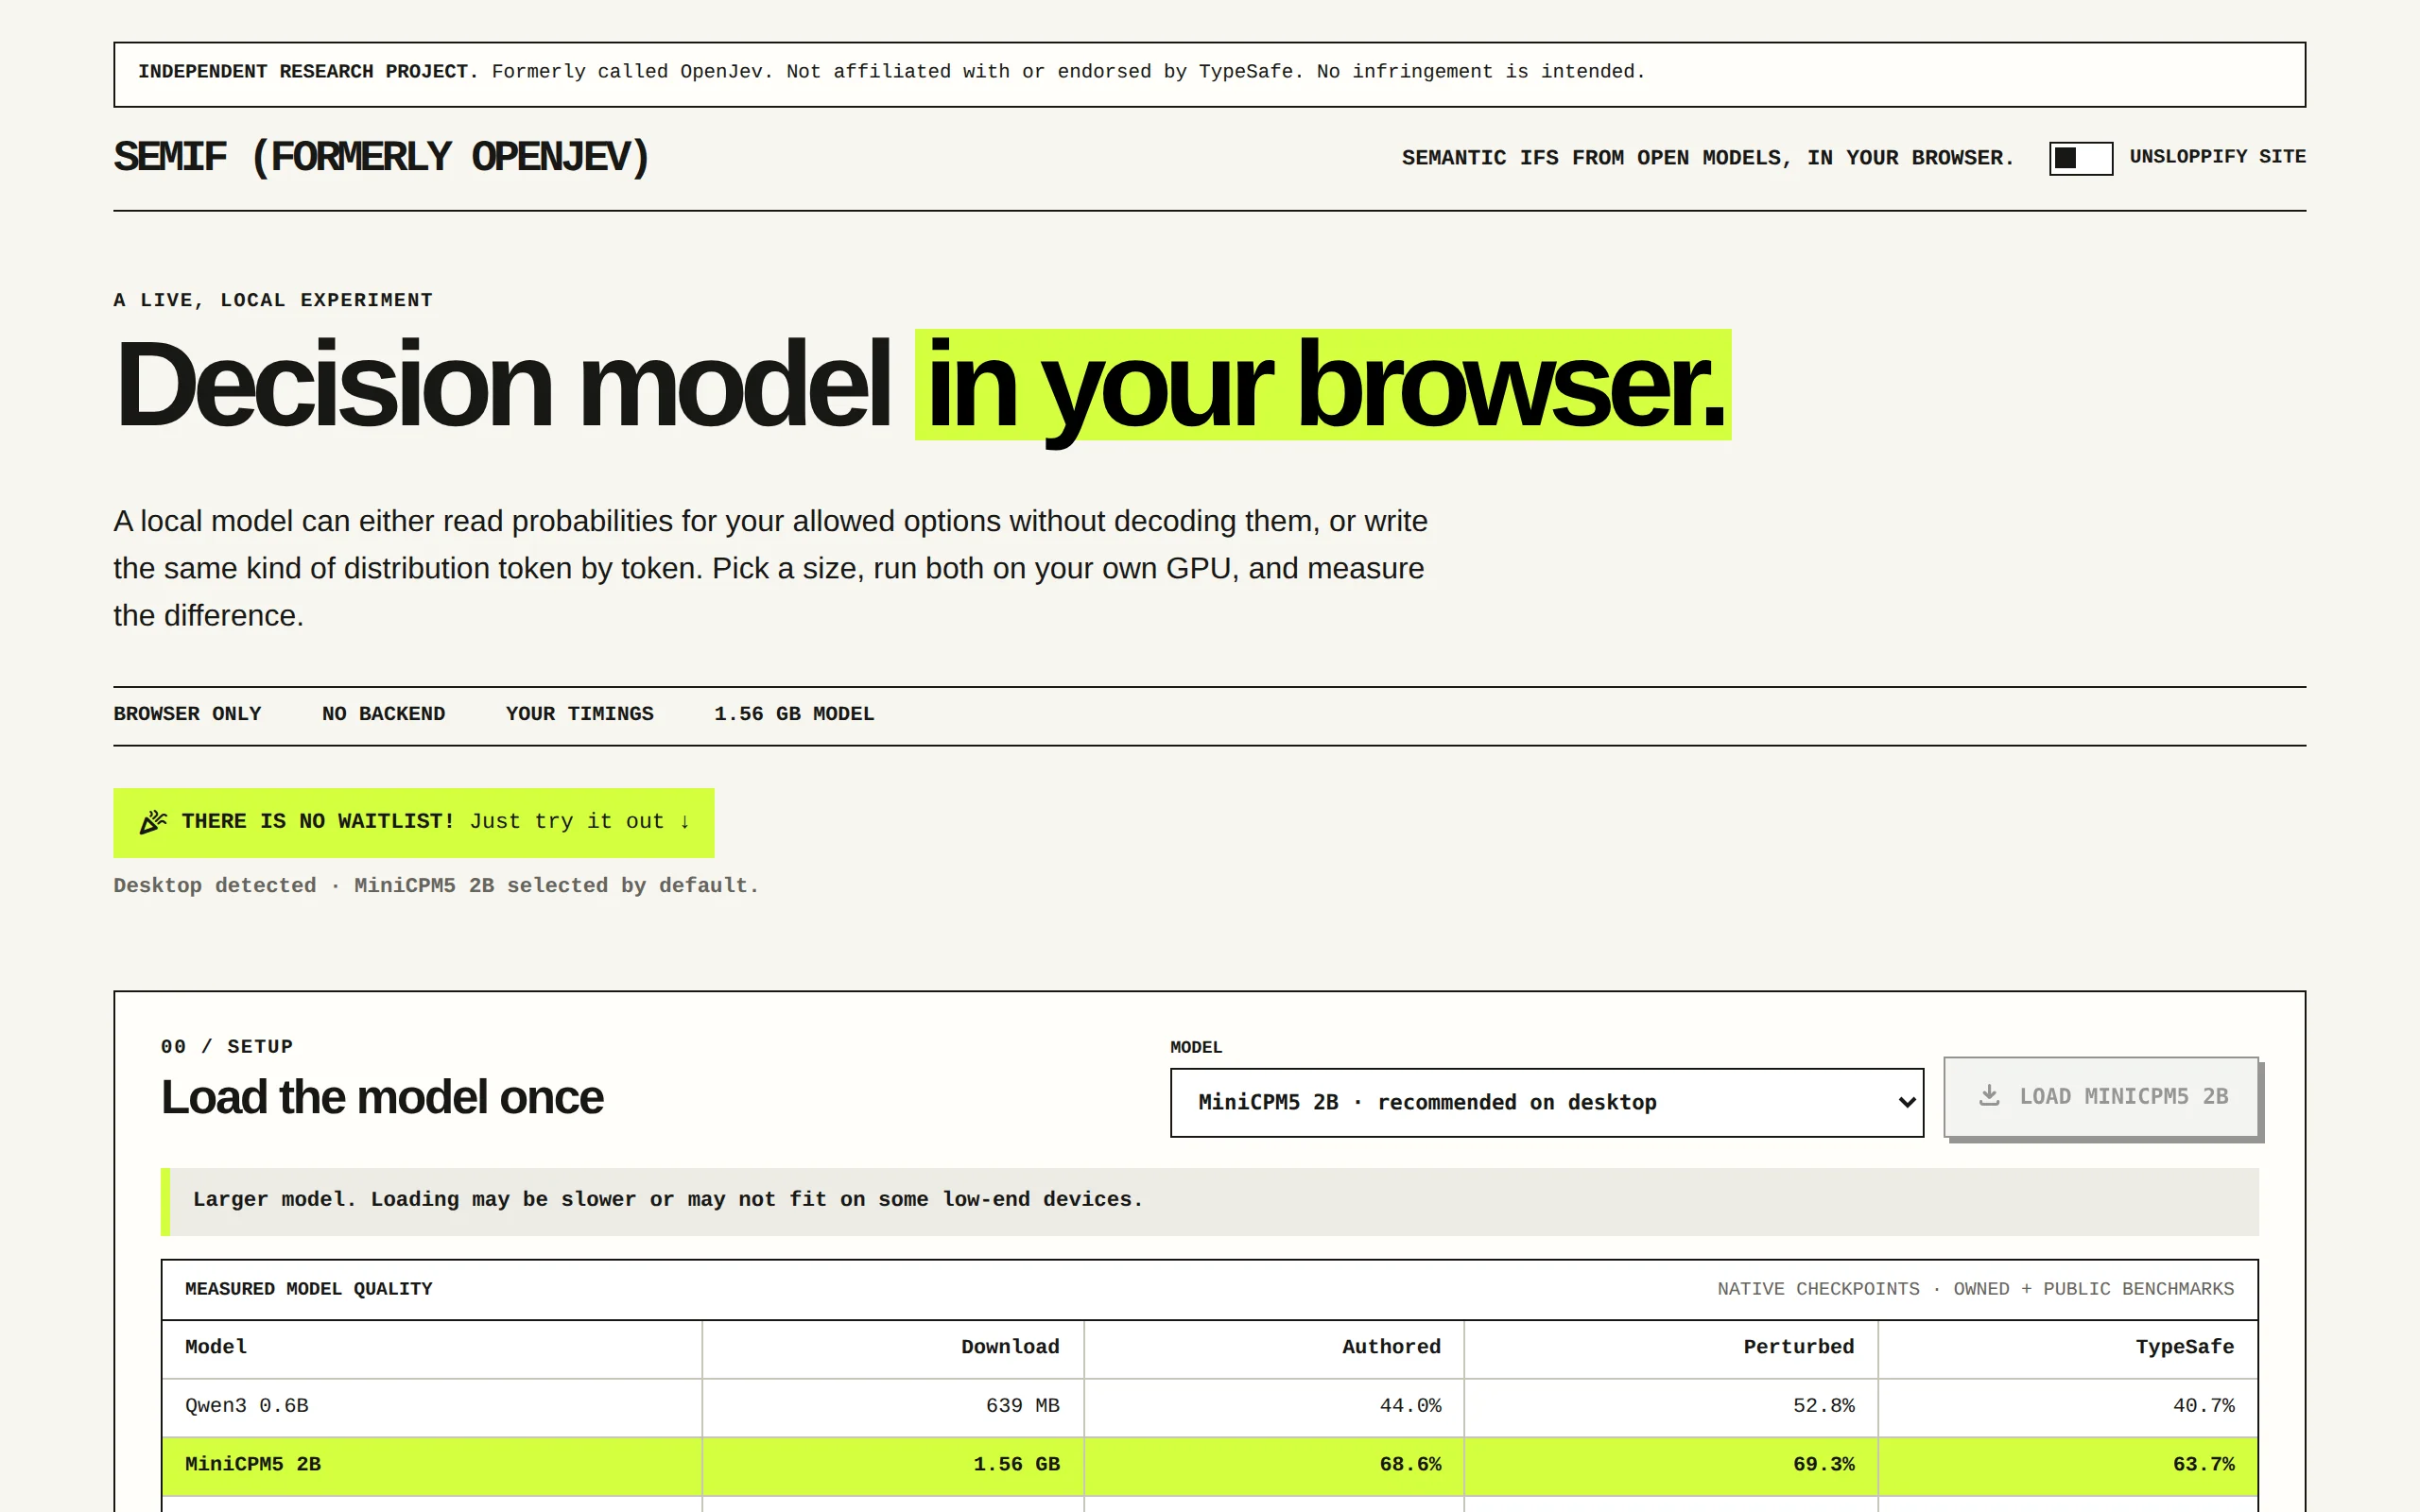
SemIf(原 OpenJev)是一个开源的 AI 决策模型,旨在通过开源手段复现 TypeSafe 闭源服务 Jev 的语义决策接口模式。该模型采用单次前向传播机制,直接读取候选选项对应的 logits 进行打分,由服务端构造结构化结果,从而规避了传统自回归生成后再解析文本的复杂流程。在多个问题共享相同状态时,SemIf 还可复用前缀计算,吞吐量提升近一个数量级。该模型在单张 RTX 3090 显卡上即可运行,并提供浏览器演示环境,包含逐行可复现的基准测试、温度校准机制以及 27B 模型桥接方案,兼顾了性能、可审计性与部署灵活性。
技术定位与领域: SemIf 属于自然语言处理领域中的语义决策与推理模型,核心应用方向为结构化决策输出、候选选项评分及轻量级 Agent 决策。其独特定位在于以开源方式复现闭源商业服务的决策接口模式,填补了该细分方向的开源空白。
研发背景: 该项目由独立开发者 TheoLeeCJ 发起,前身为 OpenJev,旨在通过完全开源的方式验证并复现 Jev 的语义决策能力。项目团队将固定 prompt、模型版本、逐行输出及已知失败案例全部提交至仓库,体现了对可复现性和透明度的重视。
核心价值: SemIf 解决了传统决策任务中"生成-解析"流程带来的延迟高、格式错误频发、解码不稳定等问题。通过直接读取 logits 打分,将 21 个二元决策的耗时压缩至约 1 秒,比生成 JSON 快 5.2 倍,显著提升了决策效率和可靠性。
技术特点: 模型采用冻结的 4B 参数 Qwen 系列作为底座,支持 CUDA、Apple Silicon、CPU 及浏览器 WebGPU 多种后端;内置按工作负载拟合的温度校准机制,使输出置信度与实际准确率对齐,可直接驱动下游自动化决策流程。
2. 主要功能
直接 logit 打分: 单次前向传播直接读取候选选项的 logits 并转换为概率,完全跳过答案文本生成与解析环节。相比自回归生成后解析 JSON 的传统方案,该机制在速度上提升约 5 倍,同时从根源上杜绝了 JSON 格式错误、解码循环及输出解析失败等问题。
共享状态复用: 当多个决策共享同一上下文状态时,系统仅需预填充一次前缀,随后可串行或并行评估各决策标准。实测数据显示,该模式下吞吐量从基准的 2.33 决策/秒提升至最高 20.03 决策/秒,提升接近一个数量级,特别适合批量决策场景。
运行时可定义决策: 决策标准和选项描述随请求动态传入,无需针对特定任务进行微调或预定义任务模板。这一特性使模型能够灵活应对路由选择、重试判断等小型 Agent 决策需求,显著降低了任务适配成本。
完全可审计: 项目仓库中提交了固定的 prompt、模型版本、prompt 哈希、逐行输出结果以及已知失败案例。任何使用者都可以精确复现基准测试结果,并对每个决策进行逐条审计与验证,这在 AI 决策类项目中较为少见。
温度校准: 内置按工作负载拟合的温度缩放机制,能够改善概率置信度与实际准确率之间的一致性。校准后的置信度输出可直接用于自动化决策流程,避免因过度自信或信心不足导致的误判。
多后端支持: 支持 CUDA GPU、Apple Silicon(MPS/MLX)、CPU 以及浏览器 WebGPU 演示环境。用户可根据自身硬件条件选择最合适的运行方式,从消费级显卡到纯 CPU 环境均可覆盖,极大降低了使用门槛。
3. 如何使用
环境准备: 需要安装 Python 3.10 或更高版本,并配置 CUDA 环境(如使用 GPU 推理)。显卡需具备至少 8GB 显存以容纳冻结的 4B BF16 模型,推荐使用 RTX 3090 或同等性能的显卡。
安装项目: 克隆 GitHub 仓库后,创建虚拟环境并激活,执行
pip install -e '.[test]'安装项目及其测试依赖。该命令会同时安装模型推理所需的各类库。准备输入数据: 编写 JSONL 格式的决策文件,每行包含
id(决策标识)、state(共享状态上下文)、question(决策问题描述)和options(候选选项列表)。格式示例:{"id": "1", "state": "用户账户状态正常", "question": "该工单应路由至哪个队列?", "options": ["账号支持", "计费支持", "技术支持"]}。运行打分: 执行
semif-score --mode direct --model Qwen/Qwen3.5-4B --revision <固定版本> --input examples/decisions.jsonl --output results.jsonl命令。运行完成后,输出文件中包含逐行选项概率、推理耗时及 prompt 哈希值。共享状态模式: 当输入文件中所有行的
state字段完全相同时,改用--mode shared参数运行。系统将仅预填充一次共享前缀,随后并行评估所有决策标准,从而获得近一个数量级的吞吐量提升。温度校准应用: 使用项目自带的校准脚本,在目标工作负载上拟合温度缩放参数。校准完成后,输出的概率置信度将与实际准确率对齐,可直接用于自动化决策流程。
4. 优缺点分析
| 优点 |
|---|
| 决策速度显著领先: 直接读取 logits 打分免去生成-解析流程,21 个二元决策仅需约 1 秒,比生成 JSON 快 5.2 倍,在延迟敏感场景中优势明显。 |
| 零生成 token 设计: 不采样答案文本,从根本上杜绝 JSON 格式错误、解码循环和输出解析失败等问题,决策过程更加稳定可靠。 |
| 硬件门槛低: 冻结的 4B 模型在单张 RTX 3090 上即可流畅运行,同时支持 CPU、Apple Silicon 和浏览器 WebGPU,部署灵活性较高。 |
| 完全开源可复现: 所有 prompt、模型版本、逐行结果和已知失败均提交仓库,支持精确复现与逐条审计,透明度和可信度较高。 |
5. 同类工具对比
| 对比维度 | SemIf | Jev | 传统生成式决策 |
|---|---|---|---|
| 核心架构 | 单次前向传播直接读取选项 logits,0 输出 token | 内部机制未公开,提供语义决策接口 | 自回归生成 JSON 文本后解析 |
| 决策速度 | 21 个二元决策约 1.02 秒,共享状态最高 20 决策/秒 | 无公开延迟数据 | 通常需数秒至数十秒,取决于生成长度 |
| 功能特色 | 运行时定义决策、温度校准、完全可审计 | 闭源商业服务,语义决策能力较强 | 灵活但易产生格式错误 |
| 部署方式 | 本地部署,支持 CUDA/CPU/Apple Silicon/WebGPU | 云端托管,用户无需自备硬件 | 本地或云端均可 |
| 开源协议 | MIT 开源协议 | 闭源商业授权 | 视具体模型而定 |
| 质量表现 | 102 行子集一致率 0.845,27B 桥接达 0.958 | 同子集一致率 0.883 | 取决于模型能力与提示设计 |
| 社区生态 | 开源社区维护,文档与基准公开 | 商业服务,生态封闭 | 生态丰富,工具链成熟 |
选型建议: 对于追求低延迟、高吞吐且需要完全掌控决策过程的团队,SemIf 是理想选择,尤其是已具备 GPU 资源且对数据隐私有要求的场景。其开源属性也便于审计和二次开发。若团队缺乏硬件资源或需要最大化的决策质量,可考虑 Jev 这类商业托管服务,但需接受闭源带来的不可控性。对于任务高度固定且训练数据充足的场景,专用分类模型在精度和速度上可能更优,但灵活性和泛化能力不及 SemIf。
6. 编辑总结
SemIf 在 AI 决策模型领域展现出了明确的技术创新性。其核心贡献在于将"生成-解析"的传统决策范式转变为"直接打分"的判别式范式,这一架构层面的改动带来了 5 倍以上的速度提升,同时从机制上消除了文本生成过程中的格式错误与解码不稳定问题。共享状态前缀复用机制的设计同样体现了工程上的深入思考,使得批量决策场景的吞吐量获得近一个数量级的提升。从实用价值来看,SemIf 将硬件门槛控制在单张 RTX 3090 即可运行的水平,同时提供 CPU、Apple Silicon 和 WebGPU 多后端支持,覆盖了从服务器到个人电脑的广泛部署场景。项目对可复现性的坚持——固定 prompt、固定模型版本、提交逐行输出与已知失败——在开源 AI 项目中树立了较高的透明度标准。
该模型主要适用于对决策延迟敏感、需要批量处理决策任务、或希望将决策过程纳入审计体系的开发团队与研究者。其运行时定义决策的特性使其在 Agent 路由、动作防火墙、证据排序等轻量级决策场景中具有较高的实用价值。从发展潜力来看,随着 27B 模型桥接方案的成熟和社区贡献的积累,SemIf 在决策质量上有望进一步缩小与闭源服务的差距。其在边缘设备上的运行能力也使其在端侧 AI 决策领域具备拓展空间。对于追求决策效率与可审计性的团队,SemIf 提供了一个值得深入评估的开源方案。
7. 应用场景
客服工单路由: 根据客户问题描述和账户状态,直接在"账号支持 / 计费支持 / 技术支持"等队列选项上打分,实现毫秒级自动分派。SemIf 的 logit 直接打分机制使得单次决策耗时极短,能够支撑高并发客服场景下的实时路由需求。
Agent 动作防火墙: Agent 在执行高风险操作前,对候选动作进行二元判断(执行/拒绝)。SemIf 在此场景下达到 0.700 的复合准确率,可作为安全防线中的第一层过滤,快速拦截明显不当的操作,降低 Agent 自主行为带来的风险。
证据检索与排序: 在代码库检索和企业知识库问答场景中替代传统 reranker,一次前向传播即可给出候选文档的相关性得分。实测在知识库问答任务上达到 0.929 的准确率,兼顾了排序质量与推理速度。
推理结论核验: 用于 NLI 类任务,判断"证据是否支持结论"的逻辑关系。经过温度校准后的置信度输出可直接驱动下游自动化流程,例如自动标记存疑的推理结论供人工复核,提升整体决策链路的可靠性。
8. 常见问题FAQ
Q:SemIf 与 Jev 的核心区别是什么?
A:SemIf 是开源实现(MIT 协议),通过直接读取选项 logits 打分完成决策,全程零输出 token;Jev 是 TypeSafe 的闭源商业托管服务,内部机制未公开。SemIf 在 102 行子集上一致率为 0.845,低于 Jev 的 0.883,但提供了本地部署、完全可审计和更高的决策速度。
Q:SemIf 支持哪些硬件环境?
A:SemIf 支持 CUDA GPU(推荐 RTX 3090 或同等及以上性能显卡)、Apple Silicon(通过 MPS/MLX 加速)、纯 CPU 环境以及浏览器 WebGPU 演示。默认 4B BF16 模型需要约 8GB 显存,用户可根据自身条件选择最合适的后端。
Q:共享状态模式(--mode shared)的适用条件是什么?
A:共享状态模式要求输入 JSONL 文件中所有行的 state 字段完全一致。满足该条件时,系统仅预填充一次共享前缀,随后并行评估所有决策标准,吞吐量可从 2.33 提升至最高 20.03 决策/秒。若各行的 state 存在差异,则需使用默认的 direct 模式。
Q:SemIf 的决策质量如何保证?
A:项目通过三重机制保障决策质量:一是固定 prompt 和模型版本确保可复现性;二是内置温度校准功能,按工作负载拟合缩放参数,使置信度与实际准确率对齐;三是提交已知失败案例至仓库,帮助使用者了解模型的能力边界。此外,27B 模型桥接方案可在人工决策任务上达到 0.958 的一致率。
Q:如何将 SemIf 集成到现有 Agent 系统中?
A:SemIf 以命令行工具形式提供,输出为 JSONL 格式,包含逐行选项概率和 prompt 哈希。开发者可通过子进程调用或将其封装为微服务接入现有系统。由于决策标准和选项随请求动态传入,无需为每个任务单独微调,集成成本较低。
Q:SemIf 的 27B 模型桥接是什么?
A:27B 模型桥接是 SemIf 提供的一种质量增强方案,通过在更大规模模型上执行相同的 logit 打分逻辑,在人工决策任务上达到 0.958 的一致率。该方案适用于对决策质量要求更高的场景,但需要相应的硬件资源支持。
9. 项目地址
- 项目官网:https://openjev.com/
- GitHub 仓库:https://github.com/TheoLeeCJ/SemIf-OpenJev
相关 AI 模型文章
Claude Haiku 5.5 – Anthropic 推出的最轻量级模型
Claude Haiku 5.5 是 Anthropic 于 2026 年 10 月 7 日正式发布的最新小型语言模型,定位为"最便宜、最快、最能打"的高性价比产品。该模型将输入价格降至 $0.10/百万 token,综合成本降低约 75%,同时实现了电脑操作能力从 15.7% 到 72.4% 的大幅跃升。其支持 100 万 token 上下文窗口和五档可调思考机制,适用于智能摘要、数据分类、实时...
Startlux-Decision – StartLux Labs 开源的决策模型家族深度评测
StartLux-Decision 是 StartLux Labs 推出的开源决策模型家族,涵盖从 0.8B 至 27B 的五个稠密模型以及 35B-A3B 混合专家模型,专为类型化决策任务设计。该模型家族接收文本、JSON 或图片形式的状态输入,针对选择、是非、评分等结构化问题,通过单次前向推理直接返回每个选项的概率分布,天然可作为置信度使用。模型原生支持 256K token 超长上下文,具备...
MAI-Transcribe-2-Streaming:微软实时流式语音转写模型深度评测
MAI-Transcribe-2-Streaming 是微软推出的首个实时流式语音转写模型,能够在讲话进行时持续输出文字,覆盖 60 种语言并自动检测语言切换。该模型在 Artificial Analysis 流式转写榜单中以 2.50% 的词错误率和 0.13 秒的最终转录延迟双双登顶,首批文本延迟低至数百毫秒,文字最快在语音后 320 毫秒显示。其核心价值在于将传统语音转写从"说完再识别"的批...
Ling-3.1-flash:蚂蚁百灵团队推出的大规模稀疏激活长流程任务模型
Ling-3.1-flash是蚂蚁集团百灵团队推出的新一代大语言模型,采用混合线性Attention架构与MoE稀疏激活技术,总参数量约560B,单Token激活参数仅约25B,支持高达1M的上下文窗口。该模型专为真实世界长流程任务设计,能够连续数小时自主完成办公报告撰写、医疗咨询、代码编译与性能优化等复杂工作,目前已接入蚂蚁内部桌面Agent客户端"小虎",并开放两周免费体验期。
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。