
Ling-3.1-flash:蚂蚁百灵团队推出的大规模稀疏激活长流程任务模型
导读摘要:
Ling-3.1-flash是蚂蚁集团百灵团队推出的新一代大语言模型,采用混合线性Attention架构与MoE稀疏激活技术,总参数量约560B,单Token激活参数仅约25B,支持高达1M的上下文窗口。该模型专为真实世界长流程任务设计,能够连续数小时自主完成办公报告撰写、医疗咨询、代码编译与性能优化等复杂工作,目前已接入蚂蚁内部桌面Agent客户端"小虎",并开放两周免费体验期。
1. Ling-3.1-flash是什么
Ling-3.1-flash是蚂蚁集团百灵团队推出的新一代大语言模型,采用混合线性Attention架构与MoE稀疏激活技术,总参数量约560B,单Token激活参数仅约25B,支持高达1M的上下文窗口。该模型专为真实世界长流程任务设计,能够连续数小时自主完成办公报告撰写、医疗咨询、代码编译与性能优化等复杂工作,目前已接入蚂蚁内部桌面Agent客户端"小虎",并开放两周免费体验期。
技术定位与领域: 属于自然语言处理与多模态生成领域,定位于长上下文、长流程Agent任务执行场景。与常规对话模型不同,Ling-3.1-flash强调在数小时连续执行中保持任务状态与目标一致性,而非每轮对话重新开始,这使其在工程化Agent应用领域具有独特定位。
研发背景: 由蚂蚁集团百灵团队研发,延续了Ling-3.0-flash的技术路线。蚂蚁在金融科技、医疗健康等垂直领域拥有深厚积累,团队基于阿福、好大夫等应用的真实需求反馈进行场景化强化学习对齐,旨在打造能够解决实际业务问题的生产级模型。
核心价值: 解决了传统大模型在长流程任务中状态丢失、上下文受限、推理成本高昂等核心痛点。通过混合线性架构与稀疏激活的配合,在保持模型容量的同时将推理成本控制在可接受范围,使企业级长任务自动化成为可能。
技术特点: 采用7层KDA配1层Gated MLA的混合架构,512个路由专家配合共享专家机制,以约25B激活参数驱动560B总参数;同时构建了需求梳理、任务规划、工具调用、结果校验与路径修正的完整工作链路,支持1M上下文下的高效长流程执行。
2. 主要功能
长流程任务闭环执行: 模型将需求梳理、任务规划、工具调用、中间结果校验与路径修正连接在同一条工作链路中,能够在数小时连续执行中保持目标与历史信息一致。这一能力使其区别于传统逐轮对话模型,可自主推进复杂工程任务,如用约17小时从零实现Lua原生编译器。
超长上下文处理: 支持1M上下文窗口,可一次性容纳长文档、大型代码库和完整任务历史。在免费体验期间上下文限制为256K,但已远超主流竞品的200K水平,显著减少人工切分信息的工作量,为长文档分析和大型代码库理解提供了基础能力。
日常办公自动化: 从一句模糊需求出发,自动拆解任务、整合网页/文档/表格中的分散资料,生成研究报告、Excel表格和PPT等完整交付物。该功能已在GDPVal-AA V2.1评测中获得Elo 1673的成绩,紧追Claude Opus 5的1708分。
医疗专业沟通: 经过基于阿福、好大夫等应用真实反馈的RLVR场景化对齐训练,能够将患者零散的症状描述转化为就诊清单、检查指标解读和用药复诊等可执行建议。在HealthBench Professional评测中取得65.35分,在同类flash模型中领先。
软件研发与调试: 能够在陌生代码库中持续数小时完成问题定位、代码修改、测试验证与迭代修复。实测中Pyright优化实现1.432倍加速且2279项测试全部通过,C图像库Rust重写达到8.015倍加速,展现了复杂工程任务的执行能力。
安全漏洞分析: 自主完成超长程漏洞挖掘、根因定位、PoC构造与补丁生成,已在OceanBase开源版本实战中成功修复高危栈溢出漏洞。该能力将安全分析从人工主导转变为模型自主推进,提升了漏洞响应的效率与覆盖范围。
Web/移动/3D开发: 支持生成营销网页、App界面、SVG矢量素材及Three.js 3D交互演示,覆盖前端开发与创意设计的多种产出形态,拓展了模型在设计与开发交叉领域的应用边界。
3. 如何使用
访问体验入口: 打开Ling Studio官网(https://chat.ant-ling.com/chat)或蚂蚁数科MaaS平台(https://maas.antdigital.com/models/modelservice-1790229240754001388)对应模型页面。两个入口均可访问Ling-3.1-flash,用户可根据使用习惯选择。
确认免费体验资格: 模型上线后提供为期两周的免费体验期,期间可直接使用全部功能,但上下文长度限制为256K。体验期结束后需通过付费方式继续使用,具体定价待官方公布。
直接描述任务需求: 无需编写复杂指令,用自然语言清晰描述目标即可。例如"帮我整理某行业资料并生成研究报告和PPT",模型会自动拆解任务并规划执行路径。
选择合适的使用方式: 单轮简单任务可直接在对话框中描述需求;Agent类长任务建议优先配合Claude Code、OpenCode或Pi等harness使用。harness能够更好地管理工具调用与中间状态,充分发挥模型的长时间执行能力。
跟进中间结果并反馈: 根据模型产出的中间成果及时补充信息或调整方向。模型会结合用户反馈修正执行路径、完善最终交付物,这一交互方式对于长流程任务的最终质量有直接影响。
4. 优缺点分析
| 优点 |
|---|
| 超长上下文窗口: 支持1M上下文,可容纳长文档、大型代码库和完整任务历史,减少人工切分信息的工作,为长流程任务提供基础能力支撑。 |
| 长流程任务能力强: 能连续数小时保持任务状态并自主推进,实测约17小时从零实现Lua原生编译器,Pyright优化1.432倍加速且2279项测试全过。 |
| 稀疏激活高性价比: 560B总参数仅激活约25B,配合混合线性架构,在模型容量与推理成本间取得平衡,降低企业级部署的算力门槛。 |
| 场景化对齐训练: 针对医疗等垂直场景进行RLVR强化学习,HealthBench Professional得分65.35领先同档flash模型,专业领域沟通能力经过真实需求验证。 |
5. 同类工具对比
| 对比维度 | Ling-3.1-flash |
|---|---|
| 核心架构 | 混合线性Attention(7层KDA配1层Gated MLA)+ MoE稀疏激活,总参数560B,激活25B |
| 上下文窗口 | 1M(免费期256K) |
| Lua编译器任务 | 97.8%(178/182项测试通过) |
| Pyright性能优化 | 1.432倍加速 |
| C图像库Rust重写 | 8.015倍加速 |
| 医疗评测 | HealthBench Professional 65.35(同档flash模型中领先) |
| 办公评测 | GDPVal-AA V2.1 Elo 1673(紧追Claude Opus 5的1708) |
| 开源计划 | 付费版上线后计划开源 |
| 获取成本 | 免费体验两周,之后付费 |
选型建议: 对于需要超长上下文处理的企业级Agent任务,如大型代码库分析、长文档研究、跨多数据源的报告生成等场景,Ling-3.1-flash的1M上下文窗口和长流程任务闭环能力具有明显优势,且免费体验期降低了评估成本。若项目对代码重写与优化的极致性能有硬性要求,如追求最大化的代码加速比,Claude Fable 5在C图像库Rust重写等任务中的表现更为突出。
对于医疗健康等垂直领域应用,Ling-3.1-flash经过场景化RLVR对齐训练,在HealthBench Professional评测中表现领先,且蚂蚁在金融、医疗领域有深厚的业务积累,更适合需要专业领域知识支撑的场景。而Claude Fable 5在通用代码生成精度上略胜一筹,适合对代码正确性要求极高的场景。团队应根据任务类型、性能需求和预算约束综合决策,也可在免费体验期内对Ling-3.1-flash进行针对性验证。
6. 编辑总结
Ling-3.1-flash在长上下文与长流程任务执行能力上展现了明确的技术创新。混合线性Attention架构中7层KDA配1层Gated MLA的设计,配合512个路由专家与共享专家的MoE机制,实现了560B总参数下仅25B激活参数的高效推理,这一架构选择在控制单步计算量的同时保留了模型容量,为1M上下文下的持续执行提供了工程基础。其长流程任务闭环设计将需求梳理、任务规划、工具调用、结果校验与路径修正连接为完整链路,解决了传统模型在多轮交互中状态丢失的顽疾,实测约17小时完成Lua编译器的案例验证了这一能力的实用价值。
从实用价值看,模型在办公自动化、医疗沟通、软件研发、安全分析等场景均有落地表现。GDPVal-AA V2.1 Elo 1673的成绩说明其在复杂办公任务中已接近头部模型水平;HealthBench Professional 65.35分验证了场景化RLVR对齐训练的有效性;OceanBase高危栈溢出漏洞的实战修复则证明了安全分析能力的可靠性。这些成果表明模型并非实验室演示,而是具备生产环境适用性的工程产品。
适用人群方面,该模型适合需要处理长文档、大型代码库、复杂多步骤任务的企业开发者、安全研究人员、医疗信息化团队以及办公自动化需求方。免费体验期降低了评估门槛,付费版上线后的开源计划则为二次开发提供了可能。
从发展潜力看,Ling-3.1-flash的架构方向与Agent应用趋势高度契合。随着Agent类应用从演示走向生产,长上下文与长流程执行能力将成为核心竞争维度。蚂蚁在垂直领域的业务积累为模型提供了持续的场景反馈与优化数据,若开源计划顺利落地,有望在开发者生态中形成影响力。不过其在代码重写等部分任务上与头部模型的差距仍需后续版本迭代弥补。
7. 应用场景
日常办公自动化: 将分散在网页、文档、表格中的资料整合为研究报告、数据表格和汇报PPT。用户只需输入一句模糊需求,模型自动完成资料检索、数据分析与成果生成,适合市场调研、行业分析、汇报材料准备等场景,可显著减少人工整理时间。
医疗健康管理: 患者用自然语言描述零散症状,模型通过澄清症状、梳理病史、解读检查报告,将不适转化为就诊清单,并给出用药和复诊的行动建议。适用于在线问诊辅助、健康咨询、慢病管理随访等场景,帮助医疗机构提升沟通效率与服务质量。
软件研发与调试: 开发者面对陌生代码库时,模型可帮助读懂代码结构、建立测试基线、定位并修复问题,支持数小时级的持续迭代。已在Lua编译器实现、Pyright性能优化、C图像库Rust重写等任务中验证,适合遗留系统维护、性能优化、跨语言迁移等研发场景。
安全漏洞分析: 模型自主完成漏洞挖掘、根因定位、PoC构造与补丁生成的全流程。已在OceanBase开源版本实战中修复高危栈溢出漏洞,适用于企业安全团队进行代码审计、漏洞响应、安全补丁开发等工作,可提升安全分析的自动化水平与响应速度。
前端与创意开发: 支持生成营销网页、App界面、SVG矢量素材及Three.js 3D交互演示,覆盖从概念到成品的快速原型开发。适合营销活动页面制作、产品Demo搭建、创意素材生产等场景,降低前端开发与设计协作的沟通成本。
8. 常见问题FAQ
Q:Ling-3.1-flash的免费体验期是多久?有什么限制?
A:免费体验期为两周,期间可使用模型全部功能,但上下文长度限制为256K,低于完整版的1M。体验期结束后需通过付费方式继续使用,具体定价方案待官方公布。
Q:Ling-3.1-flash的1M上下文窗口在实际使用中意味着什么?
A:1M上下文可一次性容纳约数十万字的文档或大型代码库,模型无需人工切分信息即可理解完整任务背景。在免费期内256K的限制下,建议优先处理中等规模任务,完整版体验需等待付费开放。
Q:Ling-3.1-flash是否支持本地部署?
A:目前模型未开源,不支持本地部署。官方计划在付费版上线后开源,届时开发者可基于开源版本进行本地部署与二次开发。当前仅能通过Ling Studio官网或蚂蚁数科MaaS平台在线使用。
Q:Ling-3.1-flash与Claude Fable 5相比,在代码任务上表现如何?
A:在Lua编译器任务中,Ling-3.1-flash通过率97.8%(178/182),略低于Claude Fable 5的99.0%;Pyright优化为1.432倍加速,接近1.502倍;C图像库Rust重写为8.015倍加速,明显低于27.310倍。总体而言,通用代码生成精度与极致优化场景中Claude Fable 5占优,但Ling-3.1-flash在长上下文与长流程代码任务上具备差异化优势。
Q:Ling-3.1-flash的医疗能力是如何训练的?
A:模型针对医疗等垂直场景,基于阿福、好大夫等应用的真实需求反馈进行RLVR(基于规则的强化学习)场景化对齐训练,重点提升专业表达与多轮沟通能力。在HealthBench Professional评测中取得65.35分,在同类flash模型中领先。
Q:Agent类长任务使用Ling-3.1-flash时有哪些注意事项?
A:建议配合Claude Code、OpenCode或Pi等harness使用,这些工具能够更好地管理工具调用与中间状态。同时需根据模型产出的中间成果及时补充信息或调整方向,模型会结合反馈修正执行路径,这一交互方式对最终交付质量有直接影响。
9. 项目地址
- Ling Studio官网: https://chat.ant-ling.com/chat (官方体验入口,提供免费体验)
- 蚂蚁数科MaaS平台: https://maas.antdigital.com/models/modelservice-1790229240754001388 (模型服务页面)
相关 AI 模型文章
Claude Haiku 5.5 – Anthropic 推出的最轻量级模型
Claude Haiku 5.5 是 Anthropic 于 2026 年 10 月 7 日正式发布的最新小型语言模型,定位为"最便宜、最快、最能打"的高性价比产品。该模型将输入价格降至 $0.10/百万 token,综合成本降低约 75%,同时实现了电脑操作能力从 15.7% 到 72.4% 的大幅跃升。其支持 100 万 token 上下文窗口和五档可调思考机制,适用于智能摘要、数据分类、实时...
Startlux-Decision – StartLux Labs 开源的决策模型家族深度评测
StartLux-Decision 是 StartLux Labs 推出的开源决策模型家族,涵盖从 0.8B 至 27B 的五个稠密模型以及 35B-A3B 混合专家模型,专为类型化决策任务设计。该模型家族接收文本、JSON 或图片形式的状态输入,针对选择、是非、评分等结构化问题,通过单次前向推理直接返回每个选项的概率分布,天然可作为置信度使用。模型原生支持 256K token 超长上下文,具备...
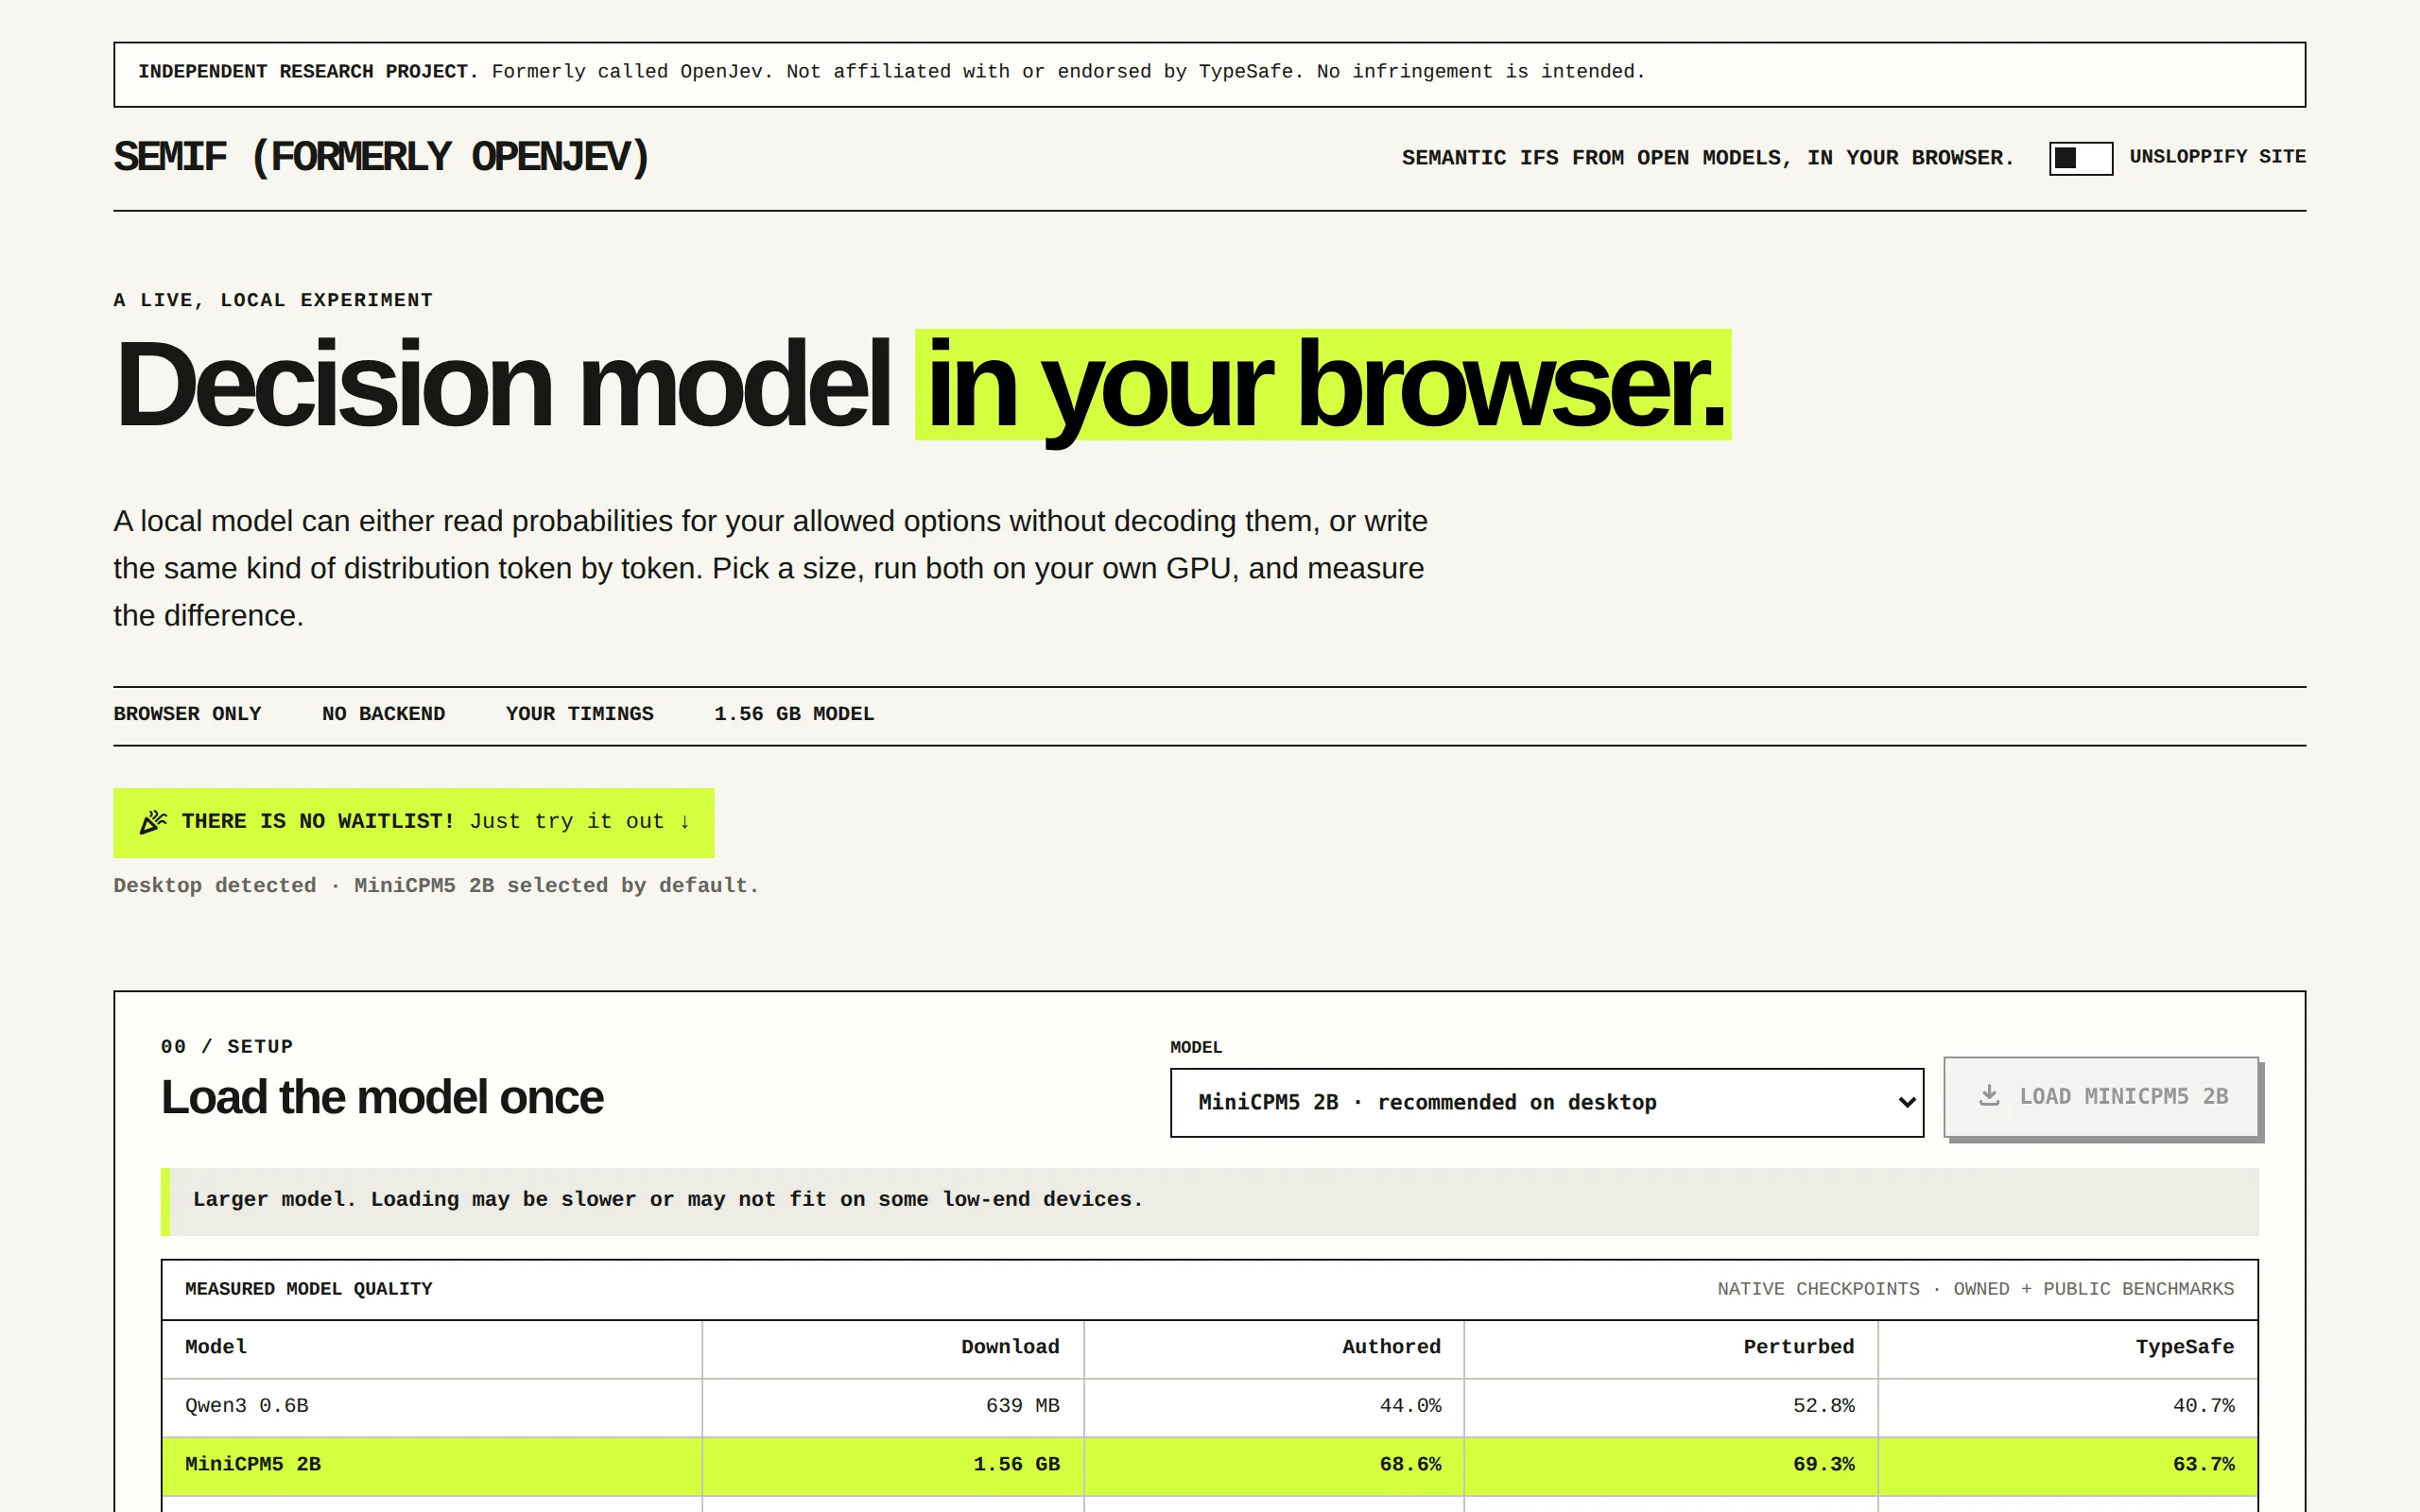
SemIf – 开源的 AI 决策模型,复现 Jev 语义决策模式
SemIf(原 OpenJev)是一个开源的 AI 决策模型,旨在通过开源手段复现 TypeSafe 闭源服务 Jev 的语义决策接口模式。该模型采用单次前向传播机制,直接读取候选选项对应的 logits 进行打分,由服务端构造结构化结果,从而规避了传统自回归生成后再解析文本的复杂流程。在多个问题共享相同状态时,SemIf 还可复用前缀计算,吞吐量提升近一个数量级。该模型在单张 RTX 3090 ...
MAI-Transcribe-2-Streaming:微软实时流式语音转写模型深度评测
MAI-Transcribe-2-Streaming 是微软推出的首个实时流式语音转写模型,能够在讲话进行时持续输出文字,覆盖 60 种语言并自动检测语言切换。该模型在 Artificial Analysis 流式转写榜单中以 2.50% 的词错误率和 0.13 秒的最终转录延迟双双登顶,首批文本延迟低至数百毫秒,文字最快在语音后 320 毫秒显示。其核心价值在于将传统语音转写从"说完再识别"的批...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。