
DeepInfer – DeepSeek 开源的生产级推理框架深度评测
导读摘要:
DeepInfer 是 DeepSeek 开源的生产级大模型推理框架,源自 vLLM 代码库,专为 DeepSeek-V4.1-Flash 模型设计,同时支持英伟达 SM100 GPU 与华为昇腾 950 NPU 两大算力生态。该框架通过 PD 分离部署架构,将 Prefill 与 Decode 阶段部署在不同硬件上,并依托 3FS 分布式缓存集群实现 96% 的输入缓存命中率,使 Prefill...
1. DeepInfer是什么
DeepInfer 是 DeepSeek 开源的生产级大模型推理框架,源自 vLLM 代码库,专为 DeepSeek-V4.1-Flash 模型设计,同时支持英伟达 SM100 GPU 与华为昇腾 950 NPU 两大算力生态。该框架通过 PD 分离部署架构,将 Prefill 与 Decode 阶段部署在不同硬件上,并依托 3FS 分布式缓存集群实现 96% 的输入缓存命中率,使 Prefill 吞吐提升约 25 倍。同步开源的 deepseek-recipe 组件负责 API 协议对齐,确保自部署模型与官方 API 行为一致。
技术定位与领域: DeepInfer 属于大模型推理与服务优化领域,专注于生产环境的超高吞吐、低成本推理服务,面向企业私有化部署与大规模在线推理场景。其差异化定位在于"专模专用"——不追求通用性,而是为 DeepSeek 自家模型深度定制优化路径,将推理效率推至极限。
研发背景: 该框架由 DeepSeek 官方团队开源,源自其大规模线上服务的实际生产验证。DeepSeek 在 V4.1 Flash 的部署运营中积累了海量真实流量数据与性能调优经验,将此前仅内部使用的推理优化技术全面开源,体现了其向基础设施领域延伸的战略意图。
核心价值: 解决自部署 DeepSeek 模型性能不及官方 API 的痛点。此前开发者自建推理服务难以复现官方 API 的低延迟与高吞吐,DeepInfer 结合 deepseek-recipe 组件,使自部署模型在接口表现和性能水平上均与官方 API 对齐,大幅降低企业采用开源模型的门槛。
技术特点: 核心创新集中在四个方面:PD 分离部署实现硬件最优分工;SWA Bounded Replay 将长上下文重算成本固定为 128 个 Token;DSpark 推测解码配合置信度调度提升生成吞吐约 6%;3FS 前缀缓存集群实现 96% 命中率。据官方数据,线上单集群日处理量达 155 万亿 Token,首字延迟仅 400ms。
2. 主要功能
PD 分离部署: DeepInfer 将推理流程拆分为 Prefill(预填充)与 Decode(解码)两个独立阶段,分别部署在硬件配置差异显著的机器上。Prefill 阶段使用常规 8 卡服务器,利用高算力集中处理数万 Token 的输入;Decode 阶段使用 64–128 卡超节点,满足逐 Token 生成对显存带宽的密集需求,两类机器约按 1:1 配置,使各阶段硬件都能按最优特性运行。
3FS 前缀缓存集群: 系统以 128 Token 为块写入独立的 3FS 分布式存储集群,仅缓存从首 Token 起完全一致的前缀,命中部分直接复用 KV Cache,仅计算新增内容。Agent 场景下每次工具调用都会重发完整历史,该机制大幅降低重复计算。缓存保留策略区分流量类型:Agent 流量保留 3 天、聊天流量保留 7 天,兼顾命中率与存储成本。
SWA Bounded Replay: 针对 V4.1 Flash 部分层采用的滑动窗口注意力机制定制优化。由于每个 Token 仅关注最近 128 个 Token,其 KV Cache 不写入硬盘、仅驻留在计算机器内存中。缓存未命中时,传统方案需按"层数 × 窗口长度"精确重算,DeepInfer 改为只重算最后 128 个 Token 且注意力仅在此范围内计算,得到近似窗口缓存,使预填充总计算量近乎减半,且成本与上下文长度和层数完全解耦。
DSpark 推测解码与异步调度: 由轻量草稿模块连续猜测 5 个 Token,目标模型批量验证,猜对的直接采用、首个猜错处由大模型纠正,一步计算即可推进多个 Token。置信度头用于预估各猜测被接受的概率,低可能性猜测不再验证、将算力让给其他请求,相比固定验证 5 个的方案线上吞吐提升 6%。同时 CPU 调度第 N+1 步与 GPU 计算第 N 步重叠执行,消除 GPU 在调度间隙的空转。
MoE 专家负载均衡: 针对混合专家模型的专家分布不均问题,系统每 10000 步动态重排专家副本在卡间的分布,动态均衡专家与请求的负载。根据线上数据,最繁忙的卡仅高出平均负载 9%,整体均衡状态达到理想值的 80%,有效避免"木桶效应"导致的整体吞吐下降。
双硬件平台适配: 同时支持英伟达 SM100 GPU 与华为昇腾 950 NPU,覆盖两大主流算力生态。通过统一抽象层屏蔽底层硬件差异,同一套代码无需修改即可在不同平台编译运行,是目前极少数能同时提供 CUDA 与 CANN 双栈支持的生产级推理框架。
API 行为对齐(deepseek-recipe): 同步开源的 deepseek-recipe 是生产级 Token 编解码组件,统一处理 Chat Completions、Responses、Messages 三种 API 格式的协议转换,覆盖注入防护、并行分词与流式输出等细节,使自部署模型的接口表现与 DeepSeek 官方 API 完全一致。
3. 如何使用
环境前置条件确认: 操作系统要求 Linux,编译器要求 GCC ≥ 13.0,Python 版本需为 3.12。硬件平台二选一:NVIDIA 平台需安装 CUDA 13,昇腾平台需安装 CANN 9.2。不同硬件平台的依赖差异较大,需在编译前确认环境完整性。
克隆仓库: 执行
git clone https://github.com/deepseek-ai/DeepInfer克隆主仓库,如需 API 对齐能力可同时克隆https://github.com/deepseek-ai/deepseek-recipe组件仓库。克隆完成后进入 DeepInfer 目录查看项目结构。创建干净的 Python 环境: 新建并激活一个空的 Python 3.12 虚拟环境(如使用
python3.12 -m venv venv创建、source venv/bin/activate激活),避免与系统已有 Python 包产生依赖冲突。此步骤直接影响编译成功率,建议在全新环境中操作。选择硬件平台并编译: 根据目标硬件执行
export DEEPINFER_ACCELERATOR=nvidia(昇腾平台改为ascend),随后运行./build.sh从源码构建。注意该环境变量不仅影响编译阶段,还需在后续运行环境中保持生效,否则运行时可能出现硬件识别失败。准备模型权重: 默认首次运行会自动从 Hugging Face 下载
deepseek-ai/DeepSeek-V4.1-Flash-1017模型权重。如需离线部署,可用export DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017环境变量指向本地已有的模型副本,避免重复下载。运行离线推理验证: 执行
python examples/offline_inference.py启动推理测试,验证环境配置与模型加载是否正常。更多使用方式参考仓库examples目录中的各类示例脚本,可根据实际场景选择合适的示例进行修改。
4. 优缺点分析
| 优点 |
|---|
| 生产验证的超高性能: 已在 V4.1 Flash 大规模线上服务中实际运行,单集群日处理 155 万亿 Token,首字延迟 400ms,生成速度 230 tokens/s,性能指标经受了真实流量的检验。 |
| 缓存复用效率极高: 3FS 前缀缓存集群实现 96% 输入命中率,Prefill 每卡吞吐从 6 万提升至 150 万 tokens/s(提升约 25 倍),对 Agent 高频工具调用场景的降本效果显著。 |
| 长上下文成本可控: SWA Bounded Replay 将缓存未命中重算量固定为最后 128 个 Token,Prefill 总计算量近乎减半,且成本与上下文长度无关,长文档处理的经济性突出。 |
| 双算力生态覆盖: 原生同时支持英伟达 SM100 与华为昇腾 950,是国内少有的能同时覆盖 CUDA 与 CANN 双栈的生产级框架,对信创场景有重要价值。 |
| 负载均衡表现优秀: MoE 专家动态重排机制实现接近理想的负载分布,最繁忙的卡仅高出平均负载 9%,有效避免单卡过载导致的整体吞吐下降。 |
5. 同类工具对比
| 维度 | DeepInfer | vLLM | SGLang |
|---|---|---|---|
| 核心定位 | DeepSeek 模型专用生产级推理框架 | 通用大模型推理与服务框架 | 高性能 LLM 推理框架,侧重结构化输出 |
| 模型支持 | 目前仅 DeepSeek V4.1 Flash | 几乎所有开源模型(数百种) | 主流开源模型(LLaMA、Qwen、DeepSeek 等) |
| 硬件支持 | 英伟达 SM100、华为昇腾 950 | 英伟达全系 + AMD/昇腾/TPU 等 | 英伟达为主,开源社区扩展中 |
| 核心优化 | DSpark 推测解码、SWA Bounded Replay、96% 缓存命中 | PagedAttention、Continuous Batching、Prefix Caching | RadixAttention 缓存、结构化输出加速 |
| 性能水平 | 单集群日处理 155 万亿 Token,每卡 Decode 14K tokens/s | 通用场景性能优秀,生态主流基准 | 长上下文缓存命中率高,输出速度较快 |
| 生产验证 | DeepSeek 官方大规模线上服务验证 | 全球大量企业线上部署,生态最成熟 | 多家头部 AI 公司生产环境使用 |
| API 对齐 | 配合 deepseek-recipe 完全对齐官方 API | 支持 OpenAI 兼容 API | OpenAI 兼容 API + 结构化生成 |
| 服务化能力 | 开源版仅离线推理 | 完整在线服务、API 服务、集群调度 | 完整在线服务与 API 功能 |
| 开源协议 | MIT 等宽松许可证 | Apache 2.0 | Apache 2.0 |
| 生态成熟度 | 刚开源,社区起步 | 最活跃的推理框架社区,插件丰富 | 社区活跃度较高,发展迅速 |
选型建议: 如果企业的核心诉求是自部署 DeepSeek 模型并追求官方级的性能表现,DeepInfer 是最合适的选择,其 DSpark 推测解码与 SWA Bounded Replay 是为 V4.1 Flash 架构深度定制的优化,通用框架难以复现同等水平。配合 deepseek-recipe 可实现与官方 API 的无缝对接,适合已有 DeepSeek API 调用经验、希望迁移至私有化部署的团队。
若企业需要同时服务多种开源模型,或希望快速上线通用推理服务,vLLM 的模型兼容性与生态成熟度仍是首选。SGLang 则在需要结构化输出或长上下文高缓存命中率的场景中值得关注,而 TensorRT-LLM 适合已深度绑定 NVIDIA 硬件且追求极致单卡性能的团队。DeepInfer 后续是否会扩展模型支持范围,值得持续关注。
6. 编辑总结
DeepInfer 的最大价值在于证明了"专模专用"推理框架的可行性与实效性。DeepSeek 将其在 V4.1 Flash 大规模线上服务中积累的优化经验——PD 分离部署、SWA Bounded Replay、DSpark 推测解码、3FS 前缀缓存——完整开源,使外部开发者能够复现官方 API 级别的推理性能。据官方数据,单集群日处理 155 万亿 Token、Prefill 吞吐提升约 25 倍、长上下文计算量近乎减半,这些指标在通用推理框架中难以同时达成,体现了深度定制优化的实际效益。
从实用价值看,DeepInfer 精准切入两个关键痛点:一是企业私有化部署 DeepSeek 模型时面临的性能落差问题,deepseek-recipe 组件使接口表现与官方 API 完全一致,极大降低迁移成本;二是国产化算力适配需求,原生支持华为昇腾 950 使其在信创场景中具备差异化竞争优势,摆脱对英伟达硬件的依赖。
适用人群主要包括三类:一是需要高性价比自建推理服务的创业公司与中型企业,借助每卡高吞吐与 230–300 tokens/s 的生成速度,替代按量付费的官方 API;二是政企与金融机构的国产化算力部署需求;三是对推理性能极致追求的技术团队,可从中借鉴 PD 分离、滑动窗口缓存等前沿优化思路。
DeepInfer 当前的主要局限在于模型支持范围窄和开源版功能受限,其后续发展取决于 DeepSeek 是否会扩展模型适配并逐步开放在线服务能力。考虑到 DeepSeek 官方团队的持续投入与 V4.1 系列模型的市场影响力,DeepInfer 有望在 DeepSeek 生态内成为标准推理基础设施,并在国产推理框架领域占据重要位置。
7. 应用场景
企业私有化部署: 企业在本地数据中心部署 V4.1 Flash 模型,借助 deepseek-recipe 组件对齐官方 API 行为,实现数据不出域的合规推理。适合金融、医疗、法律等数据敏感行业,在保障数据安全的同时获得与官方 API 一致的接口体验,业务系统无需大量改造即可迁移。
国产化算力适配: 原生支持华为昇腾 950 NPU,满足政企、国防、能源等信创场景对自主可控算力的要求。IT 团队可在昇腾平台上编译运行 DeepInfer,实现从芯片到框架全链条国产化,摆脱对英伟达 CUDA 生态的依赖,符合国家信创政策导向。
大规模 Agent 服务: Agent 场景下每次工具调用都会重发完整历史对话,96% 的前缀缓存命中率大幅降低多轮调用的重复计算成本。适合智能客服、代码助手、自动化工作流等高频工具调用型 Agent 平台,在保证低延迟响应的同时显著降低推理成本。
超长上下文文档处理: SWA Bounded Replay 机制将长文本 Prefill 计算量近乎减半,且成本与上下文长度无关。适合合同审查、代码库分析、学术论文研读等超长输入场景,能够在可控成本内快速完成海量文本的预填充处理,提升整体响应效率。
高性价比自建推理服务: 每卡每秒生成 14K Token 的高吞吐与 230–300 tokens/s 的生成速度,适合有规模化推理需求的创业公司和技术团队。相比按量付费的官方 API,自建 DeepInfer 服务的边际成本更低,在高调用量场景下可显著节省推理费用,实现规模化省钱。
8. 常见问题FAQ
Q:DeepInfer 与 vLLM 是什么关系?
A:DeepInfer 的代码库源自 vLLM,是在其基础架构上为 DeepSeek V4.1 Flash 模型深度定制的生产级推理框架。vLLM 是通用推理框架,支持数百种模型;DeepInfer 则聚焦单一模型,将 DSpark 推测解码、SWA Bounded Replay 等面向 V4.1 Flash 架构特性的优化集成其中,追求该模型的最优推理性能。
Q:DeepInfer 支持哪些硬件平台?
A:DeepInfer 同时支持英伟达 SM100 GPU 与华为昇腾 950 NPU 两大算力平台。编译前需通过 DEEPINFER_ACCELERATOR 环境变量指定目标平台(nvidia 或 ascend),NVIDIA 平台需要 CUDA 13,昇腾平台需要 CANN 9.2,硬件要求相对较高。
Q:PD 分离部署是什么?为什么能提升性能?
A:PD 分离部署将 Prefill(预填充)与 Decode(解码)两个阶段部署在不同硬件上。Prefill 一次性处理数万 Token,是计算密集型任务,使用 8 卡常规服务器即可发挥算力;Decode 逐 Token 生成,受限于显存带宽读取速度,需要 64–128 卡超节点的大量显存带宽。两类机器约按 1:1 配置,使各阶段硬件按最优特性运行,避免传统混合部署中两类任务相互争抢资源的效率损失。
Q:SWA Bounded Replay 的核心优势是什么?
A:SWA Bounded Replay 针对 V4.1 Flash 部分层使用的滑动窗口注意力机制优化,将缓存未命中时的重算量固定为最后 128 个 Token,重算成本与传统方案"层数 × 窗口长度"的计算量解耦。这意味着无论上下文多长,未命中时的修复成本都是固定的,长上下文场景的 Prefill 总计算量可近乎减半。
Q:DeepInfer 开源版与官方线上服务有什么区别?
A:DeepInfer 开源版提供了与线上服务相同的核心推理引擎和优化技术(PD 分离、缓存复用、推测解码等),但仅包含离线推理能力。官方线上服务还包括完整的在线 API 服务、集群调度、监控运维等生产配套组件,这些在开源版中需要用户自行构建。API 协议对齐方面,可配合 deepseek-recipe 组件实现。
Q:deepseek-recipe 组件是必需的吗?
A:不是必需的,但强烈建议使用。DeepInfer 核心引擎只负责推理计算,而 deepseek-recipe 负责 Chat Completions、Responses、Messages 三种 API 格式的统一编解码、注入防护、并行分词与流式输出等协议层逻辑。如果自部署服务需要与官方 API 完全兼容,deepseek-recipe 能大幅降低接口适配工作量。
Q:模型权重从哪里获取?
A:默认首次运行时会自动从 Hugging Face 下载 deepseek-ai/DeepSeek-V4.1-Flash-1017 模型权重。如需离线部署或使用已有模型副本,可通过 DEEPINFER_HF_MODEL_DIR 环境变量指定本地路径,避免重复下载。具体获取方式建议参考 DeepSeek 官方模型发布说明。
9. 项目地址
- 官方 GitHub 仓库:https://github.com/deepseek-ai/DeepInfer
- deepseek-recipe 组件仓库:https://github.com/deepseek-ai/deepseek-recipe
- Hugging Face 模型权重:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
相关推荐
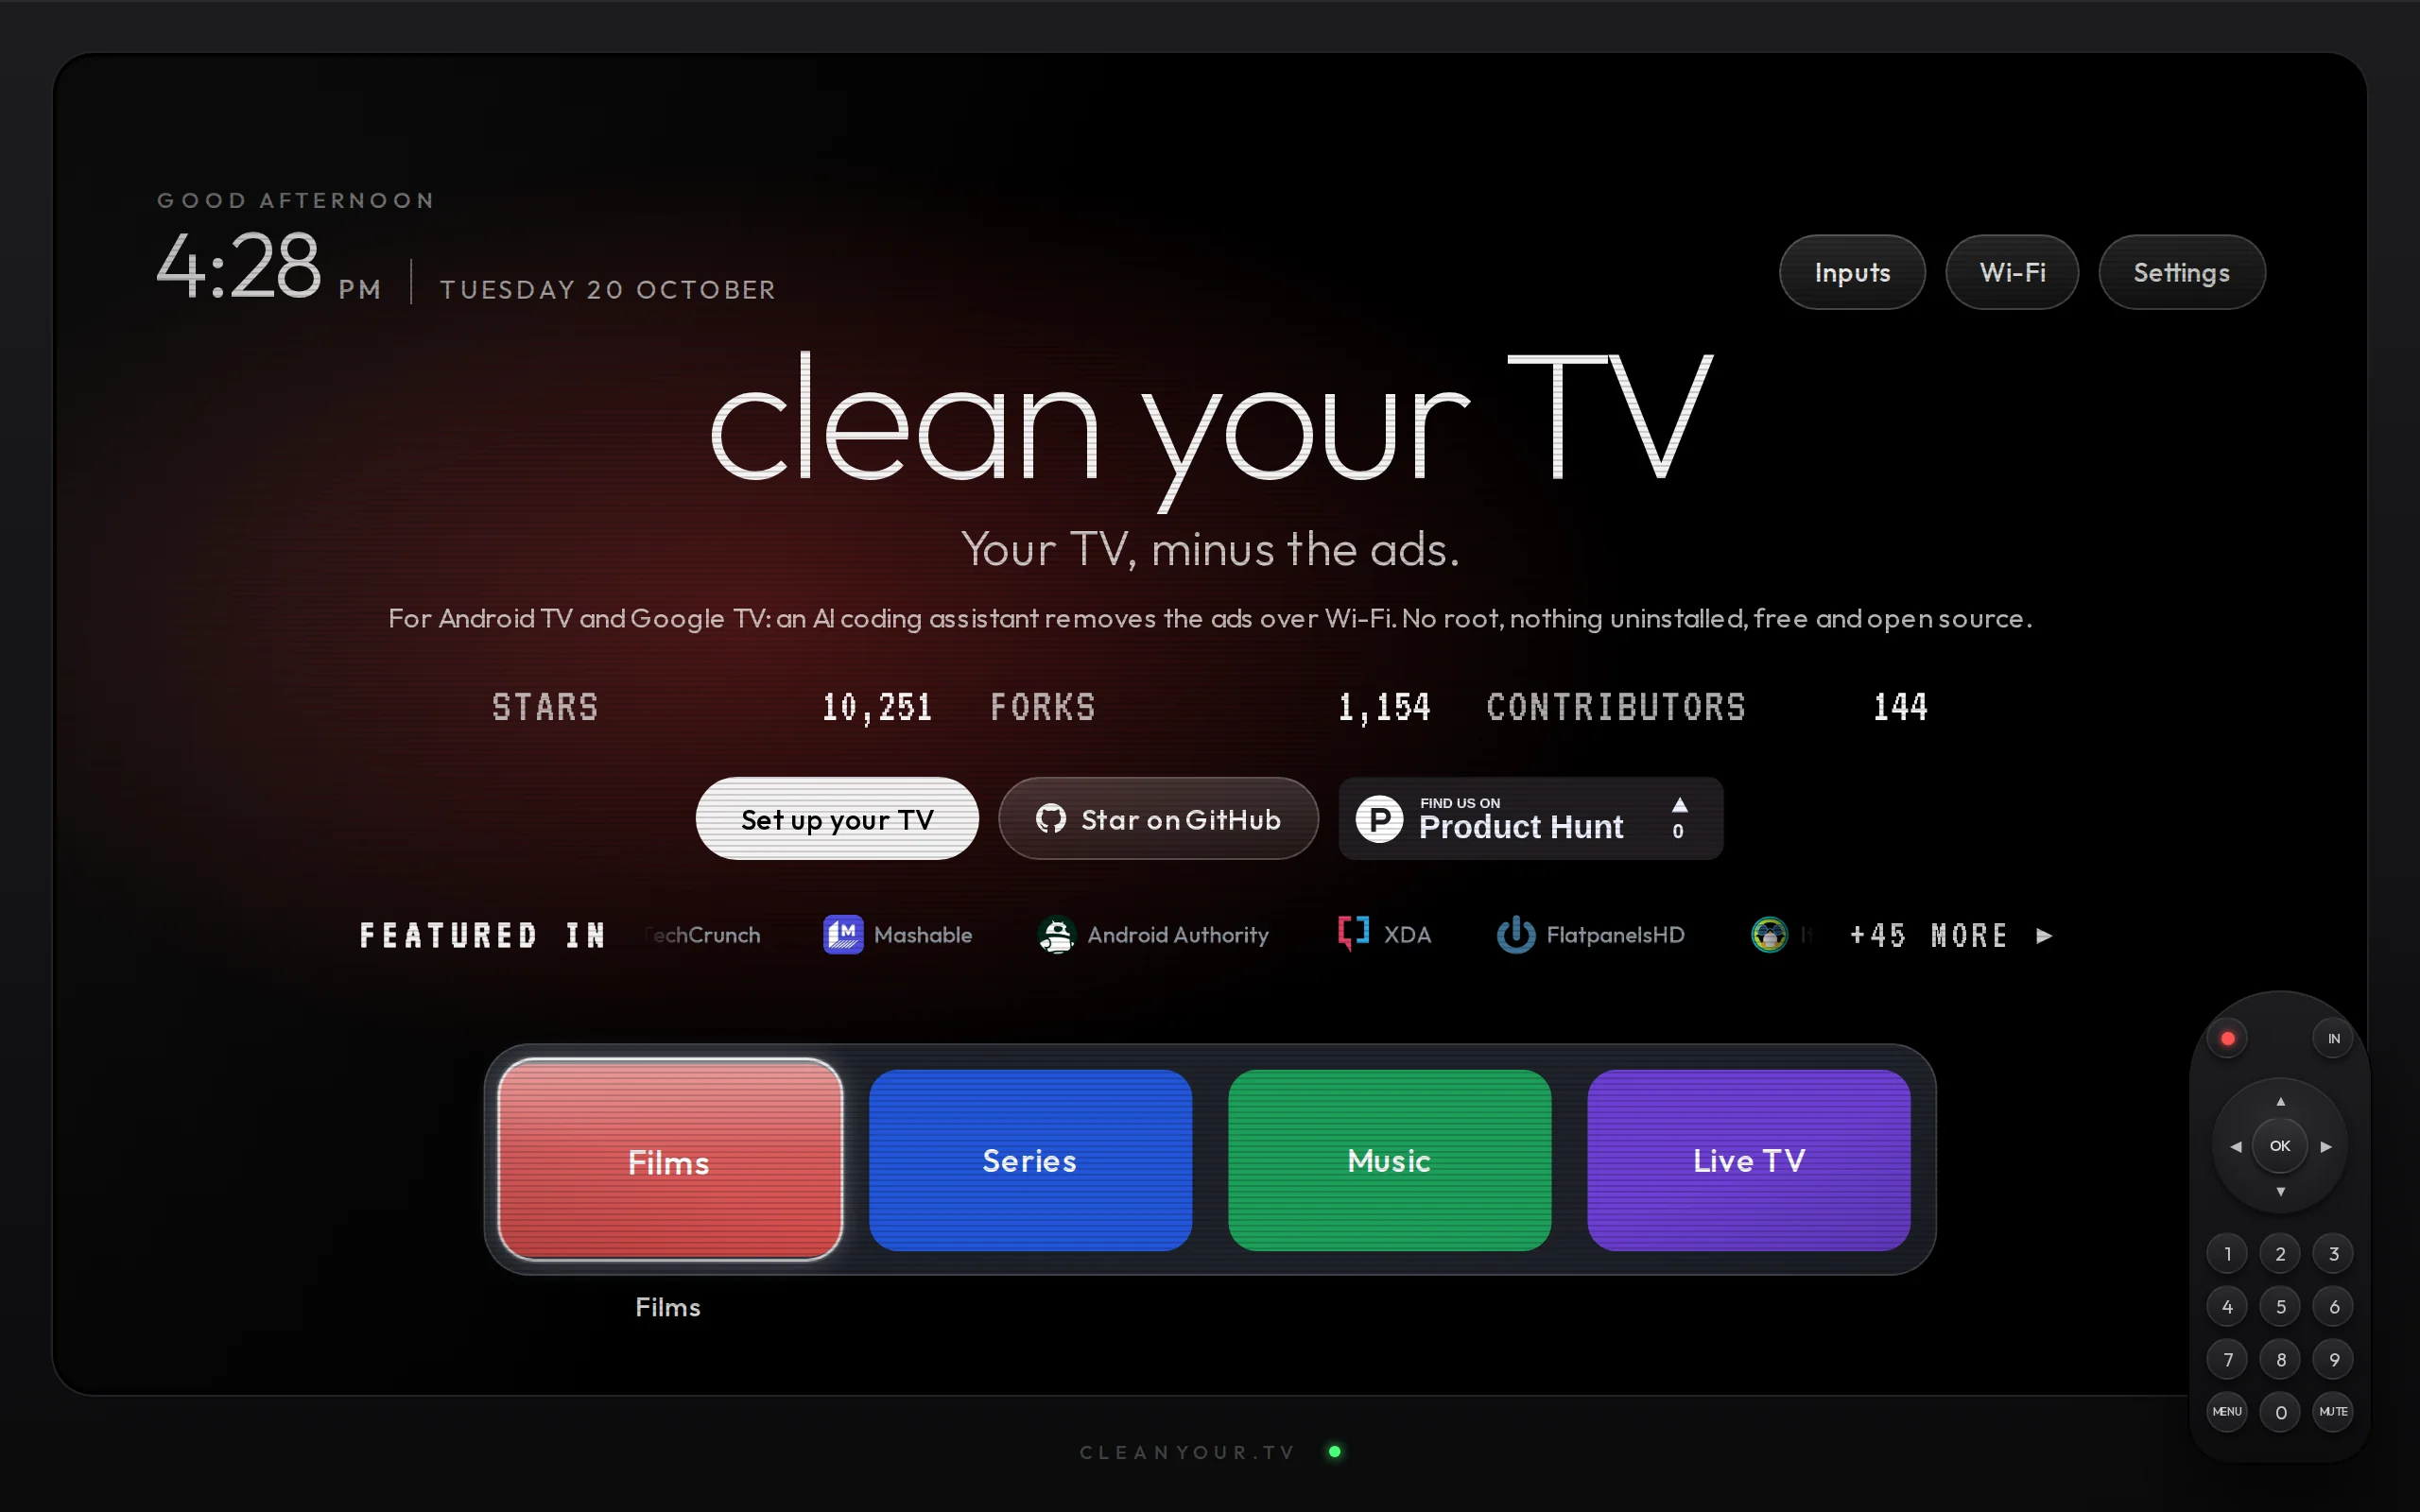
CleanYourTV – 开源的电视广告去除工具,垃圾软件全清空
CleanYourTV 是一款开源的电视系统优化工具,通过 Wi-Fi 网络利用 ADB(Android Debug Bridge)协议连接安卓电视,借助 Claude Code、Codex、Gemini CLI 等 AI Agent 自动识别并停用厂商预装的广告应用、数据遥测服务和臃肿软件,同时安装一款风格类似 Apple TV 的极简桌面 Launcher。该工具全程无需 Root 权限、不卸...

MiniMax M3.1 Flash – MiniMax 推出的一代 Flash 模型
MiniMax M3.1 Flash是MiniMax于2026年推出的新一代Flash系列模型,以匿名“Space Bunny”身份在各大评测基准中亮相,训练数据量超过200T Token。该模型在Agentic任务、编程、Computer Use及网络安全四大领域均展现出色表现,DeepSWE v1.1得分73.7%、OSWorld V2得分61.7、CyberGym得分82%,已全面上线Min...
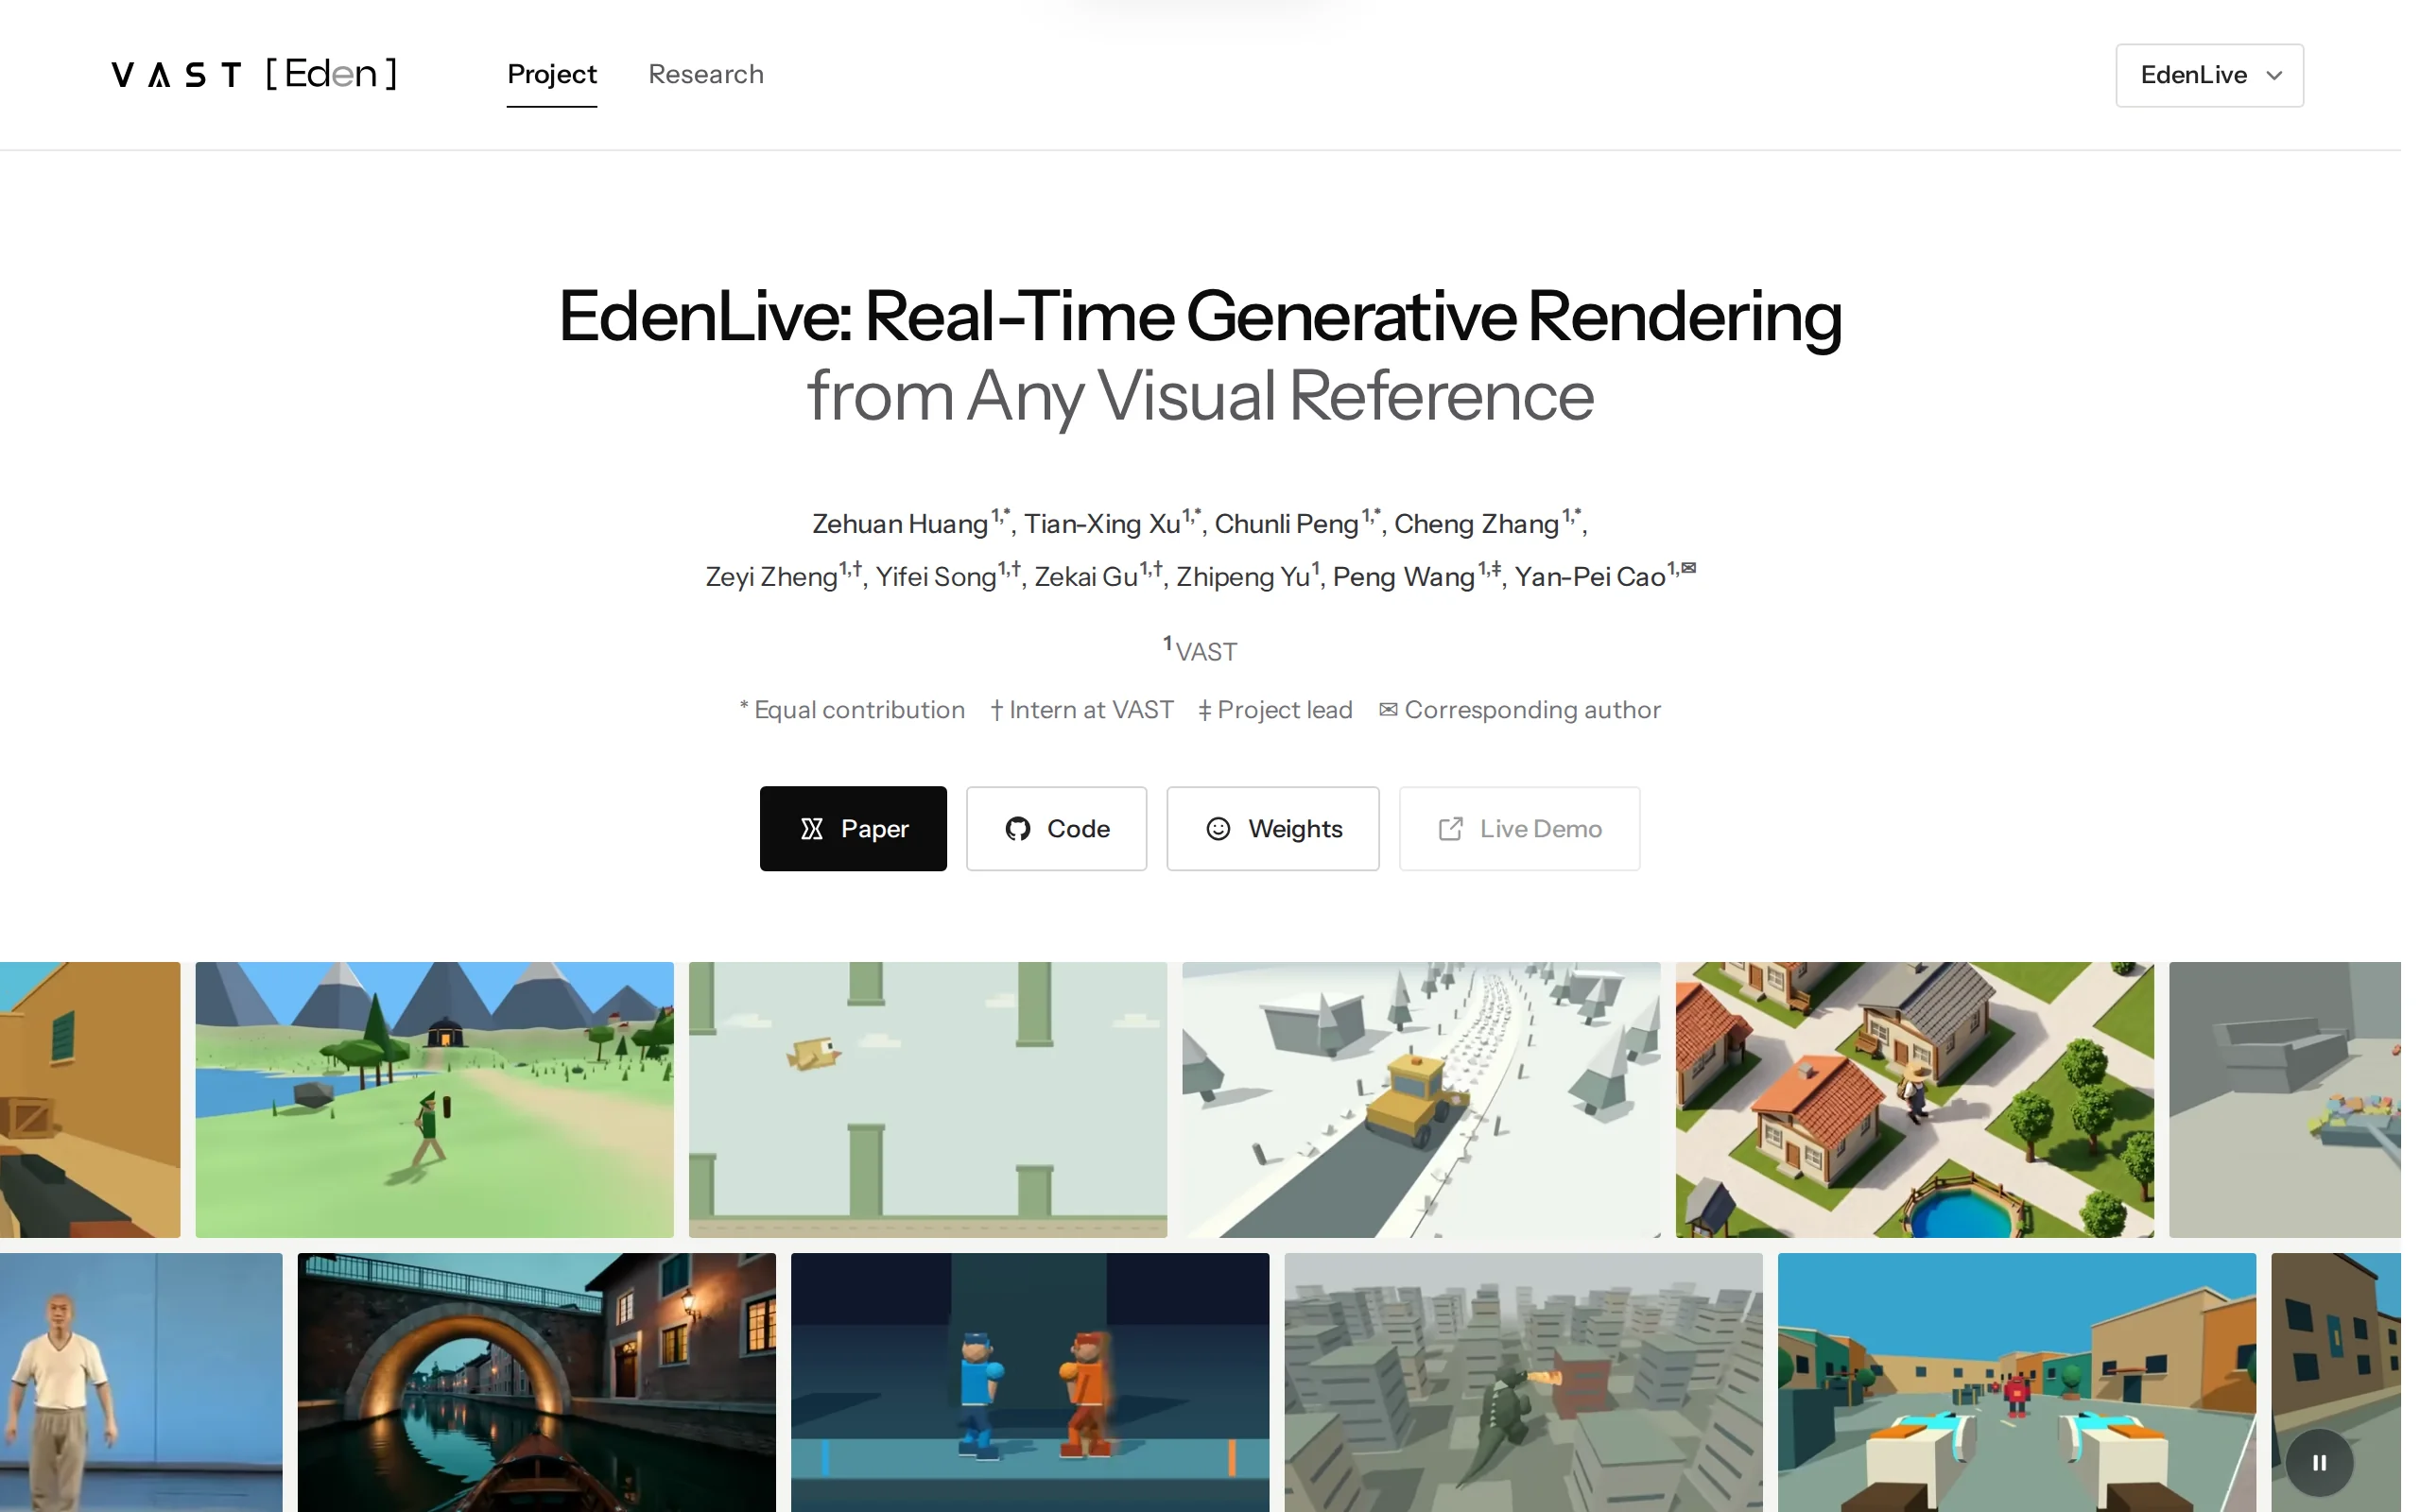
EdenLive – VAST 推出的实时生成式渲染器,重构世界模型渲染范式
EdenLive 是 VAST 推出的实时生成式渲染器,也是其世界模型项目 Project Eden 的阶段性成果。该工具以 Proxy 简化画面或参考视频为控制信号,结合目标首帧与文本提示词,持续实时生成写实或风格化画面,在单张 RTX 5090 上即可实现 720P、24FPS 以上的输出,端到端延迟仅百毫秒量级。其核心设计在于将世界状态维护与视觉渲染解耦,使视频模型不再承担隐式状态推断,从而...
Void – 开源的全栈开发部署工具,创作部署一体化
Void 是由尤雨溪团队开源的全栈开发部署工具,包含 SDK、CLI 和团队部署平台三部分。该工具将 Vite 应用的开发流程——编写代码、连接数据库、部署上线——串联为一套完整的工作流。本地开发时自动配置本地资源,部署时一键对接 Cloudflare 的 D1、KV、R2 等服务,免去繁琐的手动配置。团队平台允许管理员统一管控云账号权限,成员可安全地部署内部应用。Void 支持 Nuxt、Sve...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。