
FreeToken:开源端侧MoE大模型推理系统,实现消费级硬件满血运行

导读摘要:
FreeToken是由UC Berkeley与MIT等机构联合开源的端侧MoE大模型推理系统,将个人电脑的CPU、内存、PCIe总线与GPU统一为弹性计算平台。系统通过全层双缓冲预取、带宽自适应混合调度、Agent状态复用及弹性显存热扩缩容等核心技术,实现单卡消费级硬件满血运行Qwen3.6-35B、DeepSeek-V4-Flash 284B等超大MoE模型,显著降低本地部署前沿大模型的门槛。
1. FreeToken是什么
FreeToken是由UC Berkeley与MIT等机构联合开源的端侧MoE大模型推理系统,将个人电脑的CPU、内存、PCIe总线与GPU统一为弹性计算平台。系统通过全层双缓冲预取、带宽自适应混合调度、Agent状态复用及弹性显存热扩缩容等核心技术,实现单卡消费级硬件满血运行Qwen3.6-35B、DeepSeek-V4-Flash 284B等超大MoE模型,显著降低本地部署前沿大模型的门槛。
技术定位与领域: FreeToken属于大模型推理优化与端侧部署领域,聚焦MoE(Mixture of Experts)架构模型的本地高效运行,在消费级硬件上实现数据中心级模型的推理能力,与Ollama、llama.cpp等通用推理框架形成差异化定位。
研发背景: 项目由UC Berkeley与MIT等机构联合研发,针对MoE模型在端侧部署中面临的PCIe带宽瓶颈、显存容量受限、Agent多轮交互重复计算等核心问题,提出系统级的协同优化方案,技术积累源于学术机构在系统与AI交叉领域的研究成果。
核心价值: 该工具解决了消费级硬件无法运行超大MoE模型的现实问题,通过全栈异构协同将硬件吞吐提升至理论极限,同时借助Agent状态复用降低多轮交互延迟,使本地AI Coding Agent与大规模模型推理成为可落地的应用方案。
技术特点: 全层双缓冲预取消除I/O等待气泡,带宽自适应调度动态分流计算负载,弹性显存热扩缩容保障服务稳定性,Agent状态复用减少重复计算开销,四项核心技术构成完整的端侧推理优化体系。
2. 主要功能
端侧满血推理: 支持在RTX 4060/5090等消费级单卡上满血运行Qwen3.6-35B、DeepSeek-V4-Flash 284B等超大MoE模型。系统将CPU、内存与GPU统一调度,无需数据中心级硬件即可完成大规模参数模型的本地推理,打破了消费级硬件与前沿模型之间的算力壁垒。
全层双缓冲预取: GPU计算当前层时,后台通过PCIe流式预取下一层Expert权重,实现计算与数据搬运的完全重叠,彻底消除I/O等待气泡。该机制使Prefill过程不会因逐层从系统内存拉取Expert而产生严重阻塞,显著提升长Prompt处理吞吐。
带宽自适应调度: 运行时实时探测本机PCIe实际带宽与CPU瞬时算力,动态计算分流比率。未命中GPU缓存的Expert按实时带宽智能分流,部分经PCIe传输至GPU,部分在CPU并行计算,将硬件吞吐拉至该拓扑下的理论极限。
Agent状态复用: 在特殊Token边界设置轻量级检查点,上下文发生编辑时仅需从最近的有效锚点恢复并增量Prefill新增后缀,无需重新计算完整历史。该机制大幅减少Coding Agent与工具调用场景中多轮交互的重复计算开销。
弹性显存热扩缩: 后台应用抢占显存时,系统在不重启Serving服务的前提下无缝收缩GPU Cache,并将更多未命中Expert转交CPU计算,实现0停机、不触发CUDA Out of Memory崩溃的平滑降级,保障推理服务持续稳定运行。
极速低延迟: 首Token延迟降低42–58%,Agent多轮交互TTFT减少65–80%,整体推理速度比Ollama快2–4倍,比llama.cpp快1.46倍。笔记本RTX 4060运行Qwen3.6-35B实测可达39.3 tok/s。
3. 如何使用
桌面App安装: 访问FreeToken官网((链接待官方发布后更新)
命令行快速安装: 通过命令行执行
uv pip install "freetoken[accel]"一键完成CLI工具安装。该方式基于Python生态的依赖管理,便于开发者将FreeToken集成到现有工作流或自动化脚本中。模型载入与自动调度: 载入支持的MoE模型权重后,系统自动完成CPU-GPU异构调度与带宽自适应配置。用户无需手动调整参数,系统会在运行时持续探测硬件状态并动态优化分流策略。
硬件配置建议: 运行DeepSeek-V4-Flash等超大模型时,建议配备32GB显存并搭配192GB以上系统内存,以保证Expert权重加载与GPU缓存有充足空间。运行Qwen3.6-35B等中等规模模型时,RTX 4060级别显卡即可满足需求。
弹性显存自动管理: 使用过程中若后台有游戏、3D渲染或其他应用抢占显存,FreeToken会自动执行热扩缩容,将GPU缓存无缝收缩并转交CPU计算,全程无需手动干预或重启服务。
注意事项: 首次运行超大模型时,系统需要将Expert权重预加载至系统内存,耗时较长属正常现象。建议关闭不必要的后台应用以释放内存带宽,确保PCIe带宽探测结果准确,从而获得更优的调度效果。
4. 优缺点分析
| 优点 |
|---|
| 端侧满血推理: 在RTX 4060/5090等消费级单卡上运行35B–753B参数的MoE模型,打破数据中心硬件依赖,显著降低大模型本地部署门槛。 |
| 推理性能领先: 比Ollama快2–4倍,比llama.cpp快1.46倍,RTX 4060笔记本运行Qwen3.6-35B可达39.3 tok/s,端侧推理效率处于同类工具前列。 |
| 显存弹性管理: 后台应用抢占显存时无缝收缩GPU Cache并转交CPU计算,实现0停机、不OOM的平滑降级,保障推理服务在复杂桌面环境中持续可用。 |
| Agent交互优化: 基于Token边界轻量检查点与状态复用,多轮工具调用场景TTFT减少65–80%,显著提升Coding Agent等交互式应用的响应体验。 |
| 全栈异构协同: 将CPU、系统内存、PCIe总线与GPU统一为弹性推理平台,自动收敛至硬件拓扑的理论最大吞吐,硬件利用率较高。 |
5. 同类工具对比
| 对比维度 | FreeToken | Ollama | llama.cpp |
|---|---|---|---|
| 核心架构 | CPU+内存+PCIe+GPU全栈异构协同,专为MoE架构深度优化 | 基于llama.cpp的通用推理封装,主要依赖GPU | C/C++实现的轻量推理引擎,支持CPU与GPU混合推理 |
| MoE模型支持 | 原生深度优化,支持20+种MoE模型满血运行 | 部分MoE模型缺乏支持或无法启动(如DSV4-Flash) | 基础MoE支持,但缺乏带宽调度与预取优化 |
| 推理性能 | 比Ollama快2–4倍,比llama.cpp快1.46倍 | 基线速度,PCIe带宽瓶颈明显 | CPU推理效率较高,GPU利用率有限 |
| 显存管理 | 弹性显存热扩缩容,后台抢占时0停机不OOM | 显存不足时直接触发CUDA OOM崩溃 | 依赖mmap映射,显存管理机制较简单 |
| Agent优化 | Token边界检查点与状态复用,TTFT减少65–80% | 上下文修改后需重算,延迟累积 | 无状态复用机制,多轮交互需完整重算 |
| 部署方式 | GUI桌面App / CLI(uv pip install "freetoken[accel]") |
命令行一键拉取(ollama run) |
源码编译,支持多平台 |
选型建议: 对于希望在消费级硬件上运行超大MoE模型、追求极致推理性能的用户,FreeToken是当前端侧推理方案中的优先选择,尤其是需要本地运行Coding Agent或多轮对话服务的场景,其状态复用与弹性显存机制能够提供稳定流畅的体验。对于通用本地模型推理需求,Ollama凭借简洁的命令行交互与丰富的模型库,依然是入门门槛最低的方案。
若设备为老旧硬件或CPU-only环境,llama.cpp的轻量特性更具适配性,但其在MoE模型与Agent场景下的性能表现与FreeToken存在明显差距。而在数据中心或服务端高并发场景,vLLM的吞吐优化与生产级稳定性仍是更成熟的选择,但vLLM并不面向消费级端侧部署,两者应用场景互补而非直接竞争。
6. 编辑总结
FreeToken在端侧大模型推理领域展现了系统级的创新思路。与Ollama、llama.cpp等以模型加载与基础推理为核心的框架不同,FreeToken将优化视角扩展到CPU、内存、PCIe与GPU的全链路协同,通过全层双缓冲预取与带宽自适应调度,解决了MoE模型在消费级硬件上运行的I/O瓶颈问题。其Agent状态复用机制针对当前AI Agent应用频繁编辑上下文的典型工作负载进行了专项优化,TTFT降低65–80%的数据体现了该设计在实际场景中的有效性。弹性显存热扩缩容则从系统稳定性角度解决了消费级硬件显存受限的现实痛点。
从实用价值来看,FreeToken将超大MoE模型的运行门槛从数据中心降至个人电脑,对AI开发者、科研人员与Agent应用爱好者具有实际意义。项目由UC Berkeley与MIT等机构联合研发,学术背景为后续迭代提供了技术支撑。当前版本在Dense模型支持、多卡并行与生态建设方面仍有完善空间,但其在端侧MoE推理方向的技术路线具有较强的参考价值,值得持续关注。
7. 应用场景
本地AI Coding Agent: 在笔记本或游戏PC上本地运行Claude Code、OpenClaw等编程Agent,支持多轮工具调用与思维链迭代,无需联网即可实现智能代码补全与调试。Agent状态复用机制显著降低多轮交互延迟,提升编码效率。
端侧超大MoE模型推理: 个人用户可在RTX 4060/5090等消费级单卡上满血运行DeepSeek-V4-Flash(284B)、GLM-5.2(753B)等前沿模型,打破数据中心依赖,实现完全本地化的模型使用,保障数据隐私。
高并发多轮对话服务: 客服、知识问答等需要频繁修改上下文的对话场景,利用Token边界检查点与状态复用,避免重复计算完整历史,显著降低多轮响应延迟,提升服务吞吐与用户体感。
游戏/工作并行的弹性AI助手: 在后台运行3D渲染、游戏或开发工具时,FreeToken自动收缩GPU缓存并转交CPU计算,保证AI推理服务不中断、不崩溃,实现多任务并行下的稳定运行。
边缘设备科研与原型验证: 科研人员可在实验室普通工作站上快速部署和测试最新开源MoE模型,无需申请服务器资源,降低大模型研究门槛,加速实验迭代与算法验证。
8. 常见问题FAQ
Q:FreeToken支持哪些模型?
A:FreeToken主要针对MoE架构模型进行优化,支持Qwen3.6-35B、DeepSeek-V4-Flash(284B)、GLM-5.2(753B)等20余种MoE模型满血运行。Dense模型的适配支持情况以官方仓库发布信息为准。
Q:运行FreeToken需要什么硬件配置?
A:运行Qwen3.6-35B建议配备RTX 4060及以上显卡;运行DeepSeek-V4-Flash等超大模型建议32GB显存并搭配192GB以上系统内存。系统将CPU、内存与GPU统一调度,硬件配置越高,推理性能表现越优。
Q:FreeToken与Ollama有什么区别?
A:Ollama是通用本地模型运行框架,主要依赖GPU推理;FreeToken是面向MoE模型的端侧推理系统,将CPU、内存、PCIe与GPU统一调度,推理速度比Ollama快2–4倍,并支持弹性显存热扩缩容与Agent状态复用,两者在架构设计与功能定位上存在显著差异。
Q:如何安装FreeToken?
A:提供两种安装方式:访问官网下载Windows或Linux桌面App,通过GUI界面启动服务;或执行 uv pip install "freetoken[accel]" 安装CLI工具,适合开发者集成到现有工作流或自动化脚本中。
Q:显存不足时FreeToken会崩溃吗?
A:不会。FreeToken支持弹性显存热扩缩容,当后台应用抢占显存时,系统无缝收缩GPU Cache并将未命中Expert转交CPU计算,实现0停机、不触发CUDA Out of Memory崩溃的平滑降级。
Q:FreeToken的开源协议是什么?
A:项目已在GitHub上开源发布,具体许可证类型以官方仓库LICENSE文件为准。学术与商业使用的授权条款需查阅官方发布说明,建议在部署前确认协议细节。
9. 项目地址
- 产品官网: https://www.flashml.ai/
- GitHub仓库: https://github.com/FlashML-org/FreeToken
- arXiv技术论文: https://arxiv.org/pdf/2608.16157
相关推荐
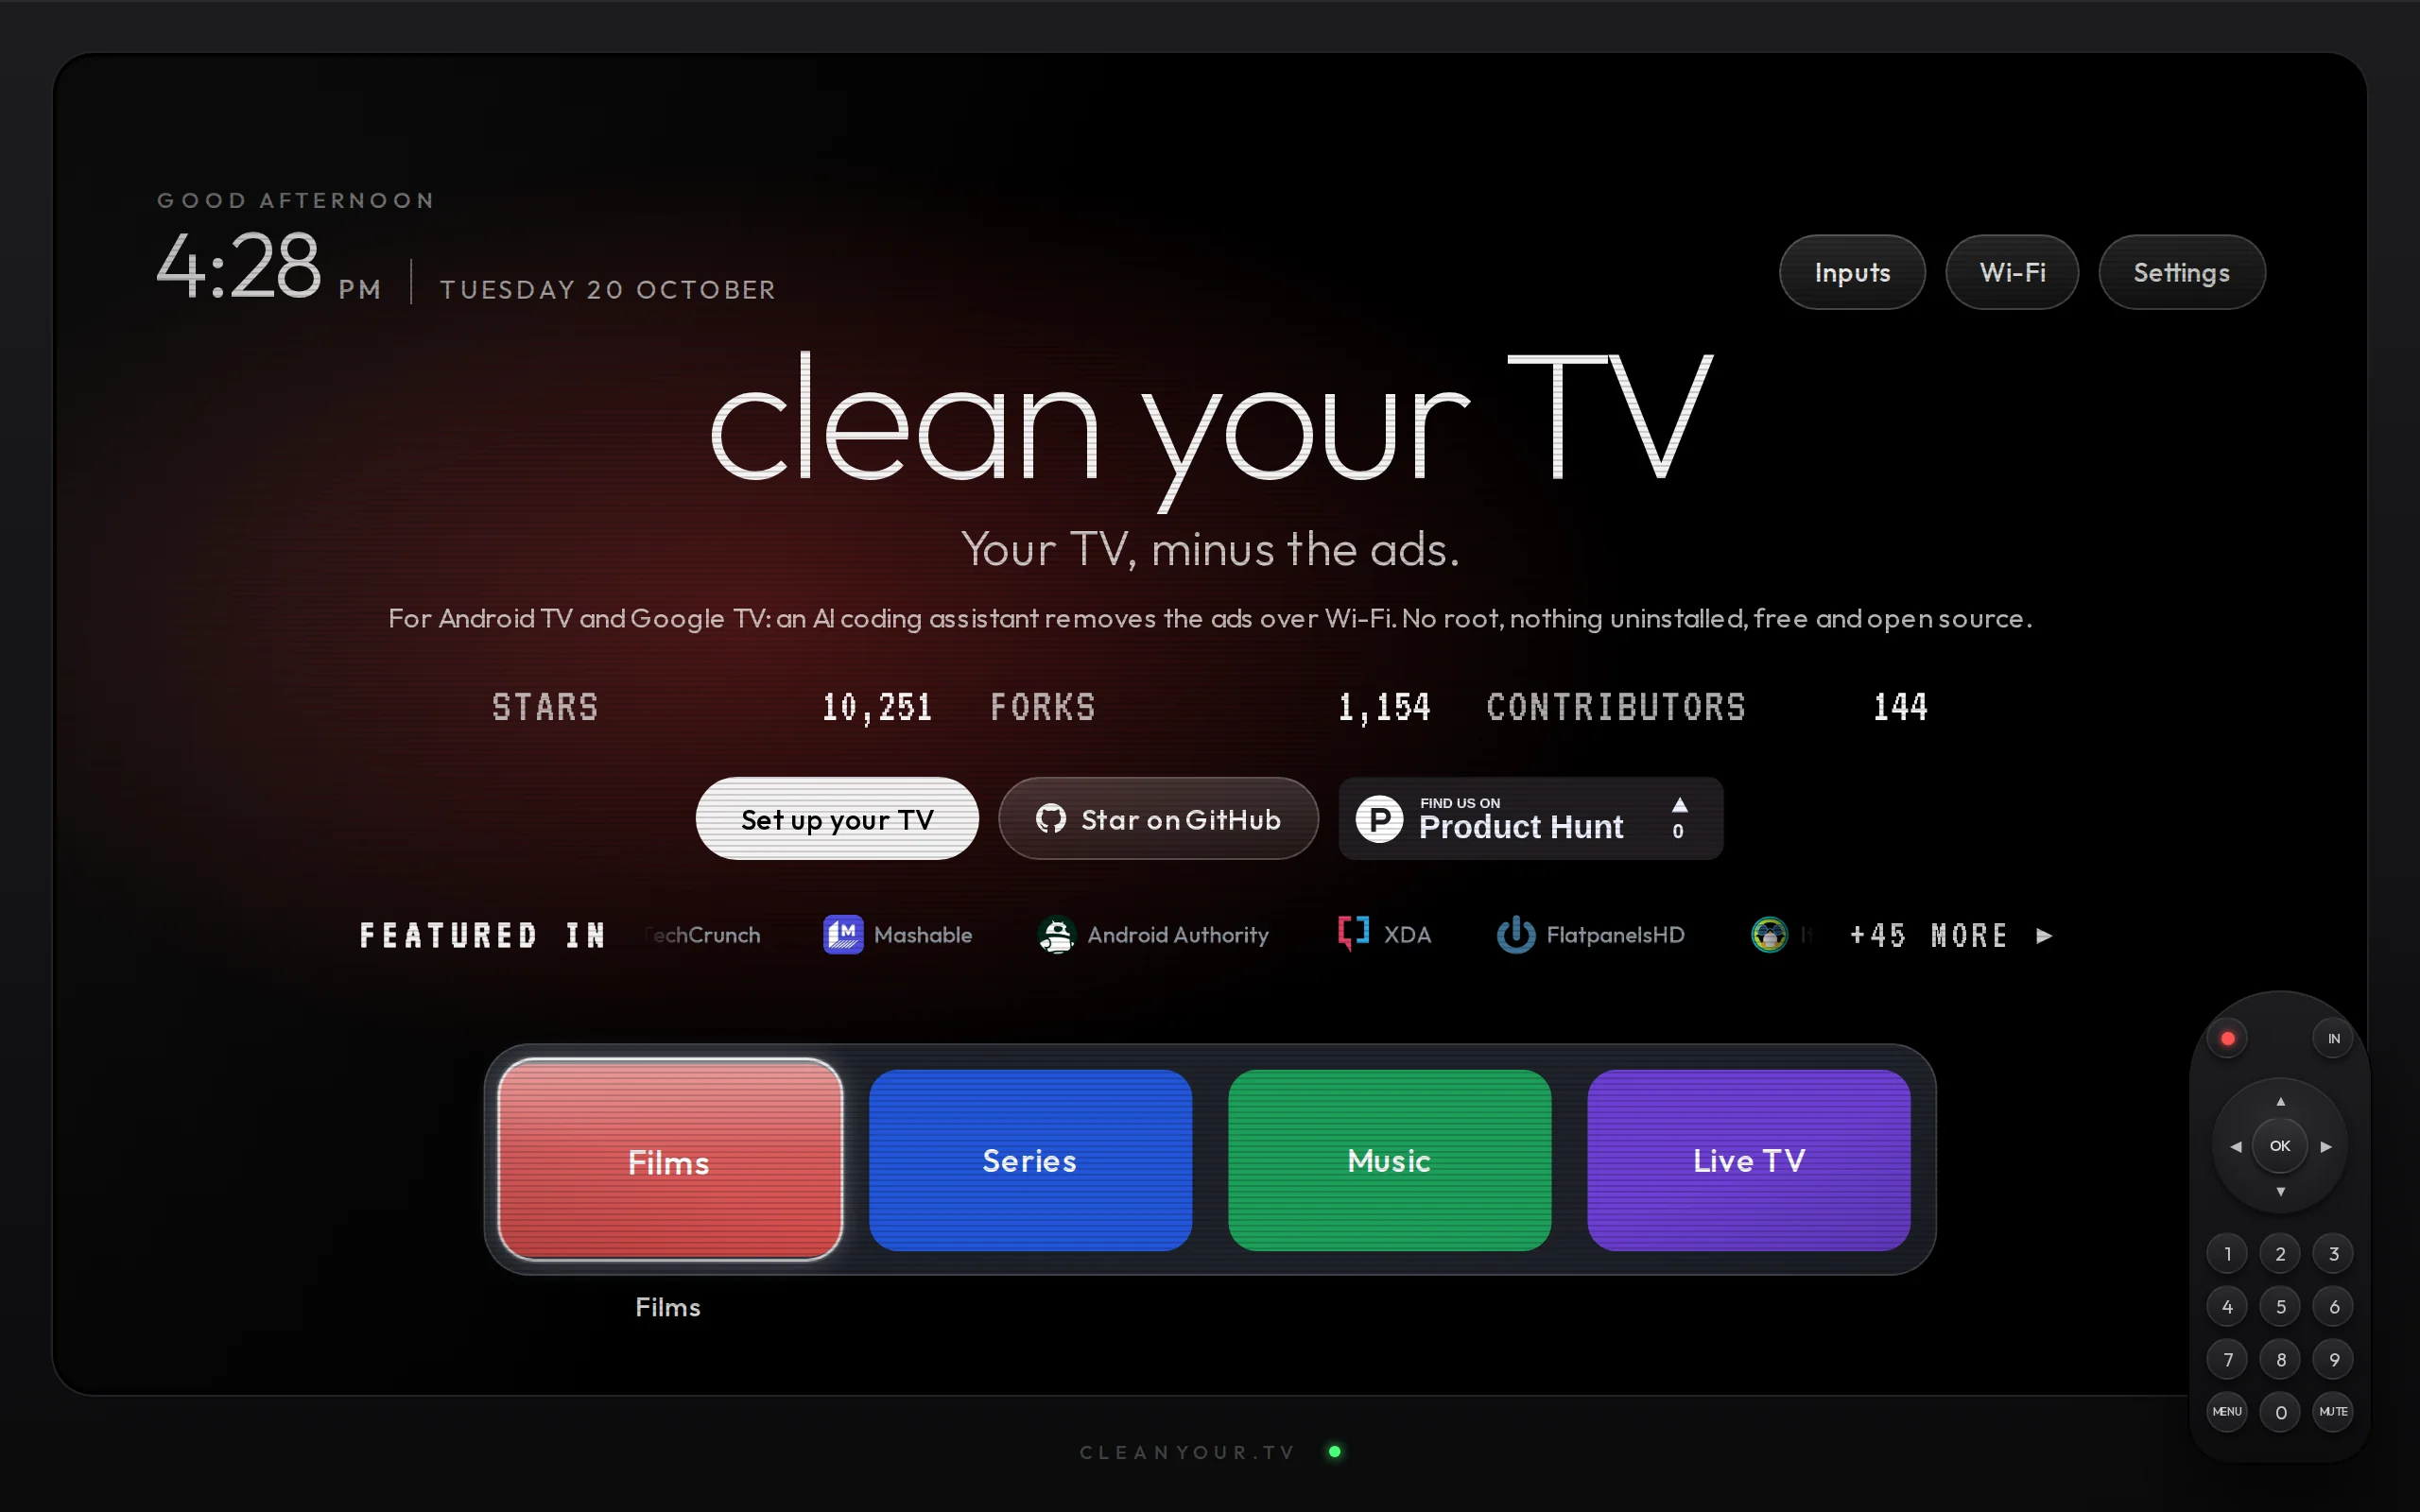
CleanYourTV – 开源的电视广告去除工具,垃圾软件全清空
CleanYourTV 是一款开源的电视系统优化工具,通过 Wi-Fi 网络利用 ADB(Android Debug Bridge)协议连接安卓电视,借助 Claude Code、Codex、Gemini CLI 等 AI Agent 自动识别并停用厂商预装的广告应用、数据遥测服务和臃肿软件,同时安装一款风格类似 Apple TV 的极简桌面 Launcher。该工具全程无需 Root 权限、不卸...

MiniMax M3.1 Flash – MiniMax 推出的一代 Flash 模型
MiniMax M3.1 Flash是MiniMax于2026年推出的新一代Flash系列模型,以匿名“Space Bunny”身份在各大评测基准中亮相,训练数据量超过200T Token。该模型在Agentic任务、编程、Computer Use及网络安全四大领域均展现出色表现,DeepSWE v1.1得分73.7%、OSWorld V2得分61.7、CyberGym得分82%,已全面上线Min...
Hy Memory 2.0 – 腾讯混元开源的智能体记忆框架
Hy Memory 2.0 是腾讯混元开源的智能体记忆框架,采用"模型 + 框架 + 应用"三层架构:专为记忆训练的 Hy-Memory-30A3B 模型、支持聊天/工作/代码三类记忆的 SDK,以及可连接 10 种 AI 工具的本地记忆管理应用 MemHub。该框架能够跨对话、跨工具沉淀和同步个人记忆,使 Agent 具备连续、完整的长期记忆能力,已在腾讯自选股、腾讯新闻等核心业务中落地验证。

BlenderWorld – Qwen 开源的 3D 创作 Agent 评测基准
BlenderWorld 是 Qwen 团队联合浙江大学、香港中文大学、复旦大学及新加坡国立大学共同推出的 3D 创作 Agent 评测基准,包含 223 项真实制作任务,用于检验 AI 系统能否根据照片、视频或设计规格,在 Blender 环境中交付可编辑的 3D 工程文件。该基准通过多视角渲染与原生工程结构检查的双轨评审机制,以 2,651 条验收标准综合衡量需求完成度与视觉质量。实测 13 ...
版权声明:本文部分内容由 AI 辅助生成并经人工校准,版权归本站所有,未经允许禁止任何形式的转载。